方法名称:Faster Flash Decoding
原文标题:Faster Than Flash: Exploiting Attention Sparsity for Efficient Long-Context Decoding
署名单位:复旦大学与上海创智学院
首次公开时间:2026 年 9 月 1 日
龙哥导读
就在前一天,Step 5 刚把百万级上下文开放给更多开发者。上下文越长,模型确实越能一次读进代码仓库、研究资料和复杂任务轨迹;但另一个不那么显眼的问题也被推到了台前:模型每生成一个新词,都可能重新面对一条越来越长的键值缓存。
快速解码方法(FFD)盯住的就是这个生成阶段的“逐词税”。它不试图改变模型,也不要求重新训练,而是问了一个很工程化的问题:注意力真正重要的位置通常只占少数,能不能先用极便宜的方式扫一遍,再把昂贵的精确计算留给少量候选?其英文方法名为 Faster Flash Decoding。
论文给出的答案是:先用 2-bit 键值缩略图快速扫描,再用相对阈值 top-δ 选候选,最后用 8-bit 残差恢复精度,并把整套流程融合进图形处理系统(GPU)内核。它在消费级高端显卡上报告最高 11.63 倍内核加速,在 H100 的 16K 设置下达到 87.0 tokens/s。真正值得关注的不是一个孤立的峰值,而是它把“注意力稀疏”做成了更接近可部署系统的完整路径。
一、长上下文真正贵在哪里?
大模型的推理通常分成两个阶段。第一阶段是预填充:把整段输入一次性送进模型,建立键值缓存(KV)。第二阶段是解码:模型一个词、一个词地向后生成。很多人看到“长上下文”时,会直觉地把成本理解成“第一次读入很慢”;实际上,当上下文已经达到数万乃至数十万词元后,解码阶段同样会越来越重。
原因并不复杂。生成第一个新词时,查询向量要与已有上下文中的大量键向量计算相关性;生成下一个词时,缓存又多了一项,查询仍要重新扫描。上下文越长,每个新词要面对的数据越多。即使 KV Cache 已经保存在显存里,读取、打分、归一化和聚合也会持续消耗带宽与计算资源。
更麻烦的是,现代 GPU 的算力增长速度往往快于显存带宽增长速度。也就是说,芯片“会算”的能力很强,但“把一大堆数据搬到计算单元前”可能成为瓶颈。长上下文解码恰好具有这种特征:它需要反复读取庞大的缓存,而最终真正获得高注意力权重的位置却可能很少。
这就形成了 FFD 的基本出发点:既然注意力权重天然呈稀疏分布,为什么还要对每个历史位置都使用同等昂贵的精确计算?能不能先形成一张低清“缩略图”,只看清哪里可能重要,再对候选区域看高清版本?这和先看地图概览、再放大目标街区非常相似。
二、已有稀疏选择为什么还不够?
注意力稀疏并不是新发现。常见方案大体分为两步:先估计哪些历史位置值得保留,再只对这些位置执行精确注意力。问题在于,“选择候选”本身也可能很贵。如果为了节省一次全量注意力,又引入一次复杂排序或高精度扫描,收益很容易被选择开销吃掉。
最直观的是 top-k:每个查询固定保留 k 个分数最高的位置。它容易理解,也方便控制计算量,但不同查询的注意力集中程度并不相同。有些查询只有几十个位置真正重要,有些查询则需要更宽的覆盖。固定 k 相当于给所有问题发同样大小的答题纸,集中时浪费,分散时又可能不够。
另一类是 top-p:按概率从高到低累积,直到总质量超过某个阈值。它能随分布变化调整候选数量,但需要更完整地掌握概率分布,通常还要排序或近似排序。对于追求极低延迟的 GPU 内核,这类全局操作并不便宜,也不容易与前后计算无缝融合。
FFD 选择了第三条路:不规定固定数量,也不追求累计概率,而是只问一个局部问题——一个位置与当前最大分数相比,差得是否太多?这就是 top-δ。它把候选判断变成逐元素阈值比较,避免全局排序,更适合在 GPU 上并行执行。
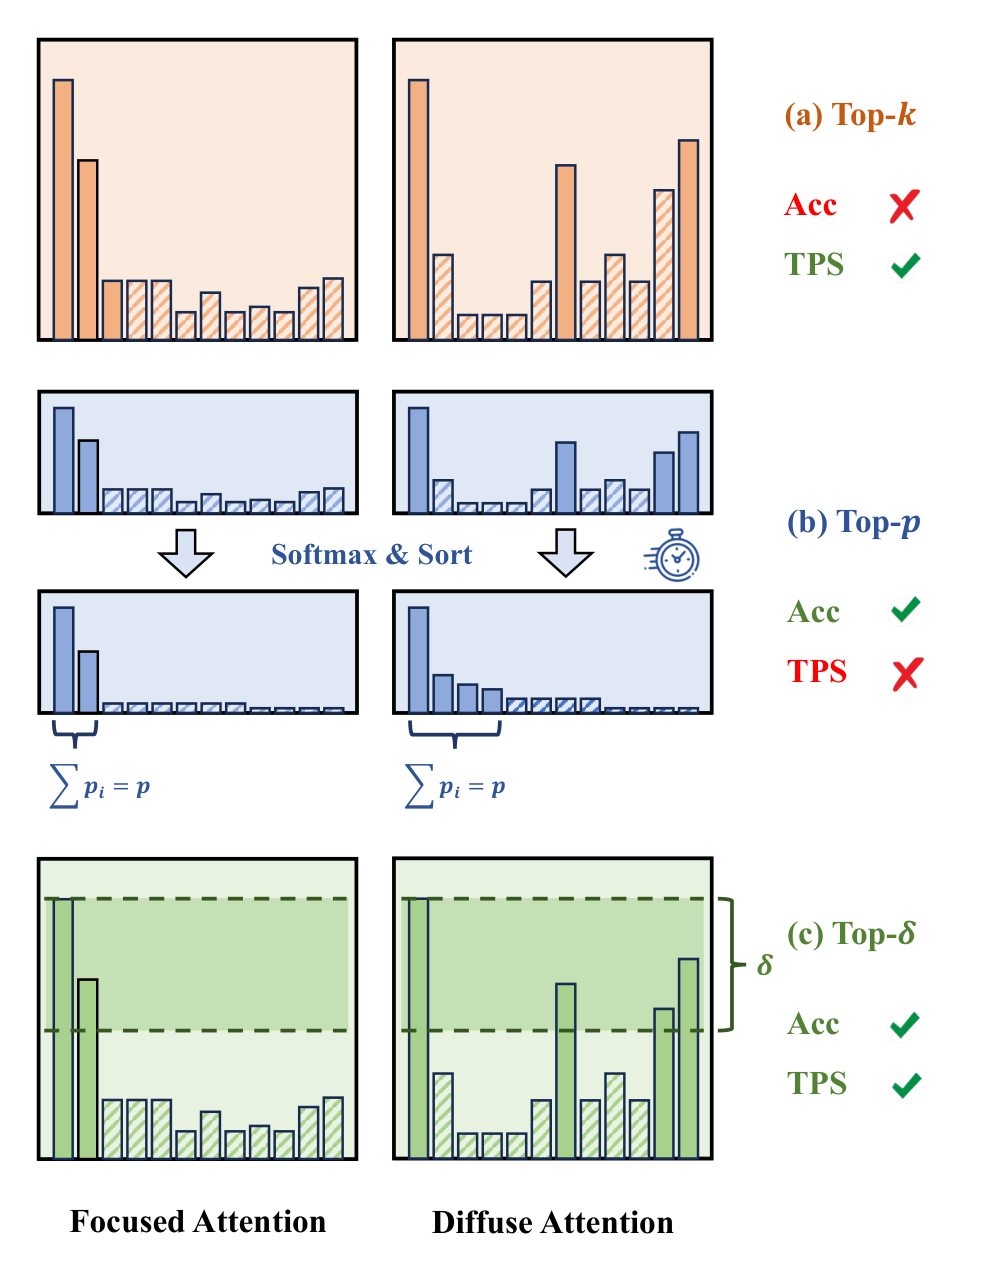 图 1:论文对 top-k、top-p 与 top-δ 的直观比较。top-k 固定候选数量,top-p 依赖累计质量,top-δ 保留与最大分数相差不超过阈值的位置。
三、top-δ:不数名次,只看离冠军有多远
设第 i 个查询与第 j 个键的注意力分数为 sij,该查询所有分数中的最大值为 mi。FFD 的规则非常直接:只要某个位置满足 sij ≥ mi − δ,就进入候选集合。δ 越小,门槛越严;δ 越大,保留位置越多。
sij ≥ mi − δ
这个规则还有一个很自然的概率解释。Softmax 会把分数变成指数权重。将候选分数除以最大分数对应的指数项,可以得到 exp(sij)/exp(mi) ≥ e−δ。也就是说,top-δ 实际上保留的是“相对于当前最强位置,贡献没有衰减到阈值以下”的键。
这比固定 k 更能适应不同形状的注意力分布。若一个查询高度集中,只有少数位置接近最大值,候选集合自然很小;若分布较平坦,更多位置会跨过门槛,系统也会自动多保留一些。候选数量由数据决定,而不是由工程师提前硬编码。
与 top-p 相比,top-δ 也不需要知道所有位置的累计概率。每个分数只需与同一个门槛比较,极易并行。对于 GPU 来说,这种规则不仅数学上简洁,更重要的是它能被做成一条轻量数据流,而不是额外插入一个昂贵的排序阶段。
当然,top-δ 不是“免费午餐”。它依赖最大分数 mi。如果为了得到精确最大值,仍然对所有高精度键做完整扫描,前面的收益又会被抵消。因此,FFD 下一步不是直接计算真实最大值,而是构造一个便宜、可靠的近似值。
四、pseudo-max:只用注意力“锚点”估计最高分
长上下文注意力中经常出现两类稳定的重要位置。第一类是序列开头的少量 token,也就是常说的 attention sink。即使它们的语义并不总是直接相关,许多注意力头也会长期给它们较高权重。第二类是当前查询附近的局部 token,因为语言和代码都具有很强的局部连续性。
FFD 利用这两个现象,从序列开头和局部窗口抽取少量锚点,只对这些位置进行快速打分,然后用其中最大值作为 pseudo-max,也就是“伪最大值”。它不保证与全局真实最大值完全一致,但论文的经验观察是,这些锚点常常足以给出接近的上界参考。
这一步很关键。若伪最大值偏得太高,门槛也会被抬高,可能错过重要候选;若偏得太低,又会放入太多候选,稀疏收益下降。因此作者不仅讨论平均情况,还专门检查 attention sink 数量变化时的鲁棒性。论文报告,使用少量 sink 加局部窗口就能在不同模型和任务中保持稳定。
从系统设计角度看,这是一种很值得借鉴的思路:不要为了做一个选择器,再重做一遍原任务。与其先精确求出“全局最优”再裁剪,不如寻找结构上稳定的锚点,先构造足够好的门槛。只要最终质量可验证,近似本身就可以成为效率来源。
五、2-bit 缩略图加 8-bit 残差:便宜扫描,精确回看
FFD 的另一个核心是混合量化表示。完整的键向量不直接用于第一次全量扫描,而是拆成两部分:一份极低精度的 2-bit 主体,以及一份 8-bit 残差。可以把 2-bit 主体理解为颜色很少、但轮廓清晰的缩略图;8-bit 残差则保存缩略图丢掉的细节。
第一次扫描所有历史位置时,系统只读取 2-bit 表示。相较于更高精度缓存,这显著减少了显存读取量。扫描得到近似分数后,top-δ 根据伪最大值筛出候选。只有进入候选集合的位置,才继续加载相应的 8-bit 残差,对分数进行更精细的修正。
这样做的重点不是单纯“把 KV Cache 压得更小”,而是把不同精度分配给不同阶段。全量阶段追求召回和速度,不要求每个分数都非常准确;候选阶段面对的数据量已经大幅缩小,才值得支付更高精度成本。精度预算由任务的重要性动态分配。
论文给出的典型设置 δ=5 或 δ=7,分别对应更激进和更保守的候选范围。已有结果显示,这两档设置的平均稀疏率大约为 82% 和 73%。换句话说,大部分历史位置可以不进入后续精确注意力,但保留多少并不是固定数字,而会随查询实际分布变化。
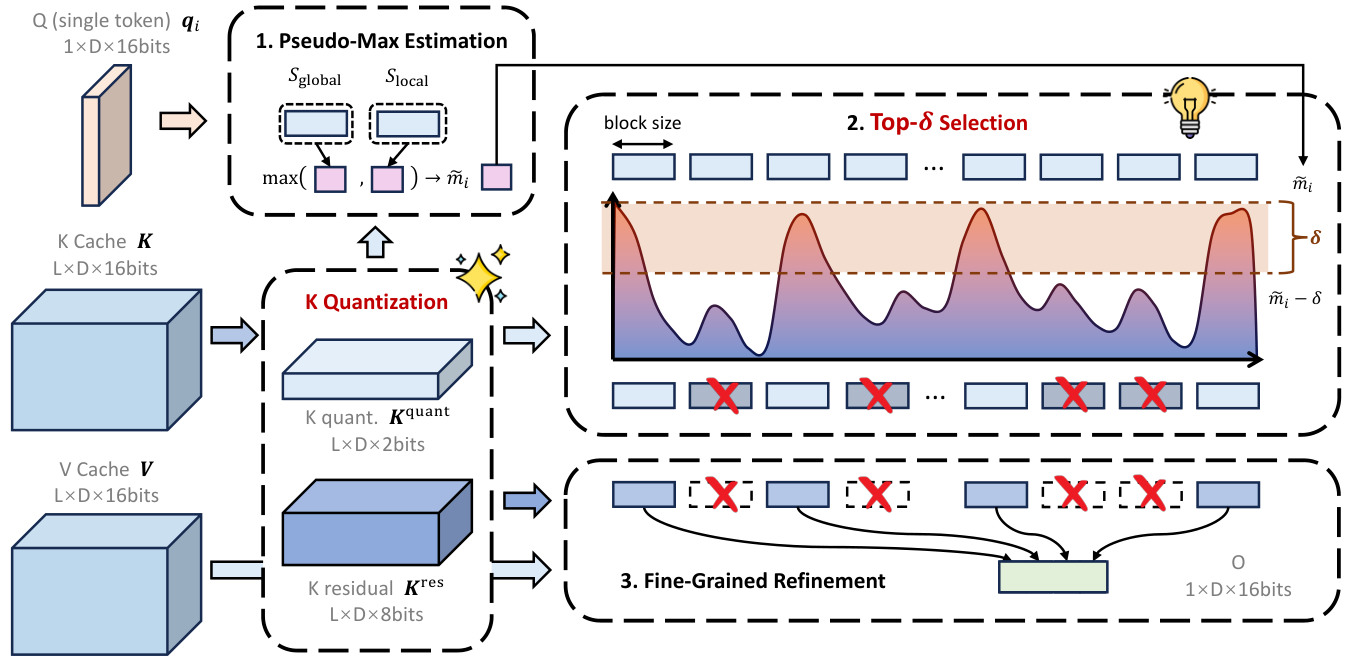 图 2:FFD 方法总览。2-bit 量化键用于快速扫描;attention sink 与局部窗口估计 pseudo-max;top-δ 形成候选集合;8-bit 残差修正候选分数,再完成精确注意力与输出聚合。
六、为什么“融合成一个 GPU 内核”比公式本身更重要?
很多稀疏方法在算法层面看起来能少算,但真正部署时不一定更快。原因是 GPU 不只关心乘加次数,还关心内核启动、数据搬运、中间结果写回显存、线程同步和不规则访存。如果候选选择、索引整理、精确计算各自启动一个内核,中间产生的大量小开销会抵消稀疏收益。
FFD 因此把 2-bit 扫描、候选判断、残差修正、精确注意力和输出聚合尽可能融合在一起。中间分数不必频繁写回全局显存,候选信息也能在更靠近计算单元的位置继续使用。系统减少的不只是“被选中的键数量”,还有阶段之间来回搬运数据的成本。
这也解释了为什么论文把结果分为“内核加速”和“端到端吞吐”两类。前者衡量注意力核心计算本身快了多少,后者还包含模型其余层、调度以及整体生成流程。11.63 倍是特定内核与设置下的峰值,不应直接写成整个大模型生成速度提升 11.63 倍。
工程论文最容易被误读的地方,往往就是把局部峰值当成整机收益。FFD 的价值恰恰在于它同时给出了两种口径:在 RTX 4090 上展示内核随上下文增长的收益,在 H100 上再与完整端到端方案比较。两者共同说明方法有效,但也清楚标出了收益边界。
七、RTX 4090:上下文越长,稀疏扫描越有意义
论文在 Llama-3.1-8B 和 Qwen2.5-7B 上测试最长 256K 上下文。对于 RTX 4090,δ=5 的平均内核加速为 7.33 倍,δ=7 为 6.18 倍,峰值达到 11.63 倍。更小的 δ 候选更少、速度更快;更大的 δ 保留更多位置,通常更稳健。
下面的官方曲线给出不同上下文长度下的延迟。它最重要的信息不是某个单点,而是趋势:随着序列拉长,密集注意力需要读取和处理的数据持续增长;FFD 用低比特扫描替代高精度全量读取后,增长斜率明显更缓。长上下文越长,减少带宽压力的价值越突出。
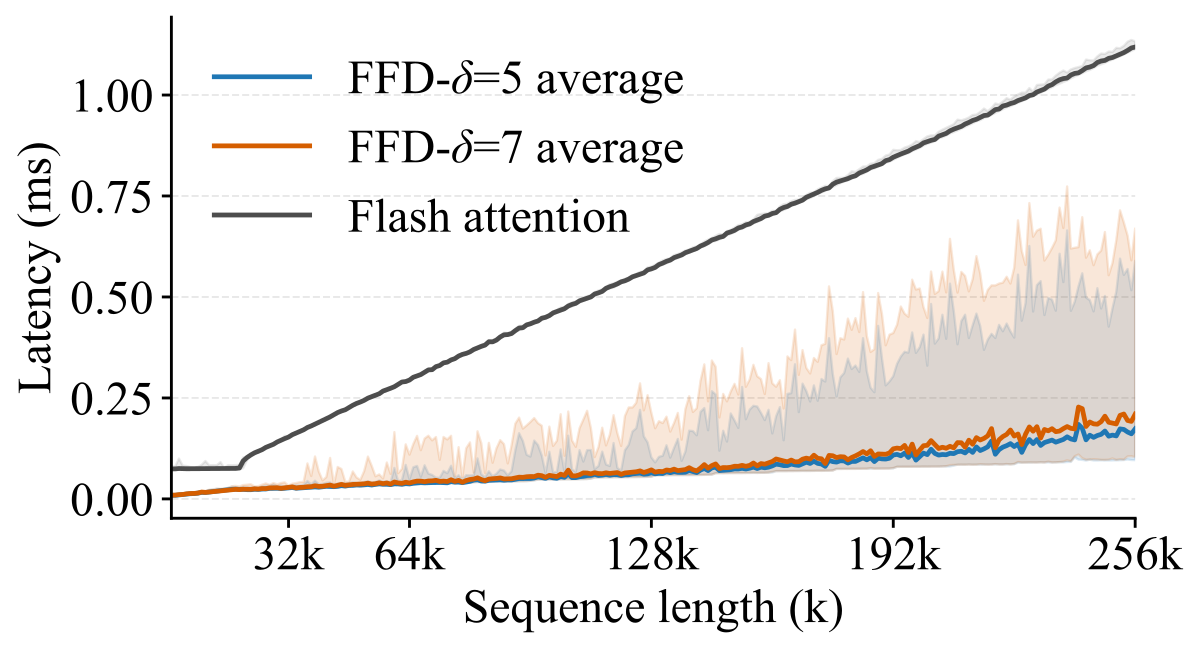 图 3:论文在 RTX 4090 上比较不同上下文长度的内核延迟。曲线展示的是注意力内核层面的速度变化,不等同于整模型端到端加速。
这里还应注意硬件背景。RTX 4090 拥有很强的计算能力,但显存容量与带宽都有限,长上下文键值缓存对它尤其不友好。FFD 的 2-bit 扫描减少了必须从显存读取的数据量,因而更容易在这类消费级高端图形处理芯片上体现出明显优势。
不过,峰值来自特定模型、上下文长度、层和注意力头组合。把“最高 11.63 倍”理解为所有请求、所有硬件、所有长度都能获得同样提升是不准确的。更可靠的结论是:在长上下文、解码阶段且注意力足够稀疏时,低比特扫描与融合内核可以把注意力计算大幅压缩。
八、H100:端到端 87.0 tokens/s 意味着什么?
H100 的算力、显存带宽和专业推理生态都明显强于 RTX 4090,因此端到端实验更接近数据中心部署。论文在 16K 上下文设置中报告,FFD 吞吐达到 87.0 tokens/s,对比 Quest 的 73.5 tokens/s;相对密集基线,最高端到端加速为 1.96 倍。
端到端收益小于内核峰值是正常现象。一个 Transformer 层除了注意力,还包含归一化、投影、前馈网络等部分;整次生成还涉及框架调度和采样。即使注意力内核变快十倍,其他部分也不会自动消失。87.0 tokens/s 因此比单独的内核倍数更能说明真实用户可能感受到的生成速度。
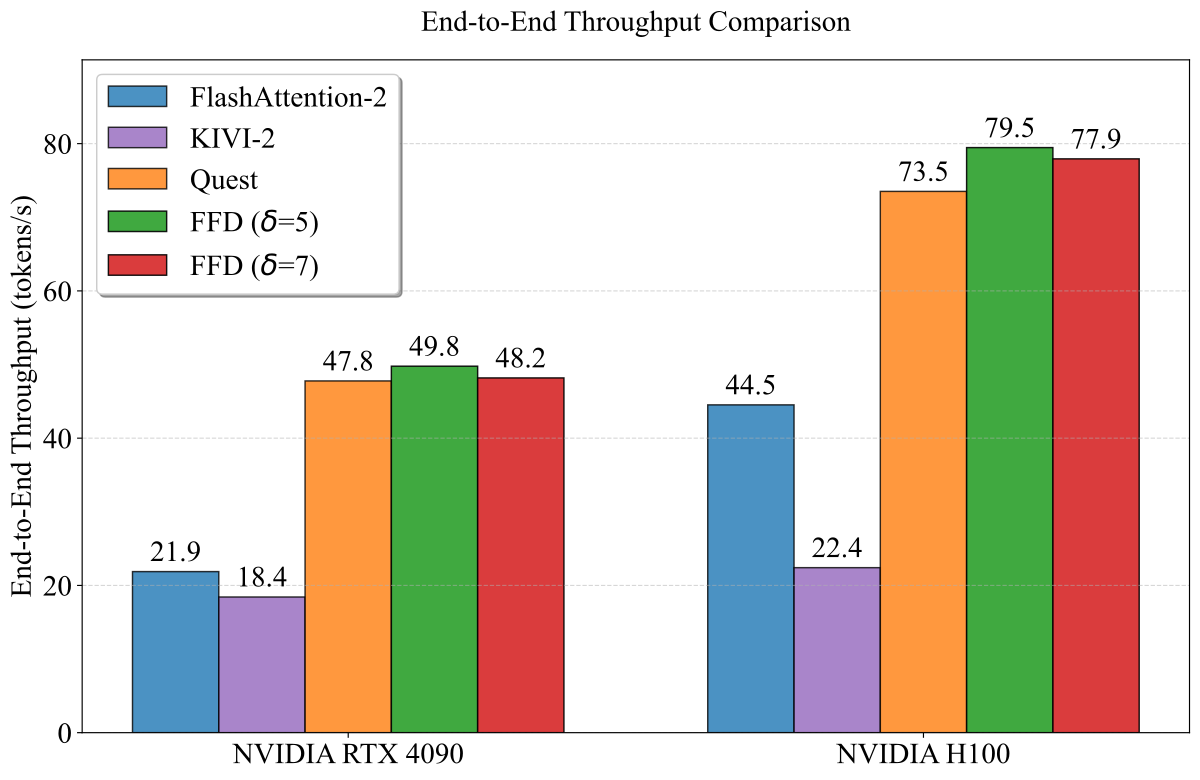 图 4:H100、16K 上下文下的端到端吞吐比较。FFD 在论文设置中达到 87.0 tokens/s,高于 Quest 的 73.5 tokens/s。
候选队列中的完整实验还给出最高 2.37 倍端到端吞吐提升,这来自论文覆盖的不同设置;而 1.96 倍是上述 H100 16K 对密集基线的具体结果。阅读性能论文时,应始终把数字与硬件、长度、批量、模型和对手方案绑定,不把不同表格中的峰值混成同一个结论。
从部署角度看,吞吐提升可被换算为更少 GPU 时间、更高并发或更低单次请求成本。但实际收益仍取决于服务形态:若请求上下文很短,注意力并非主要瓶颈;若批量很大或模型其他层占主导,FFD 的总体占比也会变化。它最匹配的是长上下文、逐词生成且 KV 读取压力突出的场景。
九、速度提升后,回答质量有没有被牺牲?
稀疏注意力最大的风险不是“少算”,而是把真正关键的位置裁掉。一次长文问答可能只依赖开头的一句约束,一次代码修改可能依赖几十页之前定义的接口。如果候选选择漏掉这些信息,速度再快也没有意义。因此论文同时使用长上下文评测框架(RULER)和长文本评测系统(LongBench)检查长上下文能力。
候选证据记录的结果中,FFD 在相应设置下取得 RULER 90.40、LongBench 26.18。这里不能只看绝对分数,更应看它与密集基线和其他稀疏方法之间是否保持接近。作者的目标不是让稀疏方法提高模型智力,而是在显著减少计算的同时,尽量守住原模型能力。
δ 在这里扮演速度与保真度的旋钮。δ=5 更激进,候选更少,平均稀疏率约 82%;δ=7 更保守,平均稀疏率约 73%。部署者可以按任务风险选择:普通摘要可能更重视速度,代码代理、检索问答或需要引用远距离证据的任务则可使用更保守阈值。
但这并不意味着所有任务都已经覆盖。RULER 与 LongBench 是常用长上下文基准,却不能代表真实生产环境中的所有文档结构、语言、代码仓库和工具调用轨迹。尤其当关键证据分布很分散、注意力不够尖锐时,候选数量可能上升,或者需要更大的 δ 才能守住质量。
十、与另外两条长上下文路线有什么区别?
本数据库中有两篇很适合与 FFD 横向比较。第一篇研究在线注意力头分类:它先判断哪些头适合使用稀疏策略,解决的是“哪些头值得稀疏”。这种方向承认不同注意力头的行为并不一致,不应该对所有头一刀切。
FFD 更关注下一层问题:当某个头要稀疏时,如何低成本找到候选,并在 GPU 内完成扫描、修正与聚合。两者并不冲突。前者像调度员,决定哪些车走快速通道;FFD 像快速通道本身,决定车辆如何筛选、如何连续通过。
第二篇工作把键值缓存扩展到使用高速固态存储接口(NVMe)的外部设备,解决的是“长上下文数据放在哪里”。当显存装不下庞大缓存时,外部存储可以扩大容量,但数据搬运延迟会成为新问题。它主要在容量层面做文章。
FFD 解决的是“数据进入 GPU 计算路径后,怎样少读、少算”。一个系统完全可能同时使用外部 KV Cache 与 FFD:前者让更长历史可被保存,后者减少每次查询真正需要搬进和处理的数据。长上下文优化很可能不是单一算法取胜,而是存储、选择、量化和内核共同协作。
十一、这项工作的工程价值
第一,FFD 不要求重新训练模型。对于已经训练完成的 Llama-3.1-8B、Qwen2.5-7B 等模型,推理后端可以通过新的 KV 表示和注意力内核获得收益。相比修改训练目标或重新微调,这种改动更容易被现有服务验证和回滚。
第二,它把算法假设和硬件实现连接起来。注意力稀疏只是现象;top-δ、伪最大值、2-bit 主体与 8-bit 残差是算法设计;融合 GPU 内核才把这些设计变成可测量的延迟与吞吐。三层缺一不可。
第三,它提供了可调节的质量—速度边界。δ 并非隐藏在系统内部的魔法数字,而是有明确含义的相对阈值。部署团队可以在自己的文档、代码、代理轨迹和用户查询上重新标定,找到满足质量要求的最小候选范围。
第四,它特别适合未来的超长上下文产品。当百万级上下文从演示能力变成开发者可用能力后,瓶颈会从“模型能否接收”逐渐转向“每次生成是否经济”。FFD 不是让上下文窗口数字继续变大,而是试图让已经很大的窗口更可用。
十二、还要警惕哪些限制?
首先,论文主要围绕两个 7B—8B 级模型展开。更大模型、混合专家模型、不同注意力结构以及新一代硬件是否保持同样收益,需要继续验证。模型规模变化后,注意力在整体推理成本中的占比也会变化。
其次,注意力稀疏程度依赖任务。若查询需要综合大量分散证据,分数分布可能更平坦,top-δ 会自然放入更多候选,速度收益下降。反过来,如果把 δ 调得过小强行追求速度,又可能漏掉远距离但重要的信息。
再次,低比特表示和自定义内核会增加推理系统复杂度。缓存格式、模型并行、批量调度、动态长度以及现有推理框架的兼容都需要工程投入。论文中的实验环境控制良好,真实服务还要面对混合请求、显存碎片和不同硬件版本。
最后,内核峰值不能替代端到端测量。部署时应同时记录首词延迟、逐词延迟、吞吐、显存占用、任务质量和长尾请求。只有当这些指标共同改善,11.63 倍这样的数字才真正转化成用户体验。
十三、龙哥点评:长上下文竞争进入“精打细算”阶段
过去两年,长上下文的竞争常用一个最醒目的数字表达:支持多少 K、多少 M。这个指标当然重要,因为窗口不够大时,很多任务根本无法开始。但当越来越多模型已经能读入整本书、长视频转写或大型代码仓库后,单纯扩大窗口不再等于真正可用。
FFD 展示了下一阶段的一种典型思路:承认历史信息很多,但每一步真正需要关注的内容很少;承认精确计算重要,但不是每个位置都值得先付出高精度成本;承认算法能减少工作量,但必须把它落实到数据布局和 GPU 内核里。
我尤其认可 top-δ 的相对视角。它不执着于“永远保留 1024 个位置”,而是根据当前查询的注意力形状决定保留多少。面对高度集中的查询就大胆稀疏,面对分散查询就多留一些。这比固定预算更贴近模型实际行为。
它也提醒我们,未来的推理优化不会只靠一种压缩。模型量化解决参数和计算,KV 量化解决缓存体积,外部存储解决容量,稀疏选择解决每一步真正访问多少数据,融合内核解决这些技巧能否变成真实速度。FFD 的位置,正是在这张系统拼图中补上“先廉价扫描,再精确回看”的一块。
龙迷三问
1. 11.63 倍是不是整模型生成速度?
不是。它是特定设置下的注意力内核峰值。H100 16K 端到端实验中,论文报告相对密集基线最高 1.96 倍,吞吐为 87.0 tokens/s。
2. 2-bit 会不会让模型“看错”历史内容?
2-bit 主要用于第一次候选扫描,并不是直接用它完成全部精确注意力。进入候选的位置还会加载 8-bit 残差修正。质量风险仍存在,因此必须用长上下文任务验证并合理选择 δ。
3. 这项方法最适合什么场景?
长文档问答、代码代理、研究助手和长轨迹智能体等长上下文逐词生成场景,尤其是 KV Cache 读取已经成为主要瓶颈时。短上下文或注意力占比很低的请求,收益会更有限。
总结
FFD 的方法链条可以浓缩成四步:用 attention sink 和局部窗口估计伪最大值;用 2-bit 键快速扫描所有历史位置;用 top-δ 按相对分数筛选候选;对候选加载 8-bit 残差并完成精确注意力。最后,把这些步骤融合进 GPU 内核,避免中间数据反复搬运。
它在最长 256K 上下文中展示了明显的注意力内核收益,在 H100 上也给出了端到端吞吐提升,并通过 RULER、LongBench 检查能力保持。它不是宣称所有生成都能快 11.63 倍,而是证明:当长上下文注意力足够稀疏时,“低成本找候选”可以成为非常实际的系统优化。
长上下文时代的下一道题,已经不只是“能读多少”,而是“读过以后,每写一个词还要付出多少代价”。复旦大学与上海创智学院这项工作,把答案落在一个很具体的工程原则上:先看缩略图,再放大重点;先减少数据搬运,再谈算力利用。对真正要把长上下文放进产品的人来说,这比窗口数字本身更值得持续追踪。
本文基于龙哥读论文PaperDaily数据库及PaperMiner的MCP进行汇总整理。本文为论文解读与个人学习笔记,不构成任何论文审核意见,及对产品能力、安全性或商业可用性的保证。

还没有公开留言,欢迎留下你的看法。