论文基本信息
原文标题:RawVLA: Embodied Neural Image Signal Processor For Robotic Manipulation
首次公开:2026年9月29日
署名单位:东京大学、D-Robotics、南洋理工大学、东北大学、香港科技大学(广州)
原论文:
https://arxiv.org/abs/2609.37530
项目页面:
https://shuhongll.github.io/rawvla/
数据集:
https://huggingface.co/datasets/ToferFish/RawVLA-Bench
龙哥导读
机器人在实验室灯光下干得好好的,把灯调暗,成功率却可能直接掉到零。RawVLA没有重训机器人的“大脑”,而是在相机和动作模型之间加了一层会随环境变化的视觉前端:它从传感器原始信号出发,动态调曝光、白平衡、颜色和色调。真机双臂实验里,固定相机处理在低光下平均成功率为0,RawVLA达到66.5%。龙哥觉得,这篇论文真正值得看的不是“把画面变亮”,而是让相机开始为动作服务。
我们经常把机器人失败归因于动作模型不够大、训练数据不够多,或者推理速度不够快。但这篇论文提醒了一个更靠前的问题:机器人交给模型的那张图,本身可能已经丢掉了完成动作需要的信息。
普通相机先把传感器原始信号经过曝光增益、降噪、白平衡、颜色校正、色调映射和量化,再输出我们熟悉的彩色图片。这套图像信号处理系统(ISP)通常由相机固件固定决定。人眼看起来尚可,不代表机器人就能稳定判断杯口、抽屉把手、花朵位置和机械臂接触关系。
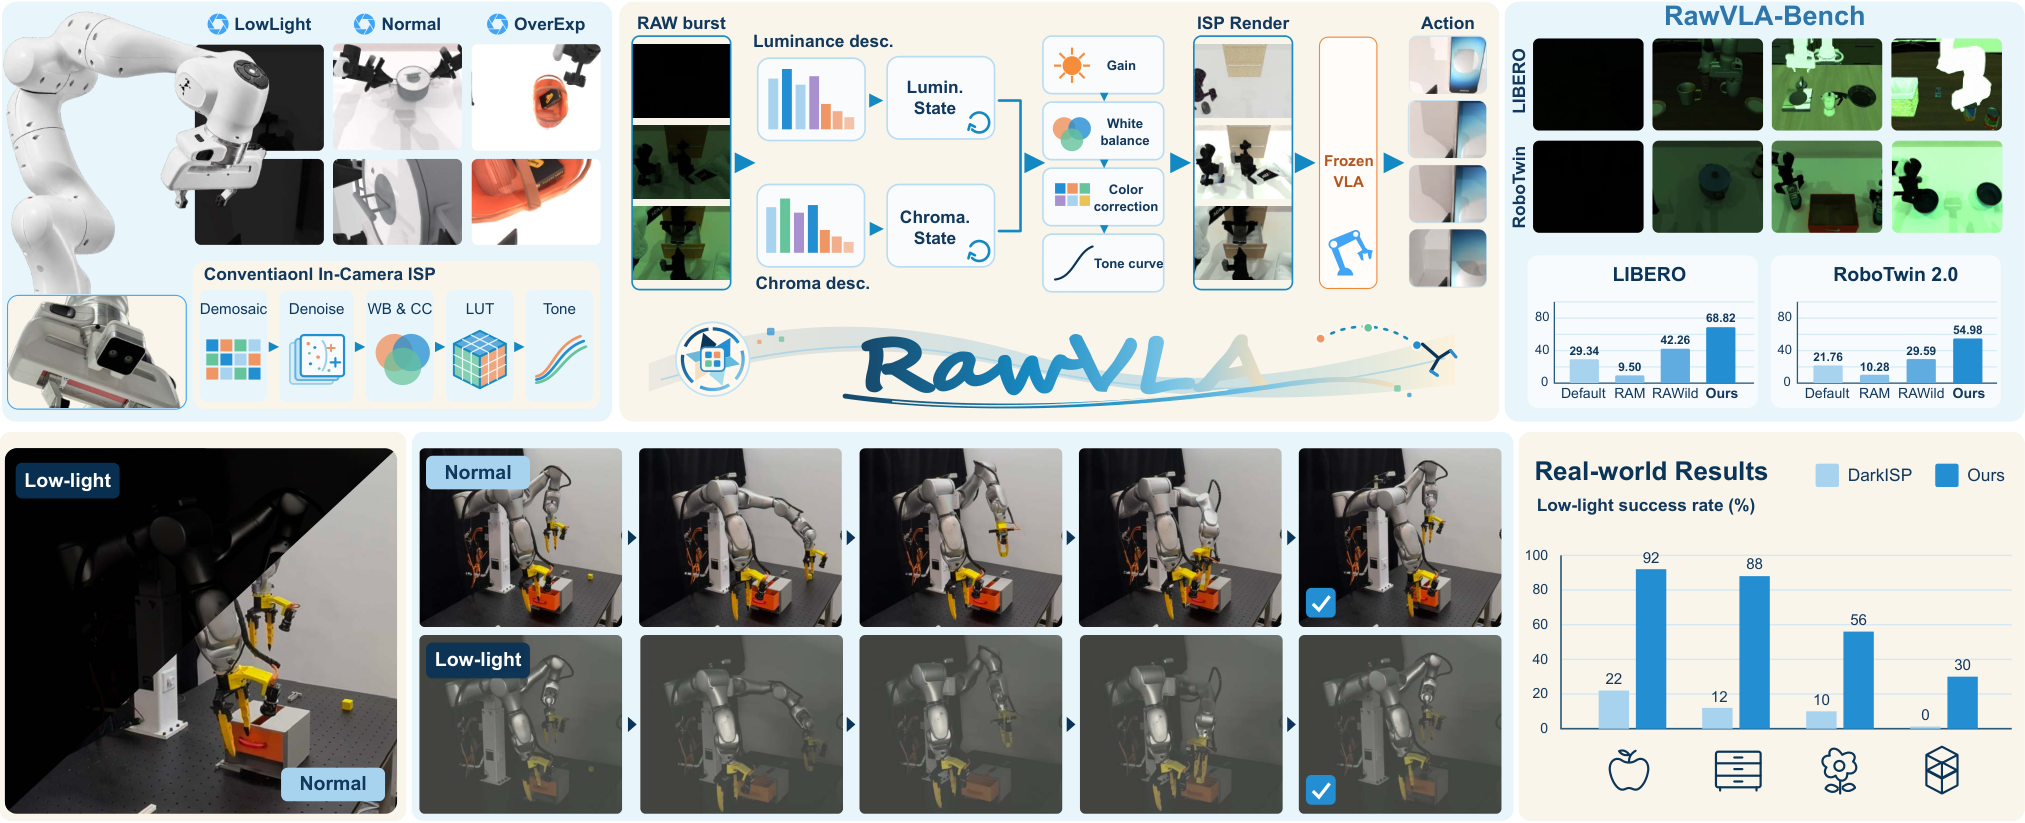
图1|论文总览:RawVLA位于相机原始信号与冻结的机器人策略之间,根据当前光照生成适合动作预测的图像,并在仿真与真机低光任务中比较固定处理流程。
团队先没有急着造新模型,而是做了一个很扎实的诊断:保持场景、机器人状态和任务不变,只改变相机处理链中的一个因素,看动作是否跟着变化。结果显示,曝光、噪声、颜色响应和色调都会影响机器人行为,尤其是曝光。过暗时物体细节沉进噪声,过亮时高光饱和,动作模型会在看似相同的任务中突然失去稳定性。
01|先看最直观的真机演示
下面这段12秒演示来自投稿方提供的对应视频。左右两侧是同一类双臂机器人任务:左边为正常光照,右边为低光环境。它展示的是真机操作对比,不是生成视频,也不是只看单帧画质。

演示|同一双臂操作任务在正常光照和低光环境下的执行过程。低光画面保留了机器人真正面对的成像困难,用于观察视觉前端变化是否能维持动作。
这里最关键的观察不是右边画面有没有被修得像手机夜景,而是机械臂能不能继续完成任务。RawVLA优化的目标不是“拍得漂亮”,而是让后面的视觉—语言—动作模型(VLA)获得更适合判断和控制的输入。图像质量的裁判,从人眼改成了机器人的动作结果。
论文在四项真机双臂任务上报告:正常光照时,固定相机处理平均成功率为76.5%,RawVLA为75.0%,说明加入自适应前端没有明显破坏原本能力;低光时,固定处理降到0,另一种学习式处理达到11.0%,RawVLA保持66.5%。这不是单张图片指标,而是任务是否成功。
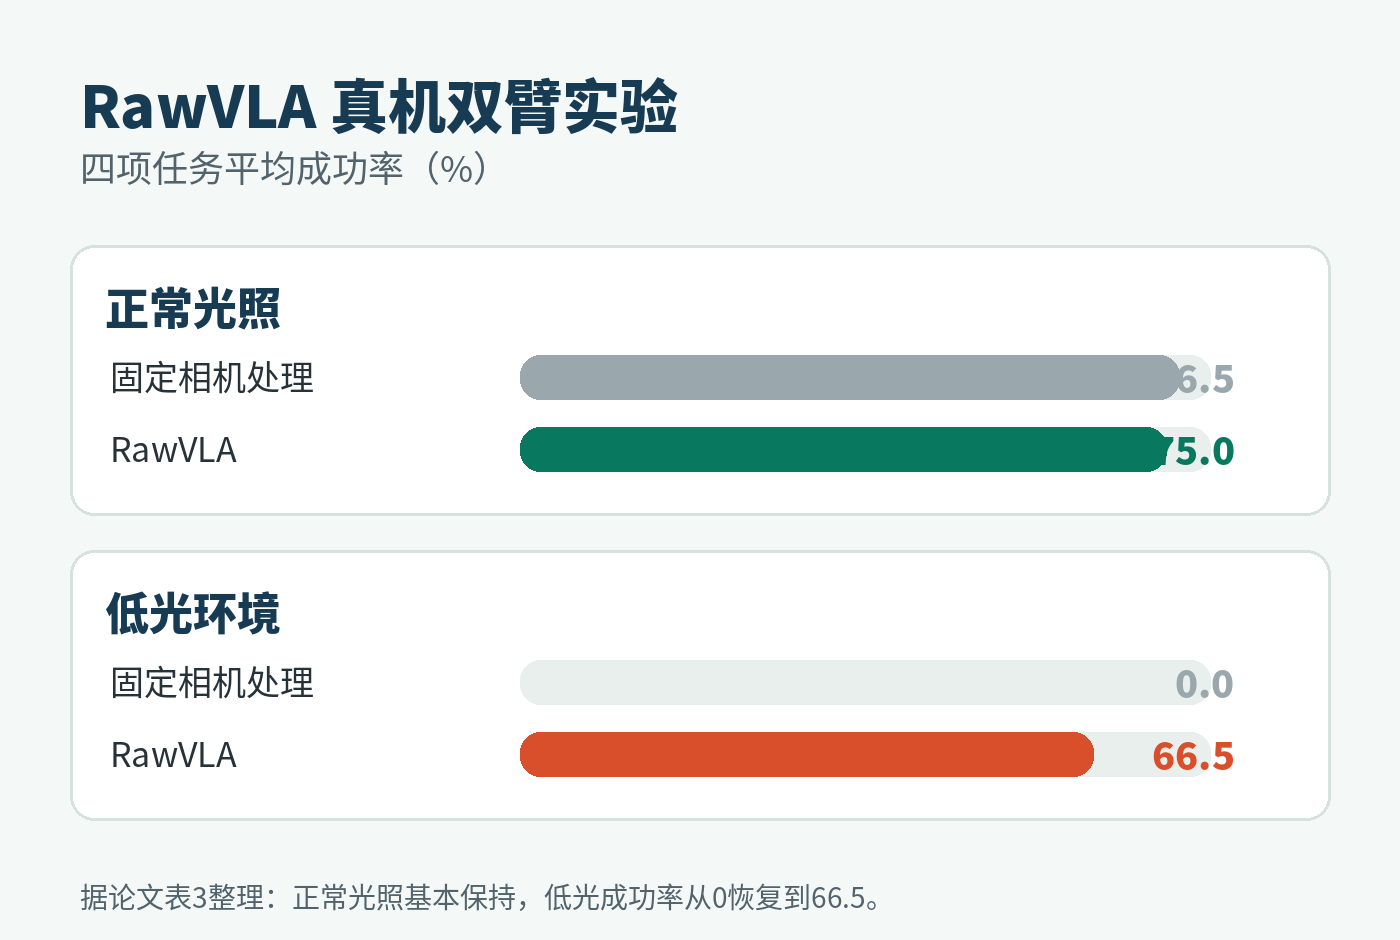
图2|据论文表3整理。正常光照下RawVLA基本保持原策略水平;低光环境下,固定处理从76.5%跌至0,RawVLA仍达到66.5%。
02|为什么换个光照,机器人就像突然“失明”?
人的视觉系统会主动适应明暗变化。进入电影院几分钟后,原本漆黑的座位会逐渐显现;从暗室走到阳光下,眼睛也会收缩瞳孔。机器人相机同样要处理这些变化,只是传统系统往往把这件事交给固定参数:曝光不够就统一提亮,颜色偏了就套一组白平衡,最后再做色调压缩。
问题在于,机器人真正关心的不是整张图平均亮不亮。抓杯子时,杯沿与背景的分离最重要;拉抽屉时,把手轮廓和手臂位置更关键;插接或堆叠时,局部阴影可能决定接触点。固定处理无法知道当前任务在看什么,更不知道哪部分信号应该保留。
论文把相机处理拆成五条轴:曝光决定暗部可见性与高光饱和;传感器噪声会吞掉细节;颜色响应改变通道比例;色调曲线重新分配阴影、中间调和高光;位深决定数值精细程度。逐项扰动发现,曝光和噪声最容易让动作崩溃,极端色调也会明显伤害成功率,而位深在不是特别低时影响相对较小。
这个结论很有工程价值。它说明团队不必让一个巨型网络同时学习所有相机变化,而可以优先把容量放在真正影响动作的因素上。RawVLA没有输出任意像素级修复结果,而是预测曝光、白平衡、颜色校正和单调色调曲线等结构化参数。自由度受控,处理过程也更容易观察。
03|RawVLA的整体流程:先看原始信号,再调相机
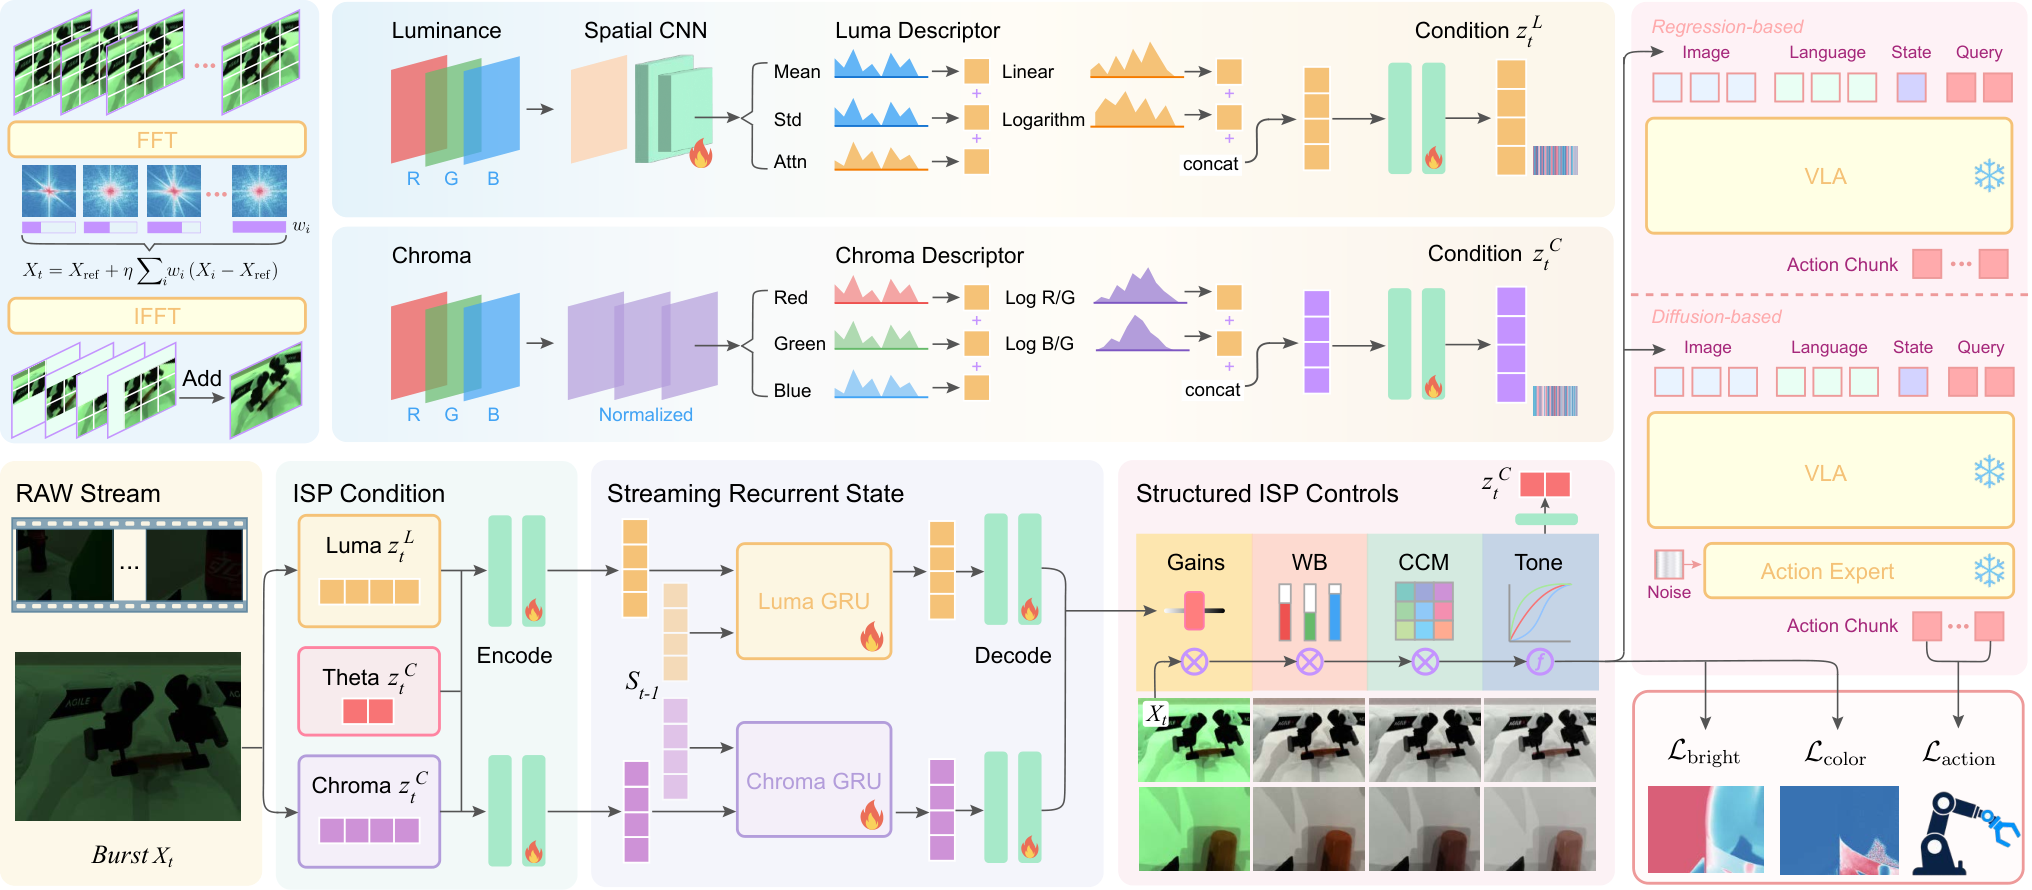
图3|论文方法图。连续原始帧先经过突发降噪,再分别提取亮度与色彩描述;两个循环状态结合上一时刻参数,输出曝光、白平衡、颜色校正和单调色调控制,最后把处理后的图像交给冻结的机器人策略。
整个系统可以理解成四步。第一步,读取连续的传感器原始帧,而不是只拿一张已经处理完的彩色图。多帧信息先用于降噪,给低光环境留下更干净的起点。第二步,分别分析亮度和颜色。第三步,用上一时刻的状态和相机参数帮助当前帧做决定。第四步,把渲染后的图像交给原来的机器人策略预测动作。
论文强调策略主干保持冻结。这一点非常重要:RawVLA不是重新训练一套机器人基础模型,而是在前端适配已经训练好的策略。对真实团队来说,重新收集大规模动作数据、重训策略、再做安全验证代价很高;如果只更新视觉入口,部署门槛会低很多。
亮度状态:记住环境是在变亮还是变暗
亮度分支先把三个颜色通道平均,得到不带色彩偏向的亮度图,再提取空间特征、强度分布、分位数和暗部裁剪比例。对低光来说,对数表示能放大暗区细微变化;对过曝来说,线性直方图和裁剪统计能发现有多少像素已经顶到上限。
这些信息不会只处理当前一帧。循环状态会接收当前描述、上一时刻状态和上一组相机参数,判断应该继续提高曝光,还是已经接近高光饱和。这样做的直觉很像摄影师连续拍摄:不是每帧都从零猜参数,而是根据上一帧的调整结果平滑修正。
色彩状态:把颜色变化与整体明暗分开
颜色分支故意不使用绝对亮度,而是看各通道占比以及红绿、蓝绿之间的对数比例。这样,一幅图整体变暗时,系统不会误以为颜色本身发生了同样幅度的变化。论文把亮度与色彩拆成两个循环状态,就是为了减少“曝光、白平衡和颜色校正都能解释同一个变化”的歧义。
这是方法里很容易被忽略的设计。如果所有参数由同一个黑盒直接输出,网络可能用错误方式补偿:本该提曝光,却过度拉色调;本该改白平衡,却用通道曲线硬扳。短期训练损失可能下降,换场景后却不稳定。分开建模让每类参数承担更明确的职责。
04|两个公式,用白话讲清系统在算什么
论文把流式更新写成:当前输出图像、当前内部状态和当前相机参数,由当前原始帧、上一时刻状态以及上一组参数共同决定。符号看起来复杂,核心只有一句话:这一帧怎么处理,不只看这一帧,还要记住刚才发生了什么。
其中,输出图像是送给机器人策略的观察;内部状态保存亮度和颜色随时间变化的线索;相机参数则是真正执行的曝光、白平衡、颜色矩阵和色调曲线。这个递推关系避免视频里每帧参数乱跳,否则机器人看到的颜色和亮度会闪烁,动作判断反而更不稳定。
另一组公式计算颜色比例:每个通道除以三通道总和,再计算红色相对绿色、蓝色相对绿色的对数比。分母加入一个很小的数,避免暗部接近零时除法失效。它的直觉是先把“有多亮”拿掉,只保留“颜色之间是什么关系”,从而把白平衡与曝光分开处理。
公式的局限也很明确。结构化参数提高了可解释性,却限制了它能表达的变化。如果场景问题来自严重运动模糊、镜头污渍、复杂鬼影或局部强反射,仅靠全局曝光、颜色和单调曲线未必够用。论文解决的是对机器人行为最关键的一组成像因素,不是所有视觉退化。
05|训练目标为何不用“更好看”来监督?
RawVLA通过机器人原本的动作目标训练。处理后的图像进入冻结策略,策略预测动作;如果视觉前端让动作更接近正确轨迹,前端就得到正向反馈。也就是说,曝光和颜色参数不是为了模仿某张漂亮参考图,而是为了减少动作误差。
这会产生一个看似反直觉的结果:最适合机器人的图,不一定是人眼最喜欢的图。某些局部可能对人看起来偏暗,但关键边缘更稳定;某些颜色未必自然,却能让策略更容易区分目标。只要处理保持在结构化、单调且合理的相机控制范围内,任务目标可以成为比主观画质更直接的监督。
论文还保留了正常光照能力。真机结果中RawVLA在正常环境为75.0%,固定流程为76.5%,差距很小;这说明模型没有为了低光鲁棒性,把正常场景全部改成奇怪风格。对部署而言,避免“治好极端场景却伤害日常场景”与提升最差表现同样重要。
06|RawVLA-Bench为何比普通增强数据集更重要?
团队构建的RawVLA-Bench把相机处理正式变成机器人评测变量。它基于两套常用机器人仿真环境,覆盖40项任务、10000次配对评测,以及13项双臂任务、3250次配对评测。每个场景都有正常、低光、极低光、过曝和极端过曝等对应条件。
“配对”二字很关键。它尽量固定场景、任务和机器人状态,只改变成像条件。这样才能判断成功率下降究竟来自光照,还是来自随机初始位置、物体摆放或任务难度变化。普通图像增强数据集往往只比较像素质量,而这里比较的是动作是否完成。
在RoboTwin 2.0上,RawVLA跨策略平均成功率为54.98%,相对最强学习式图像处理基线提高85.81%,并在不同不利光照条件下都排在第一。最大的收益来自低光,过曝条件同样有改善,说明它不只是一个单方向提亮器。
不过,仿真基准仍然不能替代真机。模拟的传感器噪声、光谱响应和镜头特性与真实相机存在差异。这也是论文同时做四项真机双臂任务的原因。两层证据放在一起,才比只给模拟数字更有说服力。
07|速度够不够实时?
机器人视觉前端不能慢慢修图。论文报告RawVLA达到每秒168帧,快于实验相机的原生帧率;参与比较的图像处理模块也都能实时运行。这意味着在论文所用硬件和实现下,前端不是动作控制的主要速度瓶颈。
但部署团队仍要重新测量。每秒168帧是作者环境中的推理结果,不代表所有边缘芯片、相机分辨率和多相机系统都能达到同样速度。突发降噪需要连续帧,循环状态也要保持;一旦相机数量增加,内存带宽、图像搬运和同步成本可能比网络本身更突出。
真正值得肯定的是它没有用一个巨大生成模型去“重画”画面,而是预测少量有物理意义的相机参数。结构化输出既减少计算,也方便工程排查:团队可以直接检查曝光是否过高、白平衡是否漂移、色调曲线是否过激。
08|与RAWild等工作放在一起看
RawVLA并不是凭空出现。2026年同一研究脉络中的RAWild研究跨传感器目标检测,让共享网络根据输入分布生成全局曲线和局部颜色变换。它的下游任务是静态视觉检测,回答的是“换相机后还能不能看见目标”。
RawVLA把问题推进到连续机器人行动:视觉前端不仅面对不同传感器和光照,还要维持时间连续,并接受动作损失监督。RAWild更强调全局曲线与局部网格;RawVLA则引入亮度、色彩两个循环状态,把上一时刻相机参数带入下一帧。两者共同说明,相机处理正从固定预处理变成任务系统的一部分。
论文还与DarkISP、RAW-Adapter等学习式图像处理方法比较。这些方法已经尝试面向下游任务优化原始信号,但RawVLA进一步把动作成功率、流式状态和冻结机器人策略放进闭环。它的新增价值不只是另一种增强网络,而是把“相机怎样看”与“机器人怎样动”直接连接起来。
相关工作入口:
RAWild论文:
https://arxiv.org/abs/2605.05941
09|代码、数据和复现应该怎么看?
项目页面已经开放RawVLA-Bench数据集和大量仿真、真机演示,论文全文也可下载。页面当前明确标注代码仍在准备中,因此本文不把它写成已经可以一键运行的开源项目。对希望复现的团队,目前最有价值的是数据协议、方法细节和公开演示。
数据集入口:
https://huggingface.co/datasets/ToferFish/RawVLA-Bench
项目演示:
https://shuhongll.github.io/rawvla/
真正复现时至少要核对四件事:原始相机数据如何去马赛克与降噪;仿真彩色图怎样反演为伪原始信号;机器人策略的动作损失如何传回视觉前端;循环状态在任务切换和相机断流时怎样重置。这些细节会直接影响结果,不能只照着网络结构图搭一遍。
10|这项工作还有哪些限制?
第一,真机实验有四项双臂任务,已经比只做仿真更扎实,但任务规模仍有限。不同材质、镜面物体、户外强逆光、快速运动和更长时程任务是否同样受益,需要更多设备与场景验证。
第二,方法依赖传感器原始信号。很多消费级相机、网络摄像头或封闭机器人平台只输出已经处理的彩色图,无法直接接入这条链。要发挥优势,硬件和驱动必须允许访问原始数据,并保证时间同步。
第三,动作损失让图像服务于特定策略,也可能形成策略依赖。对一种机器人策略最有利的渲染,未必同样适合另一种模型或人类远程操作者。论文在多种策略与基准上比较,但跨架构迁移仍值得继续研究。
第四,低光成功率66.5%很亮眼,但不是完全解决。剩余失败可能来自视觉、动作策略、机械控制、遮挡或接触误差。视觉入口恢复了大量能力,不等于机器人在所有暗光环境都已经可靠。
11|基准数据是怎样把光照问题单独拎出来的?
真实机器人数据里,光照、物体位置、机械臂轨迹和相机噪声常常一起变化。如果只比较两次独立运行,很难判断成功率差异究竟由哪个因素造成。RawVLA-Bench采用配对评测:同一个场景、同一项任务和对应的机器人状态,生成多种成像条件,再让不同处理方法面对同一组挑战。
论文先从仿真渲染缓冲区恢复近似的传感器原始信号,再重新施加曝光、噪声、颜色响应、色调和量化。这个过程不是随便把彩色图调暗,而是尽量按照相机成像链拆分变量。低光既意味着信号变弱,也会让噪声相对更明显;过曝则会把高光区域压到饱和,细节一旦丢失就无法靠简单降低亮度找回来。
论文的总处理公式可以读成一条流水线:先改变曝光,再加入传感器噪声,然后调整颜色响应,接着映射阴影、中间调和高光,最后按指定位深量化。研究者每次只改变其中一项,其他条件保持不动,因此可以看到动作模型对哪类变化最敏感。
结果显示曝光是最关键的轴:动作成功率只在默认值附近的一段范围内稳定,严重欠曝和过曝都会导致崩溃。噪声在较轻时还能承受,进入中高强度后快速恶化;颜色偏移的影响与模型训练中的视觉增强有关;极平或极强的对比度也会伤害操作;位深只有降得非常低时才出现明显问题。
这套分析反过来指导了RawVLA的结构。既然亮度和颜色变化的作用不同,就不让一个状态同时承担全部判断;既然位深相对不敏感,就不必把大量模型容量花在任意量化恢复上;既然极端曝光会丢失信息,就必须尽可能从相机原始信号和连续帧中保留可用细节。
12|如果要接入真实机器人,团队应该先检查什么?
第一,确认相机能否稳定输出原始数据。不同设备可能提供拜耳阵列、去马赛克线性图或厂商私有格式,黑电平、白电平和通道排列也不同。输入定义不一致,后面的曝光与颜色参数就没有统一物理含义。
第二,保留准确的时间戳与多相机同步。RawVLA利用连续帧和循环状态。如果手腕相机、第三人称相机与机器人关节状态错位,系统可能把前一刻光照与后一刻动作错误对应,视觉前端再聪明也难以补救。
第三,为正常场景设置保护指标。不能只在最暗环境看提升,还要持续检查正常光照、轻微过曝和颜色变化下的原有成功率。论文真机实验把正常光照75.0%与固定流程76.5%并列报告,就是为了说明鲁棒性没有靠牺牲日常能力换来。
第四,把视觉故障与控制故障分开记录。每次失败应同时保存原始帧、处理后图像、相机参数、策略输出和机械臂执行结果。只有这样,团队才能判断是画面仍不可用、策略理解错误,还是控制器没有正确执行。
第五,先从受控小任务验证,再扩到开放环境。抽屉、抓取、插接等任务可以建立明确成功标准,也方便重复测试。直接在户外复杂场景上混合光照、运动模糊、反射和遮挡,会让任何改动都难以归因。
从产品路线看,这套方法最适合已经拥有较强机器人策略、但在不同相机和复杂照明下表现不稳的团队。它不是替代动作模型,而是把相机到策略之间长期被忽略的接口变成可学习、可观测、可单独迭代的模块。
13|它与普通低光增强,差别到底在哪里?
普通低光增强通常有一张目标图:更亮、更干净、颜色更自然,或者在像素指标上更接近参考。RawVLA没有要求输出必须符合某种统一审美。它关心的是处理之后,机器人策略能否给出正确动作。因此,同一幅原始图面对不同任务,理论上可能需要不同的曝光与色调选择。
第二个差别是时间。单张增强可以逐帧独立运行,但机器人连续控制不能接受亮度和颜色忽明忽暗。RawVLA把上一时刻状态和相机参数带入当前更新,目的不仅是提高单帧可见度,还要保持连续观察的一致性。机械臂正在靠近目标时,视觉表示突然跳变,可能比画面稍暗更危险。
第三个差别是系统位置。普通增强常被当作可选预处理,效果不好就换一个算法;RawVLA则把视觉前端纳入动作训练闭环。这样做能让参数更贴近任务,却也要求数据、策略、相机和控制系统一起验证。它更像机器人感知系统的一部分,而不是一个独立修图插件。
所以,不能简单地把这项结果理解为“低光增强让成功率提高66.5个百分点”。更准确的说法是:在论文的四项真机双臂低光任务中,由动作目标训练的自适应相机处理,让冻结机器人策略从固定处理下的完全失败,恢复到平均66.5%的任务成功率。
14|龙哥点评:机器人“大脑”之前,还有一双会适应的眼睛
龙哥看完最强烈的感受是,机器人行业很容易把所有希望押在更大的视觉—语言—动作模型上。但真实系统是一条链:光线先经过镜头和传感器,再经过相机处理,最后才进入模型。链条前面丢掉的信息,后面的大模型未必能凭空找回来。
RawVLA不是给机器人换大脑,而是让它的眼睛学会随环境调整。这类工作看起来没有万亿参数那么轰动,却很可能更接近产品落地。因为团队可以保留已有策略,把改动集中在相机与模型之间的接口。
它也给图像增强研究一个提醒:画质指标不是终点。低光增强、去噪、白平衡和色调映射,如果最终服务检测、分割或机器人控制,就应该让下游任务参与评价。人眼觉得自然,只是一个目标;机器能否稳定完成任务,是另一个更直接的目标。
更长远地看,未来的机器人基础模型可能需要把相机、触觉、声音等传感器前端一起纳入学习。不是让大模型吞下所有原始数据,而是让每个入口保留物理结构,再根据任务选择最有用的信息。RawVLA展示的是其中很具体的一步:先让视觉入口不再固定。
15|龙迷三问
第一,你的机器人失败,真的是动作模型不会吗?如果失败集中发生在暗光、逆光或换相机之后,先检查输入处理链,可能比继续堆动作数据更有效。
第二,你优化的是人眼画质,还是任务成功率?两者可以一致,也可能冲突。产品团队应该提前定义最终裁判,避免每个模块各自刷自己的指标。
第三,硬件是否愿意把原始数据交给算法?如果相机只给固定处理后的图像,再聪明的前端也没有足够空间。未来机器人软硬件协同,可能首先从开放传感器接口开始。
一句话总结:RawVLA把相机从固定的数据出口,变成了会为动作目标调整的机器人视觉器官。低光成功率从0恢复到66.5%,说明真实世界里的“看得见”,远不只是把图片调亮。
本文基于龙哥读论文PaperDaily数据库及PaperMiner的MCP进行汇总整理。本文为论文解读与个人学习笔记,不构成任何论文审核意见,及对产品能力、安全性或商业可用性的保证。

还没有公开留言,欢迎留下你的看法。