← 返回 PaperDaily
大模型与智能体
智能体翻文件总漏关键表?MIT用双层经验一次补齐
想象一个干了十年的财务顾问,面对杂乱报表,他翻完一遍后脑中会留下便签:“这张表够用”,“那份文件跳过”。下次再来任务,他按便签取该看的东西,既快又准。
龙哥读论文
发布于 2026-10-16 01:12:05
阅读 12
查看原文
原论文信息如下:
告别金鱼记忆:AI智能体如何像人类一样积累“经验”? 想象一个干了十年的财务顾问,面对杂乱报表,他翻完一遍后脑中会留下便签:“这张表够用”,“那份文件跳过”。下次再来任务,他按便签取该看的东西,既快又准。
法律、咨询、科研、写代码等知识密集型行业,任务多变但语料相同。人类熟练度提升,更多是对语料熟悉。
AI 智能体也有记忆,但锚点不对。一类记用户画像,适用于对话历史任务;另一类记抽象推理套路,记的是“怎么做题”,不是“哪些材料有用”。
智能体翻过的文件、表格、代码,没留下印象。下次遇到相关任务,仍会重新翻,浪费时间。这是“金鱼记忆”。
MIT 联合 McKinsey & Company、Oracle AI & UPenn、AI2 的论文提出 ExpIdx,给智能体加“经验层”,把记忆锚点从“用户”挪到“具体语料条目”。作者包括 Peter Baile Chen、Geoffrey X. Yu、Xinming Liu、Samuel Madden、Dan Roth、Jacob Andreas、Doug Downey、Michael Cafarella。
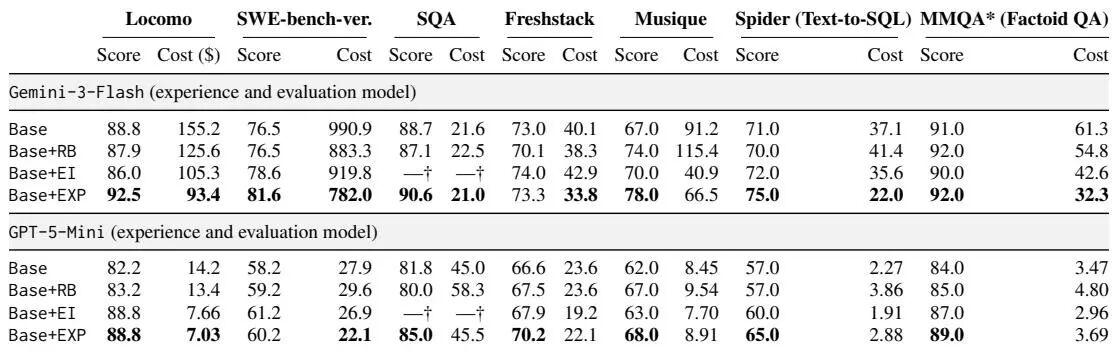
结果:在多个知识密集型任务上,答案质量提升,在线成本下降 50.5%。
ExpIdx 核心揭秘:以 artifact 为锚点的双层经验记忆 术语“artifact”指共享语料中被检索和引用的基本单位:一篇文档、一张数据表、一个文件、一段代码。ExpIdx 记忆围绕“相关性”和“完整性”设计成两层。
ExpIdx 记三样东西:任务描述、贡献摘要、片段。它们与领域无关、与模态无关,作用是让后续任务判断“材料是否相关”有依据,省 token。
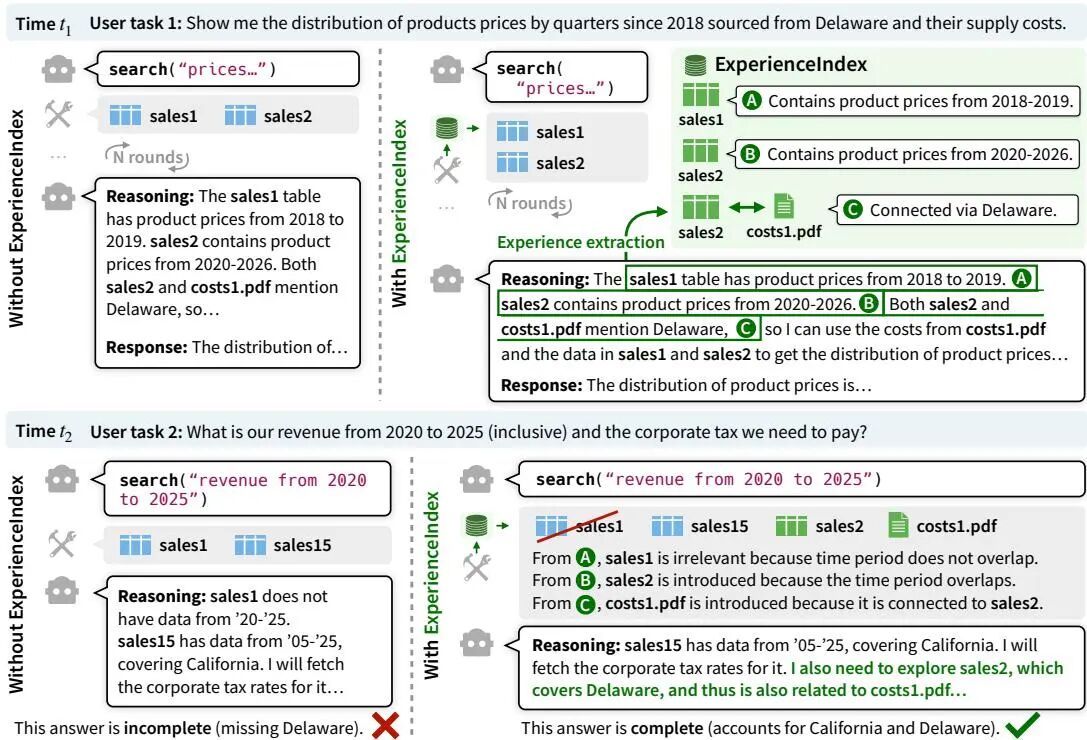
ExpIdx 还记第二层:artifact-pair experience,条目对经验。文档和文档、文档和表格之间,关系由重叠的实体定义。找到一张表,顺着它的关系线能带出相关联的邻居表。
图1 例子:任务 2 中,搜索工具返回 sales1 和 sales15。sales1 时间范围不对,被剔除;sales2 时间范围对上,被保留;顺着条目对经验 C,把通过“特拉华州”关联的 costs1.pdf 带进来。
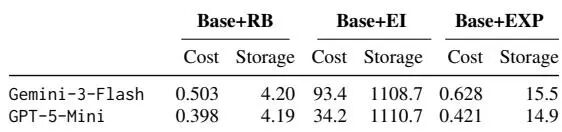
论文对标离线语料增强路线:EnrichIndex。它在离线阶段给每份材料贴标签,前期成本高,假定能访问整个语料。ExpIdx 只从“跑过的任务”学习,增量更新,成本随任务数增长。
从检索到注入:ExpIdx 如何作为中间件改造智能体工作流 论文把 ExpIdx 做成中间件,塞在已有智能体方案和模型之间。已有方案指 ReAct:让模型“想一步”和“做一步”交替进行。ExpIdx 加入检索与注入步骤,提升效率。
检索机制接收文本查询 q 和语料条目编号集合 A_ID。找候选、判相关性、扩邻居三步走。注入步骤改工具输出和系统提示词。
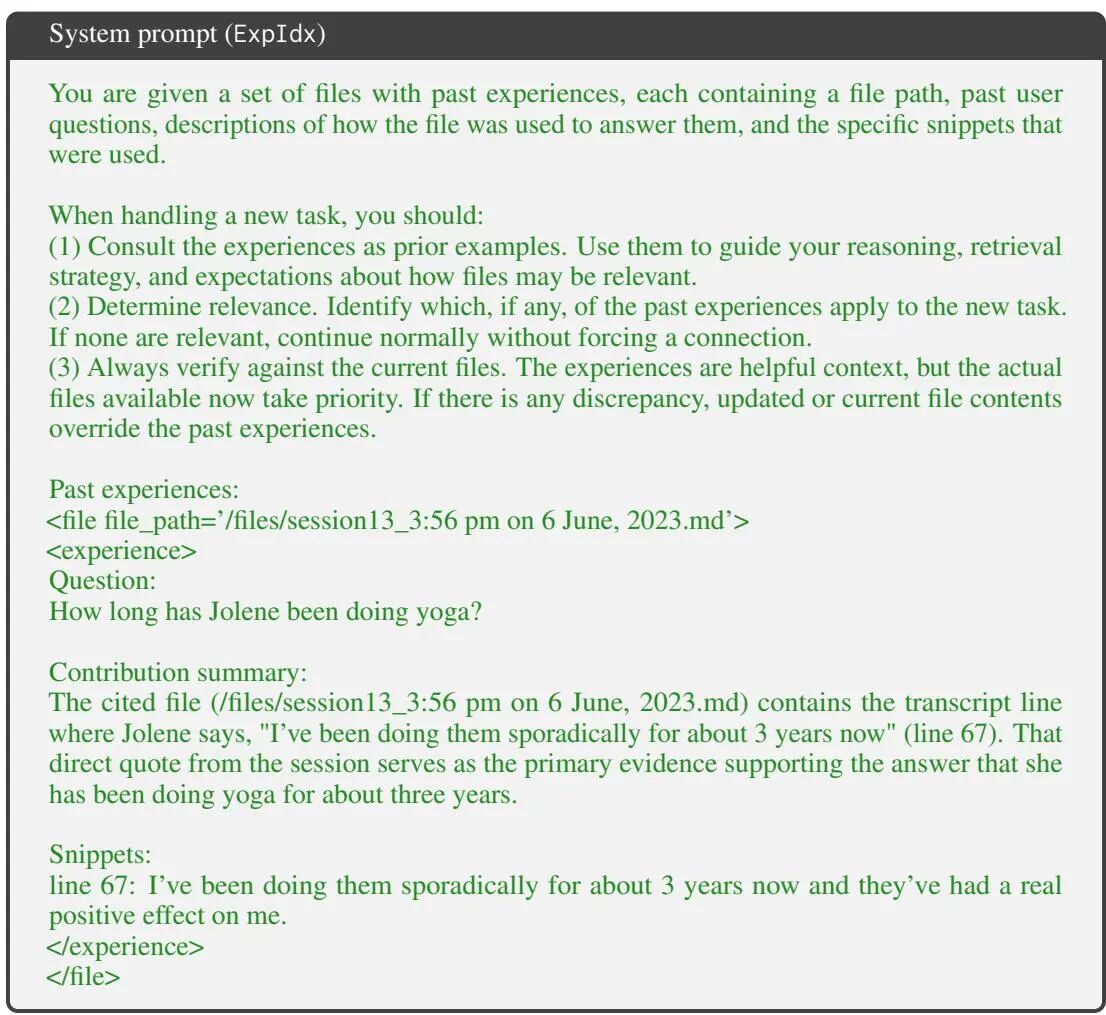
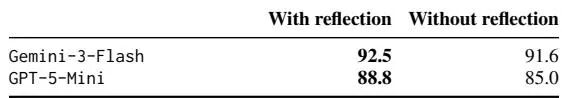
提示词内嵌轻量反思步骤,要求智能体评估经验和条目的相关性,发现冲突时以当前条目为准。
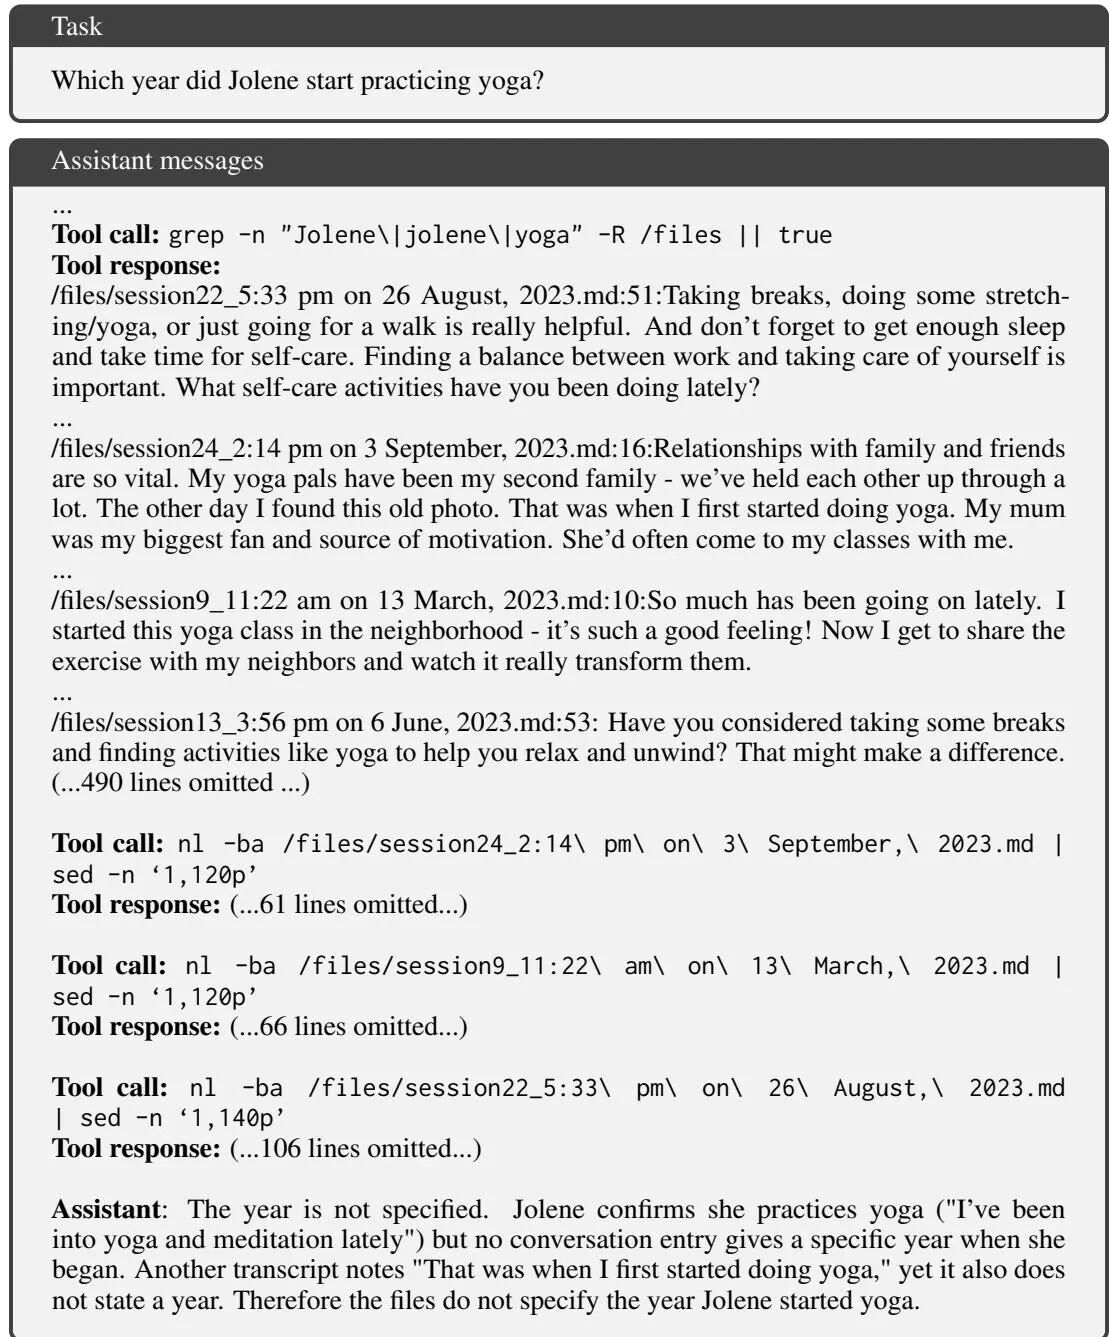
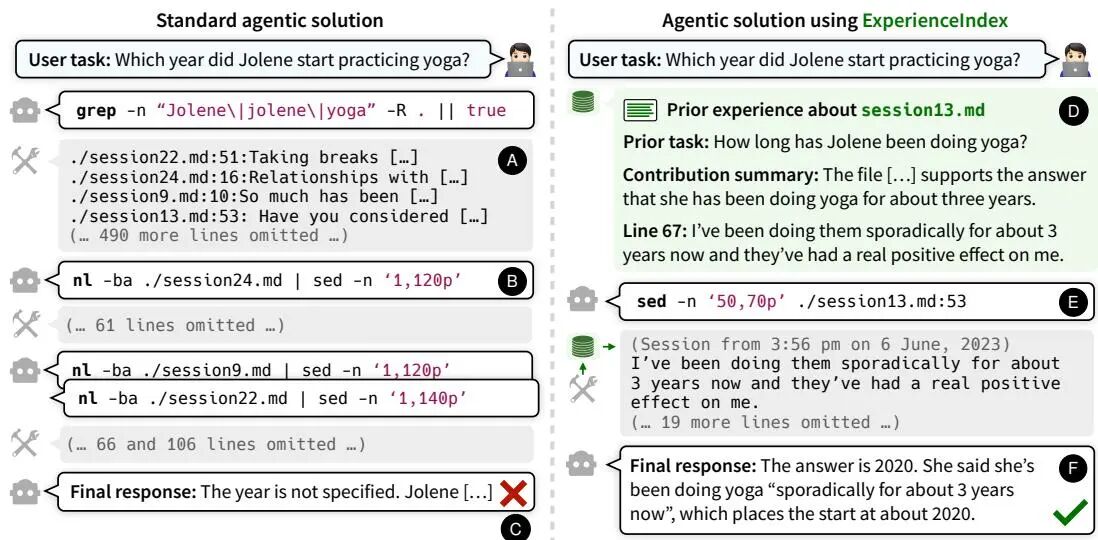
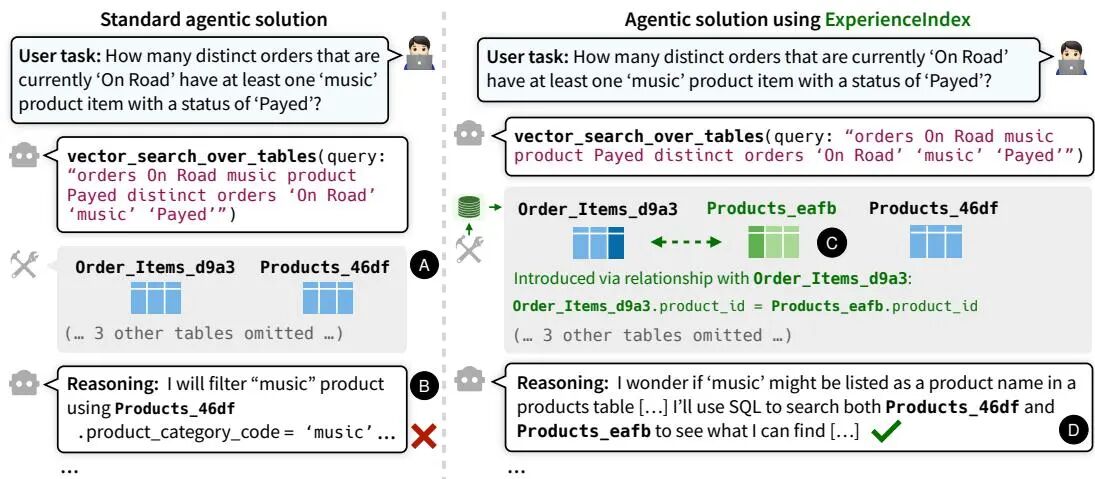
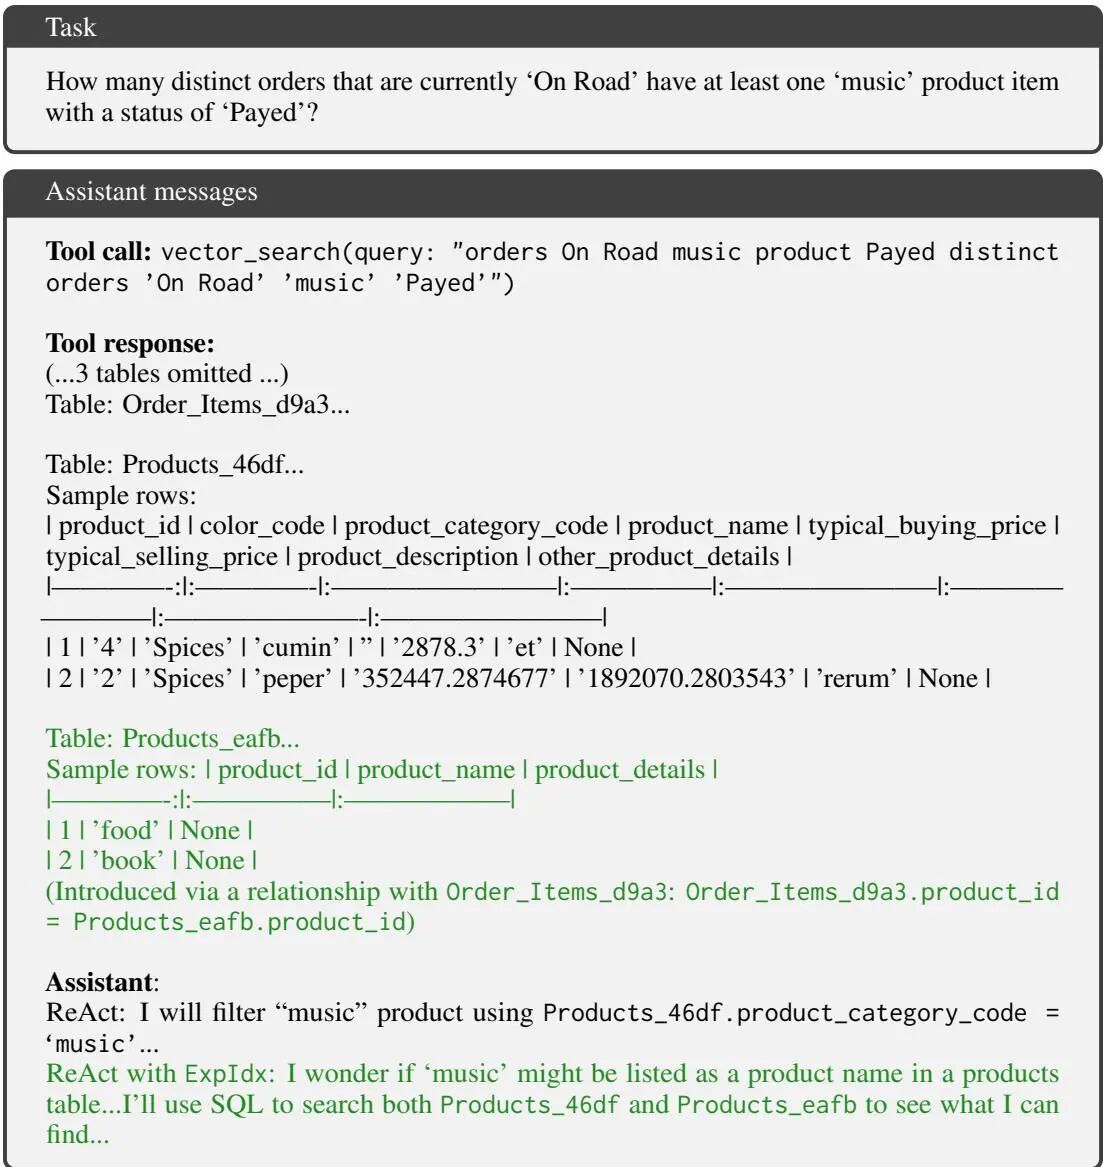
论文在 Locomo 数据集上给出具体任务对照。标准方案需反复翻找,ExpIdx 版本在开始阶段就把相关文件和片段摆到桌面上。
两张表对照显示:标准方案需反复翻找,ExpIdx 版本在开始阶段就把相关文件和片段摆到桌面上。
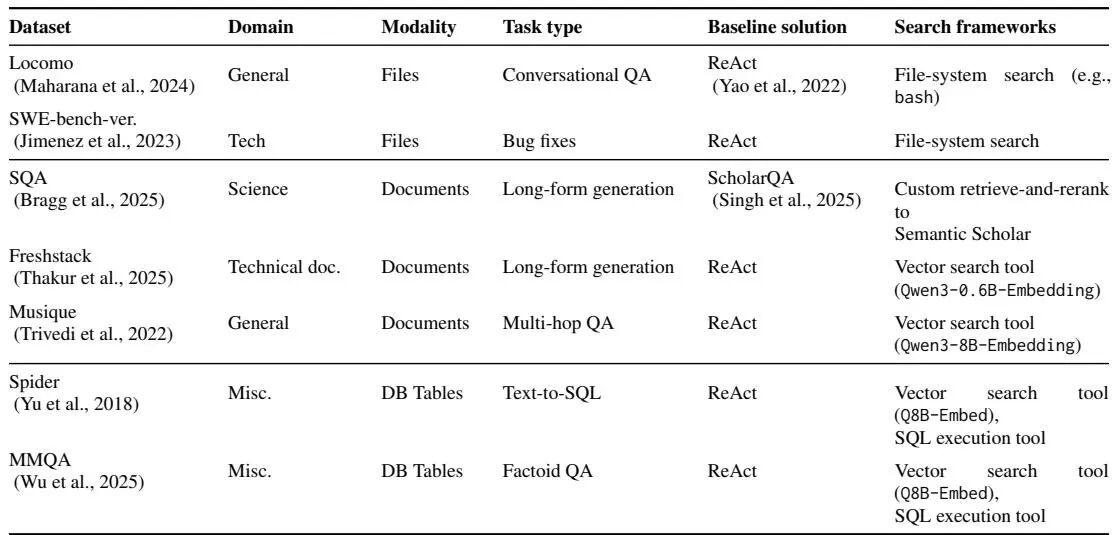
实验全面领先:答案质量提升 11 分,成本降低 50% 论文选七个知识密集型数据集,验证 ExpIdx 的通用性:能支撑各种跑在共享语料上的工作负载,能接入各种不同的搜索框架。
基线方案上,SQA 用 ScholarQA,其余数据集用 ReAct。对比方法有 ReasoningBank 和 EnrichIndex。EnrichIndex 在 SQA 上无结果,因为需离线访问完整语料。
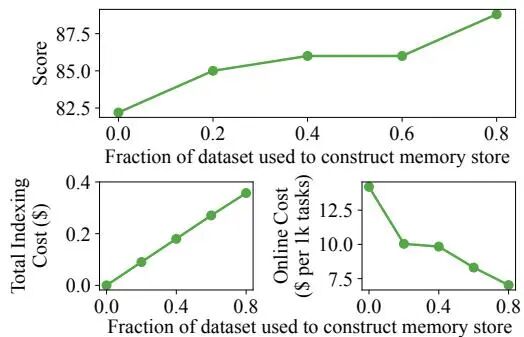
评测协议:每个数据集分“经验任务”和“评估任务”,经验任务占 80%。先让基线方案跑经验任务,收集推理轨迹,再由各记忆方案从轨迹里抽经验、建索引。然后在评估任务上测“有记忆”和“无记忆”两种状态。
指标分两个阶段。在线阶段报告平均答案分数和在线成本,成本按每千个任务多少美元计。索引阶段报告索引成本和存储占用。
实验设计扎实:数据集覆盖多个领域,模态从文件到数据库表,任务类型多样。用两个不同底座模型减少对单一模型依赖。
方法为何有效?知识密集型任务瓶颈在于“该看的没看全,不该看的看了一堆”。ExpIdx 提供准确完整材料,提升模型表现,降低 token 消耗。
消融实验支持判断:相关性分类模型影响最终得分,反思机制纠偏作用明显。
成本结构差异值得注意。EnrichIndex 开销随语料规模线性增长,ExpIdx 随任务数增长。
结果不全胜:SWE-bench-verified 上 ExpIdx 略低于 EnrichIndex;MMQA 上 ExpIdx 在线成本高于无记忆基线。SQA 缺 EnrichIndex 对照。
跨任务泛化与教师-学生学习:经验记忆的意外之喜 跨任务泛化:写 SQL 学到的经验,用来做事实问答
论文验证 Spider 和 MMQA 共享数据库表,用 Spider 的推理轨迹构建记忆库,跑 MMQA。结果 MMQA 分数提升,超过离线增强基线和抽象记忆。
ExpIdx 存的是关于语料的知识,任务换了,经验仍能用。
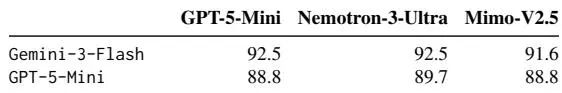
论文发现经验可跨模型迁移。用 Gemini-3-Flash 生成经验,交给 GPT-5-Mini 使用。结果 GPT-5-Mini 分数追平强模型,成本大幅降低。
在 Locomo 上,GPT-5-Mini 用 Gemini-3-Flash 经验,分数追平强模型,成本降低。
经验层价值不只是“省搜索次数”,还是强模型判断力的沉淀机制。
总结与展望:从无锚点记忆到 artifact 锚定记忆的范式转变 论文贡献:记忆锚点从“用户”换成“语料条目”;记忆内容从“抽象套路”换成“具体贡献和关系”;成本曲线从“随语料规模增长”换成“随任务数增长”。
边界:依赖搜索框架返回条目编号,模型写出靠谱经验摘要,经验会过时,非文本模态支持间接,实验用静态记忆库。
经验库具“组织资产”属性。个人经验可沉淀成团队共享索引,跨会话、跨智能体复用。工程问题:经验审核、失效、冲突裁决。
龙迷三问 这篇论文到底在解决什么问题? 知识密集型任务里,智能体每次都要把语料库翻个底朝天。MIT等提出ExpIdx,把记忆锚在具体artifact上,用单件经验与成对经验指导检索:答案质量最高涨11分,在线成本最多降50.5%,索引成本比离线增强方案低115倍。这篇工作最值得看的点是什么? ExpIdx在所有数据集上一致提升答案质量,最高提升11.0分,同时降低在线成本最高达50.5%。平均而言,答案分数相对最强基线EnrichIndex提升3.9%,在线成本降低20.8%。索引成本比EnrichIndex降低115倍,存储占用降低73倍。在跨任务泛化(Spider到MMQA)和教师-学生学习(强模型经验迁移到弱模型)方面也表现出色。这篇工作的边界或风险在哪里? 优点:(1)以artifact为锚点的记忆设计新颖且通用,支持多种模态和搜索框架;(2)轻量中间件设计,易于集成;(3)在多个数据集上一致提升答案质量并降低成本;(4)支持跨任务泛化和教师-学生学习;(5)索引成本和存储占用远低于离线增强方法。缺点:(1)经验提取依赖LLM,可能引入噪声;(2)经验检索的相关性分析需要额外LLM调用,增加一定开销;(3)未与更多类型的记忆方法(如参数化记忆)进行对比;(4)在部分数据集上提升幅度有限(如MMQA仅提升1分)。如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~
龙哥点评 论文创新性分数: ★★★★☆
把记忆锚点从“用户”和“抽象套路”挪到“语料条目”,这个视角切换是有价值的,条目对经验这一层尤其点睛;不过底层用到的检索、嵌入、LLM 分类都是现成组件,属于组合式创新。
实验合理度: ★★★★☆
七个数据集、两种底座模型、两类对比方法,覆盖面扎实;扣分点在于 SQA 缺少 EnrichIndex 对照,以及逐格结果并非全胜,平均值的说服力强于单点。
学术研究价值: ★★★★☆
它把“长期记忆”这个笼统话题切出了一个明确子问题——以语料为导向的经验复用,并且给出了可复用的表示结构,后续工作可以在它上面继续加东西。
稳定性: ★★★☆☆
经验可能过期、可能被错误摘要污染,论文用反思机制和“以当前语料为准”的规则来缓解,但静态记忆库的实验设定离真实持续更新场景还有距离。
适应性以及泛化能力: ★★★★☆
跨领域、跨模态、跨任务类型都做了验证,还演示了从文本转 SQL 到事实问答的跨任务迁移,泛化能力在同类工作中算突出;但对非文本模态需要借助底座模型转写,存在间接依赖。
硬件需求及成本: ★★★★☆
在线成本相比基线下降约两成,索引成本相对离线增强低两个数量级,这是它最硬的优势;代价是每次检索要多跑一次嵌入匹配和一次 LLM 相关性判定,属于可接受的开销。
复现难度: ★★★☆☆
方法本身不复杂,但涉及搜索框架改造、提示词工程、嵌入模型和相关性分类模型的选型等一堆工程细节,想跑出论文里的数字,需要把每个环节都调对。
产品化成熟度: ★★★☆☆
作为中间件,非侵入、易接入,产品化的形态是对的;但经验库的质量维护、失效处理、多用户共享时的权限与冲突问题都还没解决,属于“能试、暂时别当核心依赖”的阶段。
可能的问题: 问题定义清晰、系统设计完整,但核心组件多为现成模块的组合,理论贡献偏薄;静态记忆库的评测设定与真实持续更新场景存在落差,逐格结果也并非全面领先,平均值的叙事略强于单点证据。
主要参考文献
Peter Baile Chen, Geoffrey X. Yu, Xinming Liu, Samuel Madden, Dan Roth, Jacob Andreas, Doug Downey, Michael Cafarella. ExperienceIndex: Artifact-Grounded Memory. arXiv:2610.10091. https://arxiv.org/pdf/2610.10091v1.pdf Shunyu Yao, et al. ReAct: Synergizing Reasoning and Acting in Language Models. 2022. Ouyang et al. ReasoningBank: Scaling Agent Self-Evolving with Reasoning Memory. 2025. Chen et al. EnrichIndex: Offline Corpus Enrichment for Retrieval. 2025. Singh et al. ScholarQA: A Retrieval-Augmented Generation System for Scientific Question Answering. 2025.
人的经验锚在具体的事上,AI的记忆也可以锚在具体的文档上 😄
欢迎加入龙哥读论文粉丝群,
扫描下方二维码或者添加龙哥助手微信号加群 :kangjinlonghelper。
一定要备注:研究方向+地点+学校/公司+昵称(如 大模型+上海+MIT+龙哥) ,根据格式备注,可更快被通过且邀请进群。
『龙哥读论文』微信群目前包含:图像处理、大模型及智能体、自动驾驶及机器人、AI医疗及AI金融5个群
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击 "阅读原文", 查看更多原论文细节哦!
还没有公开留言,欢迎留下你的看法。