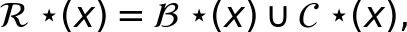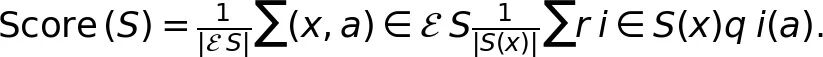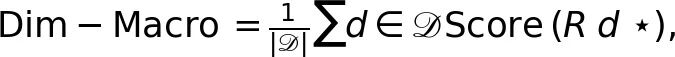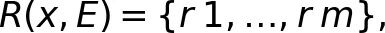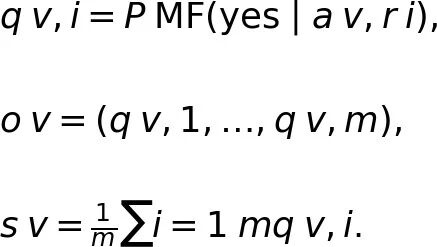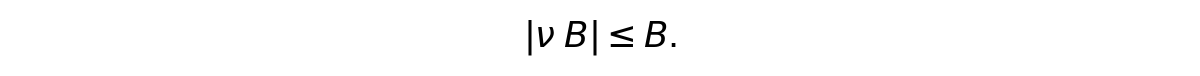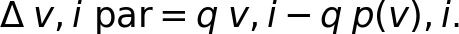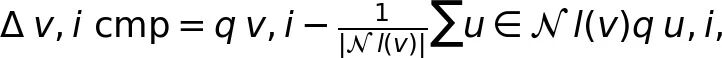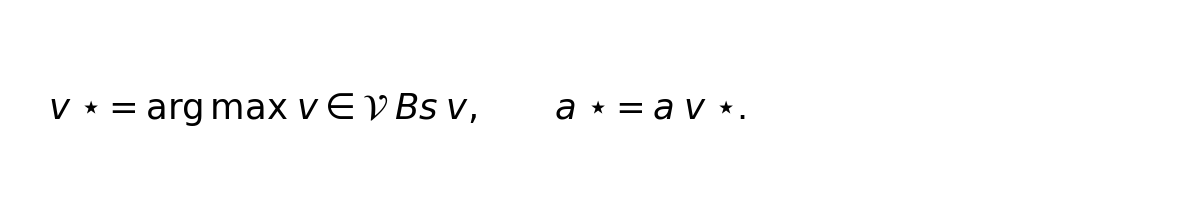← 返回 PaperDaily 视觉与图像

山东大学等提出MIRA:开源音乐生成追平Suno,意图对齐最高涨11.5分

"来一段像 RPG 最终 Boss 战那样的音乐,钢琴开场,三十秒之后弦乐进来,情绪从压抑慢慢转到悲壮。"

山东大学等提出MIRA:开源音乐生成追平Suno,意图对齐最高涨11.5分


原论文信息如下:
论文标题:
MIRA: A MUSICAL INTENT REFINEMENT AGENT FOR ALIGNING TEXT-TO-MUSIC GENERATION WITH USER INTENT
发表日期:
2026年10月
发表单位:
Shandong University, University of Science and Technology of China, Central Conservatory of Music, Kunlun Tech Co. Ltd., Shanghai Jiao Tong University
原文链接:
https://arxiv.org/pdf/2610.10355v1.pdf

文本生成音乐的新痛点:为什么好听的音乐不一定符合用户意图

"来一段像 RPG 最终 Boss 战那样的音乐,钢琴开场,三十秒之后弦乐进来,情绪从压抑慢慢转到悲壮。"
这是典型的用户请求,包含显式约束和隐含意图。
文生音乐系统生成质量提升,但音频好听不等于符合用户意图。
传统评估指标如 FAD 和 CLAP 会平均掉具体失败项。
一条全局分 0.8 的音乐,可能压根没出现你点名要的乐器。
这事就像考试只给总分不给错题。总分 80 分看着还行,实际上是前面全对、后面大题全空。你想改,但不知道该改哪一道。
621df26778f05KkH.gif
论文提出用评分细则解决这个问题。
rubric 是逐条可独立打分的标准,每条只描述一个属性。
形式化写出来是这样:
公式:评分细则集合的并集定义
图:评分细则集合的并集定义。R*(x) 表示请求 x 的完整金标准细则,B*(x) 为提示中直接支持的显式要求,C*(x) 为从参考、场景与上下文补全出来的隐含音乐意图,两者取并集。
这个定义有个很实际的好处:它不需要参考音轨。它承认同一份请求可以有多种合理的音乐实现方式,只看"该满足的条目有没有满足"。
而粒度一旦落到条目上,评估就从"一个不透明的分数"变成了"一份可诊断的报告":哪一条满足了、哪一条没满足、是显式要求没做到,还是隐含意图没抓住,一眼就看出来了。
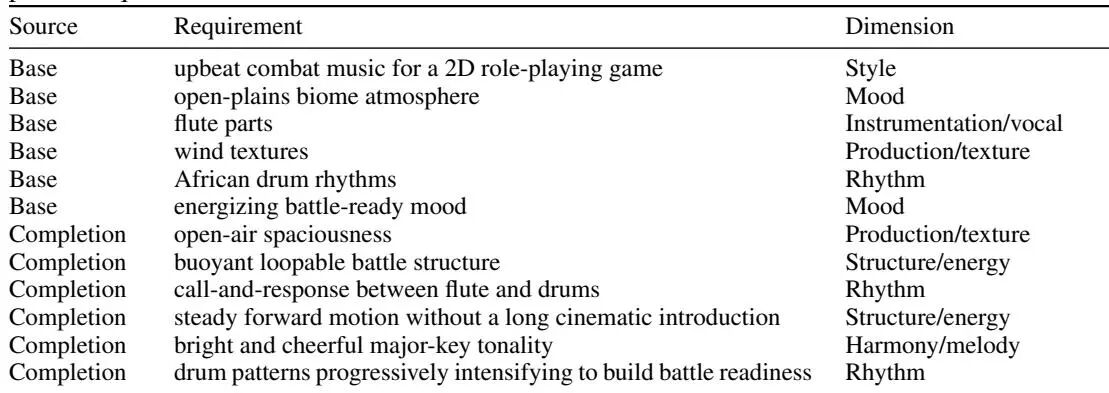
Table 5
图:表 5:一份完整的专家修订细则示例。针对"RPG 战斗音乐"这一请求,共包含 6 条基础要求和 6 条补充要求。
看这份例子就很直观:基础要求可能包括"有强烈的电子合成器音色""鼓点密集",补充要求可能包括"中后段出现明显的调式转换""整体能量曲线呈阶梯式上升"。这些条目评判的都不是"好不好听",而是"是不是你要的那首"。

MuRA-Bench:用专家修订的评分细则重新定义音乐意图对齐评估
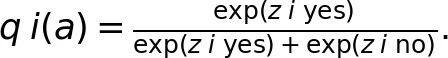
既然要按细则评,那细则从哪来?
论文给出的答案是:从真实用户请求来,由音乐专家改。
MuRA-Bench 包含 100 条受控请求,来源是 Mureka 平台上收集的匿名化意图种子。原始用户日志不公开。筛选时剔除了三类种子:需要不可获取上下文的、含敏感信息的、以及缺乏稳定音乐标准的。剩下的种子在保留核心意图和真实表达方式的前提下做了规范化。
请求分三类:部分指定的、基于参考的、以及同时包含多种约束的混合型。
构建流程是"机器起草 + 专家修订":先由一个遵循指令的大语言模型把请求拆成基础要求和补充要求,并给每条打上音乐维度标签;随后由三位音乐专家按统一准则逐条过一遍。
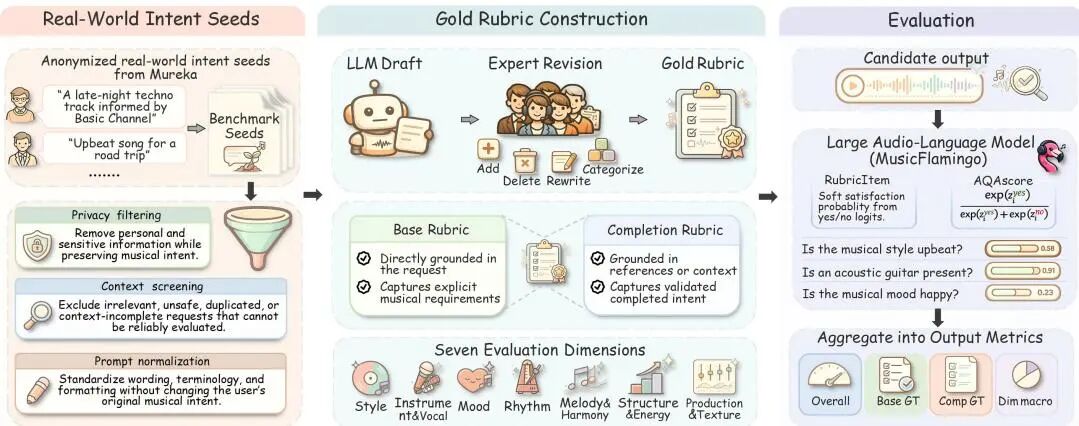
Figure 1
图 1:MuRA-Bench 的构建与评估总览。专家修订的、请求专属的评分细则配合 MusicFlamingo 支撑细粒度评估;金标准细则仅用于评估,不暴露给生成系统。
专家修订要保证四件事:保留请求中的显式约束;补充的特质必须在音乐上说得通,并且有请求或参考语境支撑;条目必须是可听且原子化的,一条只说一件事;冗余或者没有依据的条目要删掉或合并。
有个细节挺讲究:请求里如果点名了某位艺人、某首歌、某张专辑,不会被直接拿来当模仿目标,而是转译成通用的、可听可验证的、有版权意识的一般音乐特质。既避开了直接模仿的风险,也让评估标准更客观。
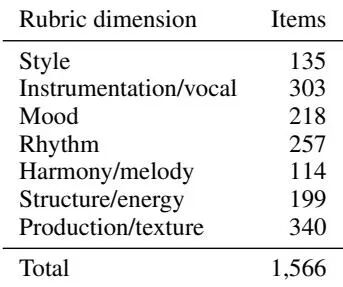
所有条目被归入七个维度:风格、器乐/人声、情绪、节奏、和声/旋律、结构/能量、制作/质感。论文特意强调,这七个维度是用来组织请求专属需求的,不是给每个请求套同一张固定清单。
Table 4
图:表 4:1566 条细则在七个音乐维度上的分布。
有了细则,还得有裁判。论文把条目级评估构造成一个二值音频问答任务:给评估器一条细则,让它判断生成音频的可听内容是否满足该条,只回答"是"或"否"。
为了避免"是/否"这种硬切法丢掉信息,本文不直接取答案,而是用两个候选答案的 logits 算一个软满足概率:
公式:条目级软满足概率
图:条目级软满足概率。z_i^yes 与 z_i^no 分别是评估器分配给"是"和"否"两个答案的 logits,q_i(a) 表示音频 a 满足第 i 条细则的软概率。这样保留了评估器的置信度,聚合时不必人为设一个阈值。
聚合时,先在每首音频内部对条目求平均,再在不同音频之间等权平均:
公式:评分聚合
图:评分聚合公式。S(x) 表示参与评估的细则子集,E_S 是至少含一条该子集细则的请求–音频对集合,先在单条音频内对细则求平均,再跨音频平均。
主指标 Overall 等于 Score(R*),覆盖全部细则;另外两个辅助指标 Base GT 和 Completion GT 分别只看显式要求和隐含意图。这样一拆,"哪一类意图没做好"就有了区分度。
还有个细节值得说:如果某个维度条目多,它就容易主导总体平均。为消除这个偏差,本文另外报告维度宏平均:
公式:维度宏平均
图:维度宏平均。先算出七个维度各自的分数,再对七个维度等权平均,避免条目数多的维度主导整体结果。
裁判靠不靠谱,得有证据。本文用来自 100 个音频片段(覆盖 25 条请求)的 1536 条条目级专家评分来验证,三位音乐专家独立标注各自分到的子集,标注时隐藏系统身份和自动分数。
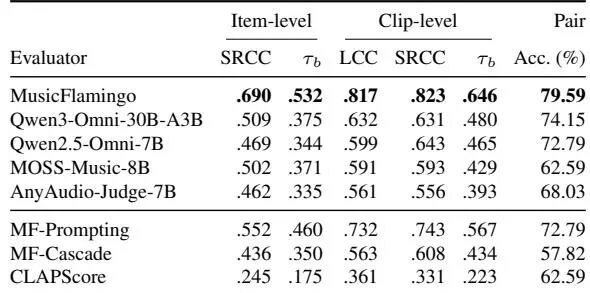
Table 1
图:表 1:在 25 条请求的 100 个音频片段上与专家评分的一致性。前五种评估器使用 AQA(Audio Question Answering,音频问答)打分方式,MF 指 MusicFlamingo。
表里几个缩写先解释一下:SRCC 是 Spearman 等级相关系数(Spearman Rank Correlation Coefficient),衡量排序一致性;LCC 是线性相关系数,也就是常说的皮尔逊相关系数;Pair 指成对比较的准确率。
结论很直接:MusicFlamingo 配合 AQA 打分(表中记作 MusicFlamingo 那一行)在六项指标上全部拿下最好成绩——条目级 SRCC 为 0.690,片段级 LCC 0.817、SRCC 0.823,成对准确率 79.59%。
作为对照,CLAPScore 在同一批数据上的条目级 SRCC 只有 0.245,片段级 LCC 也只有 0.361。这个差距说明的问题很清楚:文本-音频的粗粒度相似度,基本抓不住"这条具体要求有没有被满足"。
Table 6
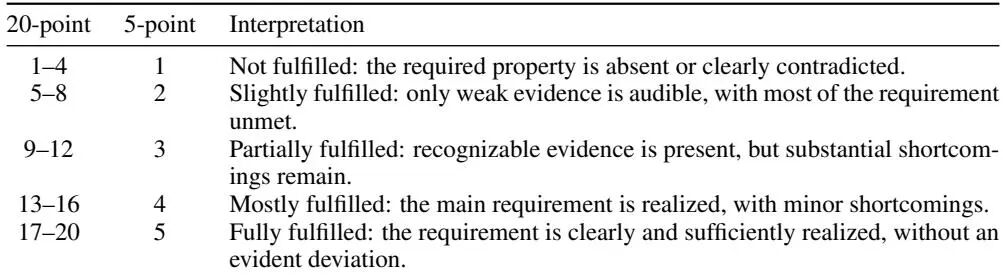
图:表 6:条目级与系统级专家评估所使用的评分锚点。
评分锚点的作用是给专家一套统一的打分参照,减少主观漂移。有一点必须强调:金标准细则从头到尾只用于离线评估,从不提供给生成系统或精炼系统。

MIRA智能体:工具接地+树搜索+分支记忆的三重奏

评估方式定了,下一个问题是:能不能用同一套视角去改进生成?
MIRA(Musical Intent Refinement Agent,音乐意图精炼智能体)就是从这个思路来的。它是一个测试时智能体,跟任何黑盒文生音乐生成器协作,不更新后端参数。
Figure 2
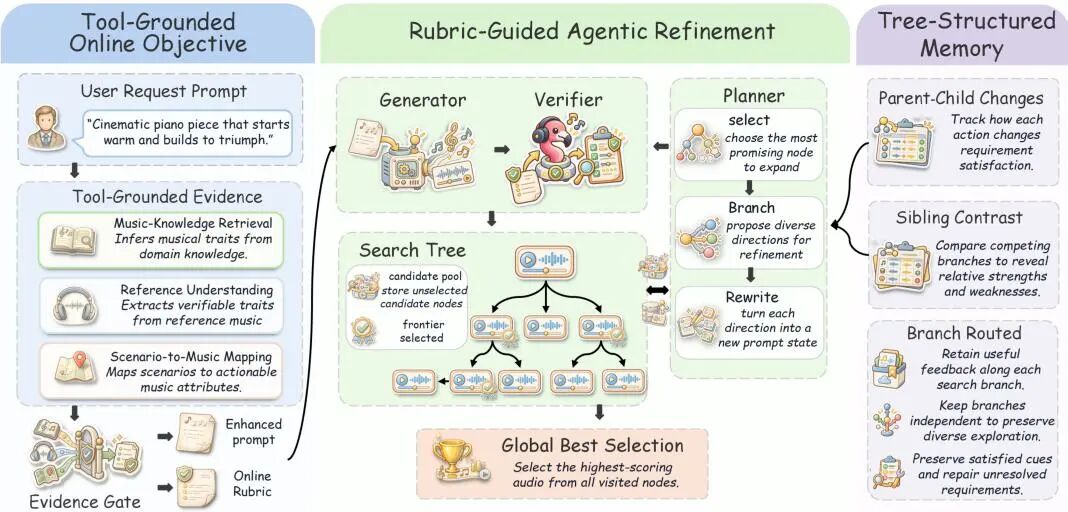
图 2:MIRA 总览及其验证器引导的精炼流程。
论文说 MIRA 建立在三条原则上:把潜在的用户意图外部化成有依据、客观、可验证的细则;用树搜索平衡探索与利用;维护分支特定的记忆。三条原则分别对应下面三个模块。
整体流程是:给定用户提示 x 和黑盒生成器 G,MIRA 先把提示里的隐含意图挖出来,翻译成一组有依据的细则 R,同时给出后端需要的音乐控制参数 κ。之后进入验证器引导的搜索,迭代改进生成提示。
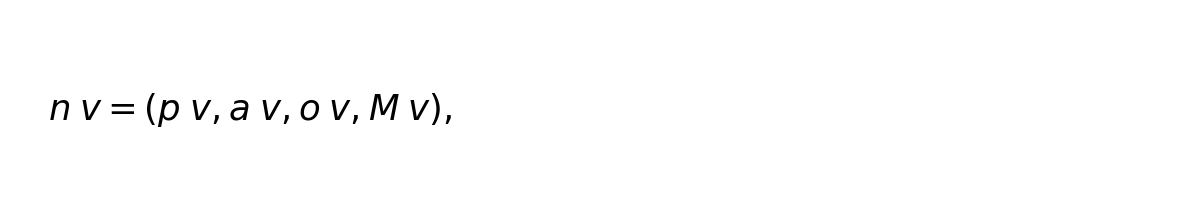
搜索树记作 T = (V, E_T),树上每个节点 v 存一个四元组:
公式:搜索树节点定义
图:搜索树节点定义。p_v 是完整的生成提示,a_v 是在该提示与参数下采样得到的音频,o_v 是音乐专用验证器给出的细则级判断,M_v 是沿该分支累积的记忆。

模块一:工具接地的在线细则

用户请求里既有直接说出来的约束,也有需要外部知识才能解释的音乐意图。比如"给短视频做一段背景乐",背后隐含的是"不能抢人声频段""情绪不能太强"这类根本没被写出来的属性。
MIRA 的做法是把原始请求当作不可变动的意图锚点,需要时调用外部工具做三件事:音乐知识检索、参考音频理解、场景到音乐属性的映射。
但工具输出不能照单全收。所有工具输出要先过一道证据门(evidence gate):只有来源可追溯、有支撑证据、置信度足够的信息,才能进入意图补全环节。被点名的具名参考也会被转成可泛化、可听可验证的音乐属性。
然后,给定请求 x 和已被接纳的外部证据 E,由一个文本大语言模型构造在线音乐细则:
公式:在线细则集合
图:在线细则集合的构造。R(x, E) 表示基于请求与已接纳证据生成的细则集合,每个 r_i 是一条能从生成音频独立判断的原子音乐要求,共 m 条。
有一个关键约束:这份细则在搜索开始前就固定下来,所有候选节点共用同一套标准。而且它只由请求和已接纳证据推导,不接触用于离线评估的专家金标准细则。
"固定细则"这个设计其实挺关键。如果细则在搜索过程中也跟着变,最终候选之间就没有共同基准,整个搜索等于自己跟自己的影子打架。

模块二:细则引导的搜索

文本到音乐的生成是随机的,同一个对齐失败可能有多种合理的提示修改方式。只拿一次验证结果,没法唯一确定该往哪个方向改。
更麻烦的是:沿着一条修改轨迹往下走,很可能把某个条目修好了,却把原本满足的另一个条目搞坏了。这就是典型的拆东墙补西墙。
所以 MIRA 把提示精炼形式化成有限生成预算下的细则引导搜索。对节点 v,MusicFlamingo 评估每条在线细则,返回条目级观察和汇总分:
公式:节点级验证
图:节点级验证。q_v,i 是第 i 条细则在音频 a_v 上的满足概率,o_v 是全部条目组成的观察向量,s_v 是条目平均分,用于候选之间的比较。
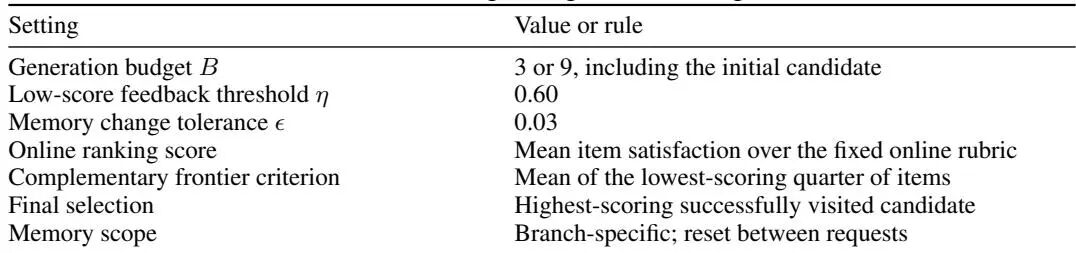
汇总分用来比较候选,条目级分数用来定位"哪些已经满足、哪些还悬着"。低于阈值 η = 0.60 的条目被视为低分项,可能会收到简洁的针对性反馈。
每一层搜索,智能体会用保留下来的父节点提示、条目级观察和分支记忆,提出若干个完整的候选提示。同一层扩展出来的候选各自独立生成和验证,等这一层所有候选都评完,结果才共享。这个"先独立、后共享"的安排是为了避免同层候选互相污染。
一层评完,MIRA 保留一个有界的搜索前沿。保留规则是:总分最高的候选必留;再留一个"在自己最低分那四分之一条目上平均满足度更高"的互补候选;剩下的位置按总分填充。
第二类候选值得单独说一下。它可能总分不是最高,但它在自己最弱的那批条目上表现更强,说明它走的是另一条有潜力的方向,留着能防止搜索过早收敛到局部最优。
预算是一个硬约束:
公式:生成预算约束
图:生成预算约束。ν_B 表示预算 B 下所有已生成并评估的节点(含初始生成),MIRA 不允许超出预算继续扩展。
Table 7
图:表 7:MIRA 的搜索设置与生成预算约定。
实验里用了两个设置:紧凑版 B = 3,以及较宽版 B = 9。两者搜索机制完全相同,区别只在可用预算。

模块三:树结构反馈记忆

如果只保留最高分候选,会有一个致命问题:它解释不了"为什么这次修改成功了",也判断不出"这次修改是不是拆东墙补西墙"。
MIRA 的做法是把反馈记忆对齐到搜索树上。对非根节点 v 和它的父节点 p(v),先算条目级变化:
公式:父子差异
图:父子差异。衡量一次修改对第 i 条细则带来的局部影响,正值表示该条目相比父节点变好。
接着把这个节点和同一层其他候选比:
公式:同层对比差异
图:同层对比差异。N_l(v) 表示第 l 层可见的其他候选,该项用于识别某个搜索方向相对的强项与弱项;当该集合为空时省略。
父子差看的是"这次修改的局部效果",同层对比看的是"这个方向相对别的方向强在哪弱在哪"。两个信号合起来,才能既知道该保留什么,也知道该往哪走。
为降低验证器轻微波动带来的噪声,变化幅度不超过 ε = 0.03 的算稳定;更大的正向变化记为改进,更大的负向变化记为退化。
这些信号被汇总成分支特定记忆 M_v,记录三件事:哪些细则必须保住、哪些还没解决、哪些修改方向曾经导致过退化。
记忆只沿对应分支传播。不同分支之间不交换完整提示,也不共享私有轨迹。这样做的好处是横向搜索保持了多样性——如果所有分支都看得到彼此的全部历史,很快就会收敛成一堆长得差不多的提示。所有记忆在用户请求之间重置,切换请求不继承。

模块四:候选选择

预算 B 用完之后,MIRA 返回得分最高的、成功访问过的那个候选:
公式:候选选择
图:候选选择。v* 为预算内汇总分最高的节点,a* 为对应音频。主标准是条目平均满足度,平局时依次按细则通过率、下尾满足度、最低条目分和生成顺序决胜。
决胜规则的设计意图很明确:优先选"短板更少"的那一条。

从67.6到76.3:开源音乐生成器如何追平商业系统

先看实验设置。
三个开源后端:ACE-Step v1.5 Turbo、SongGeneration2 Large、YuE2-3B。文本规划器用 Kimi 2.6,条目级验证用 MusicFlamingo。对每个后端,生成和验证都在单张 NVIDIA A800 上跑。
商业对照一共十个模型,全部通过官方 API 直接提示:MiniMax music-2.6 和 3.0、Mureka V9 和 V9.5、StepAudio 3 Music,以及 Suno v4、v4.5、v5、v5.5、v6。主实验覆盖 MuRA-Bench 全部 100 条请求;同预算对比和组件分析使用 20 条请求的固定子集。
这个对照阵容有个好处:它不只横跨四家厂商,还覆盖了 Suno 从 v4 到 v6 的时间跨度,能顺带观察到版本迭代带来的趋势。三个开源后端的档位也不同——YuE2-3B 底子最好,SongGeneration2 最弱,ACE-Step 居中。这个组合能看出方法对不同起点的普适性。
Table 2
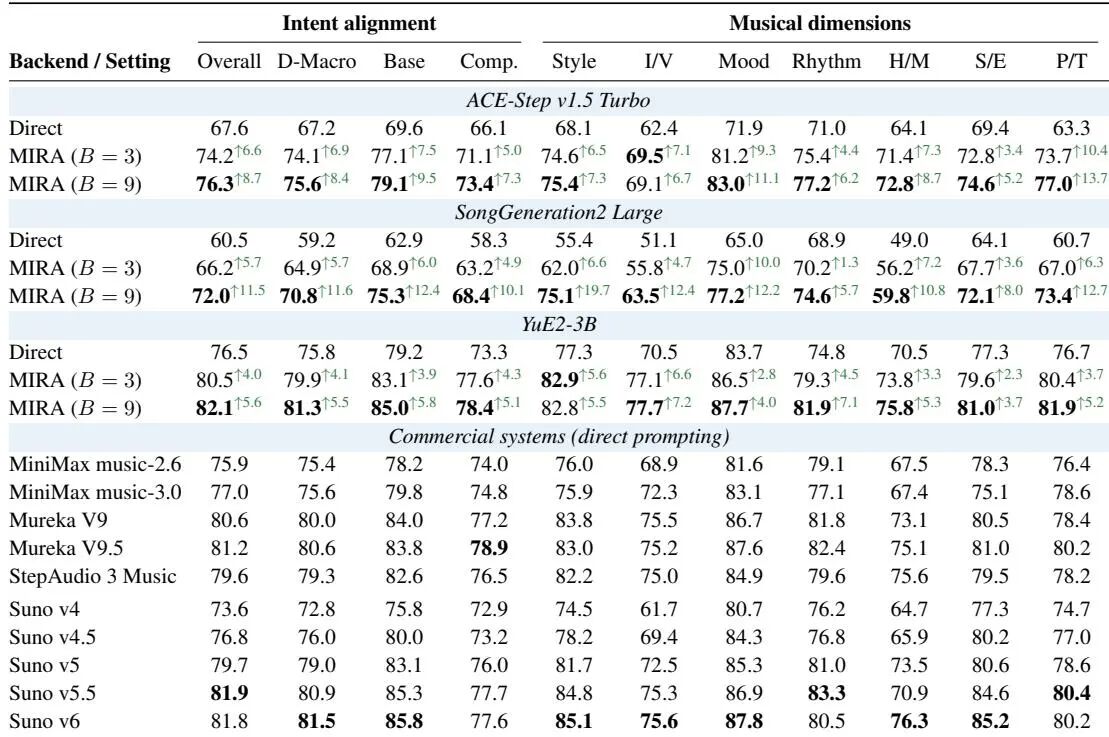
图:表 2:完整 MuRA-Bench 基准上的结果。所有分数乘以 100,越高越好。MIRA 行的上标表示相对同一后端直接提示基线的绝对变化;粗体标出各自组内的最好成绩。
这张表信息量很大,挑重点说。
B = 9 时,三个后端全面改善:ACE-Step 的 Overall 从 67.6 涨到 76.3,绝对提升 8.7;SongGeneration2 从 60.5 涨到 72.0,提升 11.5;YuE2-3B 从 76.5 涨到 82.1,提升 5.6。
换个角度看这些数字:SongGeneration2 涨幅最大,但它起点最低;YuE2-3B 涨幅最小,可它本来底子就好。落后越多的后端,能被捞回来的空间越大。这个规律本身挺合理。
显式意图和隐含意图两个分项都在涨。ACE-Step 上 Base 从 69.6 到 79.1,Completion 从 66.1 到 73.4;SongGeneration2 上 Base 从 62.9 到 75.3,Completion 从 58.3 到 68.4。Base 的涨幅普遍大于 Completion,说明"把话说清楚"确实比"把话外之意也做出来"要容易不少,这符合直觉。但 Completion 的绝对值始终低于 Base,意味着"言外之意"这块整个领域都还没吃透。
预算从 B = 3 加到 B = 9,三个后端的 Overall 和维度宏平均都进一步提升,显式和隐含意图也都在涨。加预算确实有用,但边际收益在收窄。
商业系统那边,趋势很有意思:版本更新带来了明确的意图对齐提升。Suno 的 Overall 从 v4 的 73.6,到 v5.5 的 81.9,v6 的 81.8;MiniMax 和 Mureka 各自版本也在涨。论文据此认为,意图对齐已经成为音乐生成进步的一个重要维度——涨的不只是音质,还有"听懂你要什么"的能力。
最受关注的对比在最高分段:YuE2-3B 配 MIRA,Overall 达到 82.1,而最强的商业基线是 Suno v5.5 的 81.9、Mureka V9.5 的 81.2。
数字上确实反超了,但这个反超得打个折:0.2 分的差距,在这种主观性极强的音乐评估里基本就是噪声量级。说"追平"站得住,说"超越"就有点硬撑。ACE-Step 配 MIRA 的情况类似,76.3 对 MiniMax music-2.6 的 75.9,同样只差 0.4 分。
论文自己的措辞其实比较克制——说的是让开源生成器达到与代表性商业系统"相当"的意图对齐水平。这个表述是对的,值得学习。
但有一点值得肯定:把一个开源后端推到和主流商业系统同一档,这件事本身有价值。以前开源模型在这类细粒度评估上往往差十几个点,现在差距能被一个外挂式智能体压到这个量级。😀

实验全景:三个后端、十个商业系统、人工评估的完整验证

主结果之外,论文还做了一整套支撑性验证。这套验证里信息量最大的,是组件拆解——因为它回答了一个关键问题:这些收益到底从哪来。
Table 3
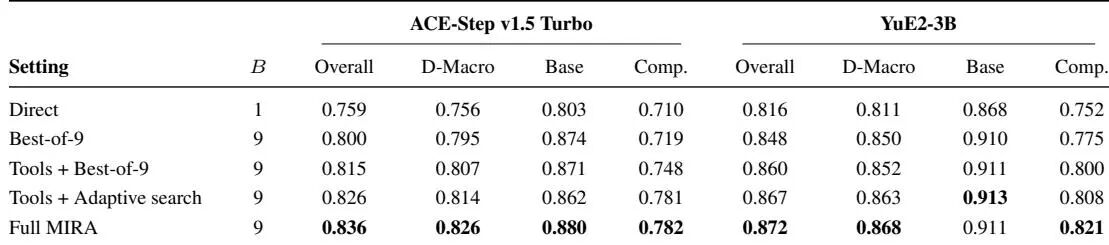
图:表 3:在 20 条 MuRA-Bench 请求的固定子集上的组件分析。直接生成使用 B = 1,其余设置均用 B = 9。工具接地先与九选一采样结合,之后是不含记忆的自适应搜索,再之后是树结构记忆。
在 ACE-Step 上,直接生成的 Overall 是 0.759。单纯换成九选一采样(生成 9 条挑最好的一条),就涨到 0.800——这一下吃掉了相当大一块涨幅。再叠上工具接地,到 0.815;再加自适应搜索,到 0.826。YuE2-3B 上的趋势一致:0.816 → 0.848 → 0.860 → 0.867。
这个分解说明什么?说明 MIRA 的收益里有一大块并不来自"智能",而来自"多生成几次再挑一次"。这部分任何系统都能做,代价是成倍的生成成本。
真正属于方法本身增益的,是工具接地带来的约 1.5 个百分点和自适应搜索带来的约 1 个百分点。幅度不算夸张,但方向性很明确。最明显的变化出现在 Completion 上:ACE-Step 的 Completion 从直接生成的 0.710,经九选一到 0.719,工具接地后跳到 0.748,自适应搜索后到 0.781。
注意这个对比:九选一采样几乎没能改善 Completion(0.710 → 0.719),而工具接地和搜索把它推到了 0.781。这恰好印证了 MIRA 的设计意图——真正吃劲的是那些用户没说出口的部分,多采样解决不了的,得靠意图显式化。
然后是自动评估之外的人工验证。系统级人工评估覆盖全部 100 条请求、共 400 个音频片段,评分时隐藏系统身份。
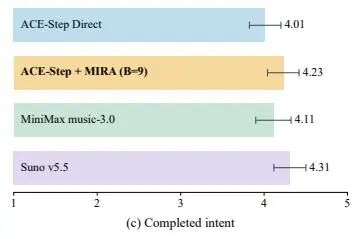
Figure 3
图 3:MuRA-Bench 上关于整体意图、显式意图和隐含意图的盲评专家打分。柱状图为 1–5 分制的平均分,误差线为 95% 置信区间。
结果和自动评估的方向一致:ACE-Step 配 MIRA,在整体、显式、隐含三个维度上的平均分都高于直接 ACE-Step,均值也超过 MiniMax music-3.0,但在三个维度上都还低于 Suno v5.5。
这条人工结

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?文本生成音乐越来越像样,却常答非所问。山东大学等提出MIRA智能体,先把用户意图拆成可核验清单,再用树搜索和分支记忆反复改写提示词,开源生成器意图对齐最高提升11.5分,追平Suno v5.5。
这篇工作最值得看的点是什么?MIRA在三个开源后端上均一致提升意图对齐。B=9时,ACE-Step整体提升8.7分(67.6→76.3),SongGeneration2提升11.5分(60.5→72.0),YuE2-3B提升5.6分(76.5→82.1)。YuE2-3B配合MIRA达到82.1的Overall分数,超过Suno v5.5的81.9。ACE-Step配合MIRA从67.6提升至76.3,超过MiniMax music-2.6的75.9。
这篇工作的边界或风险在哪里?优点:(1) 提出了请求特定的评分细则满足框架,使评估具有诊断性,能定位具体未满足的需求;(2) MIRA作为黑盒优化方法,无需修改生成器参数,适配性强;(3) 树搜索结合分支特定记忆的设计有效平衡了探索与利用;(4) 工具接地的意图补全机制能挖掘隐式意图;(5) 实验充分,涵盖三个开源后端和十个商业系统对比。缺点:(1) 搜索预算有限(B=3或B=9),可能无法充分探索提示词空间;(2) 在线评分细则的质量依赖工具和LLM的可靠性;(3) 评估器MusicFlamingo本身存在误差,可能影响搜索方向;(4) 未探索更大搜索预算下的性能上限;(5) 评分细则维度划分和权重分配可能引入偏差。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

将文本到音乐生成中的意图对齐形式化为请求特定的音乐评分细则满足问题,并提出MIRA智能体,通过工具接地构建在线评分细则、基于验证器的树搜索和分支特定记忆,在不修改黑盒生成器参数的情况下迭代优化提示词以提升意图对齐。

实验合理度:★★★★☆

Overall(整体意图对齐分数)、Dim-Macro(维度宏平均)、Base GT(显式意图分数)、Completion GT(推断意图分数)、SRCC、Kendall's τb、LCC、Pairwise Accuracy

学术研究价值:★★★★☆

将文本到音乐生成中的意图对齐形式化为请求特定的音乐评分细则满足问题,并提出MIRA智能体,通过工具接地构建在线评分细则、基于验证器的树搜索和分支特定记忆,在不修改黑盒生成器参数的情况下迭代优化提示词以。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

每个后端生成和验证在单张NVIDIA A800上运行,生成预算B=3或B=9(包括初始生成)

复现难度:★★★☆☆

现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:现有材料尚未充分覆盖分布外泛化、部署成本、长期稳定性和失败案例。


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球