← 返回 PaperDaily
大模型与智能体
亚马逊12周实测:LLM自主科研提升1.82倍召回,却暴露五种失效模式
把AutoResearch放进真实生产流水线跑满12周是什么体验?亚马逊给出了答案:220多次实验、多GPU连续烧钱,换来1.82倍和2.1倍的指标提升,也换来五种翻车模式的完整记录,还顺手让代理自己补上了5.8倍的目录覆盖缺口。自主科研的真实边界在哪里,这篇值得花时间读。
龙哥读论文
发布于 2026-10-16 01:12:05
阅读 14
查看原文
原论文信息如下:
AutoResearch 概念来自 Andrej Karpathy 的 Python 脚本,思路是让大语言模型修改训练脚本,跑完实验后根据指标决定保留或丢弃。与 AutoML 的区别在于搜索空间,AutoResearch 直接改代码,架构、优化器、损失函数、训练技巧都能动。原版设定跑的是单张 GPU、五分钟一轮的实验,失败代价低。
生产环境不同,迭代成本高,评估标准复杂,时间跨度长。亚马逊论文指出生产机器学习与原版设定在三个维度上不同:迭代成本高,评估标准复杂,时间跨度长。AutoResearch 能否应对这些压力,此前没有公开报告。
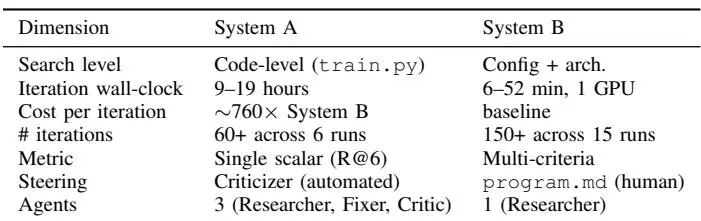
亚马逊12周实战:当AutoResearch遇上生产规模 实验在亚马逊图书推荐流水线中进行,部署了两个系统。System A 为活跃目录中98%商品学习购买优化检索向量,单次迭代9到19小时。System B 用RQ-VAE为超过50%被浏览书籍学习层级式Semantic ID,单卡GPU,单次迭代6到52分钟。
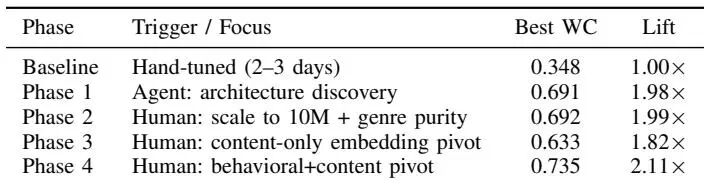
System A目标指标是Recall@6,衡量推荐的6个邻居中包含顾客真正买下的书的概率。手调基线为3.79%。System B目标指标是加权一致性,衡量同簇书本相似度,手调基线为0.348。
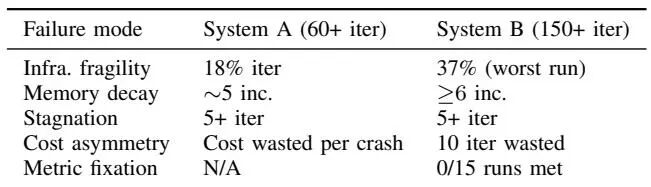
五种失败模式:生产级自主研究为何频频翻车 论文归类失败模式:基础设施脆弱性、代理记忆衰退、搜索方向停滞、迭代成本不对称、指标固着。前四种在两个系统上独立观测,第五种只在System B出现。
环境性失败如评估超时、显存溢出、GPU分布bug等消耗预算却无信号。System A中GraphSAGE模型超出显存上限;System B某run中评估器无法处理放大10倍的batch规模,连续11次迭代失败。
系统会重测失败配置,找理由。System B中训练100轮因过拟合失败被重测6次,System A中Researcher重复引入被禁操作,浪费迭代。根因是上下文窗口装不下完整历史、跨run负结果无持久记忆。
代理到达局部最优后继续微调,变化落在噪声范围内。System A中Researcher一直融合预压缩特征,System B中某run连续5次迭代改进架构,结果浮动。代理缺少判断当前搜索方向是否收益递减的视角。
代理不衡量信息增益与算力成本比值,把15小时多卡run和30分钟消融实验当一回事。System A中代理提出显存需求高于基线的GraphSAGE变体,System B中辅助损失探索10次迭代无提升,终止run。
代理忠实优化指标,但不质疑指标是否合适。System B中代理发现调大码本提升加权一致性,但层级结构不可用。研究团队加入限制层数护栏,补上三级簇可用性指标。System A只优化单一标量,未观测到此失败模式。
五种模式有共同起源:小规模实验迭代便宜、指标单一、会话短,生产规模打破这些假设,失败模式冒出。
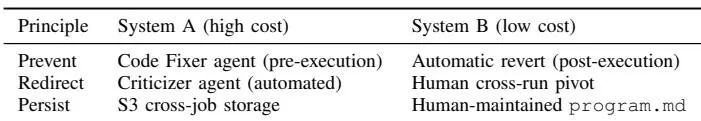
三代理框架:预防、持久化与重定向的设计哲学 脚手架原则:prevent(预防)、redirect(重定向)、persist(持久化)。每个原则对应失败模式子集:预防基础设施脆弱性和迭代成本不对称,重定向搜索方向停滞,持久化记忆衰退。指标固着只能部分缓解。原则不限于推荐场景,任何长时程、失败代价不对称、会话重置上下文、搜索空间存在局部最优的代理循环,都会面临结构性压力。
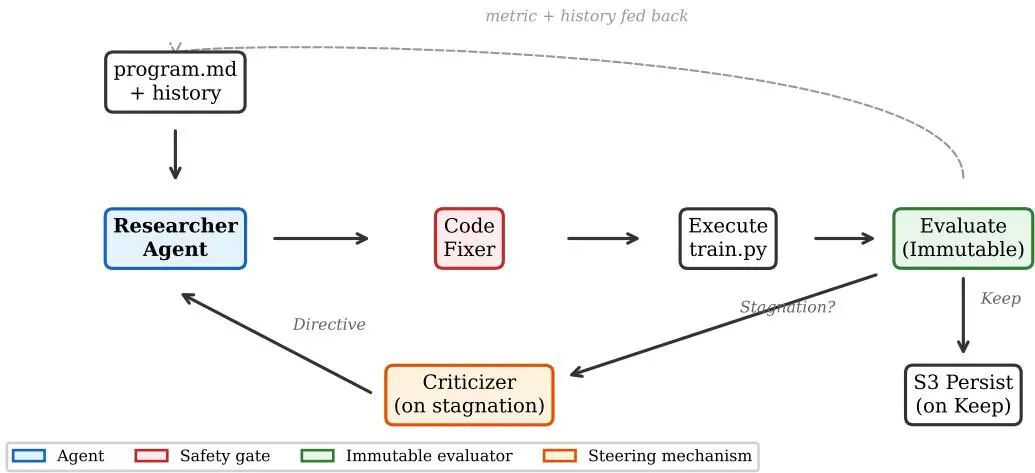
System A扩展为三个代理:Researcher用claude-sonnet-4-6,Criticizer和Code Fixer用claude-opus-4-6。模型分工有意为之:高频代码生成交给Sonnet,低频高杠杆角色交给Opus。上下文管理用滑动窗口,最近迭代摘要保留,当前最优train.py始终可见。Researcher收到提示包含任务规格、当前最优代码、历史迭代摘要、Criticizer战略指令,产出完整训练脚本。
算法1:三代理 AutoResearch 循环(System A)
1: 初始化最优分数,program ← Karpathy 的 program.md
2: 战略指令 ← 空集
3: 对 i = 1, 2, ... 循环:
4:     代码 ← RESEARCHER(program, 历史, 战略指令)
5:     代码 ← CODEFIXER(代码)        ▷ 执行前重写
6:     分数 ← EVALUATOR(TRAIN(代码))
7:     若 分数 > 最优分数 × (1 + τ_keep) 则
8:         最优 ← 代码;最优分数 ← 分数;战略指令 ← 空集
9:     结束若
10:    若 停滞:最近5次的最优分数相对变化 < τ_stag 则
11:        战略指令 ← CRITICIZER(历史)
12:    结束若
13:    program ← UPDATE(program, 分数, 摘要)
14: 结束循环
其中τ_keep是保留阈值,τ_stag是停滞判定阈值。关键在于:只有超过当前最优成绩一定幅度的修改才会被保留,战略指令一旦被保留就立刻清空,避免代理长期偏离。
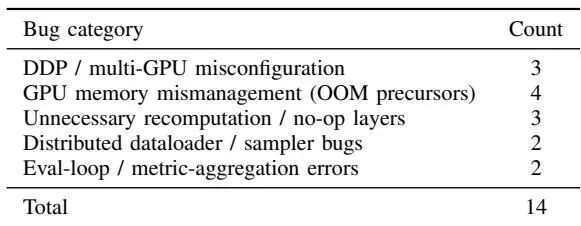
Code Fixer在Researcher产出的脚本执行前审查,抓语义bug:GPU利用率不足、配置错误、重复计算、内存泄漏。设计关键在于一次重写完成,而不是先描述bug再改。之前两步式Reviewer架构已放弃:某战役中Reviewer连续返回畸形JSON,Researcher重复引入被禁操作。Code Fixer首次部署修掉14个潜在bug,DDP包装器bug让8卡作业在单卡上跑10小时。此后无迭代损失在代理协调层。
Criticizer监控停滞信号并输出战略指令。它只在最近Recall@6相对提升未超过阈值时触发,绝大多数迭代无干预推进;一旦触发,产出2到5句话指令,建议设计空间另一区域。指令在下一次保留时清空,不积累权威口吻。8%相对增益阈值和5次迭代窗口为经验选择:3次太频繁,8次太晚。System A战役关键指令出现在连续5次收益递减后。
Criticizer,第6个run,第4次迭代后:差距不是建模问题,而是输入表征问题。去构建显式共购邻域表征。
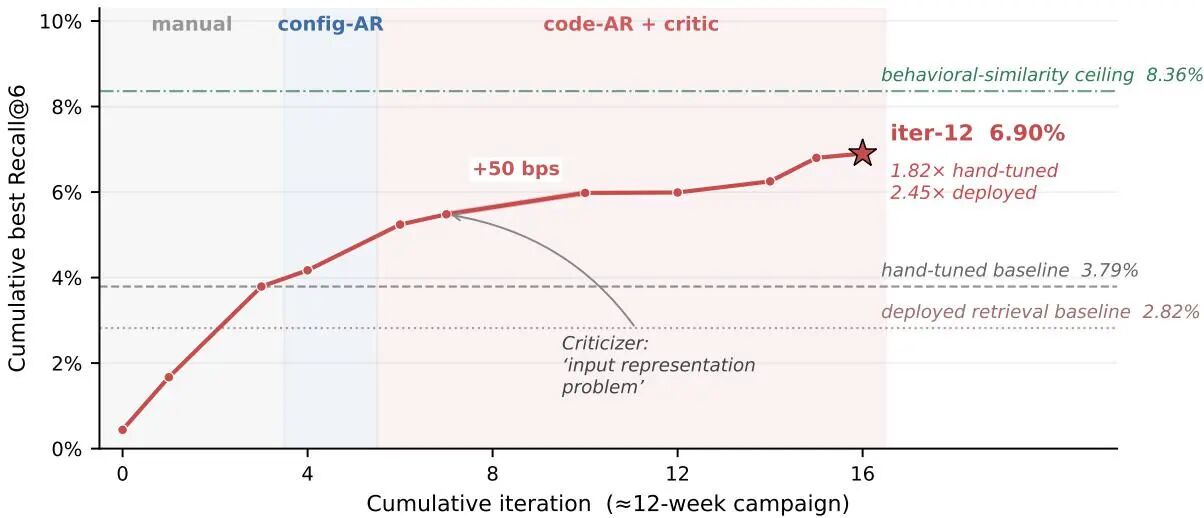
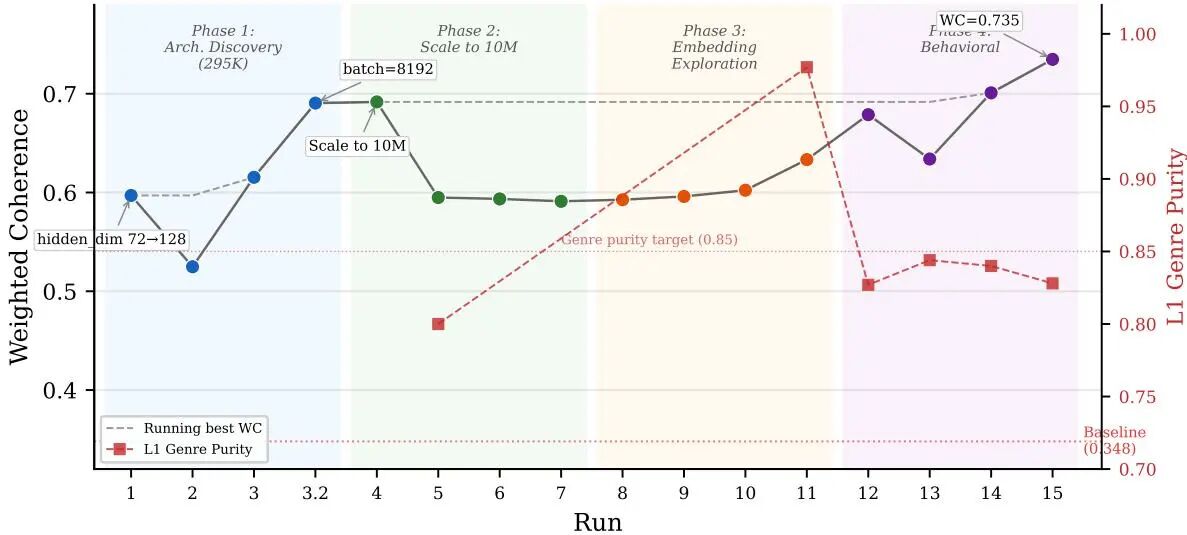
Researcher随后构建多跳邻域画像,三次迭代将Recall@6从5.48%推到5.98%——单个Criticizer指令最大改进。后续迭代在多跳基础上继续推进,第12次迭代达到6.90%。System B中,人类更新program.md起到类似作用:Phase 3到Phase 4转向将探索从纯内容向量拉到行为加内容混合向量,产出System B最佳结果,加权一致性0.735。两个系统规律一致:代理在范式内优化有效,范式转换需外部重定向——便宜指令可自动化,跨run项目需人。
论文在Karpathy的program.md机制上做两处扩展:搬到持久化跨作业存储,让每个新训练作业继承积累;System B中改由人类维护program文件,写入约束、回滚阈值、已知结论,不让代理重新发现。效果部分:代理重测6次被禁止的100轮训练。System B加自动回滚机制,某run的21次迭代中4次因配置触发OOM而回滚。回滚便宜,System B每次迭代成本几美元;System A不现实,迭代成本几百。
三种做法降低严重程度,但未解决。多指标上报让代理看到次级信号,优化目标仍单一;program.md写清每个指标为何重要;run间人工质量检查诊断指标固着,用竞争性准则制衡。根本问题在于代理不质疑指标。按设计,代理只能修改训练参数,不能修改评估标准,系统无法完全无人值守。论文作者态度明确:能否在当前大模型能力范围内解决,仍是开放问题。
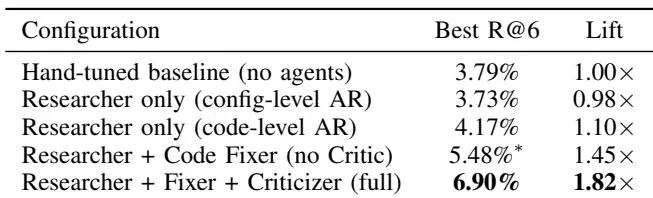
1.82倍提升背后的故事:从手工调优到自主发现 对比手调基线,System A结果呈现清晰阶梯。配置级AutoResearch在基线附近撞墙,略低于基线,0.98倍。单代理代码级AutoResearch首次越过基线,卡在1.10倍。天花板在每多引入一个代理后被打破:加Code Fixer到1.45倍,加Criticizer到1.82倍。说明收益来自特定代理引入,而非迭代次数自然累积。
完整三代理框架峰值6.90%,相对手调基线1.82倍,相对已部署检索基线2.45倍。峰值在11个评估日期上±0.28百分点波动范围内测得,比跨日期均值高约2.6个标准差;即便取跨日期均值,相对手调基线仍有1.63倍。代理渐进发现技巧包括交叉注意力、句向量模型微调、难负样本对比学习、温度课程、多跳邻域画像,驱动第12次迭代跃升的均值加Top-K双聚合。
还有一个不显眼但说明问题的结果。共购行为图只覆盖约17%物品,剩下83%商品无向量。手调基线排除这些物品,检索上限锁死在17%。代理在主目标不相干损失函数实验中发现缺口,提出纯文本兜底方案:不在行为图物品用文本特征推断向量,通过小型多层感知机投影到128维空间,与主模型联合训练。Code Fixer在兜底路径中抓到DDP包装器bug,迭代顺利跑完,下一版FAISS索引覆盖全部物品。一次迭代,目录覆盖扩大5.8倍,全程无人指定缺口为目标,无program.md条目提到覆盖问题。
System B则是15个run、150多次迭代,横跨四个阶段。早期run发现的架构决策锁定后续所有run,人类驱动的Phase 3到Phase 4转向产出最佳成绩0.735,相对手调基线2.1倍。
成本决定设计:760倍成本差异下的脚手架策略选择 同样三条原则在两个系统落地方式不同。System A用前置Code Fixer代理拦截问题,System B用执行后自动回滚;System A用自动化Criticizer破局,System B用人类在run间转向;System A用跨作业对象存储保留记忆,System B用人类维护program.md。
论文提出成本依赖原则:每条脚手架原则权重随迭代成本缩放。执行前门控在迭代昂贵时值回开销,失败烧掉数小时算力时,多花模型调用拦截划算;迭代便宜时,事后回滚够用。原则在两个成本相差近三个数量级系统上观察到,给自主研究代理团队提供设计参数。
论文承认用到单个机制都是标准件,贡献在于失败分类学和成本依赖原则。这种坦诚在论文中不常见。
自主研究的边界:代理能做什么,人类该做什么 从12周实录看,代理在范式内探索、组合、工程化落地很能干,能自主发现未点名覆盖缺口并设计方案。但不会质疑目标是否值得优化,不会主动权衡实验值不值算力,也不会记得上次为何失败——除非有人替它搭好记忆、门控和重定向。系统能力边界由脚手架划定。
对推荐、搜索、广告团队来说,报告价值在于回答"用之前得填哪些坑"。至于无人值守自主研究,论文态度明确:在代理学会质疑指标前,这是开放问题,而非可排期工程任务。
论文报告离线评估结果,嵌入向量线上试点进行中。离线涨1.82倍,线上能否兑现,是另一场考试。
龙迷三问 这篇论文到底在解决什么问题? 亚马逊把Karpathy的AutoResearch范式搬进图书推荐生产流水线,12周跑220多次实验,召回提升1.82倍、覆盖率扩大5.8倍,同时总结出五种生产级失效模式与三原则脚手架。这篇工作最值得看的点是什么? System A达到1.82倍Recall@6提升(3.79%→6.90%),System B达到2.1倍加权一致性提升(0.348→0.735),System A还实现了5.8倍目录覆盖扩展这篇工作的边界或风险在哪里? 优点:首次系统性地报告了生产规模AutoResearch的失败模式,提出了成本依赖的设计原则,三代理框架在两种截然不同的成本体系中都有效,自主发现了5.8倍覆盖扩展。缺点:组件消融为观察性而非受控实验,仅在单一领域验证,指标固定问题未完全解决,离线指标未与在线结果验证。如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~
龙哥点评 论文创新性分数: ★★★★☆
将Karpathy的AutoResearch范式扩展到生产规模,通过三代理框架(Researcher、Code Fixer、Criticizer)和三项脚手架原则(预防、持久化、重定向)解决生产环境中的五种失败模式,实现自主机器学习研究。实验合理度: ★★★★☆
System A使用Recall@6,System B使用加权一致性(weighted coherence,0.5×L1+0.3×L2+0.2×L3)及类型纯度、中位簇大小等辅助指标学术研究价值: ★★★★☆
将Karpathy的AutoResearch范式扩展到生产规模,通过三代理框架(Researcher、Code Fixer、Criticizer)和三项脚手架原则(预防、持久化、重定向)解决生产环境中。稳定性: ★★★☆☆
现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。适应性以及泛化能力: ★★★☆☆
现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。硬件需求及成本: ★★★☆☆
System A每轮迭代9-19小时多GPU计算,System B每轮迭代6-52分钟单GPU计算,两者相差约760倍复现难度: ★★★☆☆
现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。产品化成熟度: ★★★☆☆
论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。可能的问题: 模式,提出了成本依赖的设计原则,三代理框架在两种截然不同的成本体系中都有效,自主发现了5.8倍覆盖扩展。缺点:组件消融为观察性而非受控实验,仅在单一领域验证,指标固定问题未完全解决,离线指标未与在线结果验证。
主要参考文献
[1] AutoResearch at Production Scale: Failure Modes and a Multi-Agent Framework. Amazon Books Core Recs Science, 2026. 原文链接:https://arxiv.org/pdf/2609.30541v1.pdf [2] Karpathy A. AutoResearch:通过大语言模型迭代修改训练脚本的自主研究范式(论文引用文献[1]) [3] Lee K, et al. RQ-VAE:残差量化变分自编码器用于生成式检索(论文引用文献[4][5]) [4] Packer C, et al. MemGPT:面向上下文长度限制的层级记忆管理(论文引用文献[19]) [5] Lu C, et al. The AI Scientist:面向全自动论文写作的自主研究系统(论文引用文献[7]) [6] Romera-Paredes B, et al. FunSearch:语言模型与演化循环结合的数学发现方法(论文引用文献[14])
AI已经开始自己写代码、跑实验、改架构了🤖 人类工程师的周末,终于有机会被保住了。欢迎加入龙哥读论文粉丝群,
扫描下方二维码或者添加龙哥助手微信号加群 :kangjinlonghelper。
一定要备注:研究方向+地点+学校/公司+昵称(如 大模型及智能体+上海+清华+龙哥) ,根据格式备注,可更快被通过且邀请进群。
『龙哥读论文』微信群目前包含:图像处理、大模型及智能体、自动驾驶及机器人、AI医疗及AI金融5个群。
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击 "阅读原文", 查看更多原论文细节哦!
还没有公开留言,欢迎留下你的看法。