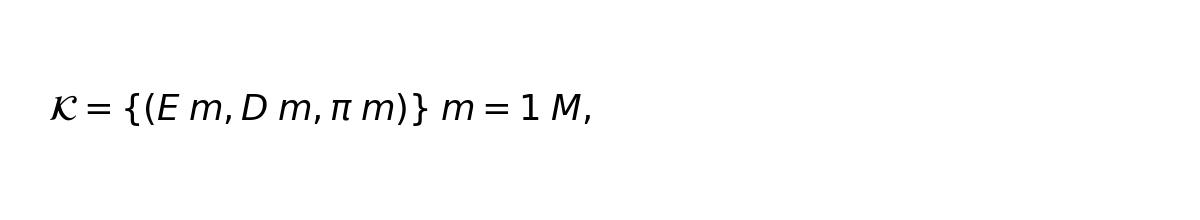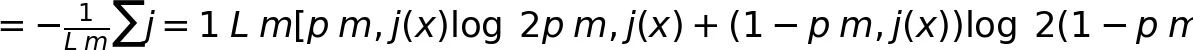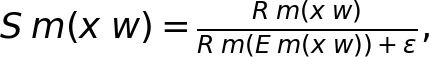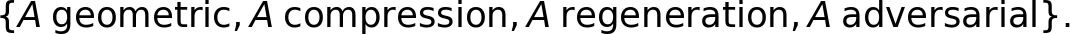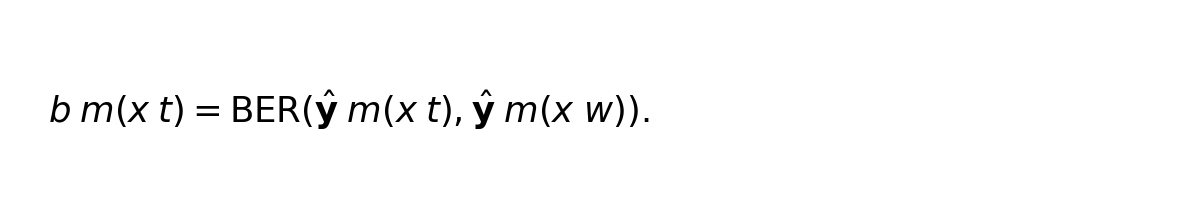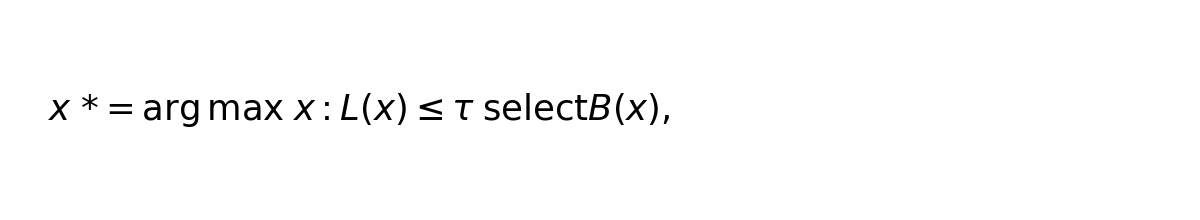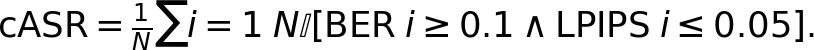← 返回 PaperDaily 视觉与图像

中科大提出ProxyEraseAgent:11种水印盲去除成功率94.8%

AI生成图片越来越多,水印成了内容溯源的最后一道防线。这篇论文给了一个不太舒服的结论:只要拿到一张水印图,不用知道对方用哪套算法、不碰它的解码器,也能把水印打到接近失效,11套系统平均成功率94.8%。中科大的思路值得细看——拿公开水印模型的解码器当"代理",把开环乱打变成闭环搜索。做水印的要读,做内容治理的更该读。

中科大提出ProxyEraseAgent:11种水印盲去除成功率94.8%
原论文信息如下:
论文标题:
ProxyEraseAgent: Blind Watermark Removal in the Wild
发表日期:
2026年10月
发表单位:
中国科学技术大学、新加坡国立大学
原文链接:
https://arxiv.org/pdf/2610.11290v1.pdf

水印去除的困境:有反馈的用不了,能用的没反馈
不可见水印(invisible watermark)干的事,是把一段二进制消息嵌进图片的像素或者潜空间里。肉眼看不出来,但对应的解码器能把这段消息读回来。它现在扛的角色越来越重:内容溯源、版权确权、AI 生成内容标识,都指望这一层。可图片一旦发到公开平台上,它就不再由发布者说了算——水印还能不能活下来,得看有没有人真去攻击它。
这篇论文研究的攻击场景朴素得有点扎人:攻击者手上只有一张已经散播出去的水印图。他不能查询水印检测器(detector),拿不到解码器(decoder),也不知道对方用的是哪套水印算法。目标只有一个——让图里藏的那段消息读不出来,同时画面别坏掉。这个设定在现实里最常见,也最难。
难的地方不是没有手段。压缩、滤波、几何形变、图像重建、对抗扰动,全都随手可用。难的是没有反馈:水印藏在像素和特征里,从外观上根本看不出一次变换到底把水印打散了,还是只是白白牺牲了画质。一次视觉上还算体面的变换,水印可能纹丝不动;一次下狠手的变换,画质崩了,水印说不定还在。
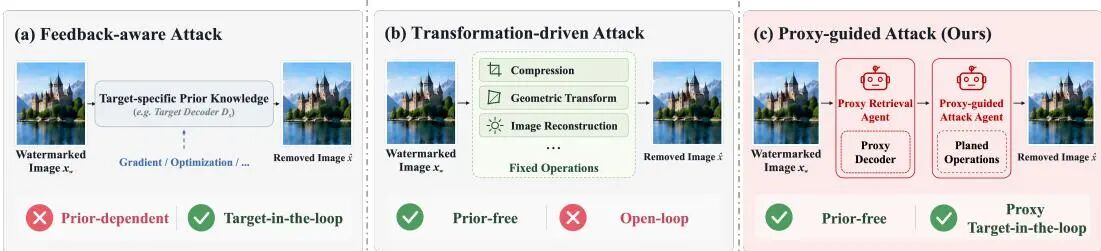
论文把已有的水印去除攻击归成两类,这个分类是理解全文的钥匙。一类叫反馈感知型(feedback-aware),能拿到检测器输出、解码器响应、梯度信号、成对的水印图与干净图,或者目标专用的代理模型,于是每一次变换都能估出"水印被打掉了几成"。另一类叫变换驱动型(transformation-driven),不依赖任何目标先验,直接上压缩、几何畸变、去噪、重建,好部署,但基本是开环的——闭着眼睛往前推,不知道方向对不对。
621df26778f05KkH.gif Figure 1
不可见图像水印去除的不同范式对比。反馈感知型依赖目标先验,能估计去除进度;变换驱动型不需要先验,但属于开环攻击、缺少反馈;本论文走的是第三条路——把代理解码器放进回路里。
图1 把三条路的差别摆得很直白。左边那一路精准,但现实里拿不到那些信息;中间那一路现实,但不知道自己走到了哪儿;论文要走的第三条路,是在不碰隐藏解码器的前提下,依然拿到一个有方向感的反馈信号。说白了,就是把"盲打"改成"摸着走"🤔。

ProxyEraseAgent:用代理解码器搭建水印去除的闭环

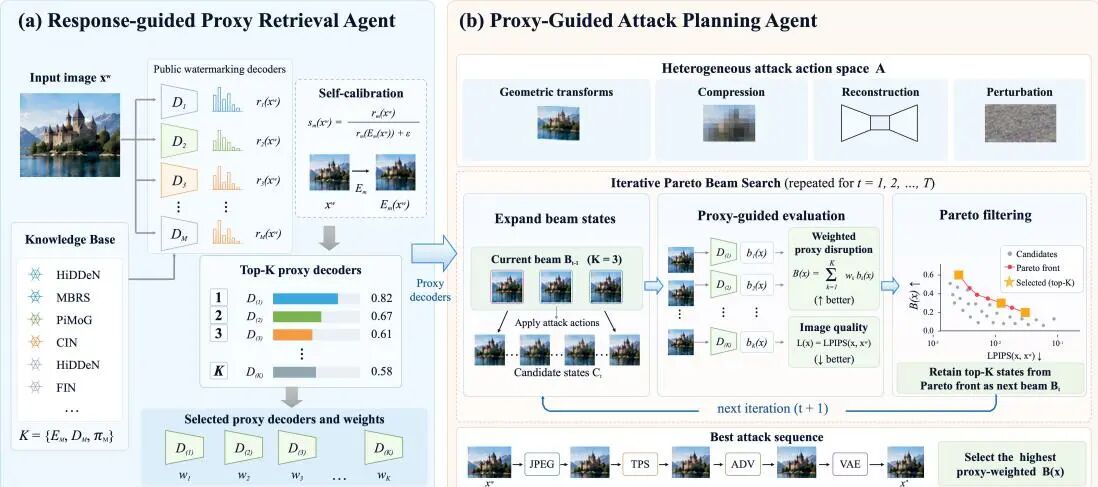
解开这个结的关键,是能不能在完全不知道目标算法的前提下,把攻击的"特异性"找回来。理想情况下当然是认出对方用的是哪套水印,然后用人家的解码器指路,但只有一张图的条件下这不现实。论文换了个角度:盲去除并不需要认出确切的算法,只要能判断出公开解码器里哪几个对这张图的反应最像那个隐藏的解码器,这几个解码器就能提供有用的方向。
于是就有了框架的名字:ProxyEraseAgent,直译过来是"代理擦除智能体"。它把公开的水印方案组织成一个外部知识库,用库里的解码器去估计那个隐藏的判决边界。知识库的形式化定义是:
formula_kb
公式1:解码器知识库的定义。K 表示整个知识库集合;E 下标 m 和 D 下标 m 分别是第 m 套水印系统的编码器和解码器;π 下标 m 是该系统的推理元数据,包含输入预处理方式、图像分辨率、消息长度、解码配置等;M 是知识库中收录的水印系统总数。
在这个定义里,解码器 D 下标 m 负责提供水印相关的响应,用于代理检索和后续的攻击引导;编码器 E 下标 m 则用来生成"自水印参考图",做响应校准。论文的知识库收录了 HiDDeN、MBRS、PIMoG、CIN、FIN、LightweightMark、RoSteALS、TrustMark、InvisMark、VideoSeal 和 ChunkySeal 十一套公开系统,覆盖了不同的嵌入机制、载荷容量和鲁棒性目标。这个多样性正是后面能泛化的前提——机制越杂,被检索出"有用代理"的概率越高。
Figure 2
图2:ProxyEraseAgent 的整体框架。响应引导的代理检索智能体(Response-guided Proxy Retrieval Agent)从知识库中筛出有信息量的解码器;代理引导的攻击规划智能体(Proxy-Guided Attack Planning Agent)利用它们的反馈构造自适应的水印去除路径。整个检索与搜索过程都不会访问目标解码器,目标解码器只在最终评估时出场。
整个系统就两个智能体在配合。第一个负责"找人",从知识库里挑出对这张图最有信息量的几个解码器;第二个负责"做事",拿着这几个代理解码器的反馈,在异质攻击空间里一步步搜出一条去除路径。两者串起来,一个原本没有反馈的开环问题,就变成了有反馈的闭环决策问题。这个思路本身不复杂,价值在于它把"我没有目标信息"这件事,从死路变成了一道可以检索的题。

自校准检索:让异构解码器的响应可比

先说要找什么样的人。论文的判断很直白:一个解码器如果对这张查询图给出了很强的、经过校准的响应,它就更可能和隐藏的目标解码器共享相近的解码边界。翻译成人话就是——它越像"内行",越值得信任。
"响应强度"用比特熵来量化。对输入图像 x,记 p 下标 m,j 为第 m 个解码器把第 j 个水印比特预测为 1 的概率,j 从 1 取到 L 下标 m,L 下标 m 是该解码器的消息长度。平均二元熵定义为:
formula_entropy
公式2:解码不确定性度量。H 下标 m(x) 表示解码器 D 下标 m 在全部解码比特上的平均不确定度;p 下标 m,j(x) 是第 j 个比特被判为 1 的概率。以 2 为底取对数时,二元熵被归一化到 0 到 1 之间,所以 H 越小说明比特预测越自信。对应的响应强度就定义为 R 下标 m(x) 等于 1 减去 H 下标 m(x)。
麻烦来了:不同解码器的响应尺度本来就不一样,有的天生"嗓门大",有的天生"嗓门小",拿原始响应强度横向比较并不公平。论文的解法是让每套系统自己给自己当标尺——用该解码器对应的编码器 E 下标 m,把水印图 x 上标 w 重新编一次,得到一张"自己人染过色"的参考图,再看解码器对原图和对这张参考图的反应差多少。校准后的检索分数定义为:
formula_calib
公式3:自校准检索分数。分子 R 下标 m(x 上标 w) 是解码器 D 下标 m 对未知水印图的响应强度;分母 R 下标 m(E 下标 m(x 上标 w)) 是它对"由自己的编码器重新加水印的参考图"的响应强度;ε 是保证数值稳定的小常数。这个比值把每个解码器自身的响应量级归一化掉了,让异构解码器之间的分数变得可比较。按这个分数排序,保留前 K 个作为代理解码器,分数归一化后作为攻击搜索中的重要性权重。
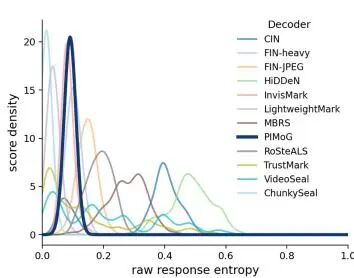
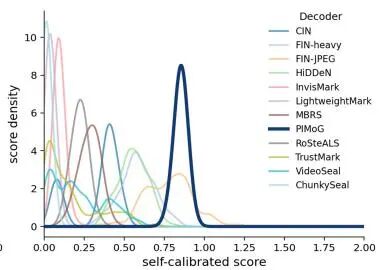
这招其实很像招聘时的"同题测试":不同人的卷子难度不一样,直接比原始分不公平,那就拿他会做的题当基准,再看他在陌生题上的相对表现。图4(b) 和图4(c) 给出的分布也印证了这一点——原始响应熵在不同解码器之间尺度散乱,自校准之后才收拢成可以排序的分数。这里没有玄学,就是一次标准化的功课。

Pareto束搜索:在攻击效果和图像质量间找最优解

人挑好了,接下来是活怎么干。论文没有押注某一种固定变换,而是搭了一个异质攻击空间,包含四个互补的操作族:
formula_space
公式4:攻击动作空间。A 下标 geometric 是几何形变族,实验中采用 TPS 形变,即薄板样条变换(Thin Plate Spline),一种非刚性几何形变方式;A 下标 compression 是压缩失真族,实验中采用 JPEG 压缩,JPEG 是联合图像专家组(Joint Photographic Experts Group)制定的有损图像压缩标准;A 下标 regeneration 是图像重建族,实验中采用 VAE 重建,VAE 即变分自编码器(Variational Autoencoder);A 下标 adversarial 是对抗扰动的轻量优化攻击。每个操作族都含多个强度档位,搜索时同时决定用哪种操作、用多大强度。
为什么四个族要一起上?因为不同水印机制的软肋不一样:有的怕压缩,有的怕几何变形,有的对重建极其敏感,还有的只在对抗扰动方向上失效。固定一种操作,注定会在一部分系统上失灵——后面表1 的数字会把这件事讲得非常直白。
那么每一步怎么判断走得好不好?目标解码器读不了,就请代理解码器来读。记 ŷ 下标 m(x) 为代理解码器 D 下标 m 从图像 x 中解出的二进制消息。由于原始水印消息不可得,就以该代理在原始水印图上的解码结果当作参考,定义代理比特错误率:
formula_ber
公式5:代理比特错误率。b 下标 m(x 下标 t) 衡量候选状态 x 下标 t 让代理解码器 D 下标 m 解出的消息,相对原始水印图发生了多大改变,数值越大说明破坏越有效。BER 的英文全称是 Bit Error Rate,中文含义是比特错误率,即解码出的比特里判错的比例。同时,相对原始水印图的感知失真用 LPIPS 度量,其英文全称是 Learned Perceptual Image Patch Similarity,中文含义是学习感知图像块相似度,是一种基于深度特征的图像感知差异度量,由 Zhang 等人提出。
这两个目标天生打架:破坏越强,画质越差。论文用帕累托(Pareto)束搜索来平衡,名字里的帕累托来自 Vilfredo Pareto 提出的多目标最优概念,指的是无法在不损害另一个目标的前提下继续改进的状态集合。搜索从原始水印图出发,每一步用所有可行动作及其参数设置扩展当前候选;先按预先设定的感知失真预算把超标的候选丢掉;再在剩下的候选里做帕累托过滤——如果候选 x 下标 j 的代理破坏分数不低于 x 下标 i、感知失真不高于 x 下标 i,且至少有一个是严格更优,那就说 x 下标 i 被 x 下标 j 支配,被支配的候选直接淘汰,只留非支配的。束宽固定为 3,也就是每一步保留三个代表不同"效果—保真"权衡的候选继续往下展开,最多搜 T 步。搜索结束后,在满足感知质量约束的状态里挑代理破坏分数最高的那个:
formula_select
公式6:最终攻击状态的选取。x 上标星号 是在所有满足 L(x) 不超过 τ 下标 select 的候选中,代理破坏分数 B(x) 最大的那个状态;τ 下标 select 是感知质量阈值,实验中取 0.05。若出现并列,优先选择感知失真更低的,其次选择攻击序列更短的。
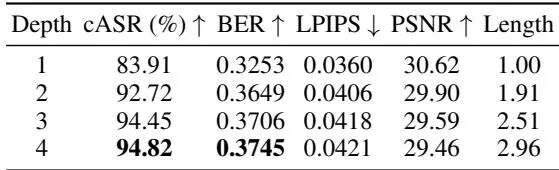
这套搜索有个容易被忽略的好处:它不要求每一步都"更狠",只要求每一步都"更值"。论文实验里的默认配置是最大搜索深度 4,平均选出的攻击序列长度约 2.96 步——也就是说,很多图像确实是靠多步互补操作啃下来的,而不是靠单一动作硬砸出来的。🙂

11种水印系统实测:94.8%成功率的背后


实验设置与评价指标

实验从 MS-COCO 2017 数据集(Microsoft Common Objects in Context,微软常见物体上下文数据集,Lin 等人于 2014 年发布)中随机抽取 100 张真实图像,每张图像分别用 11 套代表性水印系统独立加水印,包括 CIN、ChunkySeal、FIN、HiDDeN、InvisMark、LightweightMark、MBRS、PIMoG、RoSteALS、VideoSeal 和 TrustMark,全部使用官方公开模型与官方推理配置。
对比方法覆盖四大类。非几何类包括 BM3D(Block-Matching and 3D filtering,三维块匹配滤波,一种经典图像去噪算法)、亮度调整、对比度调整、高斯模糊、高斯噪声和 JPEG 压缩;几何类包括裁剪、旋转和缩放;基于重建的攻击包括 Regen-VAE 和 Regen-Diffusion(Zhao 等人,2024);专用水印去除方法包括 AdvEmbB-RN18、AdvEmbB-CLIP(An 等人,2024)和 UnMarker(Kassis 与 Hengartner,2025),其中 UnMarker 采用论文所述的 HL 配置以符合本评测的感知质量约束。
评价指标有两个:去除效果用 BER(比特错误率)衡量,图像质量用 LPIPS(学习感知图像块相似度)衡量,其骨干网络为 AlexNet。主指标是带约束的攻击成功率 cASR,英文全称 Constrained Attack Success Rate,中文含义是约束攻击成功率,它要求两个条件同时满足才算一次成功攻击——目标解码器的 BER 不低于 0.1,且 LPIPS 不高于 0.05:
formula_casr
公式7:约束攻击成功率 cASR 的定义。N 为测试图像数量,方括号中的指示函数在条件成立时取 1、否则取 0。BER 下标 i 不低于 0.1 表示目标水印已被破坏到不可靠的程度,LPIPS 下标 i 不高于 0.05 表示图像外观仍在可接受的失真范围内,两者必须同时满足。

实验结果分析

先说实验设置的合理程度。100 张 MS-COCO 真实图像、11 套机制各异的水印系统、固定的感知质量约束,再加上"目标解码器排除在知识库之外"的盲设定,这套组合在评测层面是站得住的。尤其是盲设定的处理值得单独点一下:如果目标解码器也在候选池里,那这套方法几乎等于开卷考试;论文把这个条件单独拎出来做消融,态度算是端正。
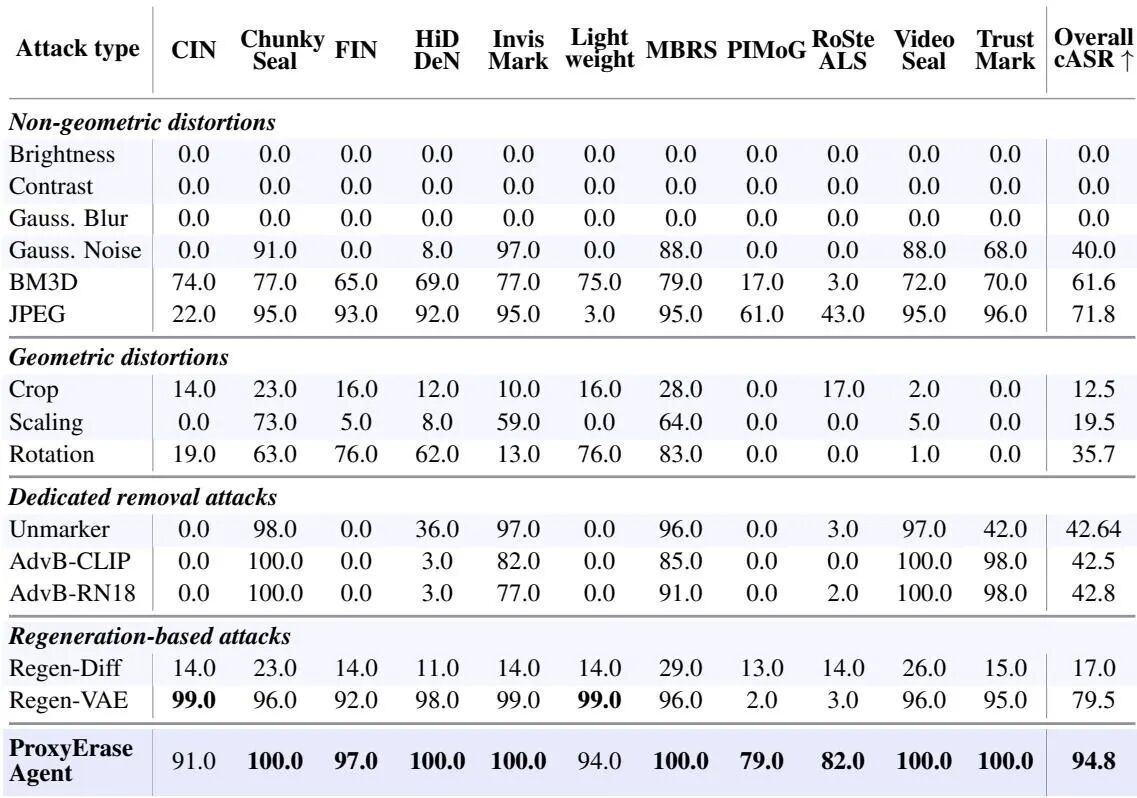
再从几个维度看结果的显著程度。全局上,本论文在 11 套系统上的整体 cASR 达到 94.8%,相比最强的固定攻击 Regen-VAE 的 79.5% 高出 15.3 个百分点,并且在 11 套系统中有 9 套取得最好成绩,说明这个优势不是被某一两个系统拉起来的。机制上,提升的来源也很清楚:固定攻击的失效方式是"机制依赖"的——Regen-VAE 在 RoSteALS 上只有 3%、在 PIMoG 上只有 2%,而本论文靠代理反馈动态组合操作,把这两个短板分别拉到了 82% 和 79%。换句话说,闭环搜索真正换来的,是跨机制的稳定性,而不只是平均分好看。
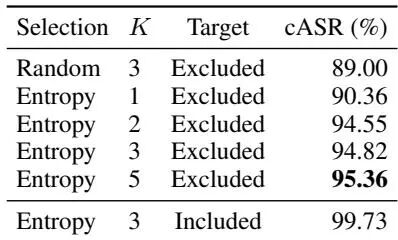
消融实验也在支撑这个解释。代理解码器的挑选方式影响不小:随机选 3 个代理只有 89.00% 的 cASR,按校准熵响应选 3 个则到 94.82%,说明"选谁"这件事本身有信息量;代理数量从 K 为 1 时的 90.36% 涨到 K 为 3 的 94.82%,再涨到 K 为 5 的 95.36%,收益逐渐饱和,说明三到五个代理已经覆盖了主要方向,继续堆数量性价比下降。作为上界参考,如果知识库足够大、目标解码器恰好落在候选池里,K 为 3 时 cASR 可以到 99.73%——这也从侧面说明,当前这 4 到 5 个百分点的差距主要来自"代理不在场",而不是搜索策略本身不行。
搜索深度的消融同样有说服力。深度为 1、也就是只允许单一操作时,cASR 只有 83.91%;深度升到 2 就跳到 92.72%,深度 3 和 4 分别是 94.45% 和 94.82%,而平均 LPIPS 只从 0.0360 缓慢升到 0.0421,始终留在 0.05 的约束之内。这说明多步组合并不是拿画质硬换效果,而是真的找到了更合适的操作序列。这点挺关键——如果每多走一步都要付出明显的画质代价,那这套搜索的实用价值会大打折扣。
该说的问题也得说。第一,PIMoG 上 79% 的成绩明显低于其他系统,说明代理检索在个别机制上仍会失灵,这个短板没有被方法本身彻底解决。第二,本论文的收益有一部分建立在"知识库覆盖了与目标同族的系统"这一前提上;如果遇到训练机制完全陌生的水印方案,能拿到多少收益还需要更多验证。第三,论文报告了效果,但没有给出推理耗时与算力开销的完整账本,而这套流程每张图都要先过一遍知识库解码器、再做多步搜索,实际成本并不低。另外需要说明的是,本段及后文引用的对比数据,仅是 PaperDaily 已收录论文范围内的辅助判断,不构成对全局 SOTA 的定论;在别的评测集或不同的 BER、LPIPS 阈值下,排名有可能变化。

实验结果

表1 是最核心的一组数字,把全局固定攻击、专用去除攻击、重建类攻击和 ProxyEraseAgent 摆在同一张表上。一次攻击被记为成功,需要同时满足目标解码器 BER 不低于 0.1、AlexNet LPIPS 不高于 0.05。
Table 1
表1:全局固定攻击与 ProxyEraseAgent 的约束攻击成功率 cASR(%)。每一列对应一套水印系统,最后一列为 11 套系统的整体 cASR。可以看到亮度、对比度、高斯模糊这类操作的 cASR 全线为 0,JPEG 和 BM3D 在部分系统上能到 90% 以上、在另一些系统上接近 0,专用攻击和重建类方法也普遍存在明显的机制短板,而 ProxyEraseAgent 的整体 cASR 达到 94.8%,且在 9 套系统上取得最优。
表2 是两组消融,分别回答"代理怎么选"和"搜多深"这两个问题。
Table 2a
表2(a):代理解码器选择策略的消融。随机选 3 个代理、目标解码器被排除在知识库外时,cASR 为 89.00%;按熵响应选 1、2、3、5 个代理时,cASR 分别为 90.36%、94.55%、94.82% 和 95.36%;若目标解码器被包含在知识库中,K 为 3 时 cASR 升到 99.73%。
Table 2b
表2(b):最大搜索深度的消融。深度为 1 时 cASR 为 83.91%,平均攻击序列长度为 1.00;深度 2 时为 92.72%,长度 1.91;深度 3 时为 94.45%,长度 2.51;深度 4 时为 94.82%,长度 2.96。与此同时平均 LPIPS 从 0.0360 升到 0.0421,PSNR 从 30.62 降到 29.46,画质代价有限。
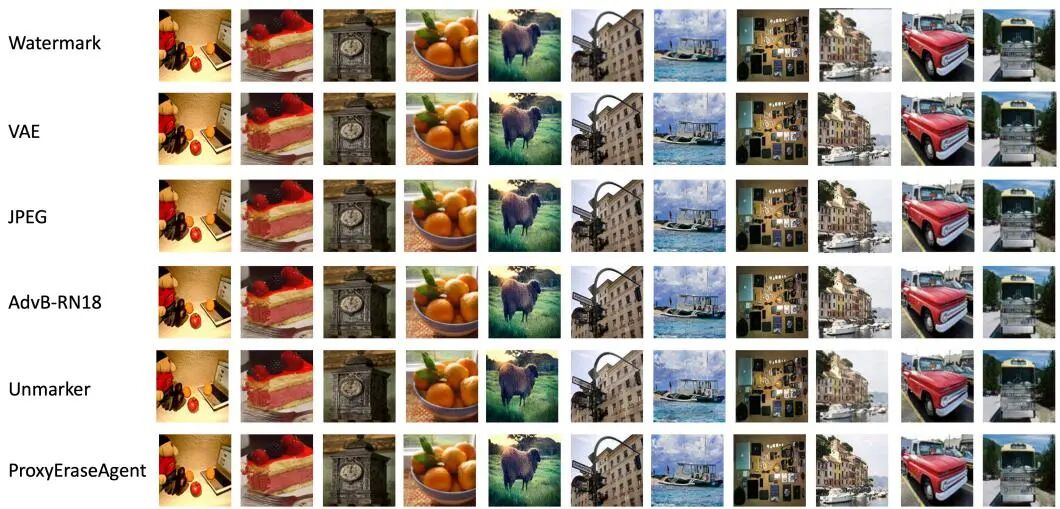
图3 给的是定性对比,一眼能看出不同攻击在视觉上的差别。
Figure 3
图3:水印图像攻击的示例对比,包含 JPEG 压缩、基于 VAE 的重建、AdvB-RN18 对抗攻击、Unmarker 对抗攻击以及 ProxyEraseAgent 的结果。可以看到在感知质量接近的前提下,不同方法对画面的破坏方式并不一样。
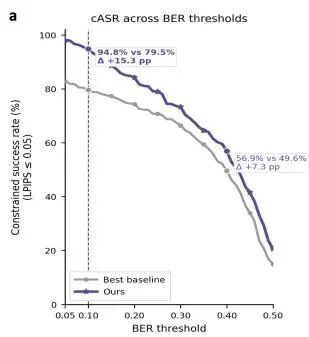
图4 用三张子图补充了阈值敏感性、原始响应熵分布和自校准分数分布三件事。
Figure 4a
图4(a):不同 BER 阈值下的约束攻击成功率。感知约束固定为 LPIPS 不高于 0.05,随着 BER 阈值提高,所有方法成功率都会下降,但 ProxyEraseAgent 始终保持着明显领先。
Figure 4b
图4(b):原始解码器响应熵的分布。不同解码器之间的响应尺度差异很大,直接比较并不公平。
Figure 4c
图4(c):自校准检索分数的分布。经过自校准后,原本尺度散乱的响应被归一化成可以排序的分数,这也是代理检索能够生效的直接依据。

总结与展望:盲水印去除的新范式

这篇论文真正值得记住的地方,不是 94.8% 这个数字,而是它把"盲水印去除"从一个开环的变换问题,重新定义成了一个代理在环的闭环搜索问题。以前的做法是在"有先验但用不上"和"没先验但闭眼打"之间二选一,本文给出了第三条路:先检索一个行为接近的代理,再让代理的反馈来指路。这个框架不是为某一种水印设计的,它对机制差异的容忍度来自于知识库的异质性。
对水印一方来说,最直接的启示是:只测固定强度、固定顺序的鲁棒性已经不够用了。攻击方一旦拿到自适应能力,"平均鲁棒性"这个指标会变得很不可靠,评测必须把自适应攻击者纳入考虑,尤其是知识库里存在同族方案的时候。对做内容治理的一方来说,这篇论文更像一记提醒——水印作为溯源手段的可信度,是有前提的。当攻击者只需要一张已经公开传播的图片、不需要任何内部接口就能把成功率推到 90% 以上,单靠像素域水印做判罚显然不够,往语义层、生成源头绑定、多渠道交叉验证去走,可能是更稳的方向。
当然,边界也要讲清楚。第一,知识库的覆盖度直接决定上限——论文自己也验证了,一旦目标解码器进入候选池,成功率能到 99.73%,说明当前结果对知识库的依赖是实打实的。第二,本方法每张图都要过一遍知识库解码器并做多步搜索,算力开销不便宜,部署时要么接受离线批处理,要么在代理数量和搜索深度上做取舍。第三,LPIPS 不高于 0.05 是一个相对宽松的约束,如果真实平台要求更严格的画质,成功率会打折扣,这一点在阈值敏感性实验里已经有体现。

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?中国科大等提出ProxyEraseAgent,用公开水印解码器做代理,通过自校准检索加Pareto束搜索构建闭环攻击路径,在11种水印系统上取得94.8%的受约束攻击成功率。
这篇工作最值得看的点是什么?ProxyEraseAgent在11种水印系统上取得94.8%的整体cASR,在9/11个系统上取得最佳性能,比最强固定攻击Regen-VAE(79.5%)高出15.3%。在CIN上达到91%,PIMoG上79%,RoSteALS上82%,其余系统均达到94%以上。
这篇工作的边界或风险在哪里?优点:(1)首次提出代理在环的盲水印去除范式,无需访问目标解码器即可获得攻击特异性反馈;(2)自校准检索机制有效解决了异构解码器响应尺度不可比的问题;(3)Pareto束搜索在攻击效果和感知质量之间取得良好平衡;(4)在11种水印系统上验证了方法的通用性和有效性。缺点:(1)知识库的覆盖范围直接影响方法性能上限,当目标水印机制与知识库差异较大时效果可能下降;(2)攻击搜索需要多次调用代理解码器,计算开销较大;(3)对抗扰动操作需要额外的优化过程,增加了整体攻击时间;(4)未讨论对自适应水印系统的鲁棒性。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

提出ProxyEraseAgent智能体驱动框架,通过从公开水印模型知识库中检索校准响应最强的代理解码器,利用其反馈信号引导异构攻击操作(几何畸变、JPEG压缩、图像重建、对抗扰动)的序贯搜索,在无目标解码器访问权限下实现单图像盲水印去除。

实验合理度:★★★★☆

约束攻击成功率(cASR)、比特错误率(BER)、LPIPS

学术研究价值:★★★★☆

提出ProxyEraseAgent智能体驱动框架,通过从公开水印模型知识库中检索校准响应最强的代理解码器,利用其反馈信号引导异构攻击操作(几何畸变、JPEG压缩、图像重建、对抗扰动)的序贯搜索,在无目。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

现有材料缺少完整训练资源、参数量、显存和推理时延信息,成本暂按中性评价。

复现难度:★★★☆☆

现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:;(3)Pareto束搜索在攻击效果和感知质量之间取得良好平衡;(4)在11种水印系统上验证了方法的通用性和有效性。缺点:(1)知识库的覆盖范围直接影响方法性能上限,当目标水印机制与知识库差异较大时效果可能下降;


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球