LEVER 的想法一句话可以说完:既然证明的品质是在构造过程中被决定的,那就让品质目标直接进搜索,在证明还没写完的时候就给它打分。问题是,一份没写完的证明怎么打分?LEVER 的做法是拆开算。一份部分证明里,有些子目标已经证完了,有些还开着。已经证完的部分按实际发生的代价计分,还开着的目标就用值函数去预测它的代价。两者加起来,就是这份部分证明当前的分数。每一次,只挑当前分数最好的那一份部分证明继续往下展开。这样一来,目标从搜索的第一步就开始引导方向,而不是等证明做完了再回头评。这里的“可编程”三个字是重点。计算开销、证明长度、主题不纯性,甚至它们的加权组合,都能被写成目标函数塞进同一套搜索机制里。而正确性从头到尾都是硬约束:每一次分解、以及最后拼装出来的完整证明,全部要过 Lean 内核这一关。用一个不太严谨但好理解的比喻:以前的定理证明器像是一个只求及格的考生,交卷之后老师再帮忙把卷面擦干净;LEVER 是让“卷面分”从做题的第一分钟起就参与决策——这道题该走哪条路,从开头就算进去了。
AND/OR 图上的自适应搜索:选择、展开与回传
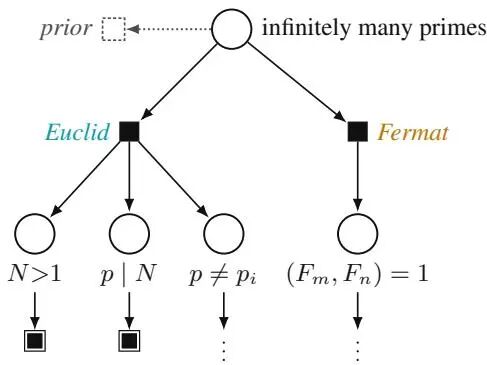
要把这套机制讲清楚,得先交代它脚下的数据结构——AND/OR 图(AND/OR graph)。这是一种有向无环图,节点分成两派,边在两类节点之间交替。OR 节点表示一条待证的目标,也就是一个定理或者引理,画成圆形;AND 节点表示针对这条目标的一种分解方式,画成方形,它把这条目标拆成若干子目标。规则很符合直觉:OR 节点只要有一个孩子被解决,它就算解决了,因为换一条路走通就行;AND 节点必须所有孩子都被解决才算解决,因为拆出来的子目标一个都不能少。如果某个 AND 节点底下没有孩子,说明这条目标不需要新引理就直接证出来了。图 1:AND/OR 图结构。OR 节点(目标)是圆形,AND 节点(分解方式)是方形;同一个目标可以拥有不同的分解方式,图中展示的是欧几里得与费马两条不同的证明路径。双边框的 AND 节点表示直接证出,虚线框的 AND 节点是“先验”(详见后文)。图里有个挺妙的细节:同一条目标,欧几里得的分解方式和费马的分解方式,在同一个图里并存。这正是 AND/OR 图的价值——它天然能容纳“多条推理路径”这件事,而不是逼着你早点做选择。图上的每条边都带一个非负代价。代价怎么回传,论文给了一条很干净的递归规则:AND 节点的值是它所有子节点的值之和(因为每个都得证),OR 节点的值是它孩子里最小的那个(因为挑最便宜的路走)。已证叶子的值记 0,假的目标记无穷大。公式 1:值回传规则。V(n) 表示节点 n 的代价估计,ch(n) 是 n 的孩子集合,c(n,d) 表示从 n 走向孩子 d 这条边上的代价。左式为 AND 节点,代价累加所有子节点;右式为 OR 节点,只取最便宜的那个孩子。这样,根节点的值 V(r) 就是最便宜那个解子图的代价,在每个 OR 节点记录下 argmin,就能把整条路径还原出来。接下来是搜索本身,论文把它建模成一个马尔可夫决策过程(Markov Decision Process,简称 MDP)。状态就是目前已经建出来的图,包含每个节点的状态和边上的代价,完全可观测。动作是下一步去展开哪个 OR 节点,或者干脆就此打住。转移指的是往图里加上新的分解和对应的子目标,而这个过程是随机的——同一个目标展开两次,抽出来的东西可能完全不一样。奖励则是每一步扩张扣掉的真实开销,再加上终止时的负的根节点值;如果最终没证出来,那就是负无穷。有了这个描述,LEVER 每一轮只做三件事。
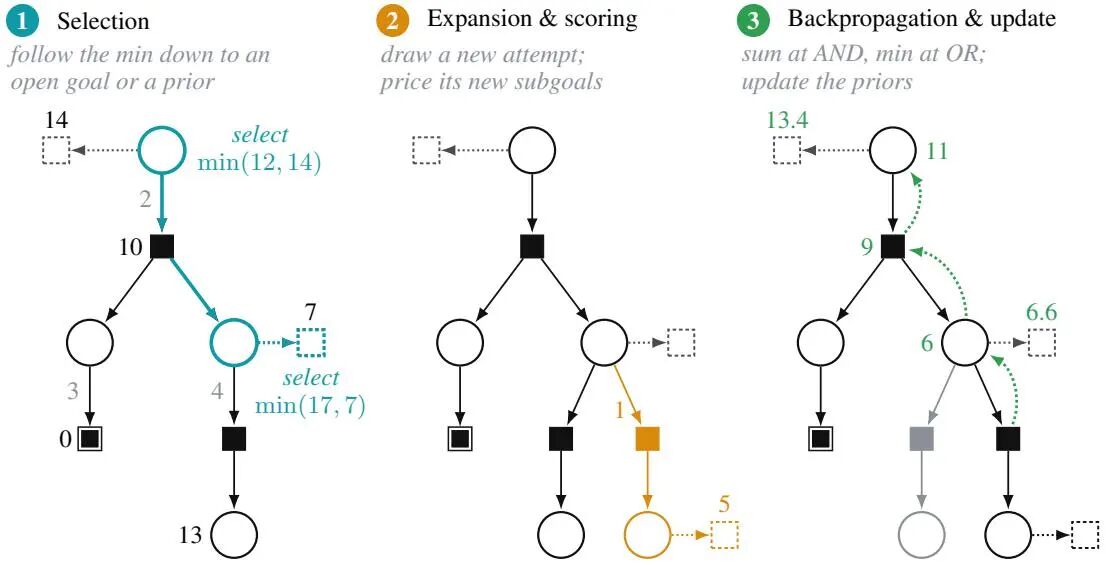
选择(Select)从根节点顺着当前最好的解子图往下走:到 OR 节点就取值最小的那个孩子,到 AND 节点就把所有孩子都带上。当走到某个 OR 节点、发现它的最小孩子是个“先验”时,就意味着这条目标值得重新展开一次。
这里藏着一个很关键的设计:任何已经拥有孩子的中间 OR 节点,理论上都可以被重新展开。因为展开器是大模型,输出自带随机性,同一个目标多抽几次,完全有可能抽到一条更便宜的路子。但值估计本身是带噪声的,所以第二次抽取必须比现有方案好出 δ 倍才算数,否则图会失控式膨胀。
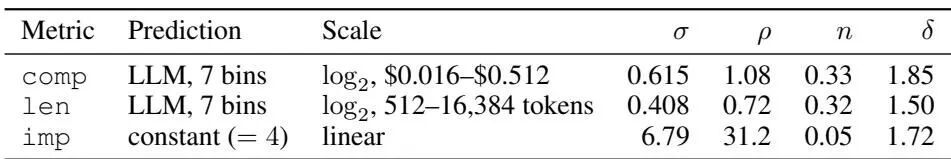
回传这一步用的是贝叶斯式的更新:把某个目标一次全新分解的对数代价建模成围绕未知均值 μ_g 的正态分布,而值函数的预测 V₀(g) 与 μ_g 之间差一个 ρ。在做了 k 次分解、拿到代价 v₁ 到 v_k 之后,后验均值是下面这个形式。公式 2:先验的后验更新。V₀(g) 是值函数对目标 g 的初始预测,v_i 是第 i 次实际分解的真实代价,k 是已完成的抽取次数;n = σ²/ρ² 表示“先验相当于几次实际抽取”的权重,σ 是同一目标多次抽取之间的波动幅度,ρ 是预测误差。换句话说,值函数的预测被折价成 n 次观测,而每一次真实抽取算一次。最终的估计取后验的几何平均。这样,真实花掉的钱会持续修正值函数的偏差——这就是搜索“从自己已经付出的开销里学习”的机制。至于失败的尝试,没有代价可学,就把估计整体抬高一个 σ。整套流程写成伪代码只有十几行:
算法 1:LEVER
输入:根节点 r,预算 B
1  给根节点挂上先验 Prior(r)
2  while 已花费 < B do
3      待展开集合 T ← Select(r)
4      if T 为空 then 跳出
5      for each 目标 g in T do
6          分解集合 D ← Expand(g)
7          for each 分解 d in D do 给 d 的子目标挂先验
8          回传更新 Backpropagate(g)
9  返回 r 对应的最优解子图
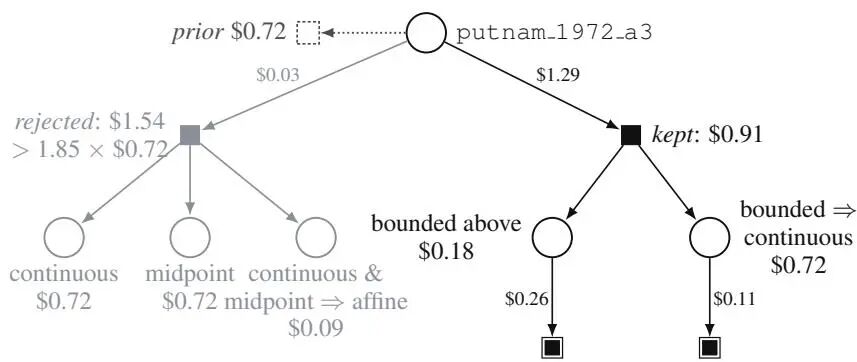
图 2 把一轮迭代画得很清楚:根节点的第二个子目标那里,先验的估值压过了已经实现的那次尝试,于是这个中间目标被重新展开;新尝试的代价随后向上传到根节点,沿途顺便把各个先验刷新了一遍。而第一次尝试仍然留在图里——钱已经花了,只是不再被选中。图 2:LEVER 的一轮迭代。灰色数字是边代价,黑色数字是节点值;后面的分面板只标注该步发生变化的部分。在根节点的第二个子目标处,先验的估值优于已经实现的尝试,于是该中间目标被重新展开;新尝试的代价随后上传到根节点,并沿途更新先验。第一次尝试仍保留在图中,已付费但不再被选中(灰色)。顺带说一句,回报里那个“已花费”的项其实不能直接进目标函数,因为它累计在整个搜索过程上,包括那些最终证明根本用不到的抽取。论文因此把它拆成两半:已经花掉的钱是沉没成本,不可优化;剩下还没花的钱可以优化,论文管它叫 V_comp(n),也就是“把节点 n 完成还需要的计算开销”。已实现的边不额外计价,只有开放的目标按先验估计计入。这个拆分是把任意指标塞进同一套代数结构的关键一步。论文还给了一个理论层面的性质:如果先验是精确的,那么回传出来的值就是精确的——对任何沿边累加的非负代价,V(n) 就是 n 底下最便宜那个解子图的代价,而且 V(n) 取无穷大当且仅当不存在这样一条路。这段结论在 Lean 里做了形式化验证,放在附录 D。当然,现实中的值函数带噪声,所以才有公式 2 的更新和 δ 这个重抽门槛。
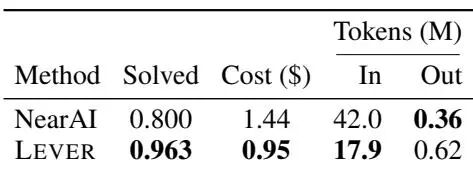
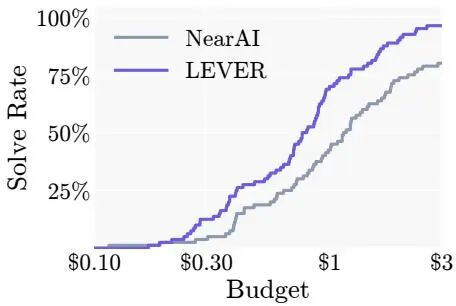
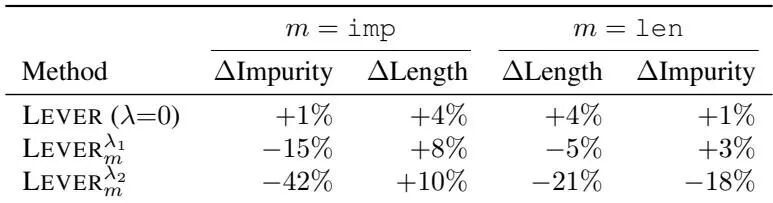
下面是龙哥对于大家可能的一些问题的解答:这篇论文到底在解决什么问题?证明只对还不够。哥伦比亚大学提出LEVER,在AND/OR图上给未完成的证明打分,把成本、长度与主题纯度都写进搜索目标。在PutnamBench上成本降34%,解出率从80%升到96.3%。这篇工作最值得看的点是什么?LEVER在3美元预算下解决率达96.3%,相比NearAI的80.0%提升16.3个百分点,同时成本降低34%(从1.44美元降至0.95美元)。在主题纯度优化上,LEVER减少42%的不纯引用,优于+Refactor的33%,且成本仅为其三分之二。在证明长度优化上,LEVER接近+Refactor的效果(21% vs 31%缩短),但成本更高。这篇工作的边界或风险在哪里?优点包括:首次将证明质量目标编程化并在搜索过程中优化,而非事后重构;AND/OR图表示使目标函数可组合;计算成本降低34%同时解决率提升;支持质量-成本权衡曲线;Lean内核保证正确性。缺点包括:主题纯度指标是代理指标,依赖Mathlib组织结构;共享子目标的NP难问题通过单一所有者近似;价值函数预测精度有限(comp仅34%落入正确bin);重绘策略可能浪费已投入成本;未与其他分解式证明搜索方法直接对比。如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~
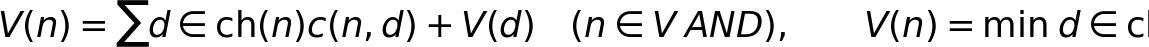


还没有公开留言,欢迎留下你的看法。