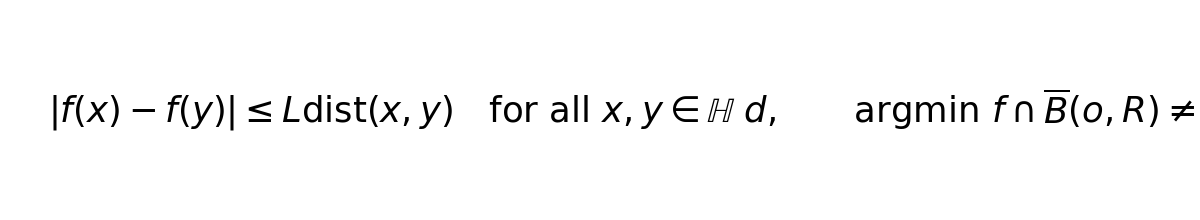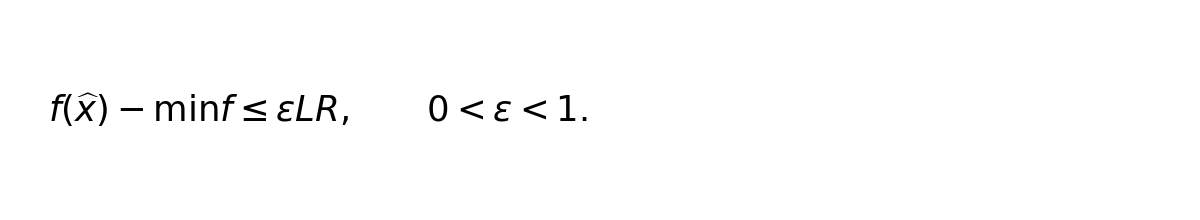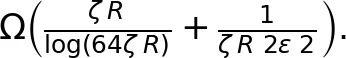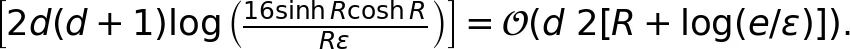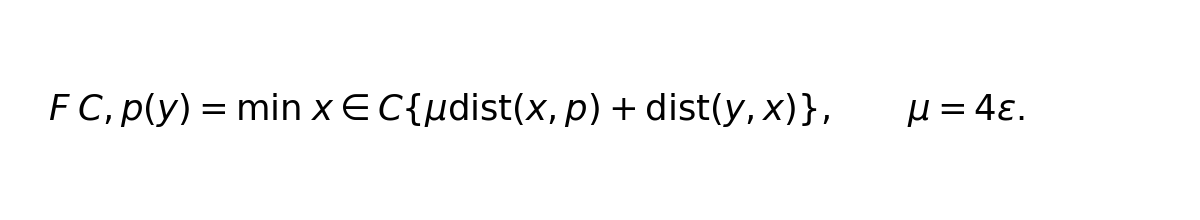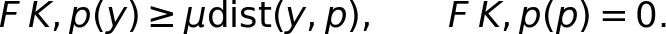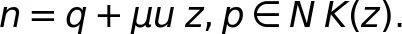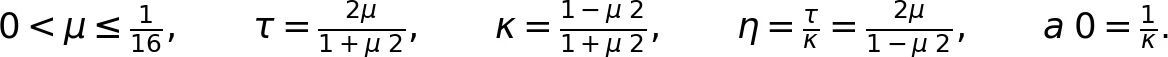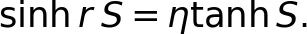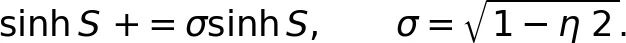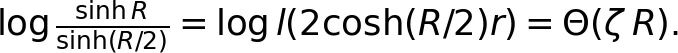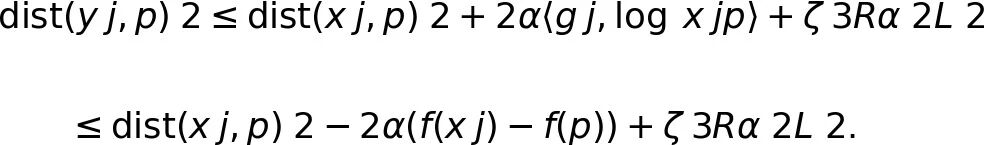← 返回 PaperDaily 大模型与智能体

北大论文自曝:整个证明流程由GPT-5.6驱动的系统完成

双曲空间里的优化,为什么天生比欧氏空间慢一截?北京大学这篇工作把答案钉死了:在不再给算法加任何额外限制的前提下,查询复杂度就是曲率因子乘以精度代价,曲率那部分躲不掉。上界早有人做出,下界这次终于补齐,中间那道多项式缺口被填平。理论控可以直接入,工程读者也能看清一件事——几何变了,信息代价就得重新算。

北大论文自曝:整个证明流程由GPT-5.6驱动的系统完成
原论文信息如下:
论文标题:
双曲空间中的测地凸优化:匹配下界(Geodesically Convex Optimization in Hyperbolic Space: Matching Lower Bounds)
发表日期:
2026年10月
发表单位:
北京大学
原文链接:
https://arxiv.org/pdf/2610.12184v1.pdf

双曲空间优化为什么这么难?下界理论告诉你答案

先从一个小问题说起:假设有一个凸函数,住在一个弯得很离谱的空间里,你每次只能问一个点——问它“这点的函数值是多少,往哪个方向走能变好”——那么最少要问多少次,才能保证自己找到的位置离真正的最优解足够近?
这个问题在欧氏空间里已经被研究得很透了。可一旦把舞台换成双曲空间,画风立刻不一样。欧氏空间里,半径 R 的球的体积按 R 的多项式增长;双曲空间里,半径稍微大一点,体积就按指数速度膨胀。换句话说,同样一块“候选区域”,在双曲空间里被摊薄成了指数多的地方,算法要付出的信息代价自然跟着水涨船高。
北京大学这支团队这次要回答的,正是这件事的“下限到底在哪”。而且他们把答案钉死到了常数级别——上界和下界严丝合缝地咬在一起,中间那道拖了很久的多项式缺口,被填平了。

先把几个概念说清楚

在正式进入结果之前,有几个术语必须先落地,否则后面的推导会变成一串看不懂的符号。

测地凸(geodesically convex):凸性不是按直线定义的,而是按测地线定义的。对空间里任意一条匀速测地线段 γ,都要求 f(γ(t)) ≤ (1-t)·f(γ(0)) + t·f(γ(1))。直观理解就是——在弯曲空间里,函数沿着“最短路径”也是往下鼓的。

全局利普希茨(Lipschitz):函数值的变化速度有上限,|f(x) − f(y)| ≤ L·dist(x, y)。L 就是这个上限,它同时决定了目标精度该怎么定义。

一阶预言机(first-order oracle):论文里把“问一次”抽象成一个黑盒。每问一个点 x,它返回两部分——精确的函数值 f(x),以及一个选定的黎曼次梯度(Riemannian subgradient)g。注意这里说的是“完整切向量”,不是一个被刻意截断的小分量。这一点非常关键,后面对造下界时所有的巧思,都建立在这个前提上。

黎曼次梯度:弯曲空间里梯度不在同一个切空间里,所以要借助对数映射(log map)把远处的点拉回当前切空间。次梯度的定义是一组不等式:对空间里所有的 y,都满足 f(y) ≥ f(x) + ⟨g, logxy⟩。

次梯度定义
图1:全局黎曼次微分(Riemannian subdifferential)的定义式。g 是切空间 TxHd 里的一个向量,要求它构造出的一阶支撑不等式在整个双曲空间上成立,而不只是在某个小邻域里成立。

问题是怎么被形式化的

论文把函数类记为 Fd(R, L),它要求三件事同时成立:函数在整个双曲空间 Hd 上测地凸;全局 L 利普希茨;全局最优解至少有一个落在以参考点 o 为圆心、半径 R 的闭球里。
函数类定义
图2:函数类 Fd(R, L) 的两条硬性约束。第一行是全局利普希茨条件,第二行保证最优解落在已知的定位球内。这个“提前告诉你最优解在哪个范围”的设定,是整个复杂度问题的前提。
算法的任务,是输出一个点 x̂,让目标间隙降到精度阈值以内:
目标间隙
图3:目标间隙的定义式。ε 是相对精度,L 是利普希茨常数,R 是定位半径,三者相乘决定绝对误差预算。这个写法本身就暗示了,误差天然带着“曲率半径”的量纲。
论文还额外规定:查询点可以随便选,不必落在定位球里,也不必落在此前回复划出的任何区域里;算法输出可以是一个从没查过的点。这个自由度,恰恰是此前那些下界啃不动的地方。

曲率因子 ζR 是个什么东西

整篇论文的“主角参数”只有一个:ζR = R / tanh R。
它有两个极限行为。当 R 趋于 0 时,tanh R ≈ R,所以 ζR 趋近于 1,几何局部接近欧氏,曲率几乎不构成负担。当 R 变大时,tanh R 趋近于 1,ζR 近似等于 R,惩罚按半径线性增长。
更一般地,如果空间曲率是 −k²,物理半径是 r,只要把度量整体缩放 k 倍,就能把它拉回曲率 −1 的标准情形,此时 R = kr,曲率因子变成 ζ = ρ / tanh ρ,其中 ρ = kr。论文在摘要里用的就是这个形式。
那么问题来了:这个 ζR 到底只是投影次梯度这个具体方法不够聪明导致的,还是任何算法都躲不掉的信息代价?要区分这两种可能,唯一的办法就是给出一个对任意自适应算法都成立的下界。

此前最好的下界,卡在哪里

这条线的上界由 Zhang 和 Sra 建立,投影黎曼次梯度下降可以达到 O(ζR·ε−2) 次查询。问题在于下界一直没跟上。
Criscitiello 和 Boumal 此前给出的无限制下界是这个样子:
此前下界
图4:Criscitiello–Boumal 的无限制下界。它由两项相加组成,一项管曲率,一项管精度,是“加法”而不是“乘法”。正是这个结构差异,导致它与上界之间留下了一道对 (R, ε) 联合依赖的多项式缺口。
他们另外还证明了 Ω(ζR·ε−2),但那个结果附加了两个限制条件:一是测地跨度限制(geodesic-span),也就是查询点必须落在已有查询张成的某个范围内;二是历史半空间限制(historical-halfspace),要求查询点必须落在此前回复所隐含的那些支撑半空间里。这两把锁一加上,结论的适用范围就被大大削窄了。
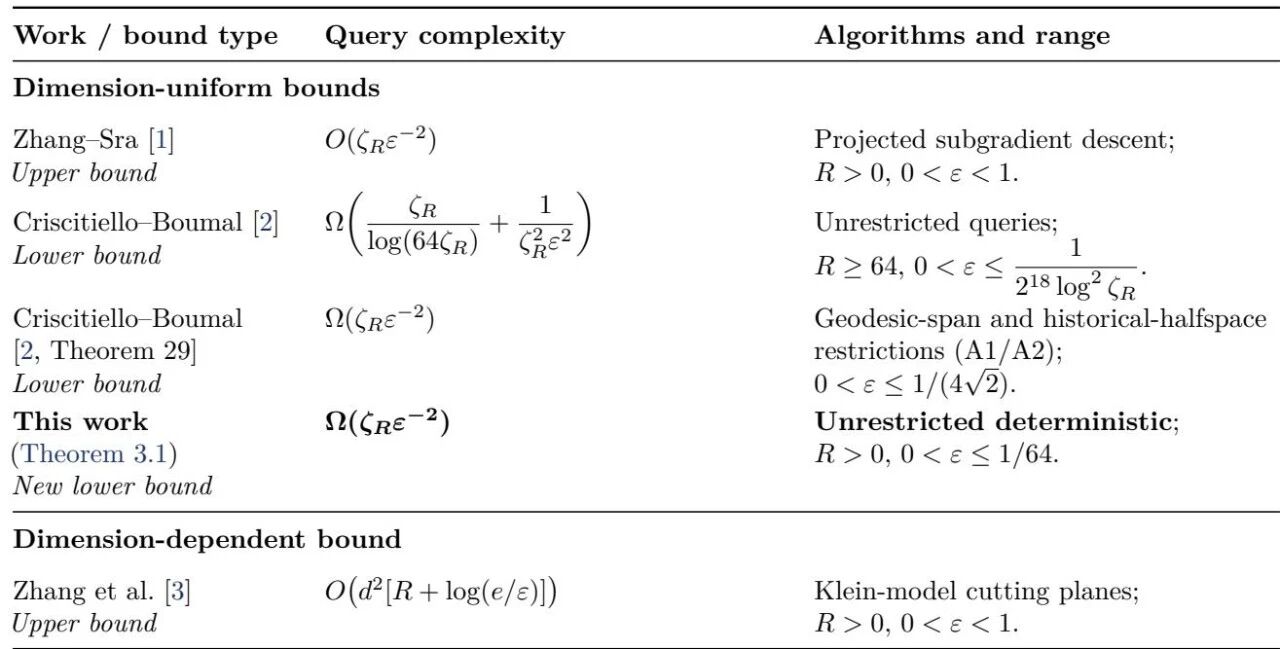
论文把这几条线放在一起做了对比:
确定性精确一阶查询界对比
表1:目标间隙为 εLR 时,确定性精确一阶查询复杂度的现有界对比,曲率因子 ζR = R/tanh R。表格把“维度一致(dimension-uniform)”和“维度相关(dimension-dependent)”两类保证分开列出。可以清楚地看到,本论文(Theorem 3.1)在无限制确定性设定下给出了 Ω(ζRε−2),正面对上 Zhang–Sra 的 O(ζRε−2) 上界。

维度这道分水岭

Table 1 下半部分还列了一条容易被忽略的信息:如果把维度固定住,Zhang 等人基于 Klein 模型(Klein model)的切割平面法,可以做到精度项只按对数增长:
固定维度上界
图5:固定维度下基于 Klein 模型切割平面的查询复杂度上界。它明确带上了维度 d 的平方因子,代价是精度依赖从多项式降到了对数。
这看起来和本文的结论矛盾,其实不矛盾。本文证明的是“对所有维度取上确界”的那个最坏情形——下界构造用到的维度是 d = T + 2,会随着查询次数 T 一起长大。维度相关的上界和维度一致的下界,是两件不同的事,完全可以并存。

从凸载体到接触持久性:一个精巧的证明框架

下界证明的套路,通常是“造一个刁钻的函数,让算法怎么问都问不到点子上”。但这件事在双曲空间里格外难办,原因有两个。
第一,预言机返回的是完整的精确切向量。一个小分量藏在某个隐蔽方向上,你没法说它“观测不到”。第二,就算你在一堆查询点上把支撑不等式都检查了一遍,也不能自动拼出一个全局凸的函数来——Criscitiello 和 Boumal 甚至举出过反例,三个点上的值–次梯度支撑不等式就未必存在测地凸插值。
本文的思路是换一个切入点:不去逐个拼查询点,而是把所有历史回复统一用“一个凸载体的支撑半空间”来承载。

第一步:把径向源从凸载体延拓到全空间

设 C 是一个非空、紧致、测地凸的集合,p 是 C 里面的一个候选最优解。定义这样一个函数:
度量延拓
图6:本文的核心构造——从凸载体 C 出发的度量下卷积(metric infimal convolution)。μ 是精度相关的缩放系数,取 μ = 4ε。
这个定义看起来只是把“到 p 的距离”和“到载体里任意一点的距离”加权求和再取下确界,但它有三个非常漂亮的性质:它在整个双曲空间上全局测地凸;它全局 1 利普希茨;它还满足一个下界保证:
下界保证
图7:度量延拓函数的下界性质。左边的不等式意味着:只要一个点离候选最优解 p 足够远,它的目标值就一定很大。右边的等式说明 p 本身就是最小值点,并且取值恰好为 0。两句话合起来,就是“离得远 = 目标间隙大”这条因果链。
这一下就把“几何距离”翻译成了“目标间隙”。算法只要没能靠近 p,就自动输了。

第二步:把一次查询变成一条法向量

接下来是最关键的一步。假设查询点 z 落在载体 C 上,D 是 z 到 p 的距离,q 是一个单位切向量。如果这个组合向量:
法向量条件
图8:接触条件。n 由两部分拼成——查询方向 q,加上指向候选解 p 的径向单位方向 uz,p 乘以 μ。要求 n 落在载体 K 在 z 点的法锥(normal cone)里。
那么沿着 q 方向走 ℓ 步得到的点 y,它收到的预言机回复是完全确定的:
精确保持
图9:接触保持引理(Lemma 5.4)。左半部分是精确函数值 μD + ℓ,右半部分是一个明确的次梯度向量。也就是说,一次查询带来的返回值,可以完整地被一条法向量“预言”出来。
这里有个细节值得强调:只要这条法向量在未来载体扩张的过程中一直有效,那么这次查询的回复就永远不需要被修改。所以问题的重心,从“怎么构造函数”转移到了“怎么保证法向量一直有效”。

第三步:留一点余量,让法向量扛住未来的扩张

这是整个证明里最需要手艺的地方。论文引入了一组互相咬合的参数:
参数定义
图10:证明中反复出现的参数。μ 是精度缩放,τ 和 κ 构成一对满足 τ² + κ² = 1 的三角函数式配对,η 是两者的比值(也就是“余量/纬度”),a₀ 是归一化常数。这组参数的作用是:让接触角度可以在一定范围内浮动,而不破坏法向量的有效性。
具体到几何上,公共域 P 内部必须包含一个内蕴球(intrinsic ball),它的半径 rS 由下面这个关系确定:
公共球半径
图11:公共域内蕴球半径的定义。S 是候选点球面的半径。这个球的作用是给每一条公共支撑法向量提供一份定量冗余——法向量在它上面还留有余量,未来载体再怎么长,也不至于把它顶失效。
论文用了一个洛伦兹(Lorentz)几何下的计算,把一个纯标量的持久性不等式,转换成未来所有公共球的包含关系证明。这部分是全文技术密度最高的地方,涉及双曲空间的超球面模型、半空间–球判据、以及大量的分支讨论。

第四步:每条查询花掉多少“几何预算”

候选点球面的半径 S 每被查询推进一次,就按下面这个规律收缩:
半径收缩
图12:候选球半径的更新规则。σ = √(1 − η²),注意是对 sinh S 做乘法收缩,而不是对 S 本身。
因为 μ = 4ε,所以 η = 2μ/(1−μ²) 约等于 8ε,σ 距离 1 非常近。单次查询消耗的“势能”是 −log σ,量级正好是 Θ(ε²)。
而把候选半径从 R 压到 R/2,总共能动用的预算是:
几何预算
图13:从半径 R 压到半径 R/2 所需的几何预算。中间用了双曲正弦的恒等式,最后一步说明这个量正好是 Θ(ζR) 量级。曲率因子在这里不是硬塞进去的,而是从体积增长里自然长出来的。
预算总量除以单次消耗,得到的查询次数上界就是 Θ(ζR·ε−2)。这就是乘积形式的来源:曲率因子负责“能撑多久”,精度项负责“每次能收多少”,两者是相乘的关系,谁也替不了谁。

紧匹配下界:曲率惩罚不可回避

把所有零件拼起来之后,论文的主定理是这样陈述的:对任意的 R, L > 0 以及 0 < ε ≤ 1/64,维度一致的确定性查询复杂度满足
主定理
图14:本文主定理的复杂度刻画。左边是下界,右边是上界,两边都带上 ζR 和 ε−2 的乘积,而且常数是通用的。Θ 记号的另一端,来自 Zhang–Sra 的投影次梯度下降——论文为了让预言机和输出约定完全对齐,还把这条上界自包含地重新证明了一遍。
写成更一般的曲率形式就是开头提到的那个式子:
一般曲率形式
图15:曲率 −k² 空间下的查询复杂度。ρ = kr 是无量纲化的定位半径,ζ = ρ/tanh ρ。结论是:曲率惩罚必须乘进整个非光滑精度代价里,而不是和它并列相加。
最后一步是把“几何上的远”换算成“目标上的差”。当查询次数用满 T 次之后,候选点球面的半径至少还有 R/2。论文证明,任何一个幸存下来的候选点 p,离算法最终输出的那个点 x̂ 都至少隔着 R/2;而度量延拓函数的地板性质,把这段距离直接换算成目标间隙:
最终间隙下界
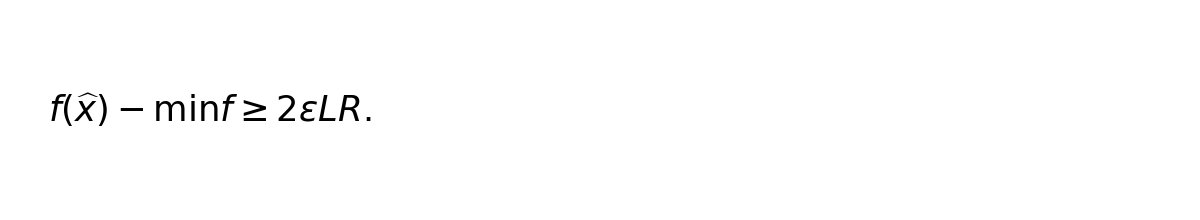
图16:下界的收尾不等式。算法如果只问 T 次,就一定存在一个函数和一个合法预言机,使得它输出的点满足 f(x̂) − min f ≥ 2εLR,也就是两倍于目标精度。这就是下界成立的最后一块拼图。
配套还有一个严格定位版本的推论:如果要求最优解必须落在开球 B(o, R) 内部而不是闭球上,同样的维度一致速率依然成立,只是常数会略有变化。

一个可能比定理本身还劲爆的脚注

论文里有一段关于 AI 使用的说明,值得原样引出来:
这篇论文几乎整个研究流程,都是由实验室内部自动研究系统 Colombo 完成的,其底座是 GPT-5.6 Sol。该系统还对成稿做了一次由 Lean 支撑的文章审计。作者随后审阅并批准了数学论断、表述与形式化产物,并对最终稿件负责。
621df26778f05KkH.gif
老实说,这段声明的信息量不比定理小。一个此前被认为需要顶尖几何分析功力才能啃下来的下界证明,现在由一套内部自动研究系统跑通了主流程,再用形式化工具做审计,人类作者只负责最终的审阅和批准。不管你对这条路线持什么态度,至少它说明了一件事:在结构清晰、验证闭环明确的数学证明任务上,人机分工的边界正在被重新画。

抵抗性预言机如何“骗过”所有确定性算法

前面讲的都是“几何怎么摆”。但下界证明还得回答一个更要命的问题:算法是自适应的,它每一步问哪里,取决于前面收到了什么回复。你怎么能保证有一个固定的函数,能在整条自适应路径上,把所有回复都对上?
论文给出的答案是构造一个“抵抗性预言机”(resisting oracle)。它一边跟算法周旋,一边维护一个存档不变量,具体做法是:

状态维护:每一轮,公共域 P 更新为“上一轮的 P 与这一轮新增公共球”的凸包。注意这些球一般不是嵌套的,所以必须把整个凸包都留着,不能只保留最新的那个。

双向保证:接触最优性保证旧凸包上所有历史不等式继续成立,未来球持久性保证后续插入的每一个球也不会破坏它们。两者合起来,才能让历史回复集体“不翻车”。

最终一次成型:对每一个还活着的候选点 p,取载体 C = gconv(P ∪ {p}),构造对应的 FC,p。论文证明了:这个函数可以在任意有限前缀之后,同时复现所有历史查询的值和完整次梯度。

剩下最后一步是把在线构造转成一次性离线构造。因为算法是确定性的,只要把抵抗性预言机给出的那串回复固定下来,就存在一个固定的函数 f 和一个固定的合法预言机 Of,让算法产生完全相同的运行轨迹。于是自适应对抗,等价于对单一固定实例的一次运行。
维度是怎么涨起来的?每处理一次查询,公共子空间最多扩展一维,所以查询次数为 T 的构造,需要 d = T + 2 维。这也是为什么定理陈述里要强调“维度一致”这个限定词——它说的是对所有维度取最坏情形,而不是在某个固定维度里。
论文还补了一条自包含的上界证明,把投影次梯度下降的迭代格式和半径递推写清楚:
投影次梯度迭代
图17:投影黎曼次梯度下降的距离递推式。第一项是上一次的距离,第二项是函数值的下降带来的收益,第三项是曲率因子 ζ3R 和步长平方带来的误差项。曲率正是从这里钻进上界的。
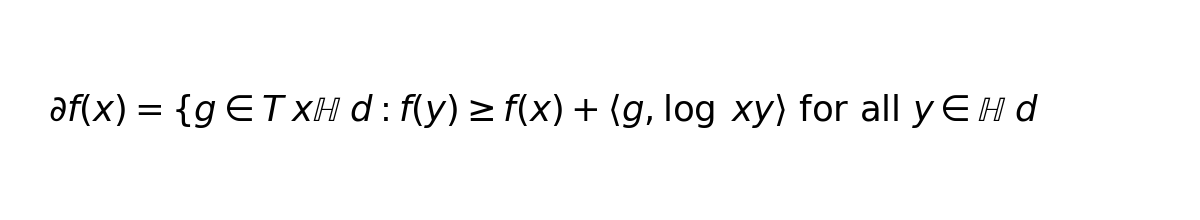
为什么此前那些“曲率无关”的好结果不算被打脸

论文专门花了一节解释这件事,避免读者产生误读。有一批工作在水平球凸(horospherically convex)、h-凸等更强的结构假设下,可以拿到与曲率无关的速率。这并不与本文的下界冲突,原因是:它们利用的是水平球支撑这种额外的几何信息,而本文的下界针对的是“从一般测地凸函数的任意普通黎曼次梯度里能榨出多少信息”。附加结构相当于额外给你开了个后门,自然不算在同一个信息预算里。
同样地,Han 关于水平球凸与测地凸对比的工作,用到了高阶导数(p ≥ 2 阶精确预言机),也超出了本文的预言机模型范围。这些边界划得很清楚,属于论文严谨的地方。

理论证明的边界与未来方向

论文对自身适用范围的界定相当克制,至少留了三条明确的边界。

确定性 vs 随机化:本文的下界只覆盖确定性算法。随机化算法能做到什么程度,论文明确表示这是另一个问题,没有给出结论。

维度一致性 vs 维度相关:下界成立时维度会随查询次数增长。固定维度下基于 Klein 模型切割平面的方法,能有远小于多项式量级的精度依赖,这两件事并不矛盾,而是刻画了不同的复杂度概念。

精度范围:定理要求 0 < ε ≤ 1/64。这个上限来自证明内部常数取整的需要,不是本质上不能放宽,但论文没有声称更大 ε 也成立。

另外,全文讨论的是“预言机查询次数”这个纯信息角度的复杂度,没有计算每次查询背后的算术开销。这是复杂度理论里的惯常做法——先把信息代价和计算代价拆开看清楚,再谈工程实现。对于真正想部署的人来说,这意味着论文给出的是“下界在哪”,而不是“你该怎么实现得更快”。
从研究路线看,接下来几个方向是自然的延伸:随机化算法在双曲空间里的最优复杂度是多少;能否在固定维度下也给出匹配的乘积下界;以及把测量从精确一阶预言机放宽到带噪预言机之后,曲率惩罚会不会进一步放大。

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?北京大学团队为双曲空间的测地凸优化给出无约束匹配下界,查询复杂度Θ(ζ_R/ε²)与投影次梯度上界吻合,证明曲率惩罚不可回避。
这篇工作最值得看的点是什么?论文为纯理论工作,证明了双曲空间中测地凸优化的紧匹配复杂度下界,与已有上界完全吻合,填补了无限制确定性算法下界的空白。
这篇工作的边界或风险在哪里?优点在于首次给出了无限制确定性算法在双曲空间中的紧匹配下界,去除了此前工作中测地跨度与历史半空间限制,构造精巧且证明完整;缺点在于仅适用于确定性算法和常曲率双曲空间,未覆盖随机化算法和一般Hadamard流形,且精度范围限制在ε≤1/64。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

把测地跨度限制和历史半空间限制这两把锁拆掉,同时给出严格的乘积形式下界,这是实质推进;整体框架沿用了凸载体与度量下卷积的经典思路,胜在组合与持久性论证的巧劲。

实验合理度:★★★★☆

纯理论论文没有数值实验,这一项评的其实是证明的自洽程度。上下界在常数层面咬合,作者还把上界重新走了一遍以保证预言机与输出约定一致,态度扎实;但缺少任何数值或仿真来展示界在有限参数下的实际表现。

学术研究价值:★★★★★

它把双曲空间一阶优化的信息复杂度钉在了 ζRε−2 上,等于宣告曲率惩罚是信息本身的性质而不是算法的短板,对这个方向后续的理论工作有直接的定标作用。

稳定性:★★★★☆

结论本身是确定性的数学刻画,不存在随机波动;但它是复杂度下界,不是一个可以直接部署的算法,稳定性这个维度在这里更多是“结论稳固”的意思。

适应性以及泛化能力:★★★☆☆

只覆盖确定性算法、0 < ε ≤ 1/64、且维度随查询次数增长的设定;随机化算法和固定维度下的匹配下界都留给了未来工作,泛化边界写得非常清楚。

硬件需求及成本:★★★★★

完全不需要 GPU,这是一篇靠纸笔和逻辑推理完成的工作,训练和推理的成本都是零。

复现难度:★★★★☆

定理陈述清晰、关键参数全都显式给出,理论上可以逐步验算;但证明链条长、洛伦兹几何与超球面模型的细节密集,要完整复现推演需要相当扎实的黎曼几何基础。

产品化成熟度:★☆☆☆☆

这是一条复杂度下界,本身不是算法,谈不上产品化。它的现实作用是给做双曲表示学习、层级嵌入、图几何模型的团队一个明确的心理预期:别指望在曲率大、半径大的场景里把迭代次数压到欧氏空间那个量级。

可能的问题:下界只覆盖确定性算法,维度还随查询次数增长,随机化与固定维度两道口子都敞着;此外论文自曝主要推导由自动研究系统完成,虽然有 Lean 审计兜底,核心细节仍值得同行逐条核验。


主要参考文献

Wendao Wu, Haihan Zhang, Chenheng Zhang, Yanyi Li, Chunyuan Zheng, Cong Fang, Haoxuan Li, Zhouchen Lin. Geodesically Convex Optimization in Hyperbolic Space: Matching Lower Bounds. arXiv:2610.12184. https://arxiv.org/pdf/2610.12184v1.pdf
H. Zhang, S. Sra. First-order methods for geodesically convex optimization. COLT, 2016.
C. Criscitiello, N. Boumal. Curvature and complexity: Better lower bounds for geodesically convex optimization. COLT, 2023.
H. Zhang, J. Yang, H. Zhu, et al. Cutting plane methods for geodesically convex optimization in hyperbolic space.
D. Azagra, J. Ferrera. Infimal convolutions and Lipschitzianity of optimal trajectories for the Bolza problem. Journal of Convex Analysis, 2006.

end
双曲空间里的上界早有人拿到,下界这次终于补齐 👇
欢迎加入龙哥读论文粉丝群,扫描下方二维码或者添加龙哥助手微信号加群:kangjinlonghelper。一定要备注:研究方向+地点+学校/公司+昵称(如 优化理论+北京+北大+龙哥),按格式备注可更快通过并进群。群里目前有图像处理、大模型及智能体、自动驾驶及机器人、AI医疗及AI金融五个方向。
wechat_helper dianzan

*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。