← 返回 PaperDaily
大模型与智能体
马里兰大学终结35年悬案:树边排序被证P-完全,MPC仍能并行
一个悬了35年、被写进P-完全性教科书的开放问题,被马里兰大学三人组终结了:树的边排序是P-完全,直径只有6的树也一样。更有意思的是,作者转头就在MPC模型里给出了并行算法。理论爱好者本周必读。
龙哥读论文
阅读 7
查看原文
原论文信息如下:
35年悬而未决的问题被解决:树边排序的并行复杂度
先把"树边排序"说清楚,因为它比名字听起来实在得多。给一棵图论意义上的树(连通、无环),给每条边分配一个正整数,这个数叫 rank,也就是等级。规则只有一条:任意两条 rank 相同的边,它们之间的路径上必须存在一条 rank 更高的边。在这个约束下,让用到的最大 rank 尽可能小,这个最小值记作 er(T),即这棵树的最优边排序数。
换个角度理解:两条同 rank 的边被更高 rank 的边隔开,说明它们在树上的位置互不干扰,谁先谁后都不影响对方。
这个问题有一长串等价身份:制造一件产品所需的最少装配阶段数(同一阶段里并行完成若干互不依赖的装配);层次聚类里高度最小的树状图(dendrogram);可逆推石子游戏(reversible pebble game)的步数;在树上用"边查询"做二分搜索定位目标元素时,最坏情况下所需的最少查询次数。并行数据库查询求值、分布式文件系统同步里都能看到它的影子。所以这不是一个纯粹的玩具问题。
串行侧的进展其实相当顺利。1991年,Iyer、Ratliff 和 Vijayan 给出了多项式时间的 2-近似算法,同时把"能否多项式时间精确求解"作为开放问题抛了出来——他们当时怀疑这个问题是 NP-难的。1993年,de la Torre、Greenlaw 和 Schäfer 给出了精确的多项式时间算法,把它放进了 P 类;之后 Lam 和 Yue 把复杂度压到了最优的线性时间与线性空间。
但并行侧卡住了。Iyer 等人那套 2-近似可以并行化到 O(log²n) 时间;de la Torre 等人的工作给出了 2^(O(Δ + log log n)) 时间的并行算法(Δ 是树的最大度),于是最大度为常数时问题落进了 NC,一般情况则一直悬着。Greenlaw、Hoover 和 Ruzzo 在 1995 年那本《Limits to Parallel Computation》(并行计算的极限)里,把树边排序列成了一个开放问题(Problem B.1.2,第 223 页)——这本书在 P-完全领域的地位,大致相当于 Garey & Johnson 之于 NP-完全。
这一挂就是三十多年。现在马里兰大学帕克分校的 Jef Giliberti、MohammadTaghi Hajiaghayi 和 Changki Yun 给出了答案,而且是否定性的答案。
 本文的结论是:给定一棵树 T 和整数 K ≥ 0,判定 T 是否存在最大 rank 不超过 K 的边排序,是对数空间归约下 P-完全的,而且即使把树的直径限制在 6 以内,结论依然成立。直径指树上最长简单路径包含的边数,直径 6 已经是相当"矮胖"的树了。这个限定恰好说明了困难性的来源:它不是"树太深、层级太多"造成的,而是结构本身决定的。
从NOR电路到树边排序:P-完全性证明的核心思路
要证明一个问题"和 P 里所有问题一样难",标准做法是从一个已知的 P-完全问题出发做归约。本文选的起点是 NOR 电路值问题(NOR Circuit Value Problem,NOR-CVP):给定一个由 NOR 门组成的布尔电路和一组输入,判断整个电路的输出是 0 还是 1。NOR 门就是"两输入取或非",两个输入全为 0 时输出 1,否则输出 0。它是最经典的 P-完全问题之一,原因也很直白:电路求值必须逐门进行,某个门的输出没算出来,下游的门就没法动,这种"不可跳跃的依赖链"正是串行性的典型来源。
本文的归约分两步走:NOR-CVP → GreedyAllocation → Tree-Edge-Ranking。中间那个 GreedyAllocation(贪心分配问题)是作者自己设计的"中转站",也是整条链里最巧的一环,留到下一节展开。这里先把两个前置概念铺好:可见 rank 和关键集。
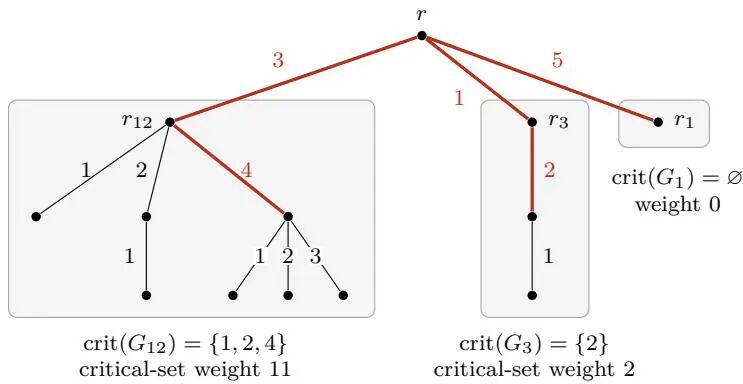
先给树指定一个根。如果一条边在它到根的路径上没有 rank 比它更高的边,就说这条边是可见的(visible),它携带的 rank 叫可见 rank。两条同 rank 的可见边会直接违反规则(它们之间没有更高的 rank),所以可见边的 rank 两两不同,构成一个集合,叫可见集。在所有合法边排序中,权重最小的那个可见集被称为这棵树的关键集,记作 crit(T)。集合的权重定义是:
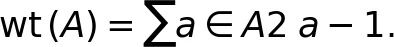 关键集有个非常好用的性质:er(T) ≤ K 当且仅当 crit(T) ⊆ [K],这里 [K] 表示集合 {1, 2, ..., K}。所以只要能把关键集算出来,最优边排序数一并到手,而且 er(T) 恰好等于 crit(T) 里的最大 rank。
接下来的问题就是关键集怎么在树上合并。设根节点 v 的孩子是 v₁ 到 v_d,每个分支 B_i 由边 vv_i 和子树 T_(v_i) 组成,边 vv_i 拿到的 rank 叫这个分支的标签(label)。假如子树 T_(v_i) 已经有了可见集 A_i,那么标签 c 对分支 i 可接受,当且仅当 c 不属于 A_i——否则边 vv_i 会和子树内部某条同 rank 的可见边撞上。此时分支 i 在 v 处贡献的可见 rank 是:
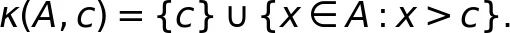 顺着这个思路,论文得到了一条看起来朴素、实际很关键的引理:把一个可见集 A 换成 κ(A,c) 之后,权重至少涨 1。
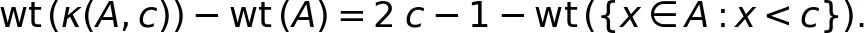 需求的数值可以是任意正整数,所以需要一种办法:对任意正整数 q,造出一个分支 B_q,关键集权重恰好是 q,而且分支本身不能太大。作者的做法是在同一个根上拼装星形结构,造出只有 O(log²q) 个顶点的分支 B_q,满足 wt(crit(B_q)) = q。这里的 O(·) 表示渐进上界,顶点数量随 log q 的平方增长,q 涨得再快,分支规模也不会失控。
 需求造好了,接下来要把它们串成能模拟布尔电路的装置。第一个难点是扇出:同一根线上的变量 b₁ 可能被下游好几个门用到,而在这套体系里需求一旦被分配就"减掉"了,残余量随之改变。所以要让信号既能传给下游、又能留一份给后面继续用,就得专门造一个中继器(relay)。
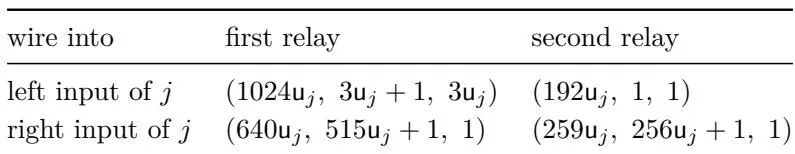
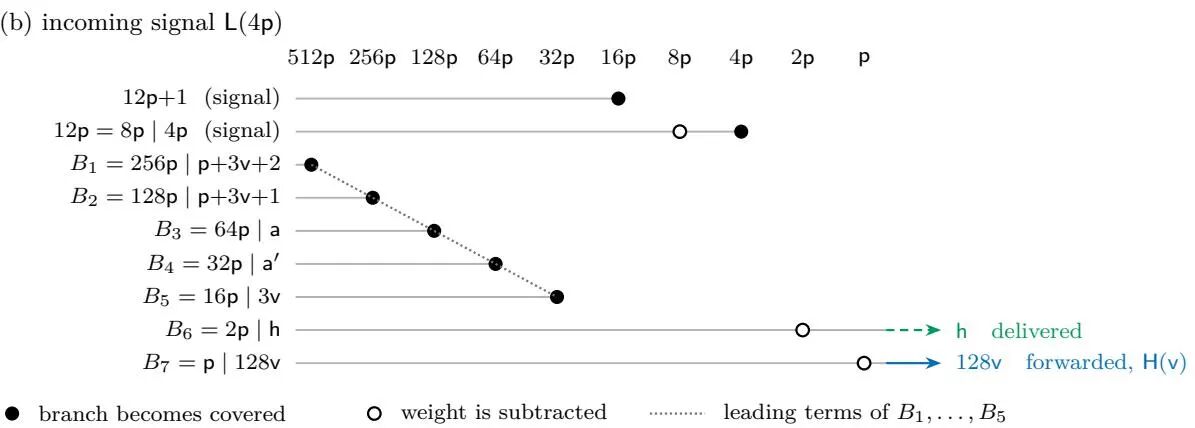
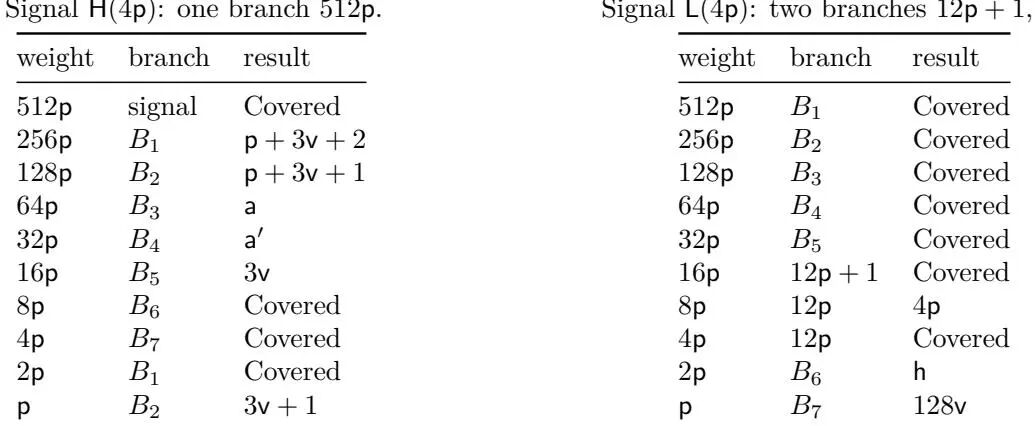
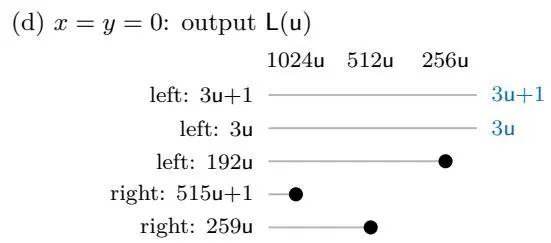
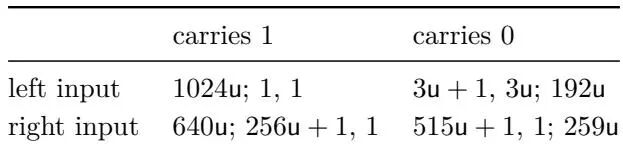
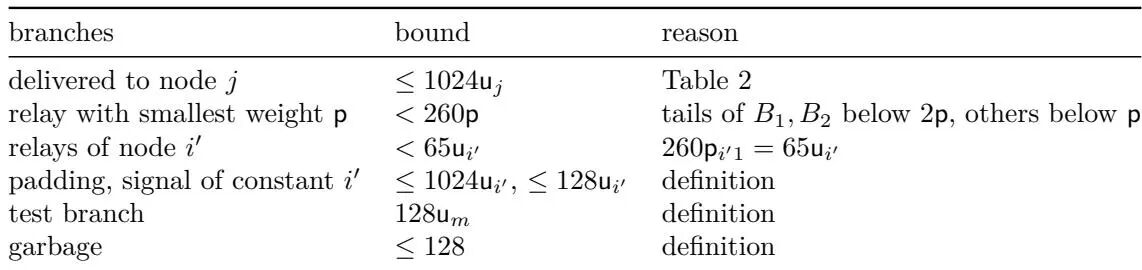
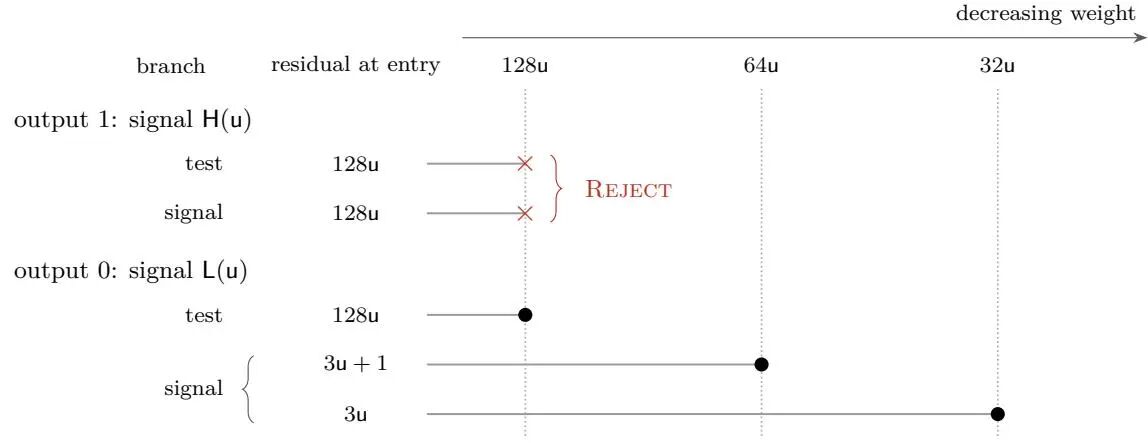 整条归约链的规模与电路是线性关系,并且可以在对数空间里构造出来。模拟过程中,贪心分配算法不会提前拒绝,唯一可能拒绝的地方就在输出测试那一步——而它拒绝,恰好对应电路的输出为 1。由于 NOR 电路必须逐门求值、不可跳跃,归约成立,树边排序的 P-完全性得证。
贪心分配算法:连接电路与树的桥梁
现在来看那个中转站。GreedyAllocation(贪心分配)问题的定义是:给定一组正整数需求 q₁ 到 q_d 和整数 K ≥ 1,问能不能把 [K] = {1, ..., K} 划分成 d 个集合 X₁ 到 X_d,使得
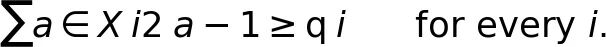 GreedyAllocation 有一个非常自然的顺序算法。让 e 从 K−1 递减到 0,每一步把权重 2^e 分给当前剩余需求最大的那个分支。有两种情况会直接拒绝:一是某个剩余需求已经不小于 2^(e+1),说明剩下的权重总和也喂不饱它;二是有两个需求都不小于 2^e,一个权重显然没法同时满足两个。如果只有一个需求不小于 2^e,就把它减去 2^e,剩下的部分留到后面继续分配;如果没有任何需求不小于 2^e,就让它"覆盖"掉一个较小的需求,被覆盖的分支不再考虑。论文证明了:这个贪心算法在且仅在 GreedyAllocation 可行时不会拒绝。
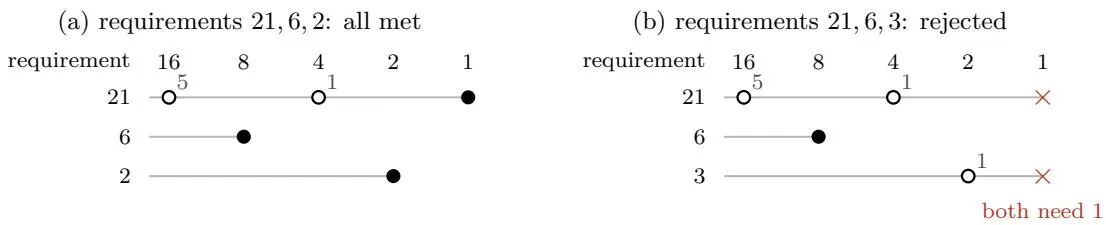 图 1(b) 那个例子值得多看两眼。它失败不是因为总量不够——30 明明小于 31。它失败在"分配粒度"上:最高位的权重不可分割,需求一旦在前面几步被劈成两个都只剩 1 的残渣,最后那个权重为 1 的 rank 就只能救一个。
为什么这个贪心过程天生串行?因为它是不可逆的。第 e 步怎么分配,决定了第 e−1 步看到的是什么样的残渣,而残渣一旦产生就回不去了;每一步还要看"当前最大的剩余需求是谁"这种全局信息。作者正是把这种逐位下沉的过程,一步步对应到 NOR 电路的逐门求值:每个布尔输入用一组固定模式的需求编码,剩余需求的演化代表电路中信号值的演化,最后由输出测试装置检查结果并决定是否拒绝。
🤔 这套"把布尔值编码成一堆 2 的幂之和"的手法,乍看很土,细想很妙。
突破P-完全性障碍:MPC模型下的高效并行算法
P-完全这个结论字面意思是:在 PRAM 这类细粒度共享内存并行模型里,"多对数时间 + 多项式处理器"的算法基本没戏。但它不等于"这个问题一点并行度都榨不出来"。原因在于 P-完全的定义和归约都是围绕细粒度并行建立的:基于电路的 P-完全归约既不排除多对数时间的 MPC 算法,也不自动给出 MPC 算法,在 P-完全归约下等价的两个问题,未必落在同一个 MPC 难度档位上。论文里也点明,据作者所知,此前只有 Dhulipala 等人在批次动态连通性上的工作属于"P-完全但能在 MPC 里高效求解"的实例,而且那个工作里批次大小还被机器本地内存卡着。
MPC(Massively Parallel Computation,大规模并行计算)是当今大规模并行的标准抽象,MapReduce、Spark、Dryad 这些框架都在它的覆盖范围内。它的设定是:N 个字的输入平均分到 M 台机器上,每台机器本地内存 O(S),总内存 M·S = Õ(N);计算按同步轮推进,每轮各机器做本地计算并收发数据,单台机器每轮收发的总量不超过 O(S) 个字;本地计算不计入复杂度,目标是最小化轮数。关键词是"强次线性本地内存":S 远小于 N,任何一台机器都看不到完整的图,全局决策只能靠有限的本地信息一点点拼出来。
论文定理 1.2 给出了四种参数组合。一棵 n 个顶点、直径 D 的树,其最优边排序可以在 MPC 里用 O(n) 总内存确定性地算出来:
方案 (a):本地内存 O(n^(3/4)·D^(1/4)),轮数 O(log D + log log n)。
方案 (b):本地内存 O(n^(3/4+δ)·D^(1/4)),轮数 O(log D),δ 是任意固定的正数。
方案 (c):本地内存 O(n^(3/4)),轮数 O(D)。
方案 (d):本地内存 O(S),轮数 O(n/S + log n),其中 n^(3/4) ≤ S ≤ n。
其中最值得拎出来说的是直径常数时的情形:本地内存只要 O(n^(3/4)),轮数是常数。而按定理 1.1,这恰恰已经是被证明 P-完全的那批实例。同一个问题,在细粒度并行模型里被判"天生串行",在粗粒度并行模型里却几轮就能算完。
 这套并行算法的骨架,是 Lam 和 Yue 那套线性时间顺序算法的并行化。顺序算法的核心动作是自底向上反复计算:父节点的关键集由所有子节点的关键集合并而来。本文把重点放在单次合并(论文里叫 Labeling,标签化)上,要求它能在次线性本地内存、极少轮数内完成;把各层结果拼回完整的边排序则主要是记账工作。
听起来简单,但有两个坎。第一个坎是内存:一个 s 个顶点的子树,关键集如果照原样存下来要 Θ(s) 个字,对次线性本地内存来说太大;即使按 Lam 和 Yue 的结论存成 O(√s) 段连续区间,也仍然不够,因为父节点要把所有孩子的表示拼在一起,合起来可能又变回线性规模。第二个坎是轮数:就算每次合并都塞得进本地内存,逐层往上也要 O(D) 轮,树一深就废了。
压缩关键集:强次线性内存下的树边排序
先解第一个坎,思路是"每个最大值规则只留一个代表"。假如若干子节点的关键集共享同一个最大 rank u,父节点不需要把它们的完整表示都存下来,只要保留其中字典序最小的那一个的精确表示,其余的只留计数就够了。论文的推论 4.2 保证了这些被摘要掉的子节点最终会拿到比 u 更高的 rank,所以它们原先可见的 rank 具体是什么,并不影响最终结果。这样压下来,需要保留的集合总共只占 O(n^(3/4)) 个字,整条 Labeling 流程都在这个压缩表示上跑,工作空间也控制在同一量级。
轮数的解法是批量处理。考虑一个有 N 个顶点的子树,还有 k 个顶点没处理完。挂在某个待处理顶点 v 上、已经算好的子子树一共包含 N_v 个顶点,按上面的压缩方式,v 处只占 O(N_v^(3/4)) 个字。这些子子树在剩余顶点之间两两不交,所以 Σ N_v ≤ N,于是它们的压缩集合总共占
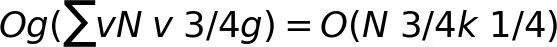 接下来是自举。假设大小不超过 B 的极大子树已经全部解出。剩下的每个顶点都根着一棵大于 B 的子树,于是每一层上这类顶点不超过 N/B 个,k = O(ND/B),完成一棵 N 顶点的子树只需要 O(N·(D/B)^(1/4)) 的本地空间。给每台机器固定 O(S) 的内存预算,第一阶段先解所有大小不超过 S 的极大子树;一旦规模不超过 B 的子树解完,同样的内存就够处理下一阶段大小为 S·(B/D)^(1/4) 的子树。取 S = n^(3/4+δ)·D^(1/4) 且 B ≤ n,下一阶段的规模上界是
 把两个定理摆在一起:树边排序在 PRAM 这类细粒度并行下是 P-完全的,在 MPC 里却能用多对数轮数乃至常数轮解决。作者认为,这进一步强化了 NC 与"MPC 里能高效算出"这两件事之间的严格分离——P-完全归约刻画的那种困难性,在粗粒度并行模型下并不必然成立。换句话说,"P-完全"这个标签并不等于"工程上没法并行加速",它只是特定模型下的一纸判决。
龙迷三问
这篇论文到底在解决什么问题?树边排序的并行复杂度悬置35年后被解决。马里兰大学证明它是P-完全,直径仅6的树也一样;却又给出对数轮MPC算法,用关键集压缩绕开线性内存壁垒。
这篇工作最值得看的点是什么?本文为理论性论文,主要贡献为证明树边排序问题是P-完全的,并给出MPC模型下的高效算法。定理1.1证明了即使对于直径不超过6的树,判定其边排序是否至多为K是P-完全的。定理1.2给出了在MPC模型下使用O(n)总内存的确定性算法,可在O(log D + log log n)轮内计算出n个顶点、直径为D的树的最优边排序,本地内存为O(n^{3/4}D^{1/4})。
这篇工作的边界或风险在哪里?优点:(1)解决了一个长达35年的公开问题,证明了树边排序问题是P-完全的;(2)证明了P-完全性障碍可以在MPC模型下被绕过,给出了高效的MPC算法;(3)归约构造精巧,通过GreedyAllocation中间问题将NOR-CVP归约到树边排序;(4)MPC算法通过压缩关键集表示和批量处理技术实现了强次线性本地内存。缺点:(1)MPC算法的时间复杂度中包含O(log D)项,对于大直径树可能不够高效;(2)压缩表示虽然有效但增加了算法的复杂性;(3)论文主要关注理论结果,缺乏实际实现和实验验证。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~
龙哥点评
论文创新性分数:★★★★☆
本文证明了树的边排序问题是P-完全的(即使对于直径不超过6的树),并通过从NOR电路值问题的归约来证明;同时提出了一个在MPC模型下使用强次线性本地内存的确定性算法,在O(log D + log log n)轮内计算出最优边排序,从而绕过了。
实验合理度:★★★☆☆
现有材料未完整覆盖数据划分、基线公平性和统计显著性,因此按中性评价处理。
学术研究价值:★★★★☆
本文证明了树的边排序问题是P-完全的(即使对于直径不超过6的树),并通过从NOR电路值问题的归约来证明;
稳定性:★★★☆☆
现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。
适应性以及泛化能力:★★★☆☆
现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。
硬件需求及成本:★★★☆☆
现有材料缺少完整训练资源、参数量、显存和推理时延信息,成本暂按中性评价。
复现难度:★★★☆☆
现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。
产品化成熟度:★★★☆☆
论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。
可能的问题:,证明了树边排序问题是P-完全的;(2)证明了P-完全性障碍可以在MPC模型下被绕过,给出了高效的MPC算法;(3)归约构造精巧,通过GreedyAllocation中间问题将NOR-CVP归约到树边排序;(4)MPC算法通过压缩关键集表示和批量处理技术实现了强次线性本地内存。
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!

还没有公开留言,欢迎留下你的看法。