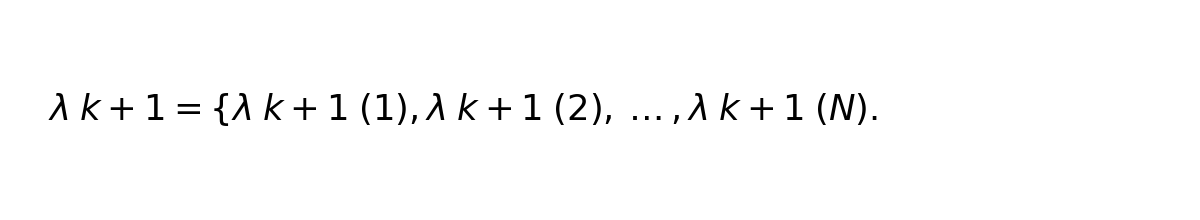← 返回 PaperDaily 视觉与图像

庆北国立大学:让LLM当损失调音师,图像恢复PSNR最高涨3.35

调损失权重这件事,以往基本靠炼丹手感和几轮消融碰运气。这篇论文干脆把LLM塞进训练循环:每隔一段拿固定小样本跑一遍质量指标,让它的下一段训练自己决定该更看重保真,还是更好看。改的全是现成损失项,网络结构、优化器、数据管线、推理流程一个没动,训练额外开销不到0.2%,推理零成本。三个恢复任务、七个基准,都挪到了更划算的平衡点上。🤨

庆北国立大学:让LLM当损失调音师,图像恢复PSNR最高涨3.35
原论文信息如下:
论文标题:
DLC: Dynamic Loss Controller for Multi-Objective Image Restoration
发表日期:
2026年10月
发表单位:
庆北国立大学 数据科学融合专业(韩国大邱)
原文链接:
https://arxiv.org/pdf/2610.11433v1.pdf

图像恢复的"不可能三角":保真度与感知质量如何兼得
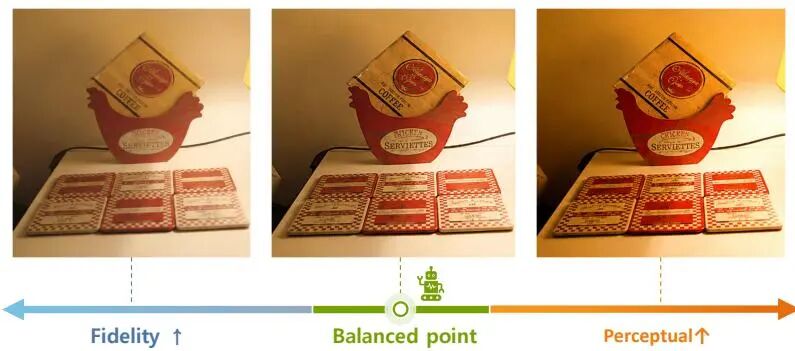
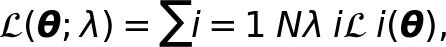
图像恢复任务希望在增强图像质量的同时保留真实细节。低光照增强、去雨、超分辨率等任务都要求去除退化信号,恢复内容。
恢复质量没有唯一答案,保真与感知质量常常互相矛盾。保真的解通常偏保守,而感知上更讨喜的解可能引入伪影。
论文中的概念图展示了这种权衡。
Fig. 1
图像恢复中保真度与感知质量之间的权衡示意。DLC 通过指标引导的损失重加权,推动训练达到更均衡的工作点。
现代恢复模型通过加权损失项训练,常用线性组合:
损失加权组合公式
图2-公式1:总损失的定义。θ 代表恢复模型的参数,Li(θ) 是第 i 个损失项,λi 是权重。整套权重在训练开始前就定好,然后一路固定到收敛。
这种做法默认同一组权重在整个优化过程中都合适,但恢复质量是多目标的,评测指标也不止一个。PSNR 和 SSIM 衡量像素保真与结构一致;LPIPS 和 DISTS 估计感知相似度;NIQE、BRISQUE、CLIP-IQA、MUSIQ、MANIQA 估计观感;FID 衡量分布层面的真实感。
这些指标并不总是一致。PSNR 上升可能导致输出更平滑;感知质量提升可能降低像素级保真。训练时用损失下降调权重,但评测时用的是异质指标的混合体。
动态损失加权是老题目。GradNorm 用梯度范数做平衡,Uncertainty Weighting 用任务不确定性推导权重,CoV Weighting 用变异系数作信号。这些方法调整信号来自训练内部,而恢复任务的指标很多不可微、数值不稳定,不能直接当损失项去反传。
大语言模型最近也开始被用作优化器。OPRO 把优化过程写成提示,AgentHPO 自动化超参搜索,TextGrad 用文本反馈作为复合 AI 系统的"梯度"。这些工作说明 LLM 可以承担决策角色。
庆北国立大学的论文把这两条线结合:评测用异质指标作为训练期反馈信号,让 LLM 决定损失权重的调整。方法叫 DLC,全称 Dynamic Loss Controller,中文含义是动态损失控制器。621df26778f05KkH.gif

DLC核心机制:让LLM当"调参大师"动态调整损失权重

DLC 的思路是:不动网络、不动损失项、不动优化器,只动损失权重,由质量指标反馈决定。
训练过程被切成等长区间,区间长度为 T。在第 k 个区间里,模型用当前权重 λk 做常规梯度更新,权重保持不动;到区间边界时重新计算权重。
判断依据来自训练集的固定反馈子集,实验中为 10 张训练样本。每到干预步,用子集评估当前模型输出,计算质量指标。固定样本使指标变化更能反映模型变化,而不是数据波动。子集只用于训练期反馈,最终成绩在标准测试集报告。
Fig. 2
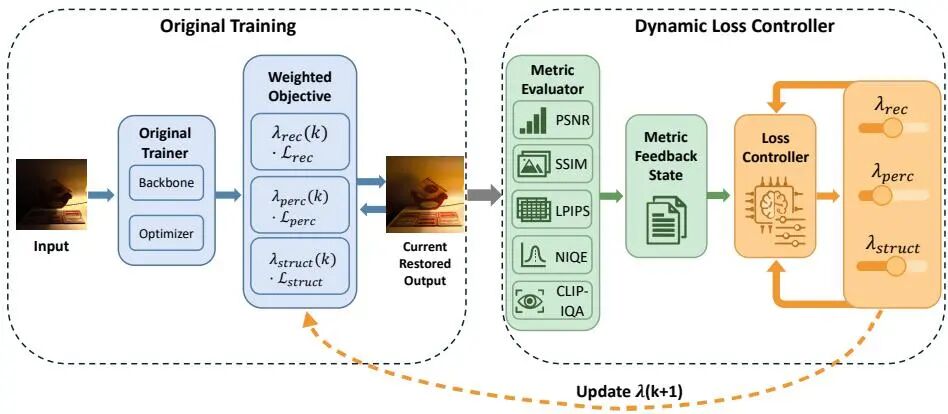
图2:DLC 整体流程。在第 k 个干预步,当前恢复结果被任务相关指标评估,构造出一个反馈状态;损失控制器据此产生下一个训练区间要用的损失权重向量 λk+1。
控制器的输入是结构化的"体检报告",包含每个指标当前数值、方向标记、最近变化量、当前损失权重、可调整损失项清单。指标方向是关键:PSNR、SSIM、CLIP-IQA、MUSIQ、MANIQA 越大越好,LPIPS、DISTS、NIQE、BRISQUE、FID 越小越好。方向保留使控制器能判断变化是进步还是退步。
控制器输出是数值字典:
权重向量输出公式
图3-公式2:控制器输出的下一个区间的损失权重向量。训练循环只使用这些数值;控制器可能同时给出一段简短文字说明,但那段说明只用于日志和分析,不参与优化。
DLC 没有把质量指标变成可微损失去反传。原因是很多恢复指标不可微,直接当目标训练时不稳定。指标作为不可微反馈信号,用来挑选权重;梯度下降用原管线的可微损失。
整套训练流程用伪代码写出来并不长:
    算法1:DLC 训练流程
    输入:恢复模型 f(θ)、训练集、固定反馈子集、初始权重 λ0、干预区间 T
    1. 初始化干预序号 k ← 0
    2. 当训练预算未耗尽时循环:
    3.   用 λk 训练模型一个区间
    4.   在固定反馈子集上评估当前检查点
    5.   计算反馈指标 mk
    6.   构造反馈状态 sk = (mk, Δmk, λk, 历史 Hk)
    7.   把 sk 提交给 LLM 控制器
    8.   解析输出,得到下一组权重 λk+1
    9.   k ← k + 1
    10. 循环结束,输出训练好的恢复模型
    LLM 角色被压得很窄。它不生成图像、不设计结构,只负责把结构化指标摘要映射成损失权重。论文用 LLaMA-3 8B,提示模板、解码参数和输出格式都固定,优化过程依赖结构化数值输出。
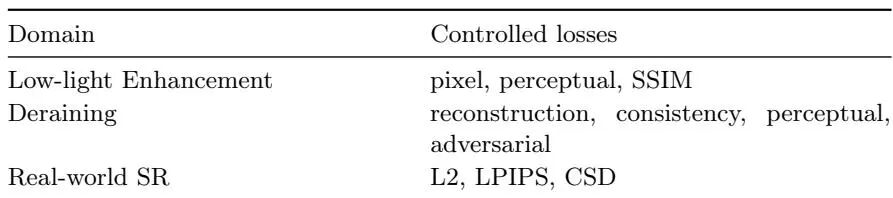
    每个任务具体调哪些损失,论文沿用各自基线的损失空间。下表给出三个域的受控损失项。
    Table 1
    表1:不同恢复域的 DLC 实例化方式。低光照增强调节像素、感知、SSIM 三类损失;去雨调节重建、一致性、感知、对抗相关损失;真实世界超分调节 L2、LPIPS 与 CSD 三类目标。所有受控损失都继承自对应基线,不是为 DLC 新设计的,因此比较的是权重决策策略本身的效果差异。
    真实世界超分里的 CSD 这一项,论文没有重新定义,它属于对应超分基线原有的损失体系,与 L2、LPIPS 并列作为可调节目标之一。方法的关键点不在于这些损失长什么样,而在于同一套"反馈—决策"的形式,可以在架构、监督方式、损失设计都不同的三条管线上复用。

    三大恢复任务实测:低光照、去雨、超分全面验证


    实验设置与数据准备

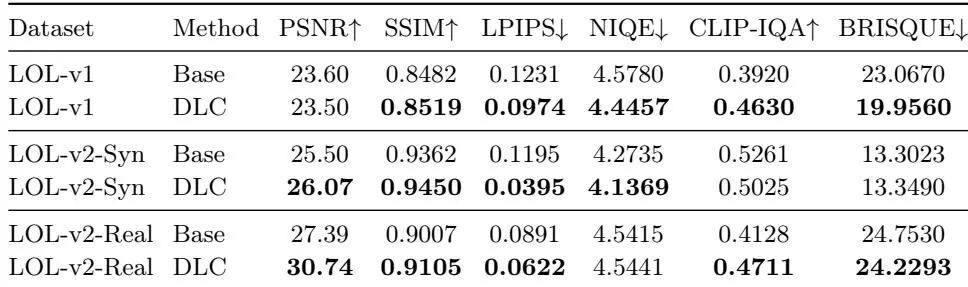
    论文选了三类恢复任务、共七个基准设置。低光照图像增强在 LOL-v1、LOL-v2-Syn、LOL-v2-Real 上评测;去雨在 Rain100L 和 RealRain1K-H 上评测;真实世界超分在 DRealSR 和 RealSR 上评测。
    对照设置是比较干净的那种:每个域的基线就是对应原管线用固定权重训练出来的结果。DLC 与基线共用同一套骨干网络、同一批训练数据、同一个优化器、同一组损失项和同样的训练预算,唯一被替换的是"损失权重怎么决定"这条策略。这样做的意义在于,任何指标差异都不能归因到网络容量或数据量上,只能归因到权重决策。
    反馈子集统一为 10 张训练样本,每个干预步都评估同一批。指标口径方面,低光照和去雨报告 PSNR、SSIM、LPIPS、NIQE、CLIP-IQA 和 BRISQUE;真实世界超分按该领域更宽的评测协议报告 PSNR、SSIM、LPIPS、DISTS、CLIP-IQA、NIQE、MUSIQ、MANIQA 和 FID。只有在该指标方向上确实优于基线的结果,才会被加粗标记。

    实验结果分析

    恢复模型的训练是一个长周期过程,早期模型对细节几乎没有建模能力,此时把感知权重拉得很高,梯度会去追一些根本不存在的纹理;到了中后期,模型已经能重建主体结构,这时候适度加大感知和对抗项的权重,才更可能换来真实的纹理收益。固定权重等于把这条时间线上的所有阶段按同一个口味处理,而 DLC 允许权重随阶段漂移,这正是它最朴素的合理性来源。
    第二个合理性来自反馈信号的类型。GradNorm、不确定性加权这些方法看的是损失和梯度,它们知道模型"在哪里挣扎",但不知道模型"看起来怎么样"。DLC 直接去测 PSNR、LPIPS、NIQE,看的是结果,更贴近论文表格里真正被打分的那些量。这就是它和传统动态加权方法的分水岭。
    但也要把话说在前头:这套机制不承诺"所有指标一起涨"。指标之间本来就互相拉扯,权重只能在这一组原损失的可达空间内挪动操作点,不能凭空造出更强的表达能力。如果骨干网络的表示能力上限就摆在那儿,再聪明的控制器也只是把操作点挪到更划算的位置,而不是把天花板抬高。论文本身的表述也比较克制,用的是"引导训练走向更有利的工作点",而不是"全面提升"。
    对比公平性方面,与固定权重基线的比较是最扎实的一档,因为一切条件都被钉死,只剩策略差异。与 GradNorm、Uncertainty Weighting、CoV Weighting 的比较也控制了骨干、数据、损失和预算,不过这些方法原本是为多任务学习设计的,用来处理图像恢复的异质指标时未必处在最舒服的状态,解读时值得留意这一层。
    还有一个容易被忽略的细节:反馈子集只有 10 张图。样本量小意味着反馈指标本身带噪,控制器必须在噪声里判断趋势,所以论文把"最近几次的变化量"和"权重历史"一起喂进去,用趋势而不是单点值来降低误判概率。这也解释了为什么权重更新的节奏是稀疏的,而不是每一步都动。

    实验结果

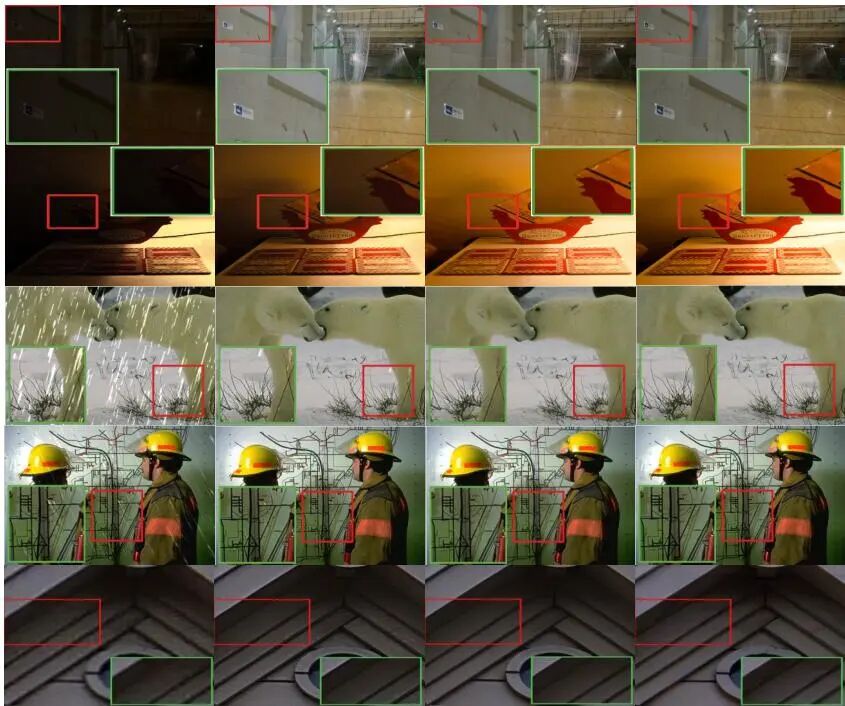
    先看视觉效果。论文在同一骨干下,把固定损失基线(Base)和 DLC 的输出并排放在一起,并对局部纹理、结构做了放大对比。
    Fig. 3
    图3:固定损失基线与 DLC 在多个恢复域上的定性对比。放大区域用来突出纹理、结构与感知层面的差异。可以看到 DLC 在部分局部区域给出了更清晰的结构或更讨喜的细节,但改善并非全域一致,这与指标层面的取舍是对应的。
    低光照增强的结果见表2。
    Table 2
    表2:低光照图像增强结果。在 LOL-v1 上,DLC 把感知和无参考指标基本都推上去了,LPIPS 从 0.1231 降到 0.0974,CLIP-IQA 从 0.3920 升到 0.4630,BRISQUE 从 23.0670 降到 19.9560,代价是 PSNR 小幅下滑 0.10。在 LOL-v2-Syn 上,保真与感知同时改善:PSNR 25.50 升到 26.07,SSIM 0.9362 升到 0.9450,LPIPS 从 0.1195 大幅降到 0.0395。最显眼的是 LOL-v2-Real,PSNR 从 27.39 抬到 30.74,SSIM 与 LPIPS 也同步变好,说明在真实退化数据上,指标引导的重加权确实找到了一个更划算的操作点。
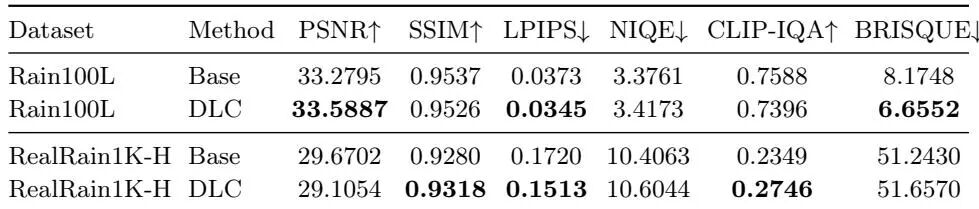
    去雨结果见表3。
    Table 3
    表3:去雨结果。在 Rain100L 上,PSNR 从 33.2795 升到 33.5887,LPIPS 从 0.0373 降到 0.0345,BRISQUE 从 8.1748 降到 6.6552,重建精度和感知质量都有收益。在 RealRain1K-H 上,SSIM 从 0.9280 升到 0.9318、LPIPS 从 0.1720 降到 0.1513、CLIP-IQA 从 0.2349 升到 0.2746,但 PSNR 和一些无参考指标反而下降。这张表最有信息量的地方恰恰是这种不一致:它说明 DLC 不是死盯某一个指标优化,而是随数据集和反馈信号把模型推向不同的操作点。
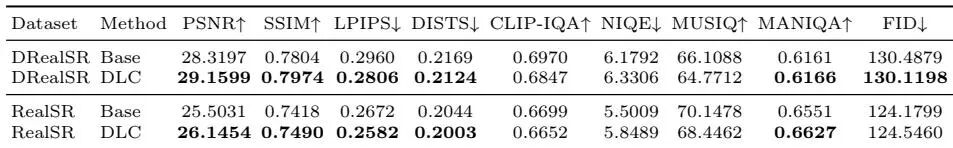
    真实世界超分结果见表4。
    Table 4
    表4:真实世界超分结果。在 DRealSR 和 RealSR 上,PSNR、SSIM、LPIPS、DISTS 四项一致变好:DRealSR 的 PSNR 从 28.3197 升到 29.1599,SSIM 从 0.7804 升到 0.7974,LPIPS 从 0.2960 降到 0.2806,DISTS 从 0.2169 降到 0.2124;RealSR 的 PSNR 从 25.5031 升到 26.1454。MANIQA 在两个数据集上都有提升,DRealSR 的 FID 也从 130.4879 略微降到 130.1198。与此同时,CLIP-IQA、NIQE、MUSIQ 出现了反向变化,说明这里发生的是重建—感知平衡点的移动,而不是所有指标齐刷刷向好。

    损失权重策略大比拼:DLC vs 固定权重 vs 自适应方法

    为了把"损失权重策略"这个变量的影响单独拎出来,论文在 LOL-v1 上做了一组对照:固定权重(固定权重这一版直接采用 DLC 训练结束时的那组权重,从零开始独立训一遍)、基于人工规则的趋势启发式、GradNorm、不确定性加权、CoV 加权,以及 DLC。所有方法共用骨干、数据、损失项、优化器和训练预算。
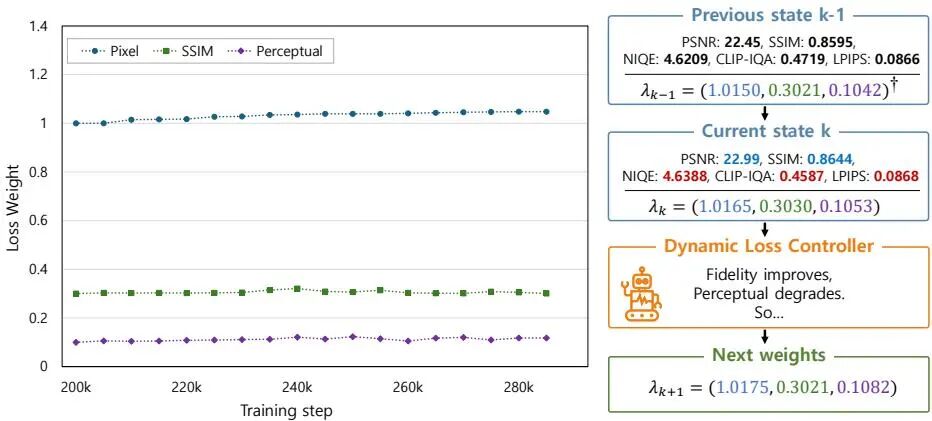
    先看权重随时间是怎么走的,以及控制器在某一次干预步上做了什么判断。
    Fig. 5
    图5:LOL-v1 上的损失权重轨迹与一次控制器决策示例。左图展示像素、SSIM、感知三类损失权重随干预步的变化轨迹,可以看到像素与感知权重逐步上升,结构权重相对稳定,说明 DLC 主要在调整重建与感知之间的平衡;右图给出一次具体决策:当保真类指标改善但感知或无参考反馈变差时,控制器会为下一个区间提高感知权重。图中权重向量的顺序为(像素、SSIM、感知)。
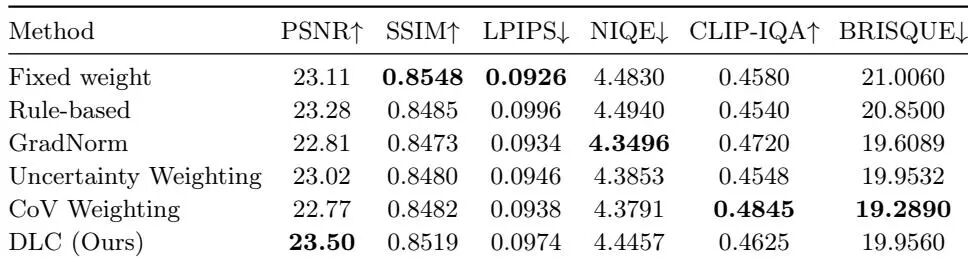
    不同策略最终落到的操作点并不相同,见表5。
    Table 5
    表5:LOL-v1 上不同损失加权策略的对比。所有方法共享骨干、数据、损失组件、优化器与训练预算,仅权重决策策略不同,每个指标的最优值加粗。DLC 拿到最高 PSNR 23.50,SSIM 0.8519 也保持竞争力;但在 LPIPS、NIQE、CLIP-IQA、BRISQUE 上,GradNorm 或 CoV 加权等方案表现更好。例如 CoV 加权的 CLIP-IQA 达到 0.4845,GradNorm 的 NIQE 低至 4.3496。这说明最终操作点取决于反馈信号和更新策略,而不只是"用了自适应加权"这一个事实。
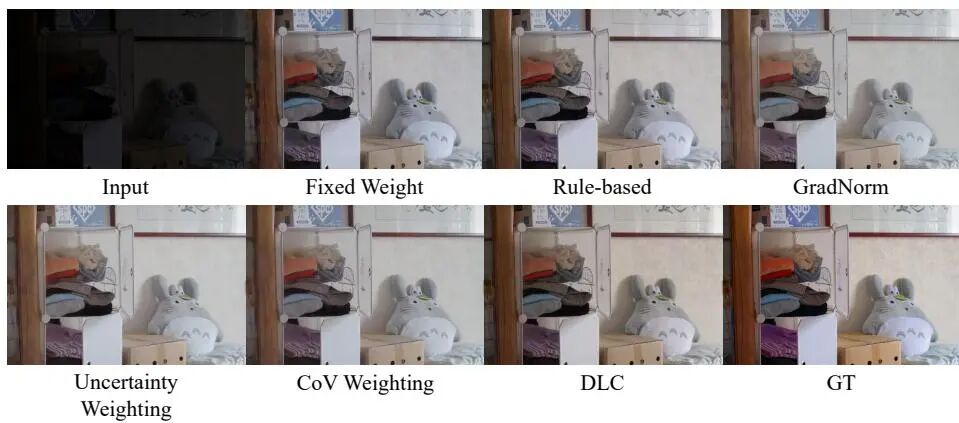
    定性对比同样能看出这些策略带来的视觉差异。
    Fig. 4
    图4:LOL-v1 上各种损失加权策略的定性对比。固定权重、规则式和自适应加权给出了不同的视觉特征。这张图的价值不在于选出谁最漂亮,而在于说明"权重策略"这个看似不起眼的开关,确实会改变最终画面的性格。
    还有一个值得琢磨的对照:固定权重那一版用的就是 DLC 训练结束时的那组权重,独立重训之后,PSNR 只有 23.11,低于 DLC 的 23.50。同样的终点权重,一路固定用下来和一路动态走下来,结果不一样。这从侧面说明收益来源不是那组权重本身多神,而是"什么时候用什么权重"这件事有价值。

    LLM控制器选型与训练开销分析

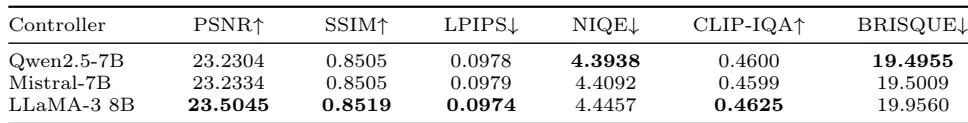
    一个自然会冒出来的疑问是:换一个 LLM 当控制器,结果会不会天差地别?论文用 Qwen2.5-7B、Mistral-7B 和 LLaMA-3 8B 在同一套 DLC 设置下做了对比。
    Table 6
    表6:控制器 LLM 的敏感性实验(LOL-v1)。三个控制器的表现比较接近:Qwen2.5-7B 的 PSNR 为 23.2304,Mistral-7B 为 23.2334,LLaMA-3 8B 为 23.5045,SSIM、LPIPS、NIQE、CLIP-IQA、BRISQUE 的差距也都在很小的范围内。这说明方法并不绑定某个特定的 LLM 骨干,控制器在这里承担的是"读懂结构化指标、给出合理权重"的操作性角色。
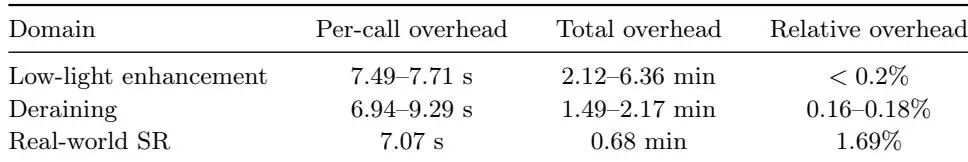
    接下来是工程同学最关心的部分:这玩意儿到底要花多少算力。答案挺让人放心——开销只在训练期产生,来源是周期性在反馈子集上评测加一次控制器推理。
    Table 7
    表7:DLC 的训练期额外开销(代表性运行结果)。低光照增强每次干预约 7.49 至 7.71 秒,总开销 2.12 至 6.36 分钟,相对开销低于 0.2%;去雨每次约 6.94 至 9.29 秒,总开销 1.49 至 2.17 分钟,相对开销 0.16% 至 0.18%;真实世界超分每次约 7.07 秒,总开销 0.68 分钟,相对开销 1.69%。虽然超分这一档的相对开销偏高,但它同样只发生在训练阶段。
    更关键的一句结论是:DLC 没有往恢复网络里加任何模块,也不改变推理管线。因此训练结束后的模型,参数规模与基线一致,测试阶段的时间成本也一致。对于真正要上线的场景,这一点的分量比训练期那几分钟大得多。

    总结与展望:即插即用损失控制器的未来方向

    把这篇论文的价值压缩成一句话:它把"损失权重怎么设"这件事,从一个凭经验的静态超参,改造成了一个带质量反馈的在线决策问题,并且用了一种架构无关、损失项无关的方式实现。
    它的边界也很清楚。反馈子集只有 10 张图,在更小或更特殊的数据集上,这个子集是否足够代表整体分布,需要额外验证;控制器输出的是连续权重,一旦解析出异常数值,训练会不会跑偏,论文用固定输出格式和数值解析来缓解,但没有给出形式化的收敛保证;当可调损失项变多、指标变多时,反馈状态会变长、噪声也会累积,控制器在更高维空间里的判断质量还有待观察。此外,多目标优化里"哪个操作点最好"本来就是个带主观性的问题,DLC 把它交给了任务指令和指标方向的定义,这部分仍然是人工设定的。
    往前看,这条路有几条可以走。一是把反馈做得更稳,比如用子集采样、置信区间或者多次评估来压低噪声;二是把控制粒度做细,从"整组权重"扩展到分组、分层甚至逐损失项的调度;三是把这套闭环接到别的多目标训练场景上,比如生成模型的多样性—保真权衡、检测模型的速度—精度权衡。只要一个任务存在"多个异质指标互相拉扯、训练信号又拿不到这些指标"的结构,这个模式就有发挥空间。meng.jpeg

    龙迷三问

    下面是龙哥对于大家可能的一些问题的解答:
    这篇论文到底在解决什么问题?庆北国立大学提出DLC,不改网络结构、不新增损失项,只让LLM根据图像质量指标反馈动态调整已有损失权重。低光增强、去雨、真实超分三大任务七项基准验证:训练期插上这个控制器,推理零额外开销。
    这篇工作最值得看的点是什么?在低光照增强中,DLC在LOL-v1上提升多数感知和无参考指标,PSNR仅微降;在LOL-v2-Syn上提升PSNR、SSIM、LPIPS和NIQE;在LOL-v2-Real上PSNR从27.39大幅提升至30.74。在去雨中,Rain100L上提升PSNR、LPIPS和BRISQUE;RealRain1K-H上提升SSIM、LPIPS和CLIP-IQA。
    这篇工作的边界或风险在哪里?优点:1)即插即用,不修改模型架构和损失项,适用于多种恢复任务;2)利用LLM处理异构质量指标反馈,避免手工设计权重更新规则;3)训练时开销小,测试时无额外成本;4)在多个领域和基准上验证了有效性。缺点:1)并非所有指标一致提升,存在明显的指标间权衡;2)反馈子集选择和干预频率等超参数缺乏系统分析;3)LLM控制器推理增加训练时间,且依赖外部LLM;4)在部分数据集上提升幅度有限,方法效果存在数据集依赖性。
    如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

    龙哥点评

    论文创新性分数:★★★★☆

    提出DLC(动态损失控制器),在不修改模型架构和损失项的前提下,利用LLM作为控制器,根据固定反馈子集上的多维度质量指标反馈,动态调整已有损失项的权重,从而引导多目标图像恢复训练走向更优的保真度-感知质量平衡点。

    实验合理度:★★★★☆

    低光照增强和去雨:PSNR、SSIM、LPIPS、NIQE、CLIP-IQA、BRISQUE;真实世界超分辨率:PSNR、SSIM、LPIPS、DISTS、CLIP-IQA、NIQE、MUSIQ、MANIQA、FID。

    学术研究价值:★★★★☆

    提出DLC(动态损失控制器),在不修改模型架构和损失项的前提下,利用LLM作为控制器,根据固定反馈子集上的多维度质量指标反馈,动态调整已有损失项的权重,从而引导多目标图像恢复训练走向更优的保真度-感知。

    稳定性:★★★☆☆

    现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

    适应性以及泛化能力:★★★☆☆

    现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

    硬件需求及成本:★★★☆☆

    DLC仅在训练时引入额外开销:低光照增强每次干预约7.49-7.71秒,总开销2.12-6.36分钟,相对开销<0.2%;去雨每次干预约6.94-9.29秒,总开销1.49-2.17分钟,相对开销0.16-0.18%;

    复现难度:★★★☆☆

    现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

    产品化成熟度:★★★☆☆

    论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

    可能的问题:1)并非所有指标一致提升,存在明显的指标间权衡;2)反馈子集选择和干预频率等超参数缺乏系统分析;3)LLM控制器推理增加训练时间,且依赖外部LLM;

    主要参考文献

    [1] Jaewan Ko, Janghoon Choi. DLC: Dynamic Loss Controller for Multi-Objective Image Restoration. arXiv:2610.11433. https://arxiv.org/pdf/2610.11433v1.pdf
    [2] Chen et al. GradNorm: Gradient Normalization for Adaptive Loss Balancing in Deep Multitask Networks. ICML 2018. arXiv:1711.02257
    [3] Kendall et al. Multi-Task Learning Using Uncertainty to Weigh Losses for Scene Geometry and Semantics. CVPR 2018. arXiv:1705.07115
    [4] Yang et al. Large Language Models as Optimizers (OPRO). arXiv:2309.03409
    [5] Yuksekgonul et al. TextGrad: Automatic "Differentiation" via Text. arXiv:2406.07496
    [6] Zhang et al. The Unreasonable Effectiveness of Deep Features as a Perceptual Metric (LPIPS). CVPR 2018. arXiv:1801.03924

    *本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

    转发文章 微博 X LinkedIn Facebook

    读者留言

    可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

    0 条已公开

    还没有公开留言,欢迎留下你的看法。

    游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
    同一访问者每天最多提交 5 条。
    龙哥读论文 · PaperDaily

    本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

    LONGGE AI COMMUNITY

    把每天读到的论文,变成长期积累

    加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

    加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

    龙哥读论文知识星球二维码 微信扫码加入知识星球