← 返回 PaperDaily
大模型与智能体
中科院计算所提出ChemDiffAgent:8B化学智能体反超GPT-5.5
化学智能体这几年做得不少,但几乎都押在自回归这条路上:一个token一个token从左往右吐,工具名、参数、SMILES谁先谁后,全被钉死。这篇论文干脆把化学推理整体改成掩码扩散的迭代去噪,让工具名、参数和推理过程在同一个块里一起收敛。结果是一个8B模型六类化学任务总分91.8%,反超GPT-5.5,还直接开源了。
龙哥读论文
发布于 2026-10-18 01:22:03
阅读 11
查看原文
原论文信息如下:
化学任务有个天然的麻烦:光靠模型脑子里的参数化知识,根本答不完。你得调用分子性质预测器算一个脂水分配系数,调用反应引擎查一条可行的合成路线,再用化学信息学库验证结构是否合法。这套"内部推理与外部工具交替进行"的过程,论文给了个正式名字——工具集成的化学推理(tool-integrated chemical reasoning)。它的核心要求其实很朴素:智能体得知道自己的知识边界在哪,什么时候该闭嘴调工具,以及怎么把多个来源互相冲突的证据揉成一个答案。
化学智能体这个赛道这几年相当热闹。StructChem 把化学推理拆成结构化阶段,从分子式生成到逐步推理;ChemCrow、ChemToolAgent 往模型外面接专家设计的工具;CheMatAgent 用分层进化蒙特卡洛树搜索做工具规划;SciToolAgent 干脆建了一张工具知识图谱,把几百个工具之间的输入输出兼容关系编码进去;更上层还有 MT-Mol、ChemMAS 这类多智能体分工方案,以及 ChemAgent、S1-NexusAgent 这种靠自我更新记忆库积累经验的路线。
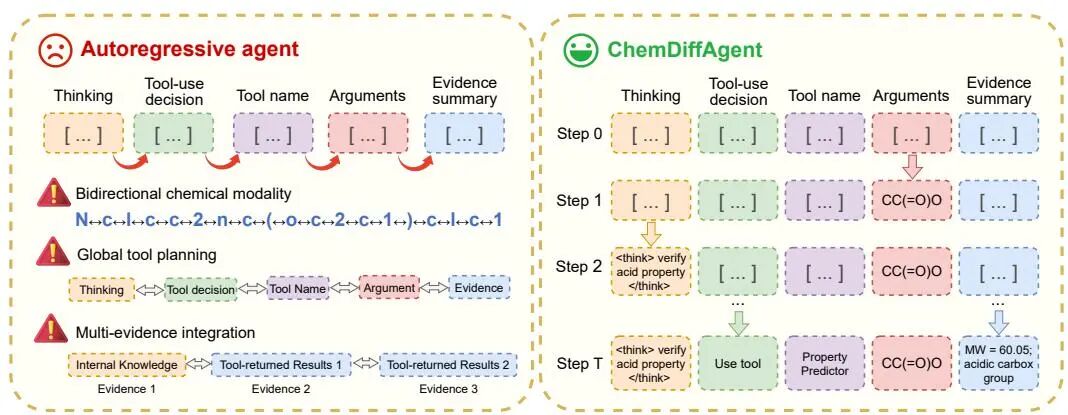
但它们全都站在同一块地基上——自回归(autoregressive,AR)范式。所谓自回归,就是模型拿到提示之后,一个 token 接一个 token 从左往右生成,每个位置只能看到自己左边的上下文,这就是因果注意力(causal attention)的硬约束。论文指出,这套"从左往右、逐字落子"的机制,和化学推理的真实结构有三处对不上。
第一处,化学模态本身就是双向的。SMILES 是分子结构的线性文本表示法,环的闭合编号、支链归属、立体化学标记分散在序列的不同位置,后面的字符会反过来约束前面该怎么写。可自回归模型只能拿着已经写完的左边,去猜下一个字符。
第二处,工具调用是全局耦合的。选哪个工具、参数填什么、这一步的推理目标是什么,三者互相牵制:工具选错,参数再漂亮也没用;参数填错,工具名再准也白搭。而自回归模型必须先把工具名这个 token 定死,再往下写参数和推理,中间没有回头路。
第三处是多源证据融合。复杂化学题通常要把多个工具返回的结果——反应产率、性质预测、结构校验——合成一个连贯答案,纯单向的注意力很难做全局对齐。
后果就是两个老毛病:局部偏置的工具选择,以及不稳定的多步执行。图 1 把这层对比画得很直白,左边是自回归智能体顺着序列一路往下commit,右边是 ChemDiffAgent 在块内把化学模态思考、工具决策、参数和证据一起打磨。 掩码扩散语言智能体:将化学推理重构为迭代去噪过程 顺带说一句,拿扩散语言模型当智能体底座,其实已经有人试过。DLLM-Agent 在 BrowseComp-zh 和网页开放任务上报过 30% 以上的加速,交互轮数还更少;DLLM-Searcher 把"并行推理与行动"和智能体后训练结合,让解码和等工具返回的时间重叠起来,省下大约 15%。但这两项工作都困在网页搜索场景里。这篇论文想问的是:化学这种多步、多模态、多工具的科学场景,扩散范式还灵不灵。🤔
反向过程则是让模型去预测被掩掉的位置原本是什么词。训练时用证据下界(Evidence Lower Bound,ELBO)作为对数似然的代理目标,简单说就是绕开难算的精确似然,用一个始终不超过它的下界来当优化对象。
更贴近本文的是块扩散语言模型(Block Diffusion Language Model,BDLM)。它把序列切成 K 个长度为 B 的连续块,注意力是"块内双向、块间因果"。这样做的好处很实在:块间因果让 KV Cache 和变长生成继续可用,块内双向又保留了任意顺序并行解码的能力。本文的底座 SDAR 就属于这一族,参数从 1.7B 到 8B,通用能力被认为与同期开源自回归模型相当。
那 ChemDiffAgent 究竟把什么当作"待去噪的对象"?答案是整条工具使用轨迹。论文把一条轨迹写成 H = (r1, c1, o1, …, rT, cT, oT, a):其中 r 是推理片段,c = (τ, α) 表示对工具 τ 的一次调用及其参数 α,o = τ(α) 是工具返回的结果,a 是最终答案。
自回归智能体必须把这条轨迹严格按顺序写出来,写到工具名的时候还不知道参数会是什么;ChemDiffAgent 则把每个块内的推理、工具名、参数、证据放进同一个去噪过程里一起收敛。这就是它宣称的块内联合确定,也是"决策边界能贴着知识边界走"的机制解释。
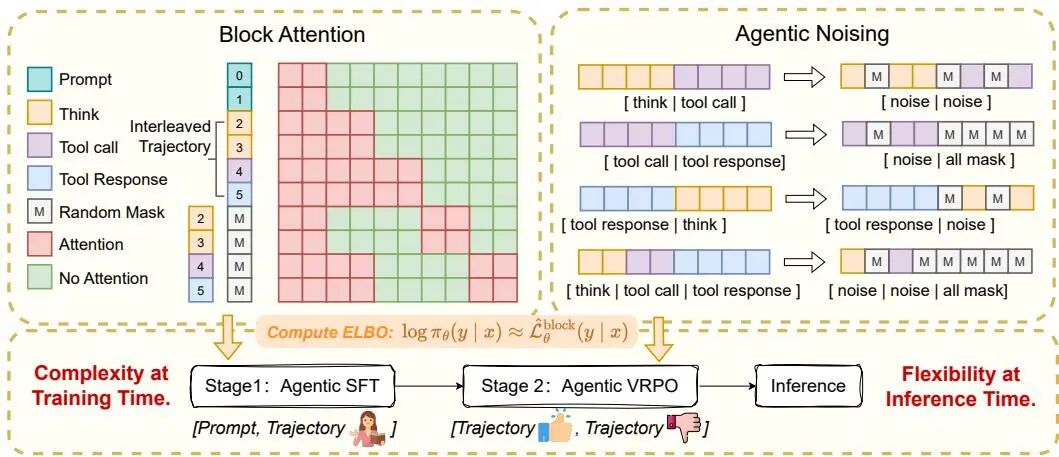
落到系统层面,有三个部件必须讲清楚:块注意力(Block Attention)、智能体加噪(Agentic Noising),以及智能体证据下界(Agentic ELBO)。块注意力的做法是把查询、干净的教师轨迹、以及一份被加噪的轨迹拼成一个输入序列,形如 [Q, Hteacher, Hnoisy]。这样一次前向传播就能在干净轨迹的条件下,监督所有被加噪的块,训练效率直接上来了。
智能体加噪的原则只有一句话:只扰动智能体自己写出来的部分。化学轨迹里,think 和 tool_call 这些片段是智能体自己的决策,而 tool_response 里装的是外部工具给的客观事实。所以前向加噪只掩智能体控制区,工具返回原样保留,作为有依据的上下文。更细的一手是防泄漏:既然块内是双向注意力,同一块里的工具返回本来会被后面的位置看见,训练时就把这些位置一并掩掉,杜绝"训练能看到、推理看不到"的作弊路径。
损失函数也得跟着改。既然只有智能体的决策需要被监督,论文把标准块级 ELBO 改造为 Agentic ELBO。
最终的监督微调损失,就是把这个 Agentic ELBO 取负再取期望,等价于"用扩散式的下界去逼近模型对教师轨迹的似然"。
两阶段后训练框架:Agentic SFT 与方差缩减偏好优化 有了底座还得让它真的会调工具。论文指出,把现成的扩散语言模型直接丢到化学智能体任务上有两个现实问题:第一,模型必须严格遵循化学工具环境要求的可执行调用协议,格式差一个字符都可能跑不起来;第二,它得完成多步化学推理,而不是给一句话就交差。于是有了第一阶段:Agentic SFT(智能体监督微调)。
对每个查询 Q,用高性能教师模型生成一条候选的化学智能体轨迹 Hteacher。这里有个细节值得注意:教师只能从一个较小的相关工具集合里挑工具,而不是整个工具库,这样既压缩了无效探索,又保留了"必须选工具"的考核要求。之后做轨迹级拒绝采样,只有同时满足三条标准的轨迹才能留下——最终答案正确、推理过程清晰完整、每一次工具选择和参数都正确且严格符合格式。留下的查询-轨迹对,才是 SFT 的训练素材。
第二步:Agentic VRPO 的方差缩减偏好优化
SFT 能让模型学会"把工具调起来",但它没有显式优化"成功轨迹优于失败轨迹"这件事。这就是第二阶段 Agentic VRPO(Variance-Reduced Preference Optimization,方差缩减的偏好优化)要补的课。它的思路很直接:同一个问题,拿一条成功轨迹和一条失败轨迹做对比,两条都用 Agentic ELBO 来打分。
关键在"方差缩减"这四个字。扩散模型的 ELBO 是蒙特卡洛估计,单次采样的噪声很大,直接拿一次打分去做偏好学习,梯度会抖得厉害。论文的做法是对每条轨迹采样 M 组不同的加噪上下文 ξj = (tj, ytj),每一组算一个只针对智能体位置的重建得分。
接着让策略模型和固定的参考模型在同一份加噪输入上各自打分,取差值,再对 M 次采样求平均。同一份噪声喂给两个模型,相当于做配对比较,这也是方差缩减的来源之一。
最后套一个标准的 sigmoid 偏好损失:成功轨迹 yw 的相对得分高于失败轨迹 yl 时损失小,反之损失大;β 控制偏好信号的强度,σ 是 sigmoid 函数。
*表格超出部分左右可以滑动
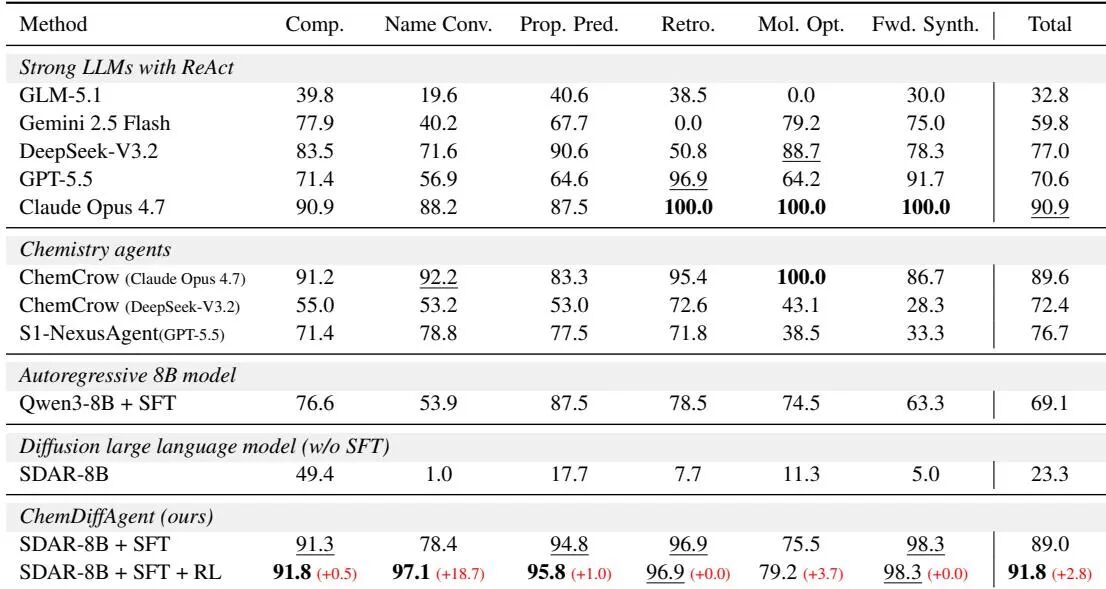
Table 1: Single-turn success rate performance across six chemistry task families: composition inference, name conversion, property prediction, retrosynthesis, molecular optimization, and forward synthesis. Red numbers denote absolute gains of SDAR-8B+SFT over Qwen3-8B+SFT, and of SDAR-8B+SFT+RL over SDAR-8B+SFT. The best and second-best results are highlighted.
六类化学任务基准测试:8B 模型如何超越 GPT-5.5 和 Claude Opus 4.7 单轮数据这块,论文收集了六类以分子与反应为中心的化学任务:组成推断、命名转换、性质预测、逆合成、分子优化、正向合成。构造时保留原始任务的语义,再用强教师模型生成一条可执行的推理轨迹,轨迹构造标准就是前一节说的那三条。
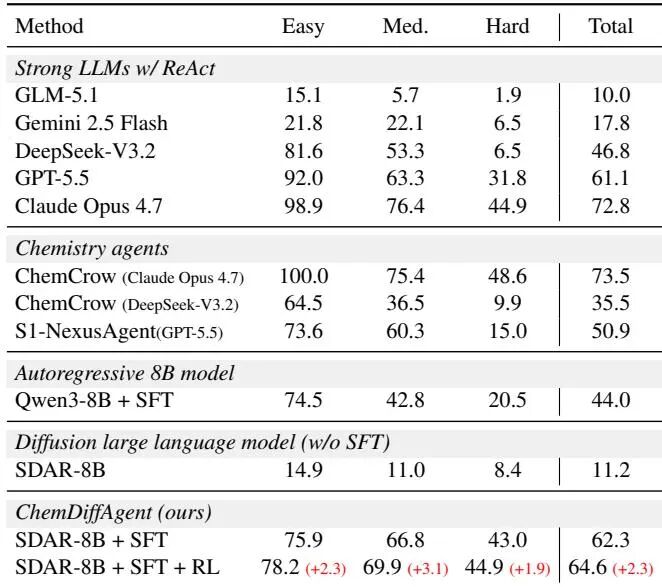
多轮数据的构造更讲究一点。每个样本被设计成一个"图条件"的工具使用任务:先建一张化学工具图,节点是工具,边表示两个工具之间的输入输出是否兼容;然后在图上做随机游走采样子图,让强教师模型把原始任务和采样到的工具编成一道新题;接着按顺序执行整条工具链,只有调用轨迹与采样出的子图完全对得上的候选才保留,最后再人工检查问题是否连贯、工具使用是否合法、答案是否忠实。所以多轮样本里既有执行验证过的最终答案,也有一条标准工具调用图。按标准链的长度,样本被分成 Easy、Medium、Hard 三档,分别对应 2 轮、3 至 5 轮、6 至 7 轮工具调用。
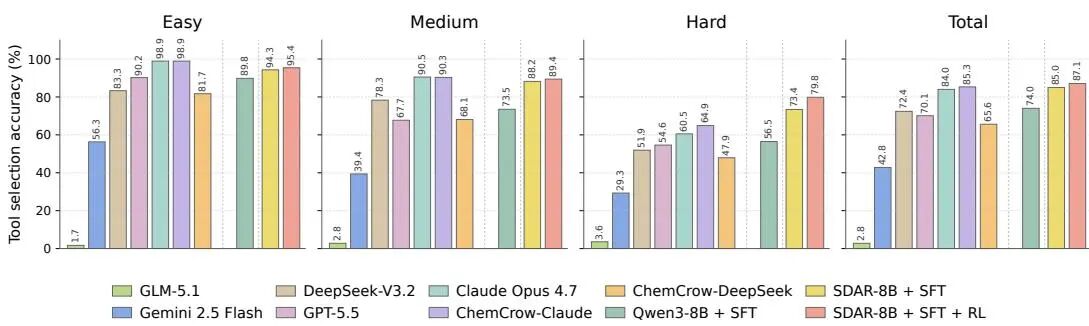
评测指标有两个。一个是答案正确率,由 GPT-4o 判定最终回答是否真正解决了任务;另一个是工具选择准确率,也就是标准工具链里有多少比例的工具被模型实际调用过。基线阵容分三档:同规模对比的 Qwen3-8B 加 SFT,这是最关键的对照,因为它和 SDAR-8B 参数规模相同、预训练同源,SFT 数据、训练轮数、上下文长度、工具接口全部对齐;还有未做 SFT 的 SDAR-8B,用来展示"光有底座不行";再就是配上 ReAct 框架的 GLM-5.1、Gemini 2.5 Flash、DeepSeek-V3.2、GPT-5.5、Claude Opus 4.7,以及专门的化学智能体 ChemCrow 和 S1-NexusAgent。实现上,全部实验跑在 8 张 A100 上,块大小与去噪步数都设为 64。
为什么扩散底座能在化学任务上拿到更好的结果?本文给的机制解释有两条。训练侧,块级填空白让模型见过各种可见上下文组合,模型不是只在"左前缀"这一种条件下学预测,而是要学会在各种残缺信息下复原整块内容,这本身就是更难的子问题。推理侧,块内任意顺序解码让模型可以先把风险低、信息量大的内容定下来,再去定风险高的决策,比如先把工具返回里的证据对齐,再回头确认工具名和参数。
最值得看的是同规模对照那一行。Qwen3-8B 加 SFT 与 SDAR-8B 加 SFT 共享数据、接口、轮数和上下文长度,唯一的区别是自回归还是块扩散,单轮整体分差了约 19.9 个百分点。这个差距很难用"数据更好"解释,因为数据是同一份。另外,RL 阶段是在多轮数据上训练的,但单轮整体分还从 89.0% 涨到 91.8%,说明轨迹级的偏好优化可以迁移到更简单的单轮设定。
但泼冷水也得泼。所谓"反超前沿模型",成立的范围是单轮总分那一栏:91.8% 对 Claude Opus 4.7 的 90.9% 和 GPT-5.5 的 70.6%。多轮总分 64.6% 仍然低于 Claude Opus 4.7 的 72.8%,也低于 ChemCrow 配 Claude Opus 4.7 的 73.5%,只是在 Hard 档与 Claude Opus 4.7 打平(44.9% 对 44.9%)。也就是说,长程工具编排这件事,8B 扩散智能体还没有真正翻过最强前沿模型这座山,论文摘要里的"部分情况下超越"表述是准确的,读的时候别把单轮结论外推到多轮。
几个数字值得单独点出来。未做 SFT 的 SDAR-8B 总分只有 23.3%,其中命名转换 1.0%、逆合成 7.7%,说明扩散底座本身不天然会调工具,后训练是必需的。加上 SFT 之后总分跳到 89.0%,其中逆合成 96.9%、正向合成 98.3%,涨得非常猛。再叠加 RL,整体升到 91.8%,命名转换一项从 78.4% 提到 97.1%,单项就涨了 18.7 个百分点,这是 RL 阶段贡献最大的地方。
工具使用行为分析:更精准的工具选择与更高效的多步推理 除了最终答案对不对,论文还单独看了工具选择这件事。图 3 给出不同难度下的多轮工具选择准确率,ChemDiffAgent 在这项指标上不仅稳定超过自回归的同规模基线,甚至在若干难度上超过了 GPT-5.5 和 Claude Opus 4.7,而且任务越复杂,优势越明显。这个现象挺符合直觉:轮数越多,越需要全局协调,越考验"先定哪个、后定哪个"的能力。
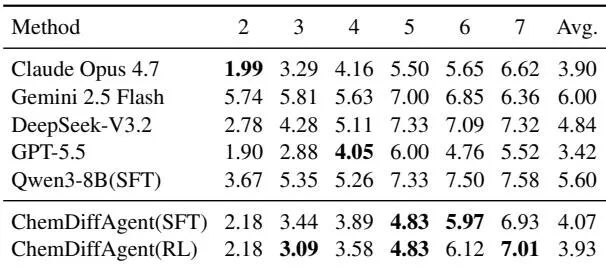
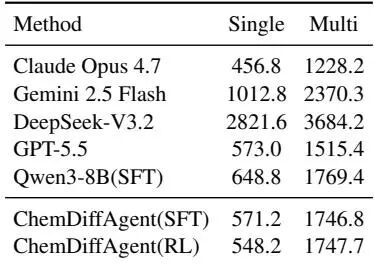
工具使用的效率也被量化了。论文统计了模型实际执行的工具调用轮数与期望轮数的对应关系,以及单轮、多轮设定下的平均轨迹长度。结论是 ChemDiffAgent 的调用轮数紧贴期望步数,做完了该做的就停,不做多余调用;相比之下,Gemini 2.5 Flash 经常多调,超出必要范围,而 GPT-5.5 则有时少调,链条没走完就收手。一个会"节制"的智能体,在产品视角下就是省钱和省时间。
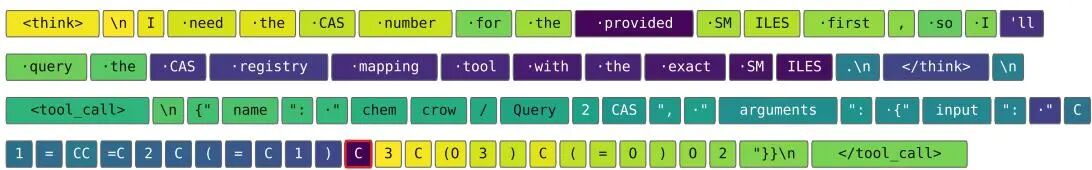
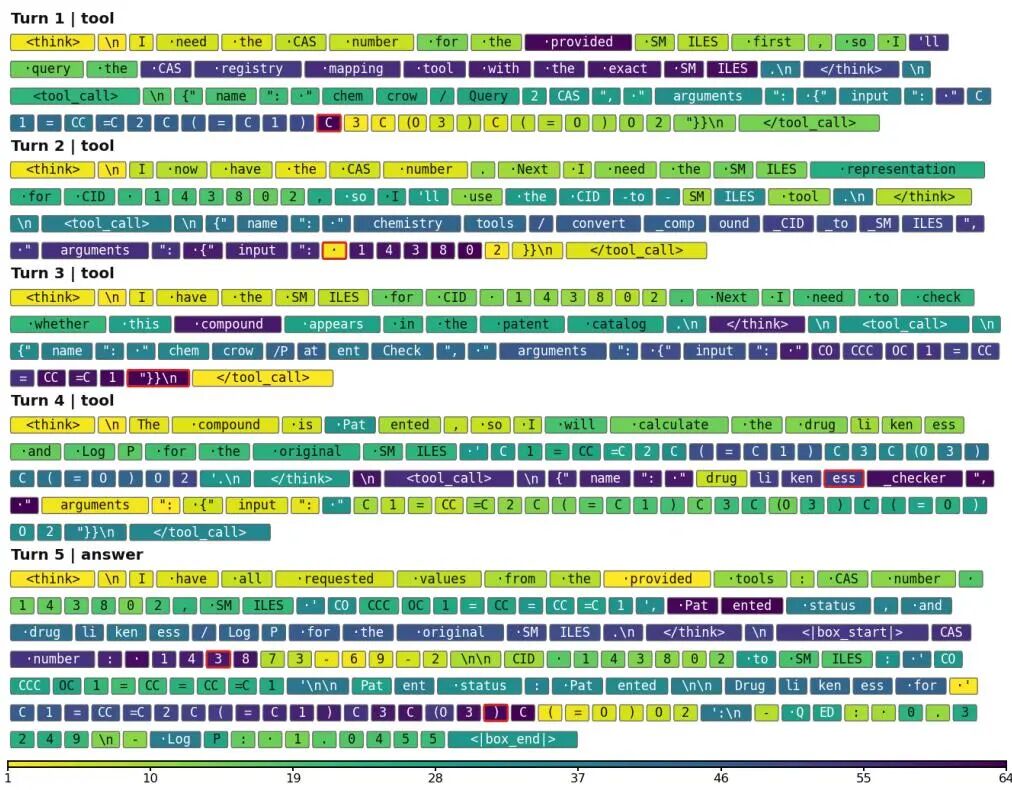
最直观的证据来自解码顺序的可视化。图 4 用热图展示了某个示例回答中每个 token 在一个块内的相对解码顺序,每块最后一个 token 用红框标出;图 5 则把一条 ChemDiffAgent 工具调用块的 token 级去噪顺序画了出来,颜色越浅表示越早被确定,越深表示越晚被确定。从热图能看出,模型并不是老老实实从左到右填,而是先敲定信息充分、依赖较少的位置,再回头处理依赖较多的位置——这就是理论分析里说的"灵活顺序"在真实推理中的样子。😏
理论分析揭示扩散范式的优势:自适应路径与严格排序优势 这篇论文比较少见的一点,是它没有只讲"效果好",而是试图解释"为什么该好"。训练侧的分析从一个块级填空目标开始:把干净回答切成 K 个连续块,随机选择非空的块集合 A,把这些块里的 token 全部换成掩码,让模型在任意可见上下文组合下重建它们。
这个目标的价值在推理时兑现:因为模型在各种掩码模式下都学过合法的后验分布,它才有资格在生成时沿着任意路径去评估和解码。论文把这一条概括为"训练时更难,推理时更自由"。
一个推理问题里的不同部分,条件难度并不一样,而且解决其中一部分往往会简化另一部分。论文把每个位置的预测难度拆成两项:条件熵(问题本身的不确定性)加上模型的近似误差。
除了"难度",还有"代价"。不同位置出错,下游后果完全不一样。设 Z 是在自回归顺序里更早出现的高风险决策,R 是同一块里较晚出现、但能为 Z 提供信息的低风险决策,两者有固定的下游错误代价权重 wZ > wR。
两条结论一条讲预测难度、一条讲错误代价,共同指向同一个判断:在工具集成化学推理这种"部分之间互相牵制"的场景里,顺序自由本身就是一种能力。这个分析并不算多深,但它把工程观察变成了可推导的命题,这一步是有价值的。
龙迷三问 这篇论文到底在解决什么问题? 化学智能体长期困在自回归的左到右生成里:工具选错、证据丢失、错误一路传下去。中科院计算所提出ChemDiffAgent,把化学推理改写成掩码扩散的迭代去噪,配合两阶段后训练,8B模型六类任务总分91.8%,反超GPT-5.5。这篇工作最值得看的点是什么? CHEMDIFFAGENT在单轮任务上达到91.8%的总成功率,超越所有基线包括Claude Opus 4.7(90.9%)和ChemCrow(89.6%);在多轮任务上达到64.6%,超越GPT-5.5(61.1%)和ChemCrow(73.5%在Easy上但Hard仅48.6%),在Hard split上与Claude Opus 4.7(44.9%)持平。工具选择准确率持续超越前沿模型,尤其在任务复杂度增加时优势更明显。这篇工作的边界或风险在哪里? 优点在于首次将掩码扩散语言模型引入化学智能体领域,通过迭代去噪实现全局协调的工具使用和多源证据整合,理论分析从自适应路径优势和严格排序优势两个角度论证了扩散范式的优越性,两阶段后训练框架设计合理,8B模型即达到前沿模型水平。缺点在于仅在8B参数规模上验证,工具集固定且限于计算化学工作流,dLLM的部署基础设施尚不成熟,训练难度随模型规模和推理步数增加而显著上升,缺少块大小和去噪步数的消融实验。如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~
龙哥点评
论文创新性分数: ★★★★☆
首次提出掩码扩散语言智能体CHEMDIFFAGENT,将工具集成的化学推理重构为交错推理与工具使用轨迹上的迭代去噪过程,使工具使用决策能在全轨迹上下文下联合确定,从而更好地对齐智能体的决策边界与知识边界。实验合理度: ★★★★☆
答案正确率(由GPT-4o评判最终回答是否解决任务)和工具选择准确率(模型调用的工具占黄金链中预期工具的比例)。学术研究价值: ★★★★☆
首次提出掩码扩散语言智能体CHEMDIFFAGENT,将工具集成的化学推理重构为交错推理与工具使用轨迹上的迭代去噪过程,使工具使用决策能在全轨迹上下文下联合确定,从而更好地对齐智能体的决策边界与知识边。稳定性: ★★★☆☆
现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。适应性以及泛化能力: ★★★☆☆
现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。硬件需求及成本: ★★★☆☆
未明确报告FLOPs,实验在8块NVIDIA A100 GPU上进行,块大小和去噪步数均设为64,最大提示长度4096,最大生成长度8192。复现难度: ★★★☆☆
https://github.com/bilemond/ChemDiffAgent产品化成熟度: ★★★☆☆
论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。可能的问题: 现有材料尚未充分覆盖分布外泛化、部署成本、长期稳定性和失败案例。
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击 "阅读原文", 查看更多原论文细节哦!
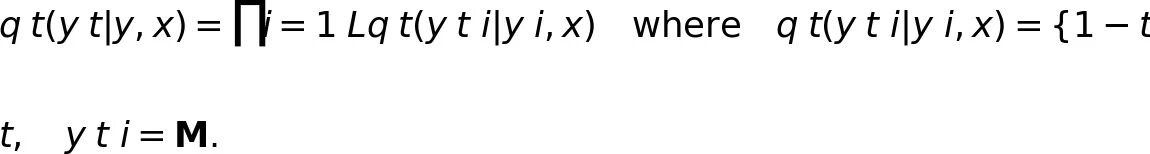
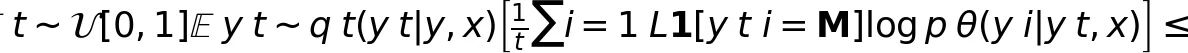
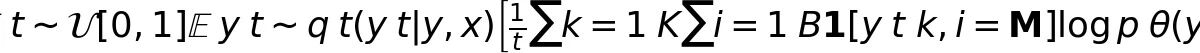
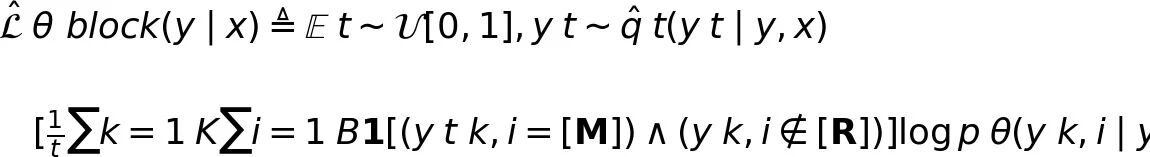
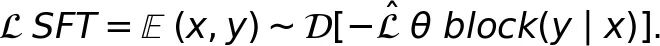
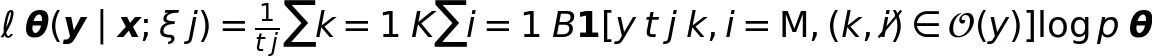
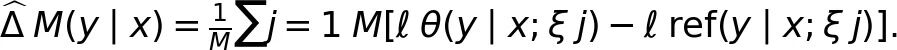
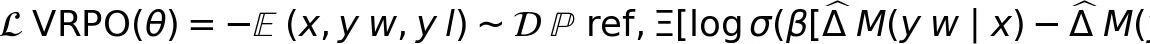
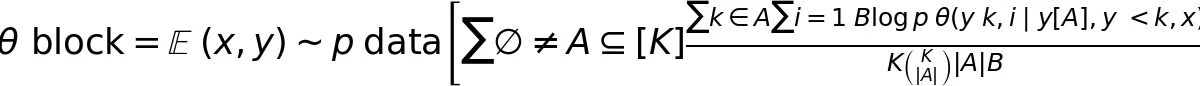
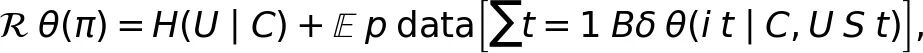
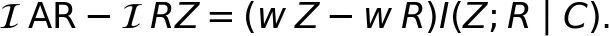

还没有公开留言,欢迎留下你的看法。