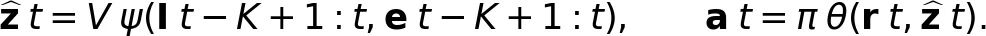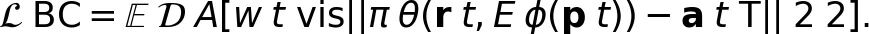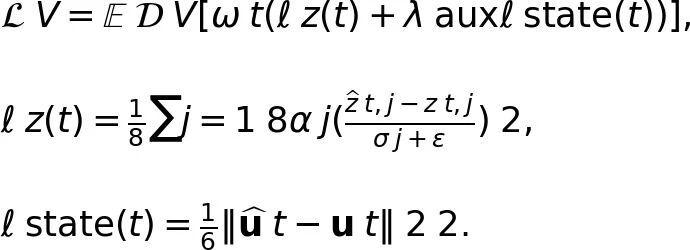
← 返回 PaperDaily 视觉与图像

华盛顿大学Reflex:人形机器人接住飞来箱子,真机成功率65%

接住一个扔过来的东西,人类基本不用想。回追一个网球、接住从桌边滑落的杯子、侧身躲开推车、搬货时顺手接住同伴抛来的纸箱,这些动作有一个共同点:目标在动,留给你的反应时间大约只有一秒,而且要用整个身体去接,而不只是伸手。

华盛顿大学Reflex:人形机器人接住飞来箱子,真机成功率65%
原论文信息如下:
论文标题:
Reflex: Visually Reactive Whole-Body Catching on a Humanoid
发表日期:
2026年10月
发表单位:
University of Washington, Stanford University, University of Southern California, National University of Singapore, University of North Carolina at Chapel Hill, Allen Institute for AI
原文链接:
https://arxiv.org/pdf/2610.12772v1.pdf

paperdaily_reaction_gif

人形机器人也能接住飞来的箱子?Reflex让全身反应式接物成为现实
接住一个扔过来的东西,人类基本不用想。回追一个网球、接住从桌边滑落的杯子、侧身躲开推车、搬货时顺手接住同伴抛来的纸箱,这些动作有一个共同点:目标在动,留给你的反应时间大约只有一秒,而且要用整个身体去接,而不只是伸手。
对人形机器人来说,这件事的难度是叠加的。论文把"接住一个被抛出的纸箱"拆成三种必须同时成立的能力。第一种是全身控制:脚怎么落位、躯干怎么摆、怎么吸收冲击、怎么在抱住箱子的同时不摔。第二种是对运动物体的实时反应:不能只看最新一帧,必须在接触之前就判断箱子会到哪里,并提前"下注"。第三种是从自我中心视角(egocentric vision,指相机跟随机器人身体一起运动的视角)完成前两件事,图像里的运动同时包含物体运动和相机自运动(ego-motion),而且越靠近接触,机器人自己的手臂把箱子挡得越厉害。
论文里的几个数字很能说明这个任务的紧迫程度。真机试验中,被抛出的箱子从脱手到抵达机器人大约只有一秒;仅"相机到控制"这一环的延迟中位数就有 69 毫秒,而且这还是基于检测器的流水线测出来的。
更有意思的是人的成绩。论文让三位人类测试者在 7 米距离接箱子,成功率只有 28.3%。也就是说,接箱子并不是一个"机器人挑战超人"的任务,它更像是在跟手忙脚乱的普通人比。🤚
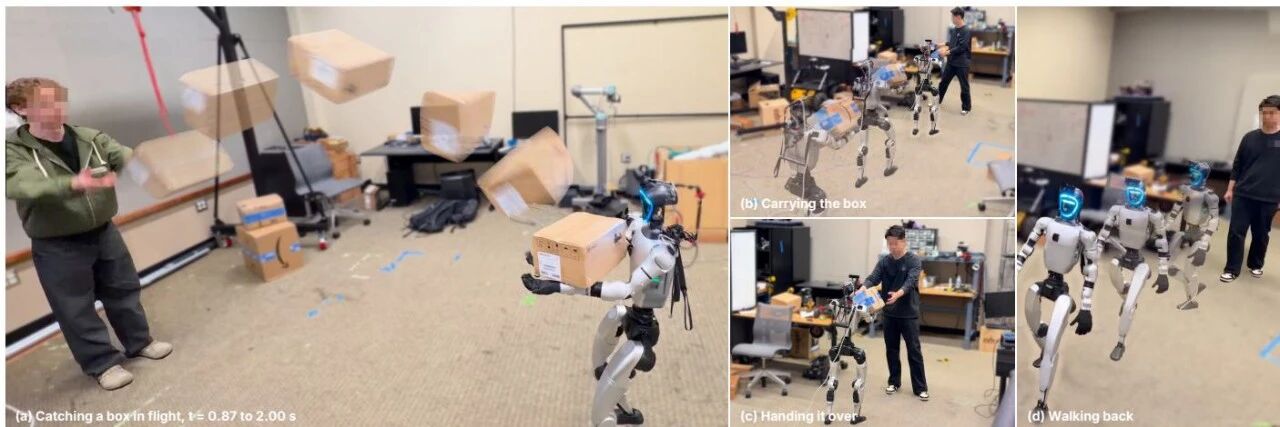
图1:人形机器人上的视觉反应式全身接物
图1:人形机器人上的视觉反应式全身接物。(a)仅用机载 RGB-D 输入接住一个被抛来的纸箱;(b)到(d)是下游应用演示:抱着箱子走 7.8 米、把箱子递给一个人、再走 7.3 米返回。接住并留存下来的箱子会直接交给下游行走控制器完成搬运与递交。
已有系统只覆盖了其中一部分。固定基座或轮式基座上的机械臂可以接住运动物体,但它们绕开了全身平衡和冲击吸收这两个难点。近期的人形机器人能打飞飞来的球,或者用双手接住篮球传球,但往往依赖动作捕捉(motion capture)或者贴了反光标记(retroreflective)的物体,而不是靠机载相机把快速运动的物体接地到自己的感知里。
本文提出的 Reflex 由华盛顿大学、斯坦福大学、南加州大学、新加坡国立大学、北卡罗来纳大学教堂山分校以及 Allen Institute for AI 合作完成,第一署名单位为华盛顿大学,测试平台是 29 个自由度(DoF,Degree of Freedom)的 Unitree G1。它想做的事情,是把三件事第一次比较完整地放在同一台真机人形上:全身控制、快速物体动力学预测,以及自我中心视觉接地。
一句话概括思路:不在像素上端到端地学"接物",而是把三种能力分成三个阶段分别学,再用一个紧凑的物体动力学隐变量把三个阶段串起来。仿真中,仅靠自我中心 RGB-D 输入的接住成功率是 85.7%,如果直接给它特权(privileged,指部署时拿不到的真值信息)的箱子状态则是 87.9%;真机上在 2.5 米和 5 米处分别为 65% 和 40%,相当于人类同距离成功率(85.0% 和 68.3%)的 76% 和 59%。

三阶段解耦:如何让视觉强化学习不再昂贵

在讲三阶段之前,先说清楚为什么不直接训一个端到端策略。代价来自四个方向。第一,每一次在线采样都需要高吞吐的 RGB-D 渲染。第二,策略要同时探索巨大的视觉空间和一个 29 维的动作空间。第三,成功信号要等到接触并把箱子稳定保持 0.6 秒之后才出现,监督极其稀疏,用这样的信号去学"箱子怎么动"非常吃力。第四,相机自运动、间歇性遮挡,以及策略自己造成的视角变化,会把感知误差直接耦合进控制器遇到的分布里。结果是,端到端训练会把视觉表示学习和运动技能发现纠缠在一起,想改感知就得连带重训控制器。
论文给了一组很直观的算力对比:在单张 RTX 3090 上,不渲染的 Stage 2 PPO 大约能跑 2.8 万环境步每秒(4096 个并行环境),而把 192×144 的 RGB-D 渲染塞进训练循环只有约 1500 步每秒(320 个环境)。同样是 5900 万步,前者大约 35 分钟,后者大约 11 小时。差了一个数量级。
论文的做法是把部署策略显式拆成两半:一个视觉感知函数 Vψ,一个全身控制函数 πθ。前者从 K 帧自我中心 RGB-D 历史和相机自运动里预测一个 8 维的物体动力学隐变量,后者把这个隐变量和 160 维的机器人/参考观测合在一起,输出 29 维归一化动作。
公式1:感知-控制分解
公式1:感知与控制的分解接口。其中 It−K+1:t 是长度为 K 的自我中心 RGB-D 观测历史,et−K+1:t 是对应的相机自运动序列,rt 是机器人/参考观测,ẑt 是预测出的动力学隐变量,at 是归一化的全身动作。这个接口的意义在于:把"从视觉里能推断出什么物体信息"和"这些信息该如何驱动身体"这两件事彻底分开。
动作最终要变成关节目标,方式是围绕一个标称关节配置做逐关节缩放:
公式2:关节目标换算
公式2:全身关节目标换算。q0 是 29 维标称关节配置,s 是每个关节的动作缩放系数,⊙ 表示逐元素相乘,qtnom 就是这一步下发的关节位置目标。

第一阶段:先把"身体会接"这件事学会

第一阶段先把运动技能单独拆出来。在不需要渲染的仿真里,用 PPO(Proximal Policy Optimization,近端策略优化,一种常用的策略梯度强化学习算法,由 Schulman 等提出)训练一个基于状态的接物策略 πstate。它的输入是 170 维观测,由 160 维机器人/参考输入加上 10 个箱子状态通道构成:骨盆坐标系下的位置 3 维、线速度 3 维、观测年龄 1 维,以及测量抖动、新鲜度、冻结观测三个指示位。仿真通过给箱子检测加随机噪声、丢帧和延迟来生成这些通道,再过一遍硬件上实际使用的卡尔曼滤波(Kalman filter,一种递归状态估计方法)。
策略网络是一个隐藏层宽度 512–256–128 的多层感知机,激活函数用指数线性单元(ELU),输出 29 维动作;另外配一个非对称的评论家网络,它可以额外看到未加噪的全身位姿以及真值的箱子位置和速度,用来降低价值估计的方差。
奖励设计上有几块拼图:接近塑形鼓励机器人移动到拦截位置;托举塑形奖励前臂在胸前形成支撑;持续接住加分奖励真正把箱子留在身上。动作层面用重定向后的真人参考动作做跟踪,再加一个对抗式运动先验 AMP(Adversarial Motion Prior,对抗式运动先验,用一个判别器把生成动作往真实人体运动分布上拉,由 Peng 等提出)来引导整体动作协调。同时还有几项惩罚,分别抑制躯干过度摆动、动作突变和摔倒。投掷参数、接触属性、机器人动力学都被随机化,训练里还会让人形以"已经抱着箱子"的状态起步并施加扰动,专门练留存与恢复。
训练完成后,这个状态策略被冻结,成为后面两个阶段的老师。

第二阶段:只学"箱子的运动规律"

第二阶段回答的是"控制器到底需要知道箱子的什么"。论文引入一个特权编码器 Eφ,把 26 维的箱子观测压缩成 8 维隐变量,取值范围被 tanh 限制在 [−1, 1] 之间。26 个通道包括相机坐标系下的位置 3 维、相对线速度 3 维、箱子半边长 3 维、朝向 12 维、角速度 3 维、可见性 1 维,以及归一化的观测年龄 1 维。朝向的编码方式值得一提:它用箱子长轴和短轴各自的外积中六个独立元素来表示,这样对轴向的正负翻转天然不敏感。
观测本身是残缺的:论文在一个 25 帧的延迟窗口里挑最新的可见样本,并做视场遮挡和丢帧处理。如果窗口里一个可见样本都没有,位置、线速度、角速度和朝向全部置零,可见性设为 0,归一化年龄设为 1,只有箱子半边长仍然可用。也就是说,编码器每次只看到一个带延迟的样本(其中含速度信息),"从历史里推断运动"这件事被留给了第三阶段。
隐变量的坐标不是人为规定的,而是通过"动作匹配"学出来的。论文保留老师解码器的主体结构,只把它的物体输入权重换成随机初始化的隐变量输入权重,然后用行为克隆 BC(Behavior Cloning,行为克隆,即直接监督模仿专家动作)做初始化。可见箱子的样本权重给 5,其余给 1,只更新特权编码器和解码器第一层的隐变量输入权重。
初始化之后是 DAgger(Dataset Aggregation,数据集聚合,一种让学生在自己访问到的状态上继续向老师请教标签的模仿学习流程)式的数据聚合:先收集老师驱动的轨迹,再让隐变量控制器自己跑,并用固定的状态老师在这些新状态上打动作标签,扩完数据集后重做一次动作匹配。最后用 PPO 联合优化特权编码器和整个解码器,因为解码器也在更新,全身控制本身也会被进一步打磨。
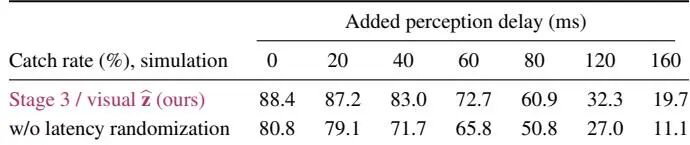
这一阶段有一个容易被忽略但很关键的细节:延迟随机化。每个回合从 1 到 3 个控制步(也就是 20 到 60 毫秒)之间采一个物体观测延迟,逼着控制器在"看到的是旧消息"的前提下行动。单种子对比显示,不做延迟随机化的控制器在每个测试延迟上都低 5 到 11 个百分点。

第三阶段:把隐变量接到相机上

第三阶段只做一件事:把已经训好的动力学隐变量,在自我中心视觉里重新接地。控制器完全不改,渲染也只在这一阶段出现。
视觉编码器使用长度 K=25 的历史。一个卷积神经网络(CNN,Convolutional Neural Network,卷积神经网络)先预测一张箱子定位热图;一个固定的几何层把它变成 8 维几何特征:归一化图像坐标 2 维、两个邻域内的局部最小深度 2 维、热图峰值分数 1 维,以及由针孔反投影得到的相机坐标系表面点 3 维。随后一个门控循环单元(GRU,Gated Recurrent Unit,门控循环单元,一种循环神经网络结构)吃这些几何特征和 9 维相机自运动向量,用来在视角变化和漏检的情况下推断物体运动。注意这里的结构约束:外观信息只能通过定位热图进入 GRU,GRU 本身不直接看原始图像。
训练也是两步走。先训 CNN 和热图头:监督目标是以投影箱子中心为中心的高斯热图,损失用二元交叉熵。然后冻结 CNN 和热图头,只训 GRU 和两个输出头,一个头预测动力学隐变量,另一个头辅助预测箱子的位置和速度。只有隐变量会被送进解码器,辅助头的作用是提供额外监督信号。
视觉数据集里的隐变量标签,是用第二阶段冻结下来的特权编码器打出来的。论文还做了第二轮 DAgger:先跑视觉控制器,再用固定的特权编码器给它访问到的状态标上隐变量,聚合数据后重新拟合 GRU。这个环节和第二阶段不同,监督的是"隐变量"而不是"动作"。
外观适配做得比较务实:本地化器预训练时会随机改变箱子颜色,同时施加随机 RGB 增益与偏移、像素噪声、小幅图像位移,以及约 2.4 厘米的深度噪声。不过论文也坦率承认,运动模糊、自动曝光动态和结构化深度伪影都没有建模。

接住之后:走下去、递出去

为了让"接住"不只是一个孤立的动作游戏,论文把它接入了下游链路。接住并留存下来的箱子交给预训练的 SONIC 运动控制器(论文引用文献[22])完成负重行走与递交,交接对象由视觉人体检测来识别。控制权转移由一个监督模块负责:当胸前持续出现箱子证据,且腿部速度、躯干倾角和底座速度都足够低、说明姿态已经稳定时,才切换控制器。切换后参考姿态先保持当前姿势 2 秒,再过渡到站立托抱姿态进入行走和递交。此外还有一个基于 MuJoCo 的部署孪生体,用来校验感知、通信、关节指令和控制器切换。
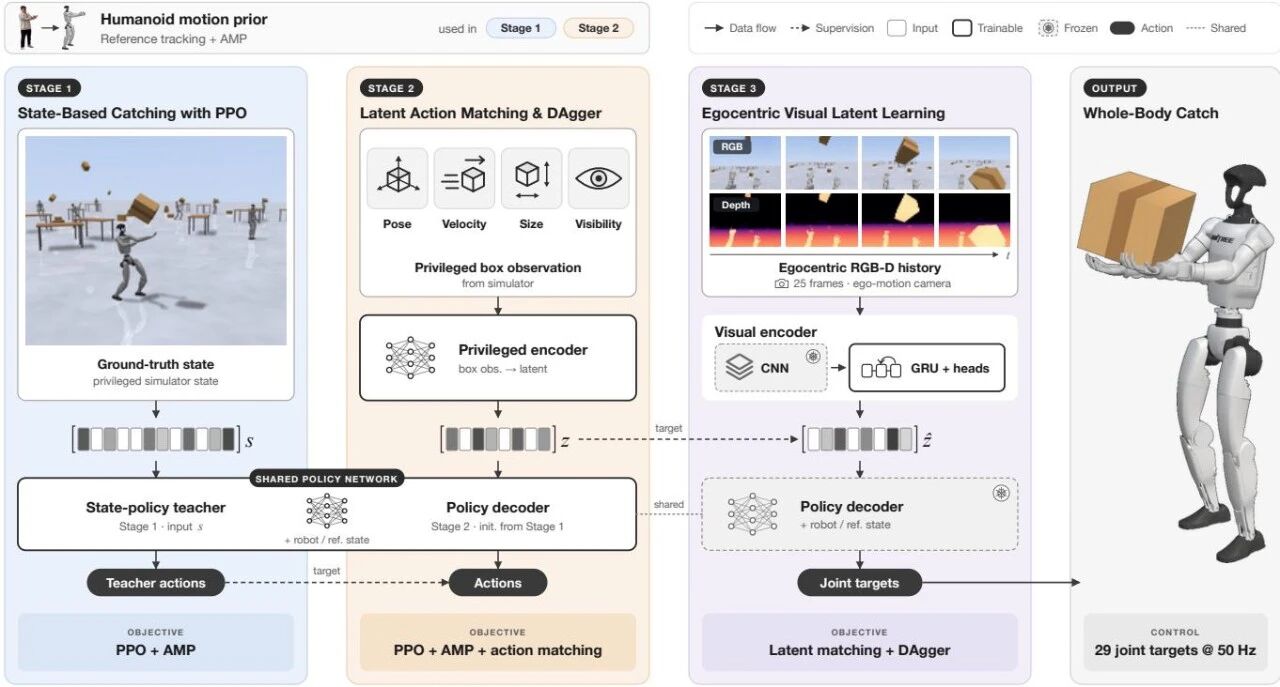
图2:训练流水线与策略架构
图2:训练流水线与策略架构。第一阶段用 PPO 训练基于状态的状态策略老师,学会全身控制;第二阶段学物体动力学,先用动作匹配初始化特权编码器和解码器的隐变量输入权重,再用 PPO 联合微调编码器与解码器,人类动作样本提供参考跟踪和 AMP 风格奖励;第三阶段学视觉接地,从 RGB-D 历史和相机自运动预测隐变量,用箱子状态监督并配合 DAgger 采样。预训练好的 CNN 和热图头在 GRU 训练期间保持冻结,特权编码器和解码器在整个第三阶段也不动。解码器同时接收机器人/参考观测。由于第三阶段只学隐变量预测器,视觉控制器可以直接复用 PPO 训好的解码器。

论文主体思路速览

*表格超出部分左右可以滑动 TABLE I SIMULATION ROBUSTNESS. CATCH AND INTERCEPTION RATES (%); ONE CHECKPOINT PER CONTROLLER, 640 THROWS PER CONDITION (320 FOR THE DETECTOR). WITH THE SAME DETECTOR, VISUAL LATENT CONTROL EXCEEDS DETECTION PLUS FILTERING WITHIN ITS VISUAL TRAINING RANGE.
TABLE I SIMULATION ROBUSTNESS. CATCH AND INTERCEPTION RATES (%); ONE CHECKPOINT PER CONTROLLER, 640 THROWS PER CONDITION (320 FOR THE DETECTOR). WITH THE SAME DETECTOR, VISUAL LATENT CONTROL EXCEEDS DETECTION PLUS FILTERING WITHIN ITS VISUAL TRAINING RANGE.

从特权状态到自我中心视觉:物体动力学隐变量的学习之道
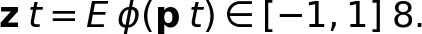
先解释一个基础概念。特权学习(privileged learning)是仿真到真实迁移里的常见套路:训练时给策略一些部署时拿不到的信息,比如物体的真值状态,先训出一个"老师";再让只能看相机和机器人状态的"学生"去模仿老师的行为。这样可以把"感知"和"控制"分开训练,避免稀疏奖励直接把学习压垮。
本文在这一点上做了一个明确的选择:学生不是去回归完整的箱子物理状态,而是去回归老师那个 8 维隐变量。隐变量由特权编码器从 26 维箱子观测压缩而来:
公式3:特权隐变量编码
公式3:特权隐变量的定义。pt 是第 t 步的 26 维箱子观测,Eφ 是由一个线性投影加残差多层感知机再经 tanh 构成的编码器,输出的 zt 被限制在 [−1, 1]8 的立方体内。这 8 个坐标没有人为设定的物理含义,它们靠动作匹配和任务优化共同确定。
动作匹配用的损失是标准的平方误差,只是样本被可见性加权:
公式4:动作匹配初始化损失
公式4:动作匹配初始化损失。DA 是存放"机器人/参考观测、箱子观测、老师平均动作"三元组的数据集,wtvis 是按可见性给的样本权重,可见时取 5,不可见时取 1。整个式子的含义很直白:让"只看到隐变量"的学生,尽可能复现"看到箱子状态"的老师的动作。
第三阶段的视觉训练目标则是一个加权组合,主干是隐变量回归,附带一项辅助的箱子状态回归:
公式5:视觉时序训练目标
公式5:视觉时序训练目标。第一行是总损失,ωt 强调近距离观测,λaux 平衡辅助监督;第二行是逐维加权的隐变量回归,σj 是训练集上第 j 个隐变量坐标的标准差,αj 反映固定解码器对"某一维出现一倍标准误差"的动作敏感度,也就是说,对动作影响越大的维度,权重越高;第三行是辅助的位置速度回归,ut 是标准化的当前相机坐标系箱子位置与速度,属于监督信号,不进入控制器。
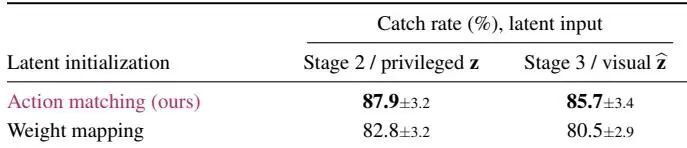
这套设计里最值得琢磨的是"隐变量而不是完整状态"这个选择。完整状态回归看起来信息更全,但它把机器人不需要精确知道的分量(比如完整朝向)也压进了监督信号,误差被均摊到所有维度;而隐变量回归让所有容量都集中在"控制需要什么"上。论文的消融结果与此一致:回归隐变量比回归完整特权箱子状态效果更好。此外,动作匹配初始化比直接用权重映射(weight mapping)平均高 5.2 个百分点,说明让新通道在初始化时就"对齐老师的动作语义",比强行让隐变量坐标对应物理量更有效。
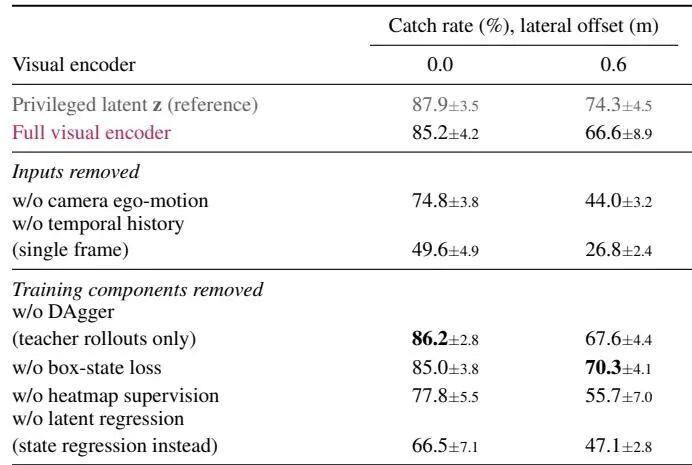
另一个硬结论是时间历史不可省。去掉时序历史,正投和 0.6 米偏移投掷的成功率分别掉 35.6 和 39.8 个百分点。原因不难理解:单帧观测只能给出箱子的位置,速度和飞行方向无法从一帧里推出来;而如果让网络隐式去猜,相机自运动带来的图像运动又会和物体运动混在一起。25 帧历史给了 GRU 把两者分开的空间。相机自运动本身也被证明是有效的:消融显示它对视觉接地有实际贡献。

实验验证:仿真85.7%成功率,真机达到人类76%水平


数据准备及实验设计
第一阶段使用随机化的状态观测,老师策略则用真值的箱子位置与速度来查询;作为参照的"真值状态策略"喂进去的是理想测量,也就是完整、无噪声、零延迟的箱子测量,再经过它自己的卡尔曼滤波。
第二阶段的行为克隆初始化用 5 轮数据聚合,可见箱子样本给 5 倍权重;随后的联合 PPO 使用 4096 个并行环境、600 次迭代、初始学习率 10−4,不加额外的隐变量噪声或整向量丢弃。释放距离覆盖 2.5 到 5.0 米,箱子尺寸在三种规格之间随机:25×19×13、34×26×22 和 42×32×27 厘米。特权编码器有两层 64 单元的残差隐藏层;视觉模型用两层 128 单元的 GRU,输入是 8 维几何特征与 9 维自运动特征。本地化器用颜色增强预训练 20 个轮次、批大小 32、学习率 3×10⁻⁴;时序训练用 AdamW 跑 60 个轮次、批大小 512、最大学习率 2×10⁻³,λaux 取 0.5,箱子距离在 0.5 到 2.5 米之间时样本权重放大约 8 倍。视觉训练每个控制器配两到三轮 DAgger,轮次在留出投掷上选择。
评估协议值得单独说明,因为它决定了数字能不能横向比较。每个环境从 3.0 到 3.5 米投掷一次,箱子取 34×26×22 厘米;评估从"没有持箱"的状态开始,从第一步就开始计分,640 步后结束。重投、故意不可达的目标、机器人推挤、持箱踢击这些容易刷分的操作全部被禁用。投掷姿态、旋转、瞄准散布、物理属性和复位状态噪声仍然随机化。初始化对比更狠:每一种隐变量配置训练六个控制器,每个控制器在 640 次留出投掷上评估,也就是每种配置 3840 次投掷。
成功判据被拆成三种不同结果,这个设计比单一"成功/失败"更细致。拦截指机器人止住了箱子靠近的运动,即箱子在躯干附近降到 1 米每秒以下,不管后面有没有拿住;接住成功是主要指标,要求箱子被支撑在胸部区域、双腕位于箱子两侧、不借助头部或肩部支撑,并在低速下保持 0.6 秒;接住后稳定性单独统计,记录躯干倾角是否在发射到回合结束之间达到 38 度,摔倒则独立报告。箱子尺寸扫描时固定的胸部区域判据不再可比,因此改用与几何无关的持续握持判据。
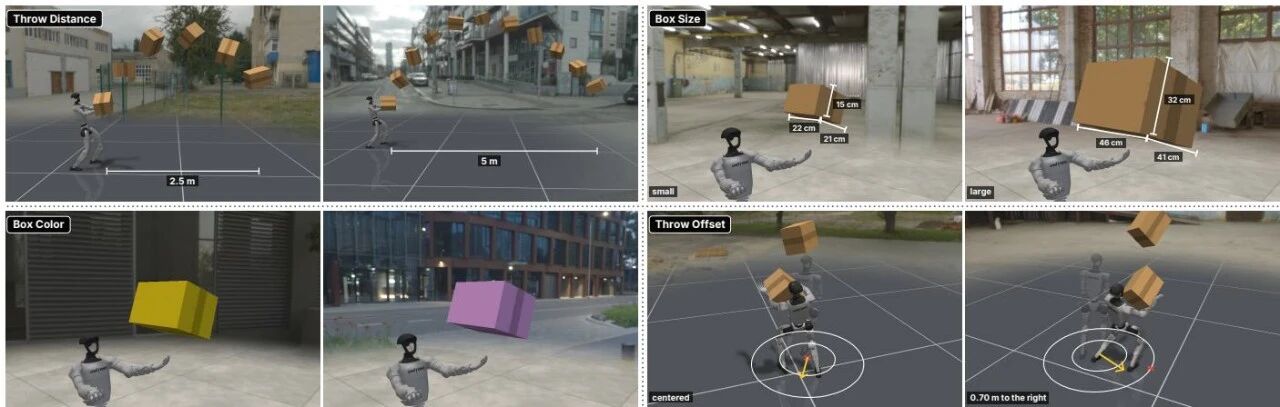
图3:投掷与外观变化
图3:投掷与外观变化。仿真示例展示了释放距离、箱子尺寸、颜色和落点的变化;箱子尺寸面板里是实测的真实箱子;模拟的重量和距离测试统一使用 34×26×22 厘米的训练箱。颜色增强只在训练视觉组件时施加。这些变化构成了后文鲁棒性评估的操作条件。

实验结果分析

先说结论为什么站得住。三阶段分解之所以有效,核心在于每一项能力都拿到了直接的训练信号:全身控制有仿真状态和塑形奖励,物体动力学有动作匹配和 PPO 回报,视觉接地有隐变量回归。视觉学习被隔离在第三阶段,而第三阶段只改隐变量预测器,控制器完全不参与训练,所以感知的升级不需要重训动作。这条设计在工程上比"端到端一次训完"省掉的不只是时间,还有调试时的排查成本。
再说统计可信度,这里必须给论文一个肯定。仿真侧每个条件 640 次投掷,视觉消融跑五个策略取均值与标准差,初始化对比训六个控制器各评 640 次,这个量级在机器人论文里算是比较扎实的。真机侧就明显吃紧了:每条件 20 次试验,95% 的 Wilson 区间最宽能到正负 20 个百分点左右。论文自己也把例子摆了出来,0.5 公斤和 1 公斤载荷分别是 9/20 和 12/20,Fisher 精确检验 p 值为 0.53,这个差异在统计上并不显著。所以真机表格里那些小差距,读者不应该当成确定结论来读,只有 2.5 米与 5 米之间、以及接近人类水平这类量级差异才比较可信。
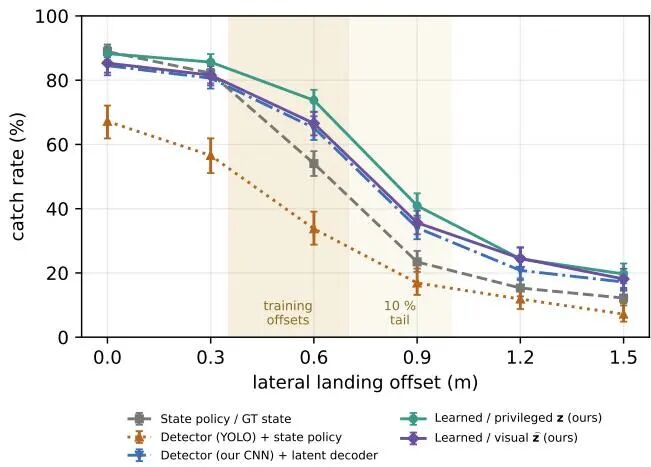
横向落点偏移那组结果需要小心解读。论文报告视觉隐变量输入在 0.6 米和 0.9 米偏移处,反超真值状态策略约 12 个百分点,而基于 YOLO 检测器的方案在每个报告的偏移上都低于状态策略。这个现象初看很反直觉,"相机比真值还准"显然不成立。论文给出的解释是,特权观测使用的是硬件相机的视场掩码,水平正负 53 度、竖直正负 40 度,而渲染出来的 4:3 针孔图像在竖直方向只有正负 45 度,因此特权输入的结果只能作为"视觉替换"的参照物,两组条件的可见性并不严格一致。更稳妥的解读是:隐变量表示在偏移场景下比原先的状态表示更鲁棒,感知与控制在联合优化之后形成了对横向变化的更好适应,而不是相机真的比真值测量更准。
延迟是这篇论文里最"工程"的一部分,也是最容易被忽略的贡献。硬件侧基于检测器的流水线相机到控制延迟中位数是 69 毫秒,第三阶段还额外引入 40 毫秒延迟,而第二阶段的延迟随机化只在 20 到 60 毫秒之间采样。也就是说,训练时刻意模拟的延迟范围小于部署时的真实延迟,这一点论文没有回避,而是通过延迟随机化带来的 5 到 11 个百分点的稳定提升来说明"显式建模延迟"本身是必要的。真机部署里,正是这种延迟量级的误差最容易在接触瞬间集中爆发。
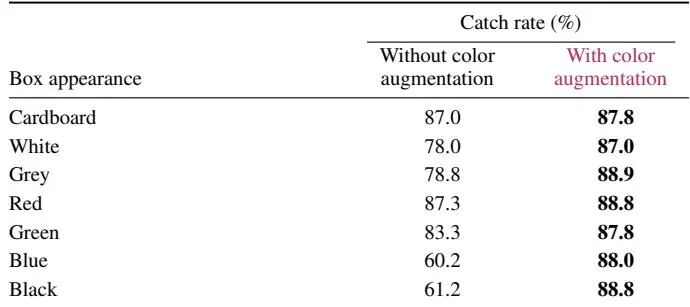
颜色增强的结果也很有信息量。加上增强之后,蓝色和黑色箱子分别被提升到 88.0% 和 88.8%,说明视觉组件对箱子外观确实敏感,而这种敏感性在真实场景里几乎无法通过控制变量来回避。至于时间历史那一项,去掉之后掉 35.6 和 39.8 个百分点,是全篇幅度最大的一次消融,基本可以认定为该方法的硬性依赖。

实验结果

表I:仿真鲁棒性
表I:仿真鲁棒性。接住率与拦截率(百分比),每个控制器一个检查点,每个条件 640 次投掷(检测器条件为 320 次)。在使用同一个检测器的情况下,视觉隐变量控制在其视觉训练范围内超过了"检测加滤波"的基线。
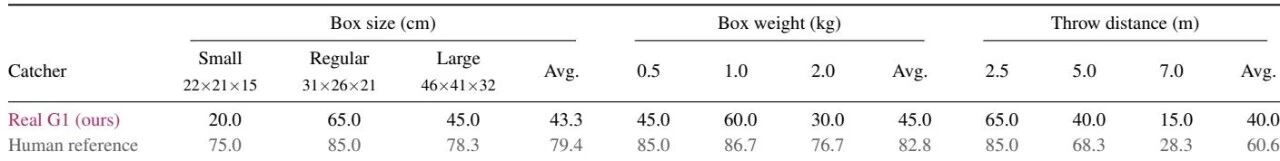
表II:真机接物结果
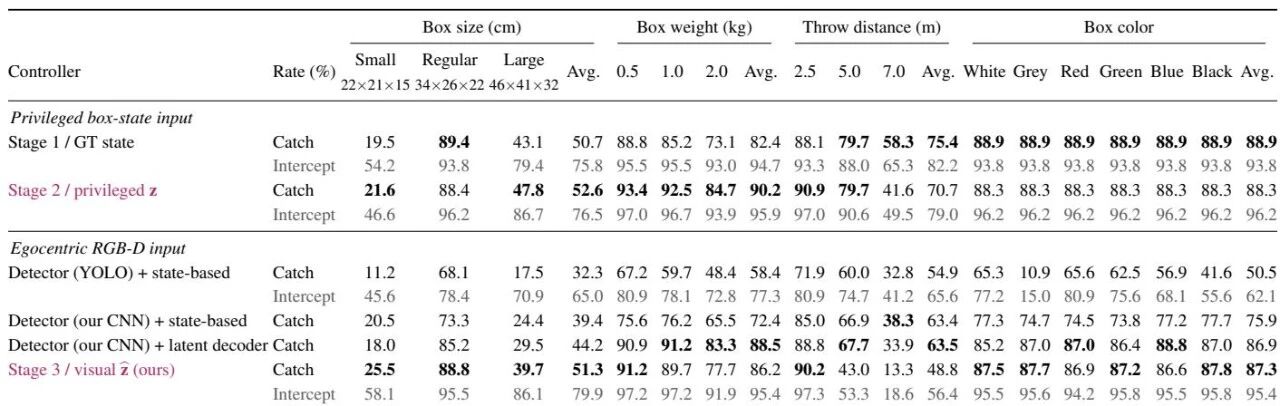
表II:真机接物结果。每个条件在 Unitree G1 上跑 20 次试验,每次只改变一个因素,其余固定在约 2.5 米和常规尺寸箱子上;95% 的 Wilson 区间最宽约正负 20 个百分点(例如 0.5 公斤与 1 公斤:9/20 对 12/20,Fisher 检验 p 值为 0.53)。G1 在 2.5 米和 5 米处分别达到人类成功率的 76% 和 59%,人类数据来自三个人、每个条件 60 次试验。
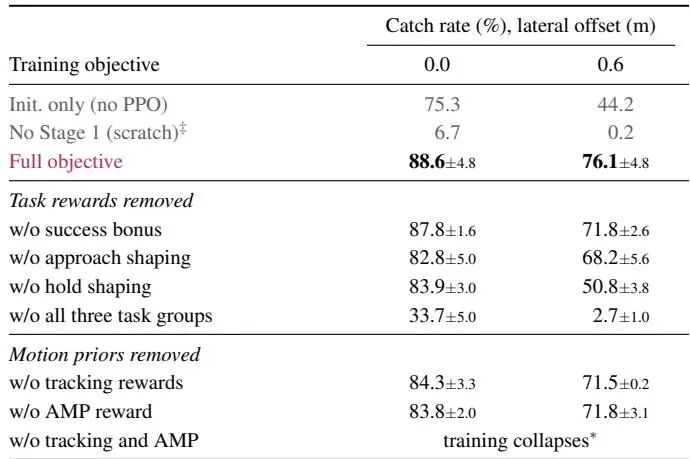
表III:论文补充实验结果表
表III:论文补充实验结果表,对应正文第 V 节的条件基准与消融小节,用于给出单一因素变化下的完整数值。
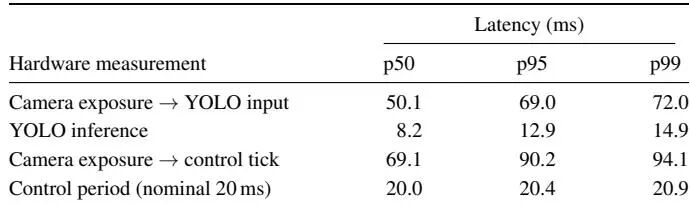
表IV:延迟统计与延迟敏感性
表IV:延迟。上半部分是硬件各环节耗时,下半部分是控制器对不同延迟的敏感性;延迟随机化在每一个测试延迟上都带来了提升。
补充表格:论文附加实验数据
补充表格:论文附加实验数据,用于补充第 V 节中的对比与消融结果。
表V:视觉编码器消融
表V:视觉编码器消融。接住率以五个策略的均值加减标准差给出。去掉时序历史造成的损失最大。
表VI:外观增强效果
表VI:外观增强把蓝色和黑色箱子的接住率提升到 88.0% 和 88.8%。
表VII:第二阶段初始化方式对比
表VII:第二阶段初始化方式对比。接住率以六个控制器的均值加减标准差给出,动作匹配初始化平均高出约 5 个百分点。
图4:不同横向落点偏移下的接物表现
图4:不同横向落点偏移下的接物表现。曲线分别对应真值状态策略参照、YOLO 检测器配状态策略、本文 CNN 检测器配隐变量解码器、特权隐变量输入和视觉隐变量输入。阴影区表示训练覆盖的偏移范围及其尾部。每个点汇总一个策略检查点的 640 次投掷(YOLO 曲线为 320 次)。视觉隐变量输入在 0.6 米和 0.9 米处比真值状态策略高出约 12 个百分点,而 YOLO 检测在每个报告的偏移上都拉低了状态策略的接住率。
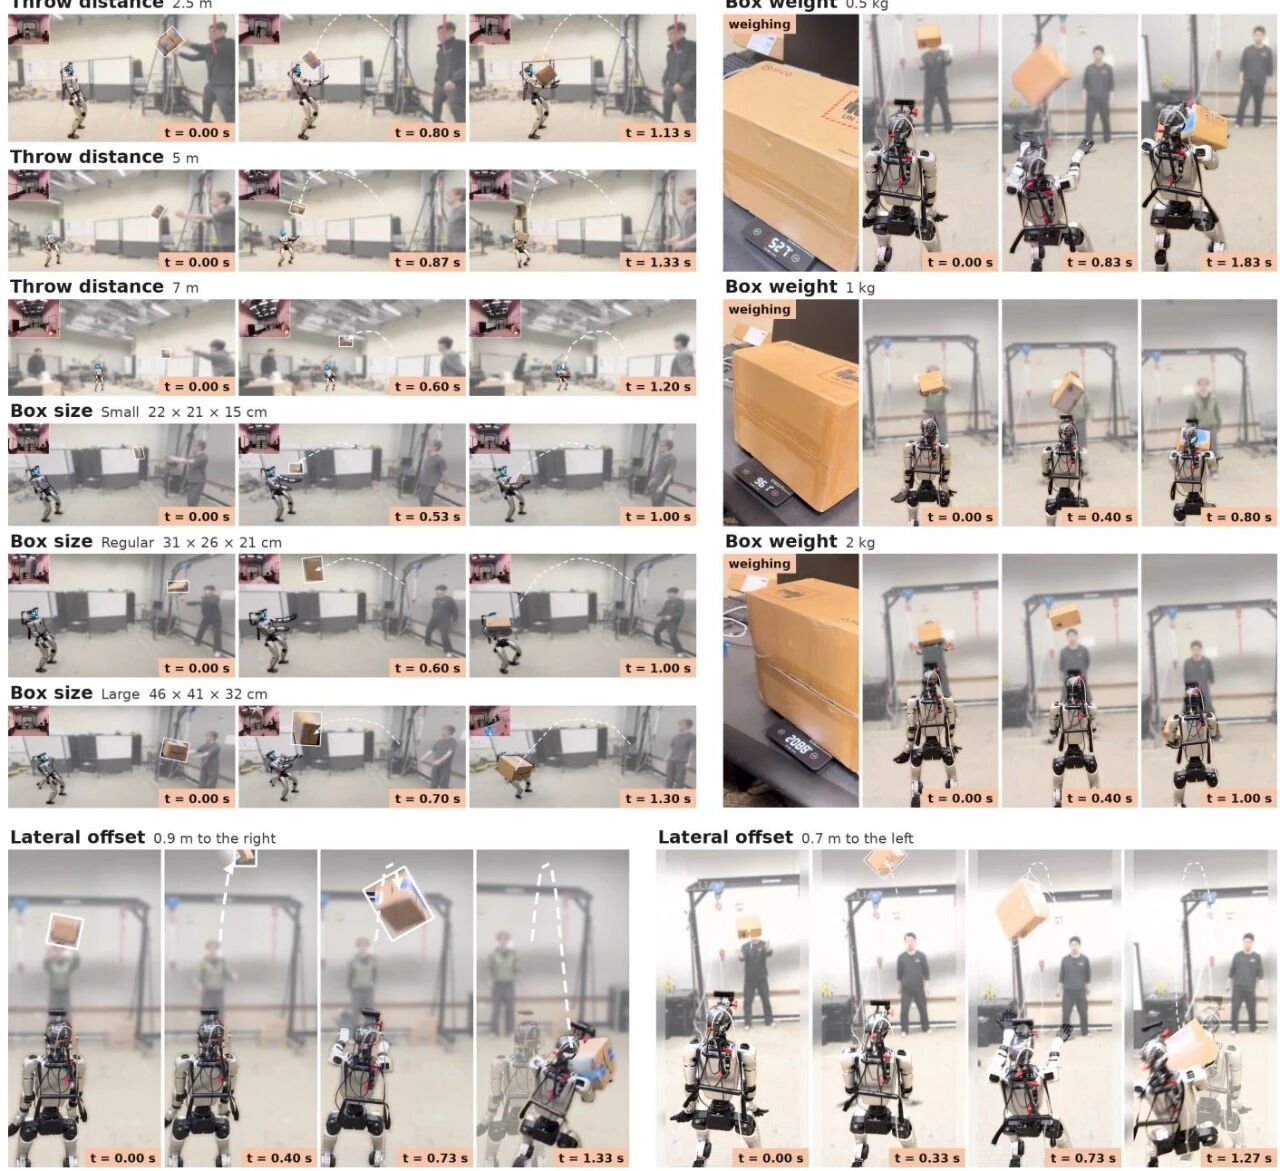
图5:真机在距离、尺寸、载荷与横向偏移下的接物
图5:真机在距离、箱子尺寸、载荷与横向偏移下的接物。左侧是 2.5 米、5 米、7 米距离以及小、常规、大三种箱子(每组各展示释放、接近与接住之后);右侧是 0.5 公斤、1 公斤、2 公斤载荷(小图展示了称重);底部是向右 0.9 米和向左 0.7 米的横向偏移。插图为机载相机视角,时间戳表示每段序列内的耗时,白色轮廓标出箱子位置,虚线表示飞行方向。同一个视觉隐变量控制器在测试的所有距离、箱子尺寸、载荷和横向偏移下都能接住;表II 报告了距离、尺寸与载荷的接住率,第 V 节给出了横向偏移的结果。

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?华盛顿大学等提出Reflex,把全身控制、物体动力学与视觉接地拆成三阶段,用八维隐变量衔接。仿真中自我中心RGB-D接箱成功率85.7%,真机Unitree G1在2.5米达65%,约为人类水平的76%。
这篇工作最值得看的点是什么?仿真中视觉控制达到85.7%接住成功率,特权输入为87.9%;真实Unitree G1在2.5m和5m距离上分别达到65%和40%成功率,为人类接住者成功率的76%和59%;时序视觉历史至关重要,移除后成功率下降35.6和39.8个百分点;颜色增强将蓝/黑箱体成功率从60.2%/61.2%提升至88.0%/88.8%。
这篇工作的边界或风险在哪里?优点在于三阶段解耦设计巧妙,将昂贵的视觉强化学习与运动技能学习分离,使视觉学习可扩展;隐变量接口设计合理,通过动作匹配初始化确保控制接口一致性;在真实人形机器人上验证了视觉反应式全身接物的可行性。缺点在于控制器实际上对箱体尺寸不敏感,小箱体和大箱体成功率显著下降;长距离(5m和7m)视觉接地性能大幅下降;渲染未建模运动模糊和曝光动态;真实机器人试验次数有限,统计置信度不足。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

提出三阶段解耦框架Reflex,将人形机器人视觉反应式全身接物拆分为全身控制(PPO状态策略)、物体动力学(特权编码器学习8维隐变量)和视觉接地(RGB-D历史回归隐变量)三个阶段,通过紧凑的物体动力学隐变量连接,避免端到端视觉强化学习的高。

实验合理度:★★★★☆

接住成功率(catch success)、拦截率(interception)、躯干偏移率(torso excursion)、摔倒率、下游任务累计成功率。

学术研究价值:★★★★☆

提出三阶段解耦框架Reflex,将人形机器人视觉反应式全身接物拆分为全身控制(PPO状态策略)、物体动力学(特权编码器学习8维隐变量)和视觉接地(RGB-D历史回归隐变量)三个阶段,通过紧凑的物体动力。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

Stage 2无渲染PPO约28k环境步/秒(4096环境),Stage 3渲染192×144 RGB-D约1.5k步/秒(320环境);Stage 2 PPO共59M步约35分钟,Stage 3渲染约1.6M步;

复现难度:★★★☆☆

现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:控制器实际上对箱体尺寸不敏感,小箱体和大箱体成功率显著下降;长距离(5m和7m)视觉接地性能大幅下降;渲染未建模运动模糊和曝光动态;


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球