龙哥推荐理由:
这篇论文回答的是缩放定律里最朴素也最要命的一个问题:多加一层,为什么有用?作者的答案有点反常识——在线性注意力里,深度只能按数据谱的幂律慢慢挤性能,很快就见底;注意力一旦带上 softmax 非线性,损失就按约 1/L 的逆幂律继续往下掉。作者还把这件事接到中心极限定理上,把「层间共享误差」和「层间差异」分开算账。这套实验在设计上相当克制,也很讲道理。第一,任务难度是分层的:简单任务让 P 趋向无穷,本质上是检索—复制的理想化版本,可以直接对比单层能力;困难任务改成 top-k 聚合,把"必须组合多个 token 信息"的需求显式引入。第二,数据谱用两个独立指数 a 和 b 参数化,加上每个上下文独立的随机旋转,模型没法靠固定坐标轴偷懒。这种"可控变量 + 独立变化"的做法,比在真实语料上跑一遍再猜原因要干净得多。 拟合策略也值得一提:参数不是直接对损失做最小二乘,而是在对数空间里最小化残差。这么做能让尾部的小损失值也获得足够的权重,避免平台期的点把幂律尾巴"带偏"。拟合出来的指数接近 1,而不是"稍微好一点点",这也是逆深度缩放这个说法站得住脚的原因。 当然,这些结论的适用范围必须被小心界定。所有实验都在受控的 ICL 合成任务上完成,架构也做了大幅简化——位置编码、多头、MLP、层归一化等等都被拿掉了。第 4 节末尾的验证虽然把设置往标准 Transformer 上推了几步,观察到了类似的信号,但只是"信号类似",不等同于机制被完整证明。本文自己也承认,简化架构中识别出的机制,并不保证在完整的大语言模型里同样起主导作用。 关键实验结果
先说线性注意力侧的定量核对。本文测量了简单任务上的深度缩放指数,发现它落在两个参考值之间,与理论预期一致。 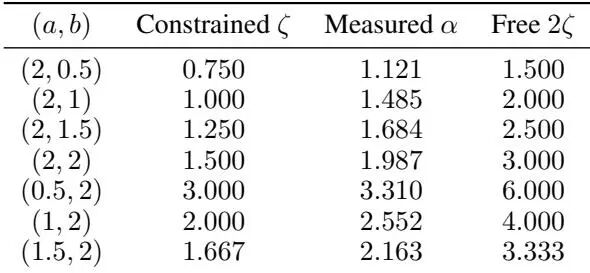
表 2:实测得到的线性注意力模型在简单任务上的深度缩放指数落在两个参考值之间,说明理论框架下的预测与实验测量基本吻合。 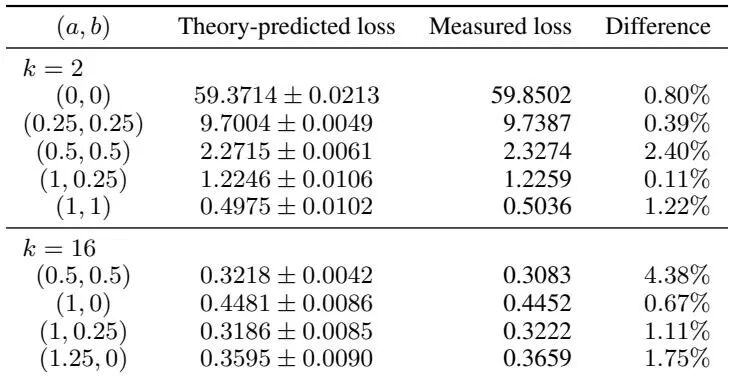
表 3:理论上预测的不可约损失与实际观测到的损失平台非常接近,说明"平台来自共享误差"这个解释并非事后编故事,而是有定量支撑的。 再看推广性。把目标从 top-2 扩到 top-16,把数据谱换成两个指数都非零的设置,拟合出来的深度缩放指数依然接近 1。 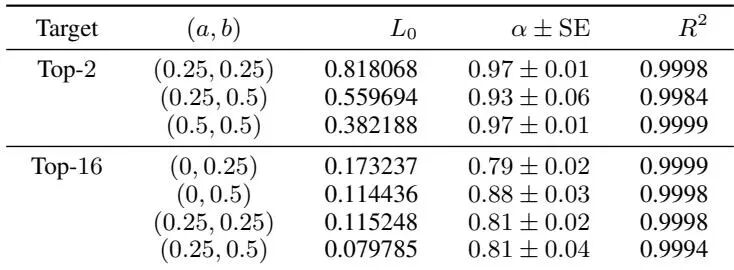
表 4:在更广的目标与数据谱设置下,拟合出的深度缩放指数依然接近 1,说明逆深度缩放并非某个特定配置的巧合。 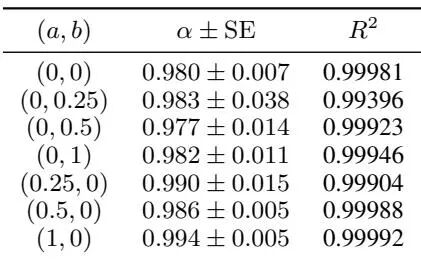
表 5:差值 L_0 − C_L 在拟合区间内随深度近似按反比衰减,这与损失分解中"可约部分按 1/L 缩减"的预测一致。 从合成任务往真实架构靠拢的几步里,第一类是单流模型:输入和标签共用一个表示空间,而不是分两条流。 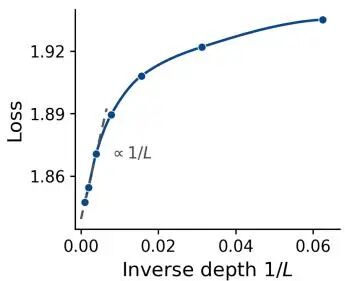
图 9(a):单流非线性注意力模型在各向同性数据谱下的评估结果,同样出现了逆深度缩放的信号。 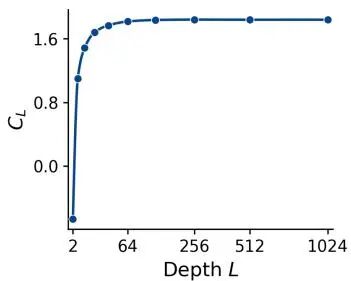
图 9(b):单流模型的共享误差项 C_L 随深度收敛到有限常数。 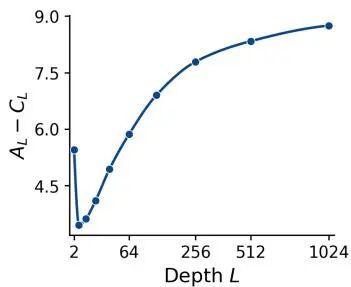
图 9(c):单流模型的差异项 A_L − C_L 同样随深度趋于有限常数。 第二类是把共享的值矩阵解开,允许每一层用自己的值变换。 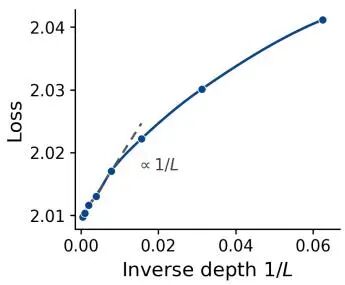
图 10(a):值矩阵逐层独立时,非线性注意力模型在各向同性数据谱下的评估结果,逆深度缩放信号依然存在。 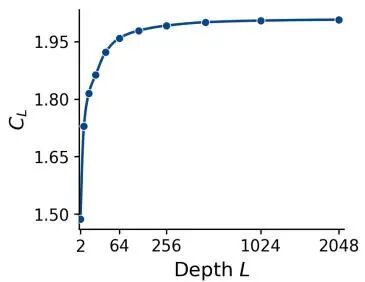
图 10(b):该设置下的共享误差项 C_L 随深度的收敛情况。 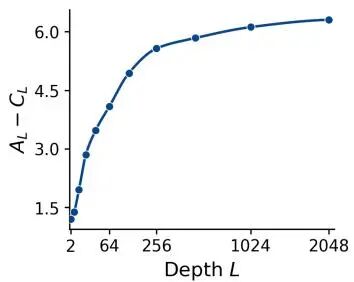
图 10(c):该设置下的差异项 A_L − C_L 随深度的变化趋势。 第三类也是最有意思的一步:把上下文状态也改成逐层更新,看看"逐层细化信息"这件事是不是逆深度缩放的必需品。答案是有条件的。
原论文信息如下:
龙迷三问
龙哥点评
论文创新性分数:★★★★☆
通过对比线性注意力与非线性注意力在受控ICL任务上的深度缩放行为,揭示注意力非线性通过选择性聚焦相关token实现强/弱谱方向并行学习,并借助中心极限定理将深度增益解释为层级预测器集成平均,从而产生逆深度缩放。实验合理度:★★★★☆
评估均方误差R_L,深度缩放指数α(通过拟合R_L = L_0 + cL^{-α}得到),不可约损失下界L_0,以及注意力质量分布(top-1注意力质量)。学术研究价值:★★★★☆
通过对比线性注意力与非线性注意力在受控ICL任务上的深度缩放行为,揭示注意力非线性通过选择性聚焦相关token实现强/弱谱方向并行学习,并借助中心极限定理将深度增益解释为层级预测器集成平均,从而产生逆。稳定性:★★★☆☆
现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。适应性以及泛化能力:★★★☆☆
现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。硬件需求及成本:★★★☆☆
未明确报告FLOPs或具体推理速度。实验在受控的小规模合成数据上进行,隐藏维度N≥d,上下文长度P趋于无穷(理论分析)或有限值(实验),深度L从1到数十层不等。训练直至损失收敛。复现难度:★★★☆☆
现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。产品化成熟度:★★★☆☆
论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。可能的问题:实验局限于合成ICL任务,未在真实LLM上验证;简化架构去除了位置编码、MLP等组件,机制在完整Transformer中的普适性未证实;
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!

还没有公开留言,欢迎留下你的看法。