论文标题:
Sample-Preserving Search-to-Decision Reduction for Noisy Linear Equations over Large Moduli
发表日期:
2026年10月
发表单位:
Shanghai Academy of AI for Science (SAIS)
原文链接: https://arxiv.org/pdf/2610.12913v1.pdf
从搜索到判定:密码学中的等价性问题
要说清楚这篇论文的价值,得先从密码学里一个看似绕口、其实非常朴素的问题讲起:如果你能判断一组数据里有没有藏着秘密,那你能不能把这个秘密直接找出来?论文研究的对象叫噪声线性方程组问题,英文是 Noisy Linear Equations。它的设定可以这样理解:有一个随机矩阵 A,一个未知的秘密向量 x,系统能给出的观测值是 A 乘以 x 之后再被某种噪声函数 R 搅浑过的结果,记作 R(Ax)。在这个框架下有两个任务。
本论文的核心创新在于构造了一个阈值区分器。它的目标不是直接恢复秘密 x,而是回答一个更简单的问题:对于给定的向量 y,内积 ⟨y, x⟩ 在模 q 下的绝对值是否小于等于某个阈值 B?这个问题一旦能回答,就相当于获得了关于秘密的一位信息,而且这个信息可以被反复利用来逐步逼近完整的秘密。构造方法如下:取输入矩阵 A 和噪声观测 R(Ax),然后加上 v yT 这个矩阵,其中 v 是从 {0,1}m 中随机采样的向量。由于 A 本身是随机的,这个操作在分布上等价于把噪声从 R(Ax) 变成 R(Ax - v yTx)。图3:在矩阵 A 上加上 v yT 后,分布等价于在噪声观测上减去 v yTx。这正是阈值区分器得以工作的核心恒等式。如果内积 ⟨y, x⟩ 的绝对值很小,那么 v yTx 就是一个很小的扰动,噪声函数 R 能够吸收它,整体分布仍然接近原来的噪声线性方程分布,此时区分器会倾向于输出「像真实样本」。图4:当内积很小时,加入的扰动被噪声吸收,分布仍然接近原始噪声线性方程组分布。如果内积很大,v yTx 就会压倒噪声,使得观测数据看起来更接近随机,此时区分器会倾向于输出「像随机样本」。论文通过混合论证证明,这样构造出来的算法 P 在条件 |⟨y, x⟩q| ≤ B 和 > B 下的输出概率差至少是 ε 的数量级。图5:阈值区分器的核心不等式。P 在两种条件下的输出概率差至少为 ε 量级,这是后续 Fourier 分析的起点。这里 B 的取值很关键。它不能太大,否则会压倒噪声,使得区分器失效;也不能太小,否则获得的信息量不够。论文定义 B 为满足噪声容忍条件的最大整数,对 LWE 而言 B 约等于 2εσ/√m,对 LWR 而言 B 约等于 εq/p。这个 B 与模数 q 的比值决定了归约的最终复杂度。
Fourier分析:从频谱中提取秘密信息
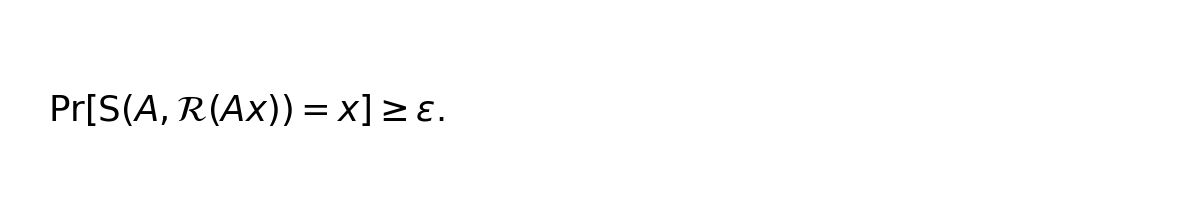
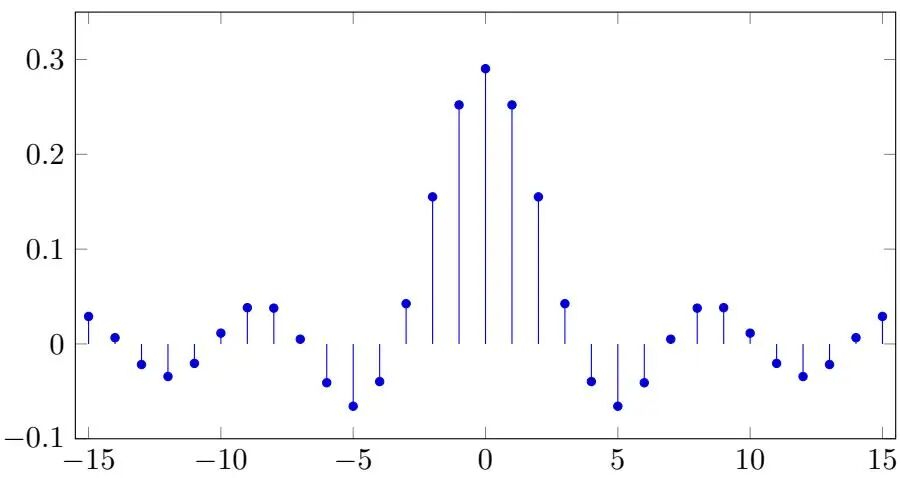
有了阈值区分器 P,下一步的问题是如何从 P 中提取出秘密 x。这里论文采用了 Fourier 分析的工具,思路类似于 Micciancio 和 Mol 以及 Bogdanov 等人的工作:如果 P 与某个阈值函数相关,那么 P 的 Fourier 频谱中就会在特定频率上出现较大的系数,而这些频率恰好编码了秘密 x 的信息。论文引入了一个中间函数 S,定义为当 |⟨y, x⟩q| ≤ B 时取 -1,否则取 1。这个函数是秘密 x 的直接函数,它的 Fourier 变换只在 x 的倍数处有非零系数。图6:阈值函数 S 的定义。当内积的绝对值不超过 B 时输出 1,否则输出 -1。这个函数的 Fourier 频谱集中在秘密 x 倍数对应的频率上。论文证明 P 和 S 的协方差有一个下界,这个下界与 B、ε、q 有关。图7:P 和 S 的协方差下界。μP 和 μS 分别是 P 和 S 的期望值,这个不等式说明 P 必须在 S 的某个重 Fourier 系数上有不可忽略的权重。由于 S 的 Fourier 频谱只在 x 的倍数处有值,P 的频谱中就必然在某个 c·x 处有一个较大的系数。这个系数的大小至少是 ε 的对数倒数级别,具体形式如下所示。图8:P 在某一个 c·x 频率上的 Fourier 系数下界。这个下界虽然不大,但足以被 Akavia-Goldwasser-Safra 的算法在多项式时间内找到。Akavia-Goldwasser-Safra 算法是 2003 年提出的用于学习重 Fourier 系数的经典算法,它可以在多项式时间内找出函数频谱中所有系数较大的频率。论文利用这个算法从 P 的频谱中恢复出一个列表,列表中包含 c·x 这个向量,其中 c 是一个较小的整数。如果 q 是素数,或者 c 与 q 互素,那么通过遍历列表中的元素和可能的 c,就可以恢复出真正的秘密 x。如果 q 是合数且 c 与 q 不互素,那么恢复出的只是秘密的一个倍数,这是所有参数保持归约的一个固有限制。图9:当 q=31、B=4 时函数 f 的 Fourier 频谱。可以看到在 c·x 对应的频率上出现了明显的尖峰,这正是算法能够定位秘密 x 倍数的基础。整个归约的执行流程可以这样理解:首先用判定器构造阈值区分器 P,然后通过 Fourier 分析证明 P 在 c·x 处有重系数,接着用 AGS 算法恢复出包含 c·x 的列表,最后通过遍历和验证恢复秘密 x。整个过程只需要多项式数量的样本和多项式时间的计算。
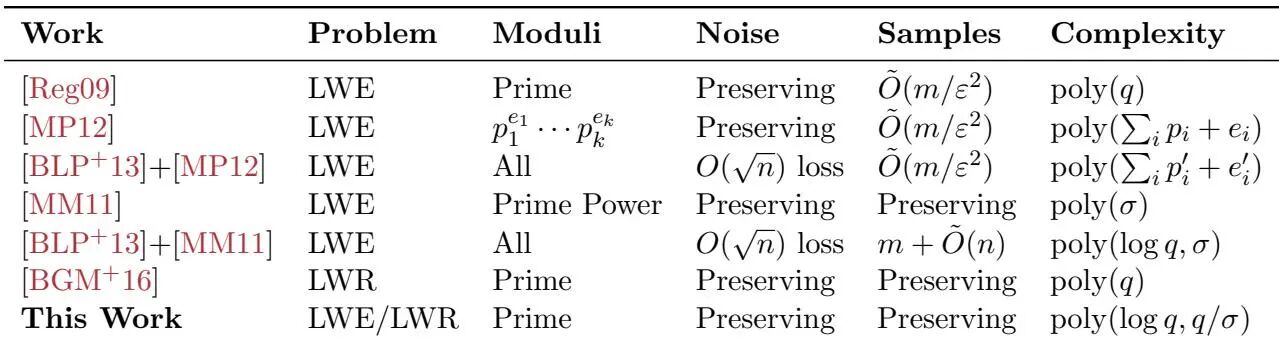
下面是龙哥对于大家可能的一些问题的解答:这篇论文到底在解决什么问题?该论文为噪声线性方程组提出样本保持的搜索到判定归约,复杂度仅随噪声与模数之比增长;模数指数级增大时仍为多项式时间,并覆盖LWE与LWR。这篇工作最值得看的点是什么?本文为纯理论工作,通过严格的数学证明展示了归约的正确性。主要结果包括:对于素数模数q,LWE和LWR的搜索到判定归约保持秘密维度n、样本数m、模数q和噪声幅度σ不变,运行时间为poly(n, m, log q, q/σ),即使模数q指数级大,只要噪声模数比σ/q不可忽略,归约仍多项式时间运行。对于合数模数,输出包含秘密向量小倍数的候选列表。这篇工作的边界或风险在哪里?优点:首次实现了复杂度仅依赖于噪声与模数之比而非模数或噪声绝对大小的保样本搜索到判定归约;适用于素数模数和无小素数因子的合数模数;对于LWE和LWR均适用;理论证明严谨完整。缺点:对于一般合数模数只能恢复秘密的倍数而非精确秘密;当噪声幅度既为ω(poly(n))又为o(q/poly(n))时,算法运行时间不是poly(n);需要噪声函数满足B-平滑性条件。如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~
Andrej Bogdanov, Kel Zin Tan, Prashant Nalini Vasudevan. Sample-Preserving Search-to-Decision Reduction for Noisy Linear Equations over Large Moduli. arXiv:2610.12913, 2026. https://arxiv.org/pdf/2610.12913v1.pdfO. Regev. On lattices, learning with errors, random linear codes, and cryptography. STOC 2005 / JACM 2009.D. Micciancio, P. Mol. Pseudorandom Knapsacks and the Sample Complexity of LWE Search-to-Decision Reductions. CRYPTO 2011.A. Akavia, S. Goldwasser, S. Safra. Proving Hard-Core Predicates Using List Decoding. FOCS 2003.
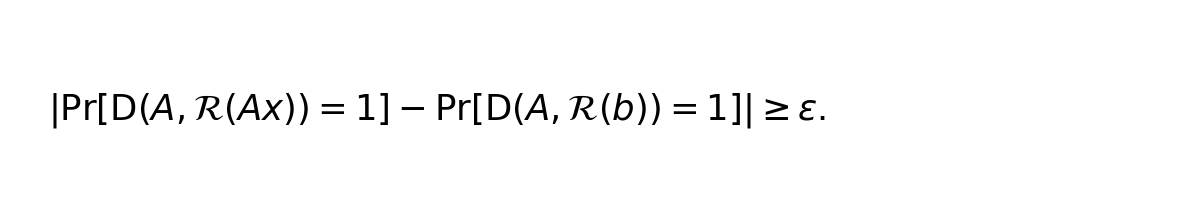
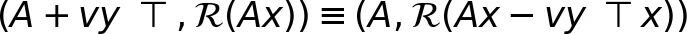
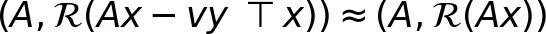
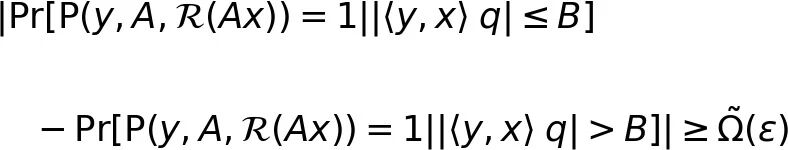
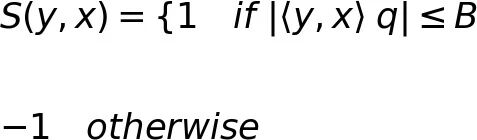
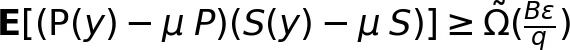
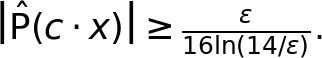
还没有公开留言,欢迎留下你的看法。