过去两年,AI 把写代码这件事改得面目全非:补全、修 bug、写单测、审 PR,一条流水线几乎被智能体摸了个遍。但有一件事几乎没人碰——架构文档。Hou 等人做过一项梳理(AI for Software Engineering,简称 AI4SE,即面向软件工程的 AI 研究),结论相当扎心:绝大多数工作瞄准的是代码生成与软件测试,真正针对软件设计与软件架构的少之又少。这个不对称其实很好解释。代码能编译就是能编译,编译不过就是过不去,对错有硬反馈,智能体可以在里面反复试错。架构制品不一样,它是沟通性的,而且部分主观:业务意图在架构设计阶段就掺进来了,而这些意图又会变成后续阶段必须继承的约束。换句话说,代码的对错有编译器兜底,架构文档的对错只能靠人吵出来。 比"没人写"更麻烦的是"写了也会烂"。van Heesch 和 Avgeriou 提出过一个说法叫架构知识蒸发(architectural knowledge vaporization):一个设计背后的理由、被否决的备选方案、当时做的权衡取舍,恰恰是架构知识里被记录得最少的一类。系统一演化、设计师一换岗,这些内容就蒸发了;剩下的记录与正在运行的系统越走越远,还散落在 wiki、文件共享目录和各个仓库里。 架构即代码(Architecture as Code,简称 AaC)解决了其中一部分:把图和规格说明当成纯文本源码纳入版本控制,架构就能被评审、能被 diff、还能被机器读取。Bucaioni 等人特别强调,AaC 不只是"用文本工具画图",而是把源码开发的那套纪律搬到架构制品上。但请注意,AaC 解决的是存储和版本化,不是维护问题。一个装满 PlantUML(一类用纯文本描述 UML 图的工具)源文件的仓库不会自己更新,不会主动报告漂移,更不会自己把设计理由补上去。 为了先搞清真实痛点,作者在 2025 年 10 月到 12 月间,与 6 位产品负责人和 4 位架构师做了非结构化交流(n = 10)。这轮交流是探索性的,没指南、没录音、没编码流程,只用来发现问题,不能当作证据。反复出现的痛点有五类:维护成本高、可查找性差且内容碎片化、模板不一致、信任赤字,以及交接时上下文丢失。 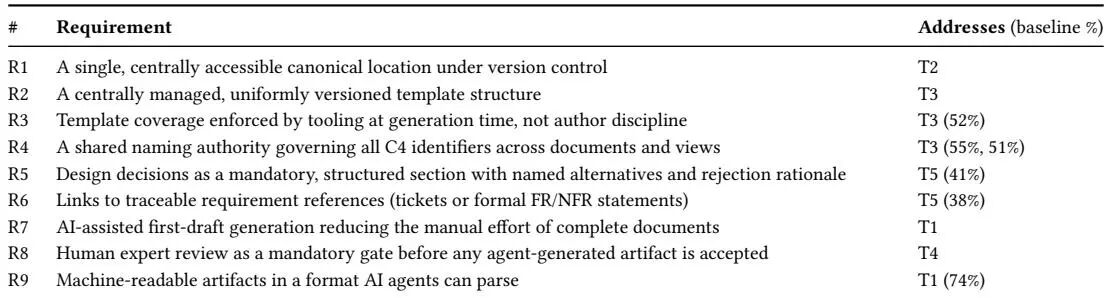
表1:流程制品的设计需求及其对应的痛点。括号内数字为队列 A 在相关量表子项上的均值(占满分百分比)。 这九条需求(R1 到 R9)里,有几条特别有意思:模板覆盖必须由工具在生成时强制,而不是靠作者自觉;决策必须以结构化章节出现,还要带上被否决的备选方案和理由;而且人工评审必须是任何智能体产物被接受前的强制关卡。看到这里,这套东西的野心就很清楚了——它不打算让 AI 替你拍板,它想让 AI 替你把草稿先写出来。 
A-SAW三层架构:制品层、智能体编排层与人工评审层如何协作
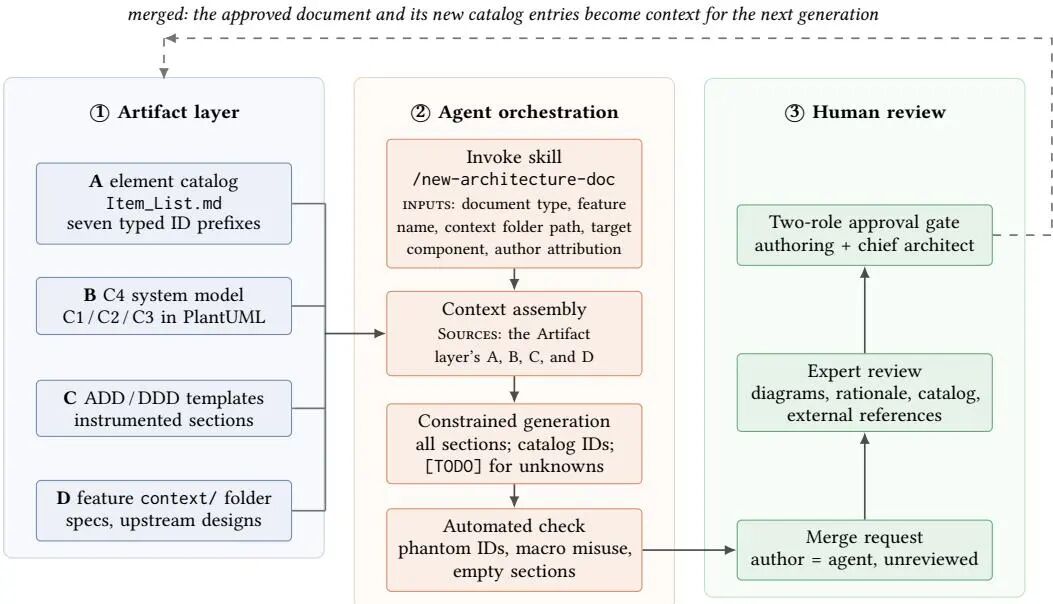
图1:A-SAW 总览。制品层是受版本控制的架构仓库;智能体编排层按需读取它,并产出一份结构完整的第一稿;人工评审层是一道没有任何草稿可以绕过的强制关卡。通过评审的输出重新回到制品层,因此下一代生成可用的上下文是单调增长的。 本文提出的方法叫 A-SAW(Agentic Software Architecture Workflow,智能体软件架构工作流)。论文把它定位成一个"流程级制品":在 AaC 之上,往制品库与人类评审者之间插进一层常驻的智能体。整个结构分三层,彼此咬合得挺紧。 制品层(Artifact Layer)存放受版本控制、机器可读的 C4 模型与设计文档。C4 模型指的是 Context、Container、Component、Code 四层递进抽象(分别对应上下文、容器、组件、代码),它的上层相对稳定,很适合当作长期有效的系统模型。真正有意思的是那份类型化元素目录(typed element catalog):它充当所有视图共用的命名契约——同一个组件,在任何一张图、任何一份文档里只能有一个名字。 智能体编排层(Agent Orchestration Layer)从元素目录、系统模型、插桩模板(instrumented templates,指带有生成规则与占位约束的模板)以及按特性划分的上下文目录里组装上下文,产出一份结构完整的第一稿。注意"结构完整"这四个字:它保证的是骨架不缺章节,并不保证内容都对。这个智能体是集成在 IDE(Integrated Development Environment,集成开发环境)里的。 人工评审层(Human Review Layer)负责审批每一份草稿。批准后的产物重新回到制品层,于是下一次生成可用的上下文是单调增长的——用得越久,智能体手里的底料越多。这一点很关键,它把"AI 辅助"从一次性调用变成了会自我积累的流程资产。 论文产出的是架构设计文档(Architecture Design Document,ADD)和详细设计文档(Detailed Design Document,DDD),而不是 Tyree 和 Akerman 意义上的、一条决策一条记录的架构决策记录(Architecture Decision Record,ADR)。ADD 描述的是某个特性的结构,并把决策连同备选方案与否决理由嵌在专门章节里。用 ISO/IEC/IEEE 42010 架构描述标准的术语说,这套工作流产出并维护的是一份由多个视图组成的架构描述,元素目录扮演的正是其中的对应规则(correspondence rules)。 这套东西是"智能体化的",但刻意不是"自主的"。按 Parasuraman 等人的自动化等级量表,它在信息获取和分析上自动化程度很高,在决策选择与动作执行上又压得很低,大约停在十点量表的第 4 级——"计算机给出一个备选方案",由人接受、修改或者否决。保留这个决策点,正是他们推荐的那种"最后一次纠错机会"机制。就单次生成而言,它是一次边界清晰的调用;真正的智能体属性体现在它是组织设计循环里的常驻参与者,而不是某次调用有多花哨。 五重防线约束AI幻觉:从元素目录到双角色审批门
论文专门造了个词叫架构幻觉(architectural hallucination):一个内部看起来完全说得通、但与真实系统对不上的设计。这种错误比"胡言乱语"更危险,因为它读起来非常像一个正经设计。 对付它,这篇论文没有靠"提示词祈祷",而是用结构约束。第一道防线是元素引用必须落在元素目录上(catalog-grounded element references):文档里提到的每个组件、每个接口,都必须能在目录里找到实体,编不出来。第二道是上下文目录收窄(context-folder scoping):生成某个特性文档时,只把跟这个特性相关的材料喂进去,让智能体没机会跑到无关模块上去"发挥"。 第三道防线大概是整套流程里最朴素也最狠的一条:信息缺口显式标注(explicit gap marking),而不是拿一段听起来很顺的漂亮话填上。在人写文档时,"这里我不知道"是可以接受的;在 AI 写文档时,默认行为却是把空白填满。把"不知道"变回一个合法的输出,幻觉的空间就小了一大截。第四道是自动检查幽灵标识符与宏误用(phantom identifiers and macro misuse),也就是引用了根本不存在的元素、或者把模板宏用错位置。第五道是双角色审批门(two-role approval gate),任何草稿都绕不过去。 这套设计其实回答了一个很常见的争论:AI 写文档到底靠不靠谱?论文给的答案不是"靠不靠谱",而是"取决于你有没有把不确定性约束在流程里"。它承认模型会犯幻觉,然后用目录、范围、缺口标注和自动检查把它挤到流程之外,最后再留一道人工关卡。像个筛子,一层一层往下漏。 45份文档+13位从业者的工业级验证:质量提升31分、方差缩小5倍
论文的验证场景是一家大型工业软件产品组织。这家公司在研究开始前大约 18 个月就把 C4 模型定成了架构可视化标准,当时正从基于仓库的建模工具迁向 PlantUML 文本定义。研究期间大约有 15 位架构师和资深开发参与设计工作。研究方法走的是设计科学研究(Design Science Research,DSR)路线:造一个真实制品,部署它,然后在真实使用中评估,而不是在实验室里造对照条件。设计经过三轮精化迭代后才进入总结性测量,评估是自然情境下的(naturalistic),基于一个组织里的真实用户。 45 份架构文档被分成三个队列。队列 A 是引入工具前的人工撰写(n = 19),队列 B 是部分采用 AaC(n = 13),队列 C 是智能体生成(n = 13)。评分量表把 Clements 等人提出的四条描述属性——描述完整性、视图间内部一致性、与需求挂钩的设计理由记录、对目标读者的可用性——操作化成具体维度,再补上机器可读性与可追溯性等子项。 更讲究的是实验设计。论文用了一个匹配对(matched pairs)结构:13 份智能体文档各自重新生成一份指定的人工撰写源文档,也就是同一份内容的"人类版"和"智能体版"能一对一做比较。这样一来,"智能体是不是比人写得好"就不再是个主观印象,而是一个可以用配对检验去问的问题。 先看稳定性。文档总分的标准差从队列 A 的 19.2 掉到队列 C 的 3.8,比值 5.0,95% 置信区间为 [2.9, 9.2]。也就是说,同一个流程下产出的文档,质量从"看人下菜"变成了"基本一个水平"。因为接近满分的维度本身没有多少变异空间,论文又专门看了离满分最远的可追溯性:它的标准差同样从 22.9 降到 7.4。 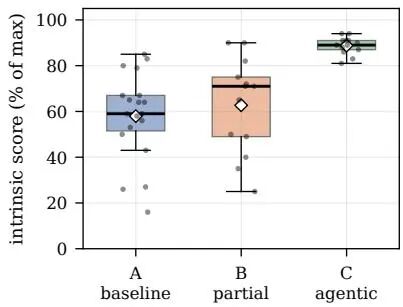
图2(a):按队列划分的文档质量分布。箱体表示中位数与四分位距,须表示 1.5 倍四分位距范围,白色菱形为均值,黑点为单份文档。 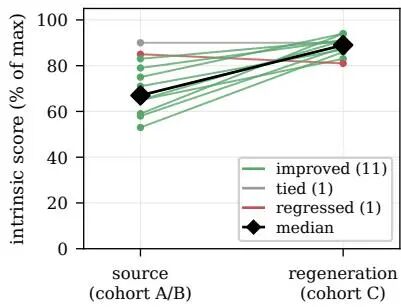
图2(b):13 对匹配文档。图中每条线是一份文档,由指定的队列 A/B 源文档重新生成而来;黑色菱形标出各组中位数(67 → 89)。 再看质量本身。13 对匹配文档的中位数提升了 +19 分(p = 0.001,匹配对秩双列相关 r = +0.97,属于很强的效应量)。两个队列的均值分别是 58% 和 89%,这 31 分的区间从上方框住了智能体到底贡献了多少——论文的措辞很克制,它说的是"框住",而不是"这就是智能体的功劳",因为模板、元素目录和更丰富的重生成上下文都在里面出力。 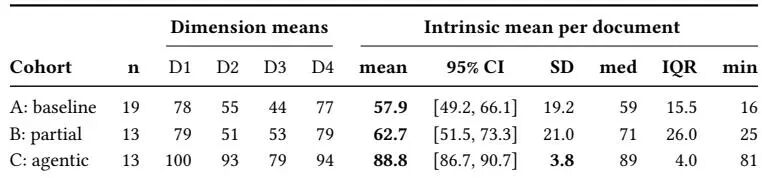
表2:各队列的内在质量——各维度均值以及每份文档内在均值的分布(占满分百分比)。置信区间为 10,000 次重采样得到的百分位自助法区间。 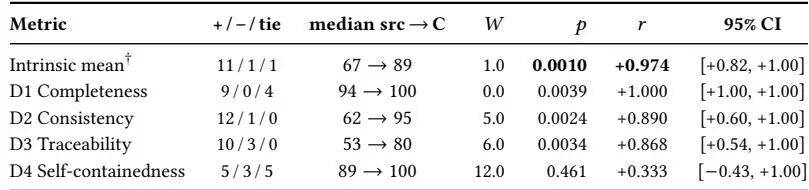
表3:13 对"源文档→重生成"文档的配对 Wilcoxon 符号秩检验结果。效应量为匹配对秩双列相关及其自助法 95% 置信区间。† 为预先指定的主检验;各维度行属于探索性分析,除 D4 外全部通过 Holm 校正(α = 0.05)。 在智能体生成的文档里,完整性达到 100%、一致性 93%、机器可读性 99%,都达到或者逼近量表上限;可追溯性只有 79%,是唯一明显掉队的维度。这个分布很像一个"结构性任务"的特征:能被模板和目录管住的东西,AI 做得又快又好;需要连回外部信息的东西,AI 帮不上太多。 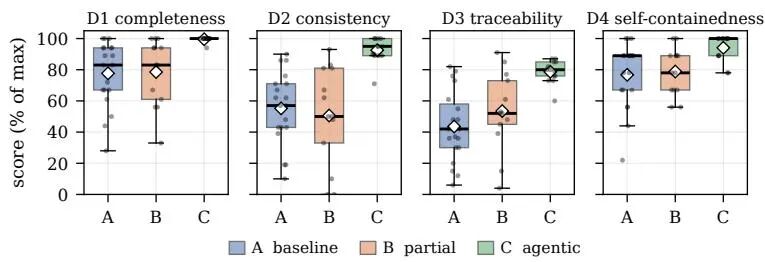
图3:三个队列在各维度上的内在质量分布。编码方式同图2,箱体表示中位数与四分位距,须表示 1.5 倍四分位距范围,白色菱形为均值,黑点为单份文档。 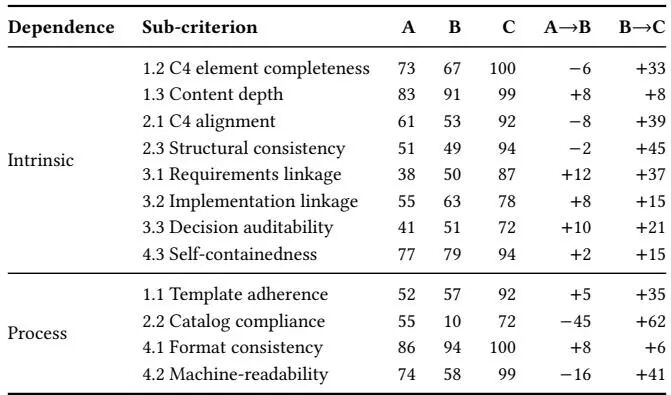
表4:各子项在三个队列间的变化轨迹(占满分百分比)。 为什么有效?本文的判断是三条机制在起作用。模板在生成时被工具强制覆盖,文档结构不再依赖作者自觉;元素目录统一了命名,跨文档跨视图的漂移被从源头掐掉;上下文按特性收窄,智能体不容易跑到无关模块上编故事。而可追溯性掉队也合理——它要求把文档描述连回具体需求条目(工单,或者正式的 FR/NFR 陈述,即功能需求与非功能需求),而这些信息往往根本不在仓库里,智能体再强也变不出来。 还有一个细节值得拎出来说:队列 A 里,架构文档和详细设计文档之间存在 19 分的差距,这在队列 C 里没有再出现。智能体不只是把低分文档拉高,它还把"文档类型之间的落差"一并抹平了。这其实是方差收缩这条结论的另一种表现——流程产出变得齐整,读者因此可以在读之前就预判文档的结构覆盖度。 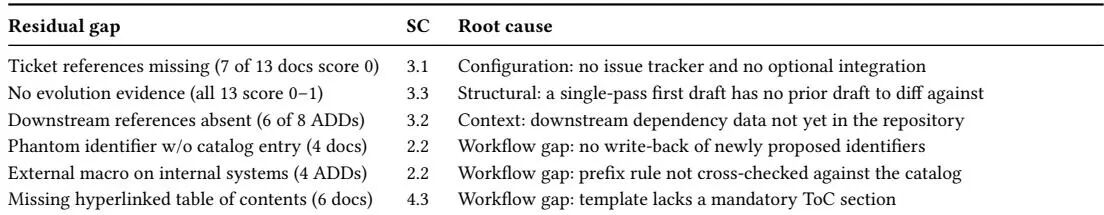
表5:队列 C 残留质量缺口的根因分类。SC 指子项(Sub-criterion)。 论文没有止步于"平均分涨了多少",而是把队列 C 剩下没拿到的分逐项找了根因。这一点在流程类论文里并不多见:多数工作只报告自己赢了多少,很少解释"到底输在哪里"。而恰恰是这些残留缺口,划出了智能体在架构文档这件事上的能力边界。 质量与信任的背离:为什么评分接近满分,工程师却不敢用?
如果只看到上面那批数字,结论大概是"AI 写架构文档已经赢了"。但论文还有另一半:13 位从业者每人做了一次 30 分钟的上手重生成任务,随后接受访谈(2026 年 6 月)。他们反馈说,第一稿的投入从"几天"压到了"几分钟",设计理由也比过去好找。听起来是大获全胜。 然后访谈结果给出一记闷棍:没有任何一位受访者对刚刚亲眼看着生成出来的图表达无条件信任。13 人里有 11 人坚持人工评审必须保留。更微妙的是,他们的工作重心从"撰写"移到了"验证"——省下来的时间并没有消失,只是换了个地方花。 信任是有条件的,条件还挺具体。第一,取决于智能体需要在仓库已有数据之外推断多少:推断越多,信任越低。第二,取决于他们之前见过多少次可靠的生成结果——这东西是靠积累的,看一次漂亮输出建立不起来。第三,还要看记录下来的设计本身是否站得住:文档结构完整,不代表里面的设计决策是对的。 论文还记录了一个反向风险,读起来很有画面感:输出太"精致",反而可能让评审者放松警惕甚至跳过评审。一位受访者明确提出了这个担心。这大概是所有 AI 辅助文档工具都要面对的尴尬——幻觉不一定骗过你,但它可能让你懒得看。 最终结论很克制,也很重要:完整性、一致性、机器可读性这些结构性指标可以做到接近满分,但它们不是信任的同义词。评分量表没有测量推断量、历史可靠性、设计合理性中的任何一条,所以结构分高本身,并不能说明一份文档可以被信任。这篇论文最有分量的东西可能不是那 5 倍的方差收缩,而是这句"分数和信任会分家"。 设计原则与未来展望:智能体辅助架构文档的边界在哪里?
论文把能力边界划得很清楚:完整性、一致性、机器可读性已经在"仓库打底"的智能体能力范围内;需求可追溯性和决策可审计性依然依赖人。这是一条相当实用的分工线——凡是从仓库里能读出来的,交给智能体;凡是需要跳出仓库去判断的,留给人。 由此还引出几条可迁移的设计原则,其中最关键的一条是:人工评审必须保留,而且要把评审精力集中到智能体必须"超出仓库去推断"的位置。把评审均匀撒在所有内容上,等于浪费人力;只盯住推断密集的地方,才划算。这个思路其实可以往很多 AI 辅助场景上搬——问题不是"要不要人审",而是"审在哪里"。 论文自己承认的局限也需要说清楚。第一,这是单次会话设计,长期使用下信任会不会收敛到测量质量,它回答不了。第二,评估在一个组织内自然进行,场景与样本都有限。第三,第一作者在研究中身兼双重角色——既是构建制品的实践者,又是收集和分析评估数据的研究者,这是工业界行动研究式 DSR 的典型特征:优点是能拿到真实数据和默会上下文,风险是容易按自己的标准设计、按自己的偏好读证据。论文用三条措施来缓解:访谈结论与独立的量表测量做三角验证、流程标准化,以及从访谈池里剔除三类人(研究者本人、设计参与度超出正常范围的公司侧主管、以及上手任务所用文档的原始作者,后者能从记忆里复原文档而不是真正从制品里读出来)。 值得继续追的问题有三个:如果团队连续用半年、一年,信任会不会追上评分?会不会出现"评审疲劳",让强制评审门形同虚设?以及当系统演化到仓库里读不出来的部分越来越多时,这套方法的增益还剩多少?这三个问题单次会话实验都答不了,但它们恰恰是这套工作流真正上线后必须面对的。😏 龙迷三问
下面是龙哥对于大家可能的一些问题的解答: 这篇论文到底在解决什么问题?AI辅助软件工程扎堆写代码,架构文档维护却少人问津。列支敦士登大学等提出A-SAW:智能体基于版本控制的C4模型与元素目录生成文档首稿,人工评审必经。45份文档实测,质量中位数涨19分,方差从19.2压到3.8。 这篇工作最值得看的点是什么?在45份架构文档的三队列评估中,智能体生成队列(Cohort C)的文档内在质量均值达到89%,相比人工撰写基线(Cohort A)的58%提升31个百分点;13对匹配源→再生成配对中,中位数从67%提升至89%,中位提升19个百分点(p=0.001, r=+0.97);文档间标准差从19.2降至3.8(比值5.0),质量一致性大幅提升;完整性达100%、一致性93%、机器可读性99%,但可追溯性仅79%仍为最低维度; 这篇工作的边界或风险在哪里?优点在于提出了完整的三层架构文档维护工作流,将智能体生成与强制人工评审有机结合,通过元素目录、上下文限定、显式缺口标记、自动化校验和双角色审批五重机制约束幻觉;在真实工业环境中进行了大规模评估,包含45份文档和13位从业者访谈,实验设计严谨,匹配配对设计有效控制混淆变量。缺点在于可追溯性维度仍依赖外部系统集成,决策审计性受限于单次生成无法提供演化证据,评估中LLM评分可能存在偏差,且Cohort C为受控再生成而非自然产生,生态效度有限。 如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~ 龙哥点评
论文创新性分数:★★★★☆
提出A-SAW(智能体软件架构工作流),在Architecture as Code基础上引入持久化智能体层,通过元素目录、模板化生成、上下文文件夹限定、自动化校验和强制人工评审门,实现架构设计文档的智能体辅助首稿生成与人工验证闭环。实验合理度:★★★☆☆
现有材料未完整覆盖数据划分、基线公平性和统计显著性,因此按中性评价处理。学术研究价值:★★★★☆
提出A-SAW(智能体软件架构工作流),在Architecture as Code基础上引入持久化智能体层,通过元素目录、模板化生成、上下文文件夹限定、自动化校验和强制人工评审门,实现架构设计文档的智。稳定性:★★★☆☆
现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。适应性以及泛化能力:★★★☆☆
现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。硬件需求及成本:★★★☆☆
现有材料缺少完整训练资源、参数量、显存和推理时延信息,成本暂按中性评价。复现难度:★★★☆☆
现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。产品化成熟度:★★★☆☆
论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。可能的问题:现有材料尚未充分覆盖分布外泛化、部署成本、长期稳定性和失败案例。
主要参考文献
Finn Klatt, Luca Di Grazia, Johannes Schneider. A-SAW: The Agentic Software Architecture Workflow. arXiv:2610.13647v1. https://arxiv.org/pdf/2610.13647v1.pdf P. Clements et al. 软件架构文档化(views-based framework):描述完整性、内部一致性、设计理由记录与可用性四条属性 A. Bucaioni et al. Architecture as Code:定义、愿景与开放挑战(漂移最小化与一致性保障) van Heesch, Avgeriou. 架构知识蒸发(architectural knowledge vaporization) Hou et al. 面向软件工程的 AI 研究分布调研(AI4SE) Parasuraman et al. 自动化等级量表(levels-of-automation) Esposito et al. 生成式 AI 在软件架构中的验证缺失与幻觉挑战 ISO/IEC/IEEE 42010. 系统与软件工程——架构描述(architecture description)标准
代码里那点事,AI早就包圆了;文档里那点心酸,还得自己扛 🤚。与其一个人对着半年前的架构图发呆,不如来群里把架构师的吐槽摊开聊。欢迎加入龙哥读论文粉丝群,扫描下方二维码或者添加龙哥助手微信号加群:kangjinlonghelper。一定要备注:研究方向+地点+学校/公司+昵称(如 软件架构+上海+XX公司+龙哥),根据格式备注,可更快被通过且邀请进群。
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!
还没有公开留言,欢迎留下你的看法。