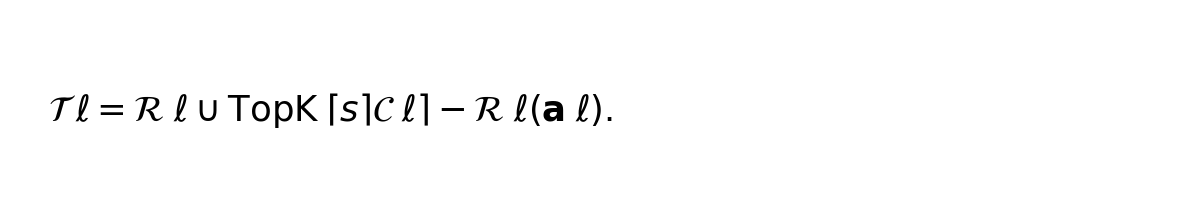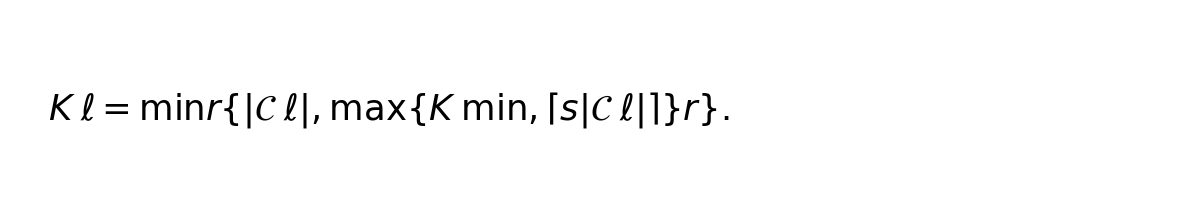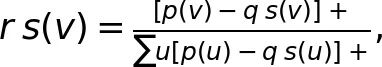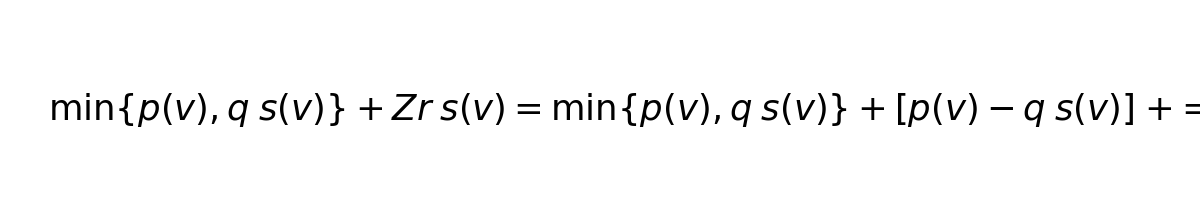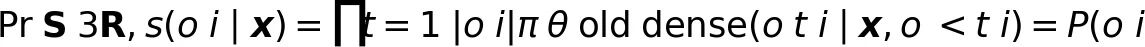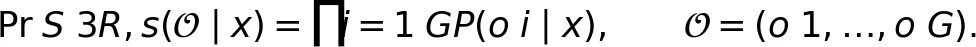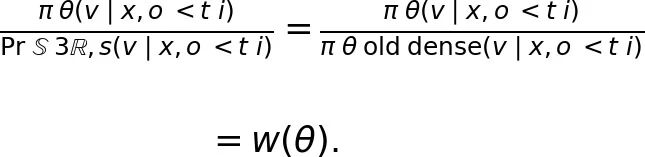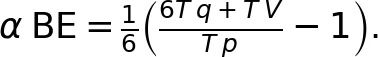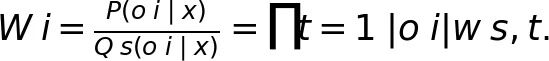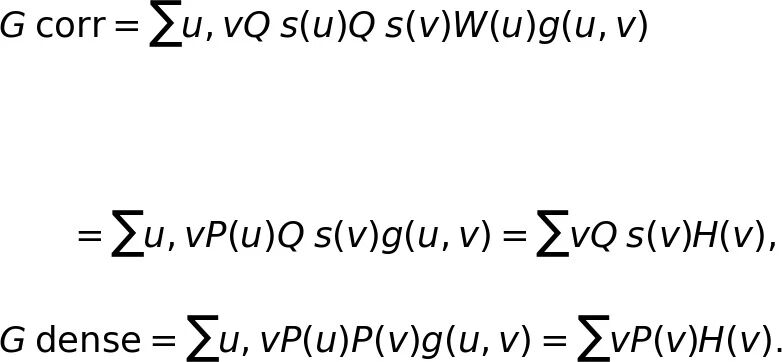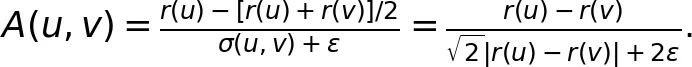
← 返回 PaperDaily 大模型与智能体

港科大(广州)S3R:稀疏起草+稠密验证,RL训练吞吐1.39倍

大模型做强化学习,真正的瓶颈常常不在反向传播,而在 rollout 生成——注意力吃掉了七成以上的解码时间。港科大(广州)这篇 S3R 的做法挺取巧:稀疏注意力只负责"提词",全注意力负责严格验收,采样分布不动,KV 读取却大幅减少。Qwen3-1.7B 上端到端训练吞吐做到 1.39 倍,训练还更稳。

港科大(广州)S3R:稀疏起草+稠密验证,RL训练吞吐1.39倍

paperdaily_reaction_gif


原论文信息如下:
论文标题:
S3R: Fast and Faithful RL Rollouts via Self-Sparse Speculative Decoding
发表日期:
2026年10月
发表单位:
香港科技大学(广州)
原文链接:
https://arxiv.org/pdf/2610.13202v1.pdf

RL训练太慢?稀疏注意力+推测解码来救场

大模型做完预训练之后,重头戏基本都落在后训练上。其中一条越来越主流的路线是 RLVR(Reinforcement Learning with Verifiable Rewards,可验证奖励的强化学习):数学、代码这类任务的答案对错可以用规则直接判,不需要再单独训一个奖励模型。算法侧常被提起的是 GRPO(Group Relative Policy Optimization,组相对策略优化),做法是对同一个问题采样一组回答,用组内相对分数算优势,再更新策略。
听上去很干净,但真跑过一轮的人都有同一个感受:整条训练流水线里最慢的环节往往不是反向传播,而是 rollout——也就是让策略模型把长回答一个一个 token 生成出来。回答越长,每一步解码都要把越来越长的 KV 缓存(Key/Value cache,大模型推理时缓存的注意力和前馈中间状态)重新读一遍。
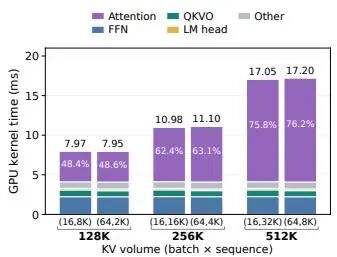
论文先做了性能剖析:在它测的 RLVR 负载里,注意力占到了自回归解码核时间的 72% 到 76%,而且随着 KV 体量增长,这个占比还会往上爬。换句话说,想给 rollout 提速,最值得动刀的地方就是 KV 读取。
attention dominates AR
图1(a):随着 KV 体量增长,注意力在自回归解码核时间里占据主导地位
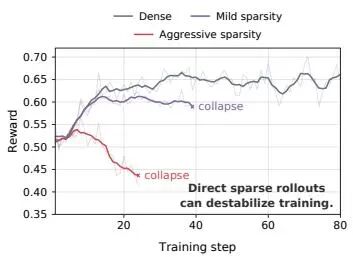
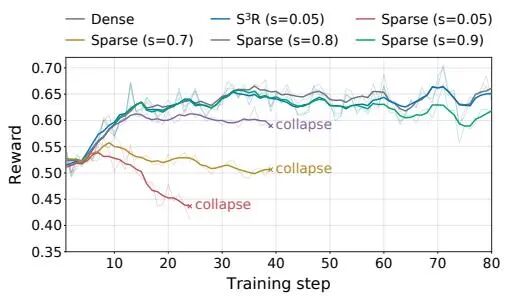
一个非常自然的念头是:既然注意力在反复读历史 KV,那上稀疏注意力,只保留一部分历史不就行了?思路没错,但论文紧接着摆出了反面证据:直接把稀疏采样出来的回答拿去训练,会崩。图1(b) 里,无论稀疏预算设置得温和还是激进,只要不做训练侧的失配修正,训练都会塌掉。
sparse rollout collapse
图1(b):无论是温和还是激进的稀疏度,只要缺少训练侧的失配修正,稀疏 rollout 都会出现训练崩塌
更让人头疼的是,即使加上"逐条回答精确重加权"这种看起来最严谨的修正,也未必救得回来。这一点值得单独说清楚,第 3 节会展开。
于是这篇来自香港科技大学(广州)的工作换了个角度:稀疏只负责"提词",最终采样必须严格来自稠密策略。方法叫 S3R(Self-Sparse Speculative Rollouts,自稀疏推测式 rollout)。作者是 Yuhang He、Hongyu Ge、Zihan Lin、Siyi Liu、Yongqi Zhang。

S3R核心原理:稀疏起草+稠密验证如何保证分布不变


稀疏起草:省下的是 KV 读取,不是策略本身
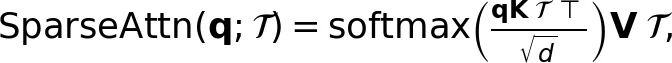
先说清一个容易混淆的点:稀疏注意力并不改变模型权重,它改变的是每一步能看到多少历史。S3R 里的草稿(draft)阶段和验证(verify)阶段共用同一份策略参数快照 θold,也就是说不需要另外训一个小草稿模型,也就不存在"草稿模型跟不上策略更新"这个老问题。
整个 rollout 是一个"起草—验证"的循环:先用稠密预填充(prefill)拿到第一个输出 token;从第二个块开始,草稿阶段只在一个被挑选过的 KV 子集上做注意力。需要补一句背景:推测解码(Speculative Decoding)本身是成熟的推理加速技术,思路是用便宜的"草稿"一次猜多个 token,再让目标模型并行验证,配合精确的拒绝采样可以保证输出分布不变。S3R 做的,是把这套机制搬进 RL 的 rollout,并且让草稿来源就是策略自己。
SparseAttn
稀疏注意力公式:q 是当前查询,𝒯 是保留的 KV 索引集合,K𝒯、V𝒯 是从完整缓存里挑出来的键和值。只在子集上做 softmax 与加权求和,读的显存少了,单个草稿步的延迟自然下降
候选集合怎么挑?论文沿用了一条比较成熟的做法:保留最近的缓存位置,其余位置按照上一轮验证阶段得到的注意力分数做 Top-K 选择。
KV selection
KV 选择公式:𝒞ℓ 是第 ℓ 层当前有效的缓存索引集合,s 是稀疏预算比例,ℛℓ 是围绕验证边界的最近窗口,𝒯ℓ 就是最终要读的集合。它等于"最近窗口"加上"按注意力分数挑出的前若干位置"
budget
保留数量的下限:实际保留的 KV 条数会被限制在 Kmin 与 s|𝒞ℓ| 之间,避免上下文较短或预算较小时选得太少、草稿质量崩掉
草稿阶段一次会连续走 k 步(论文取 k=6)。这 k 步里历史选择固定不变,只把新生成的临时 KV 追加进去。同时草稿器会记录每个候选 token 以及它在完整词表上的概率分布——注意,这个分布来自稀疏注意力,也就是后文要处理的那个"建议分布" qs。
这里有个容易被忽略的细节:稀疏注意力减少的是读历史 KV 的开销,但投影矩阵、前馈网络(FFN)这些计算并不会消失。所以 S3R 的收益不是"越稀疏越快"这么简单,后面会用一个不等式把加速条件讲清楚。

稠密验证:让采样分布严格回到稠密策略

验证阶段做的事很硬核:把草稿提出的 k 个候选 token 放进一次完整的因果全注意力前向里,用真实注意力重新算一遍,得到目标分布 p。论文特别强调,验证不能复用近似的历史状态,必须基于稠密的 KV,并且把整个候选块在所有层上重算一遍,再用验证器的注意力权重去刷新草稿要用的那个子集。
full attention
全注意力公式:一次前向里对多个候选 token 做因果注意力,拿到它们在完整上下文下的真实分布,这也是"验证"这个名字的由来
拿到 p 之后,采样按标准推测采样流程走:候选按 token 顺序逐个检查,每个以 min{1, p(v)/qs(v)} 的概率被接受;一旦出现第一个拒绝,被拒候选以及它后面的全部后缀都会被丢弃,然后从残差分布里采一个修正 token。
residual distribution
残差分布公式:[z]+ 表示取 max{z,0},p(v) 是目标分布(稠密策略)在词表上的概率,qs(v) 是草稿分布。分母是所有正残差之和,用于归一化。直观理解是:草稿高估的 token 会被扣掉,目标分布多出来的那部分概率质量,会被重新分配给草稿没提到、但稠密策略其实想说的 token
exactness
精确性等式:接受部分贡献 min{p, qs},残差部分贡献 [p−qs]+,两者相加恰好等于 p。也就是说,一轮采样输出的边缘分布,与直接从稠密策略里采样完全一致
token level
把每个 token 的分布连乘起来,就得到整条回答在 S3R 下的概率恰好等于稠密策略给出的概率
group level
命题 2:对任意合法稀疏预算 s,一组 G 条回答的联合分布与稠密自回归 rollout 的分布一致。这意味着训练侧可以继续用标准的重要性比率,不需要额外挂一个"稀疏修正项"
ratio
训练时的比率项:更新策略与行为策略的比值,就是策略优化里最普通的那一项 w(θ),因为行为策略已经等于稠密策略
overview
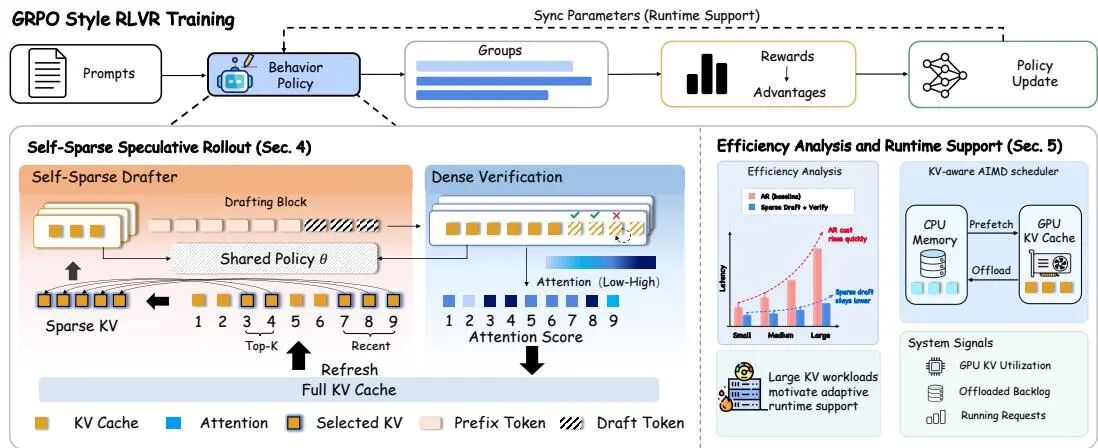
图2:S3R 的 rollout 机制与运行时支持总览。稀疏起草负责降低 rollout 成本,稠密验证负责保住 rollout 的保真度,KV 感知的运行时支持负责把省下来的时间真正留住

论文主体思路速览

把方法拆开看,这篇论文的骨架其实可以压缩成一张表:
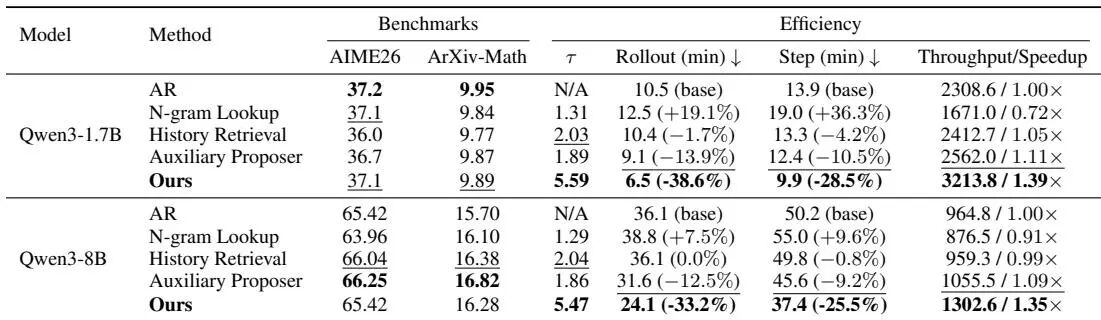
*表格超出部分左右可以滑动 Table 1: Main results on Qwen3-1.7B and Qwen3-8B. Benchmark scores are pass@1 (%) from the best checkpoint. Timing and throughput cover the full training run after the first warm-up step. Best and second-best results within each model size are shown in bold and underlined, respectively.
Table 1: Main results on Qwen3-1.7B and Qwen3-8B. Benchmark scores are pass@1 (%) from the best checkpoint. Timing and throughput cover the full training run after the first warm-up step. Best and second-best results within each model size are shown in bold and underlined, respectively.

加速的边界在哪里
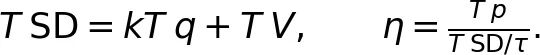
推迟解码省下来的时间,必须覆盖住草稿和验证的额外开销才叫加速。论文给了一个很干脆的延迟模型。
latency model
轮次延迟与加速比:Tq 是稀疏草稿的单步延迟,TV 是验证延迟,Tp 是稠密自回归单步延迟,k 是一轮草稿 token 数,τ 是块效率(block efficiency,即一轮推测平均被接受的输出 token 数)。要加速就必须 η>1,等价于 τ > (kTq+TV)/Tp
cost decomposition
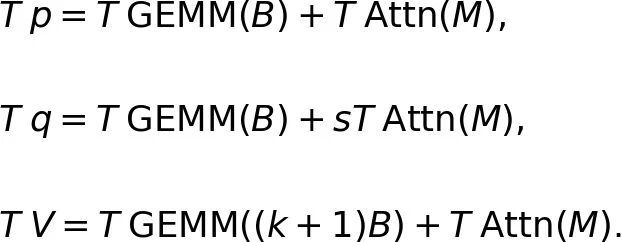
三路延迟拆解:各项都拆成 GEMM(权重相关计算)与注意力两部分。草稿省在注意力(按比例 s 缩放),验证因为一次要处理 k+1 个 token,GEMM 成本反而上升
break even
盈亏平衡的接受长度:在 k=6 的设定下,只要平均接受长度超过这个值,推测流程才开始赚时间;否则纯粹是白忙
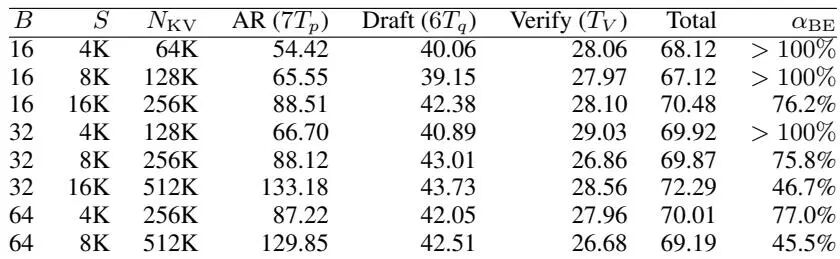
论文用组件实测延迟画了这张权衡图:在批量 B=16、缓存长度 S=4K、聚合 KV 体量约 5.24×10⁵ token 的场景下,平衡点大约落在每轮 3.8 个输出 token。换句话说,块效率低于 3.8,推测这套流程就是亏的;这也解释了为什么有些看起来很聪明的草稿策略,最后反而拖慢了训练。
trade off
图3:Qwen3-8B 上的权衡成本(s=0.05,k=6)。草稿与验证成本叠加后,只有接受长度足够高,整轮才比稠密自回归更快

为什么直接稀疏采样会崩?GRPO组级失配的理论分析

接下来解释为什么"直接稀疏采样 + 训练侧修正"这条路不稳。通常的做法是给每条稀疏回答乘一个重要性采样权重,把稀疏分布的偏差纠正回来。
response weight
整条回答层面的精确似然比:Wi 等于该回答每个 token 的稀疏与稠密概率之比连乘,看起来理论上足够"精确"
但论文给了一个命题:即便用这个精确到整条回答的权重去乘更新贡献,一般也不能恢复稠密策略下的期望更新。原因在 GRPO 的结构里。
group update
组更新的对比:修正后的期望 Gcorr 展开后是 ∑Qs(v)H(v),而稠密策略下的期望 Gdense 是 ∑P(v)H(v)。权重只把 v 这条回答的采样分布修正了,但 H(v) 本身就是对其他组内成员求期望得到的,那些成员依旧来自稀疏分布 Qs
advantage
组相对优势公式:u、v 是组内两条回答,r 是奖励,分母是组内奖励波动。一条回答的"好坏"是和同组其他回答比出来的,不是它自己的绝对分数,这就是组结构带来的依赖
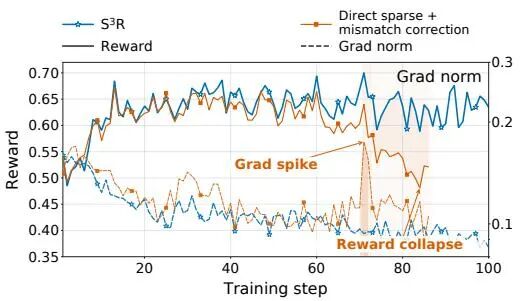
结论用一句话概括:组相对优化的学习信号里带着组结构,而稀疏采样已经改变了这个组结构,单条回答的重加权补不回来。所以 S3R 选择在采样阶段就把分布修回来——在奖励和优势计算之前完成。
verification vs correction
图4(a):S3R 与"直接稀疏 + 失配修正"的对比。两者早期奖励接近,但修正版从早期就有更大的梯度范数波动,约在第 70 步出现尖峰,随后奖励继续恶化;S3R 在 100 步里没有出现这种尖峰-崩塌的模式
stability across budgets
图4(b):不同稀疏预算下的稳定性。既不做推测验证、也不做训练侧修正的直接稀疏 rollout,在 s=0.05 时早早崩塌,在 s=0.7 与 s=0.8 时也不稳定,只有 s=0.9 才能维持相对稳定的学习。S3R 在 s=0.05 时的奖励轨迹与稠密基线基本重合
shaona.jpeg
平均奖励看着差不多,其实更新稳定性已经天差地别——这也是对比方法最容易被误读的地方:光看奖励曲线,早期根本看不出谁要崩。

实验结果:1.39倍训练加速,精度不降反稳


数据准备及实验设计

训练侧从 Qwen3-1.7B 与 Qwen3-8B 初始化策略,数据用 DAPO-MATH-17k,优化采用 DAPO 变体的 GRPO(DAPO 全称 Decoupled Clip and Dynamic sAmpling Policy Optimization,一种对裁剪与采样策略做解耦的强化学习方案)。每个 batch 包含 256 个 prompt,每个 prompt 采 8 条回答,温度 1.0,1.7B 与 8B 的最大回答长度分别是 16K 与 24K token。所有方法都跑在 veRL(一个开源的大模型强化学习训练框架)上,单节点 8 张 H100。S3R 在两个模型上都用草稿长度 k=6、稀疏预算 s=0.05,并开启 KV 感知的 AIMD 调度。
对比基线选了三条有代表性的路线:N-gram Lookup 用提示查找解码(prompt lookup decoding),从当前 prompt 或已生成回答里匹配 token 后缀来提草稿;History Retrieval 参考 RhymeRL,从同一 prompt 的历史回答里检索草稿延续;Auxiliary Proposer 用一个预训练的 EAGLE3 网络做草稿器,k=5,权重冻结不随策略更新。主对比不做额外的草稿器训练。
指标上同时看三项效率数据和两项任务分数:rollout 生成时间、端到端训练步时间、训练吞吐(每 GPU 每秒 token 数),加速比以自回归为基准;任务质量用 AIME26 与 ArXiv-Math 的 pass@1(一次采样答对的正确率),取最佳 checkpoint 打分。pass@1 的统计方式是 N 道题、每题采 16 次,累计答对次数再取平均。
measurement settings
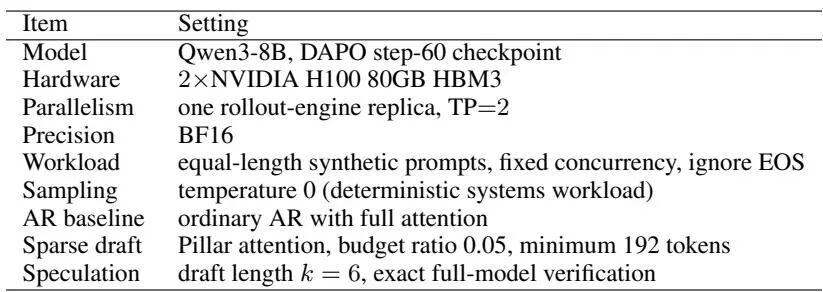
表4:组件测量所用配置。论文对草稿、验证、纯自回归三条路径分别做阶段计时,用来支撑后面的效率分析

实验结果分析

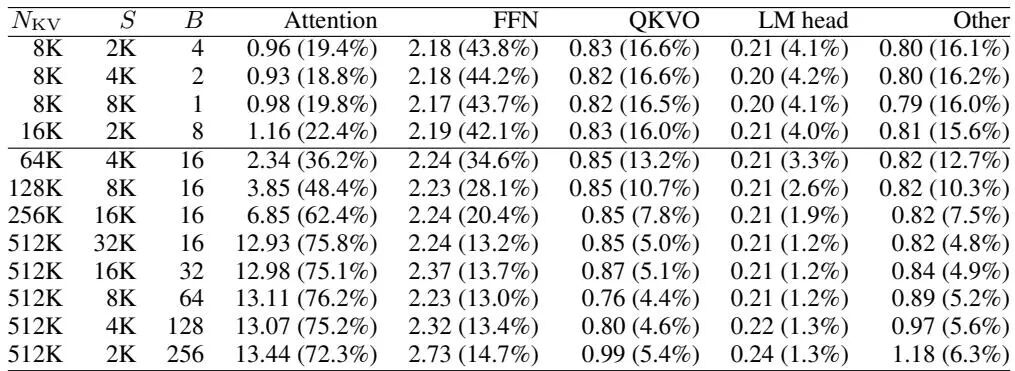
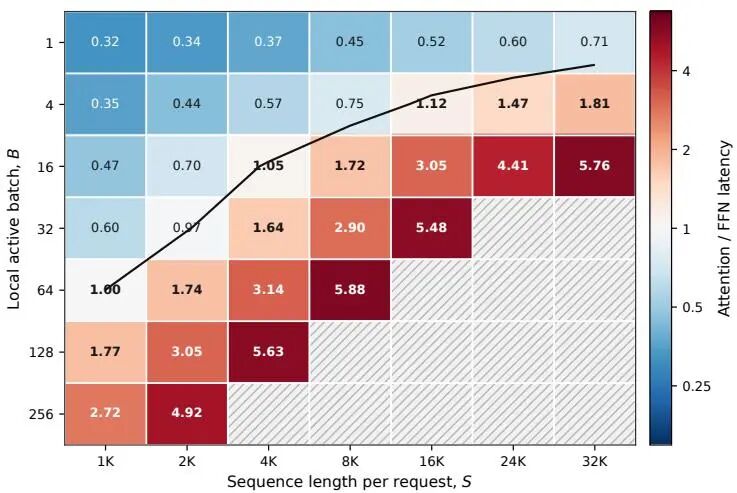
先看瓶颈到底在哪。论文把自回归解码的核时间按模块拆开:在 KV 体量较小的 rollout 尾部,注意力并不算贵;但当并发和上下文同时上来,注意力就会变成主导项。论文给出的注意力与 FFN 延迟比在大致相同的 KV 体量下相当稳定:8K 时约 0.43–0.45,64K 时约 0.97–1.12,512K 时约 4.92–5.88。这个观察挺关键——它说明在这个测量范围内,聚合的在线 KV 体量是判断瓶颈位置的一阶指标。
而 RLVR 恰好是个放大并发的场景:每个 prompt 要采 8 条回答,所以即使单条上下文不算特别长,整体并发也可能让注意力变得很贵;反过来,如果活跃 batch 收缩,长回答剩余部分的注意力机会又会缩水。这也解释了论文为什么把"稀疏推测在哪里最划算"这个问题留给了更长窗口的调度策略,而不是给一个固定的稀疏度。
AR decoding cost
表5:全注意力自回归解码成本(每次迭代毫秒数与 GPU 核时间占比)。上半部分是小 KV 的 rollout 尾部负载,下半部分则进入注意力主导解码的区间
attention to ffn ratio
图11:不同 batch 与上下文长度下,全注意力自回归解码的注意力/FFN 核延迟比。黑色等高线表示两者延迟相等,斜线填充的格子超出了实测的 KV 容量上限
再看 S3R 自身各阶段的实际开销。稀疏草稿把注意力时间压下去,但稠密验证那一次前向仍然要吃满 KV。这两张表(组件耗时与草稿/验证成本)是把"省了多少"和"花在哪儿"摆在一起看的关键依据,也说明为什么单看稀疏度并不能推出加速比。
attention time
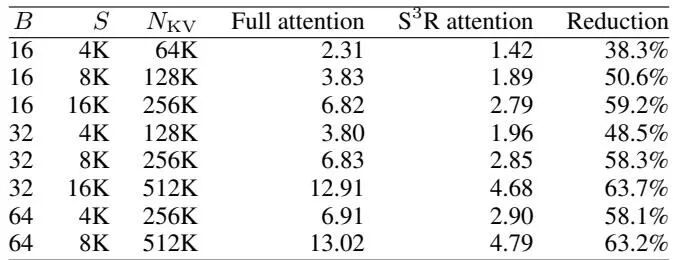
表6:自回归与 S3R 在各调度迭代、每个张量并行 rank 上的注意力耗时(三次运行的中位数)。S3R 的数值包含稀疏草稿与稠密验证,并在整个窗口上取平均,空闲迭代也被计入
draft and verify cost
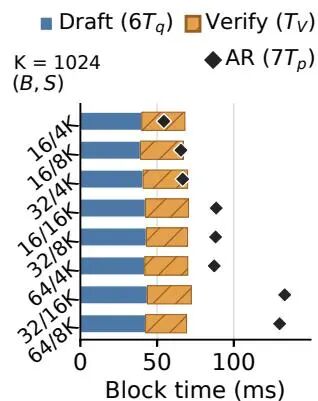
表7:k=6 时草稿与验证的耗时(毫秒,三次运行中位数)。自回归参考值 7Tp 表示一轮全接受时产出的 token 量;αBE 是在串行阶段记账下达到盈亏平衡所需的接受长度。这些统计不含空闲迭代和跨请求的阶段混合
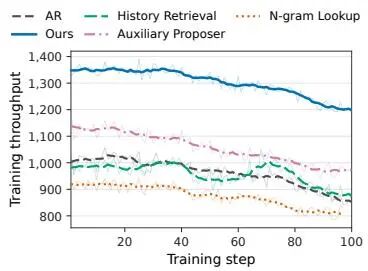
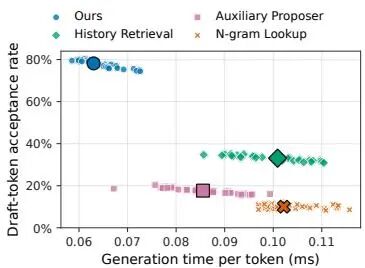
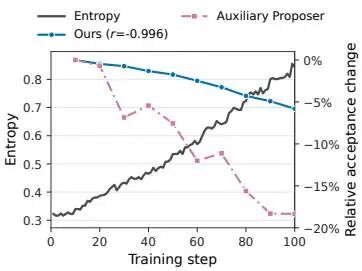
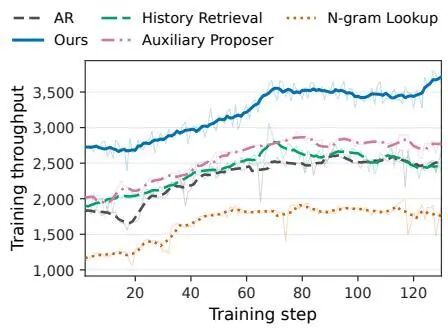
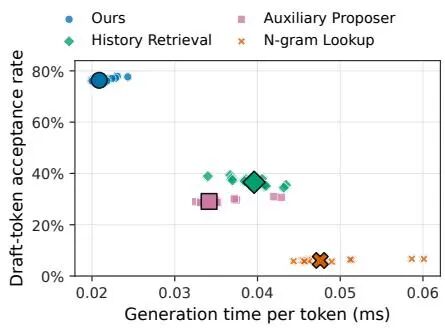
接下来是训练过程中的诊断信息。S3R 的端到端训练吞吐在 RL 训练过程中保持领先,而不同草稿策略在"每处理一个 token 的生成时间对草稿接受度"这张图上分布明显不同:接受度上不去的方法,验证成本摊不开,吞吐反而更低。还有一条容易被忽略的曲线是策略熵与草稿接受率的相对漂移——冻结的 EAGLE3 草稿器随着策略更新,接受率是往下走的,这正是"固定草稿器会变陈旧"的直接证据。
throughput
图5(a):Qwen3-8B 训练过程中的端到端训练吞吐曲线,S3R 在整个训练过程中保持效率优势
timing acceptance
图5(b):每个处理 token(prompt 与回答合计)的生成时间与草稿 token 接受度的关系,带描边的标记表示各方法的中位数
entropy and acceptance
图5(c):策略熵与草稿 token 接受度的相对变化。冻结草稿器的接受率随策略演进逐渐下滑,说明"草稿与目标对齐"这件事需要持续维护
1.7B throughput
图10(a):Qwen3-1.7B 上的端到端训练吞吐,趋势与 8B 一致
1.7B timing acceptance
图10(b):Qwen3-1.7B 上每个处理 token 的生成时间与草稿接受度关系,带描边标记为各方法中位数
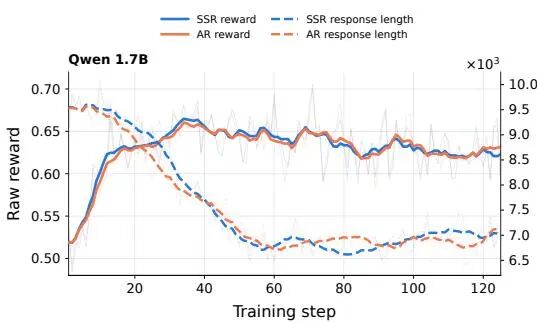
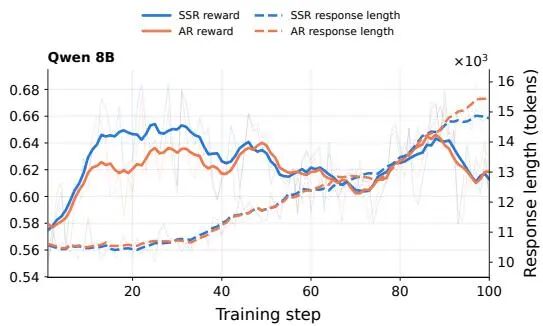
还有一个很有说服力的验证信号:S3R 的奖励轨迹和回答长度轨迹与稠密自回归基本重合。这跟命题 2 的结论是一致的——如果采样的响应组分布没有变,那么用于学习的信号就不该出现系统性偏移。从这个角度看,S3R 把"省算力"和"不改学习信号"这两件互相矛盾的事,用采样层的分离缝合到了一起。
1.7B reward trajectory
图8(a):Qwen3-1.7B 上自回归与 S3R 的奖励与回答长度轨迹对比
8B reward trajectory
图8(b):Qwen3-8B 上自回归与 S3R 的奖励与回答长度轨迹对比,两条曲线贴合得很紧
基线为什么没吃到红利,论文的分析也比较克制:N-gram Lookup 的块效率只有约 1.3,验证成本摊不开,训练吞吐反而下降;History Retrieval 的块效率好一些(约 2.0),但历史维护本身带来额外开销,整体几乎没加速;Auxiliary Proposer 虽然因为草稿成本低而拿到一定吞吐提升,但接受率随策略更新持续下滑。而 S3R 在 s=0.05 下把块效率做到约 5.5,靠的是草稿直接来自当前策略,既不需要历史覆盖,也不需要草稿模型适配。

实验结果

主结果放在下面这张表里。S3R 在两个模型上都拿到了所对比方法里最高的端到端训练吞吐,同时任务分数与自回归基线基本持平。
main results
表1:Qwen3-1.7B 与 Qwen3-8B 上的主要结果。任务分数为最佳 checkpoint 的 pass@1(%),时间与吞吐统计覆盖首个预热步之后的完整训练过程
具体数字上,Qwen3-1.7B 的吞吐从 2308.6 tokens/s 提升到 3213.8 tokens/s,加速比 1.39×,rollout 时间下降 38.6%,单步时间下降 28.5%;Qwen3-8B 从 964.8 tokens/s 提升到 1302.6 tokens/s,加速比 1.35×,rollout 时间下降 33.2%,单步时间下降 25.5%。任务分数方面,1.7B 的 AIME26 为 37.1(自回归 37.2)、ArXiv-Math 为 9.89(自回归 9.95);8B 的 AIME26 为 65.42(与自回归持平)、ArXiv-Math 为 16.28(自回归 15.70)。这些差异都在小样本波动的量级内,论文的表述也是"comparable task performance",而不是分数提升。

KV感知调度器:长上下文下的内存管理利器


龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?大模型强化学习的瓶颈在 rollout 生成。稀疏注意力能省 KV 读取,却让采样分布偏移、训练发散。港科大(广州)提出 S3R:稀疏起草只出候选,稠密全注意力精确验收,保住响应组分布。
这篇工作最值得看的点是什么?S3R在Qwen3-1.7B和Qwen3-8B上分别达到1.39倍和1.35倍的端到端训练吞吐量提升,同时保持与AR相当的任务性能(AIME26和ArXiv-Math pass@1分数接近)。在激进稀疏预算(s=0.05)下训练稳定,而直接稀疏采样+训练侧校正会出现梯度爆炸和奖励崩溃。块效率达到约5.5,远高于N-gram Lookup(约1.3)和History Retrieval(约2.0)。
这篇工作的边界或风险在哪里?优点:(1)理论分析扎实,证明了响应级重加权无法恢复稠密策略的期望更新,并给出了精确推测采样保持响应组分布的理论保证;(2)无需单独训练drafter,避免了辅助模型与策略更新之间的对齐开销;(3)KV感知AIMD调度器有效减少了KV缓存抖动,提升了长上下文场景下的吞吐量;(4)在激进稀疏预算下仍能保持训练稳定。缺点:(1)仅在数学推理任务上验证,未涉及代码生成、通用对话等其他RLVR场景;(2)稀疏预算s需要手动调节,缺乏自适应机制;(3)全注意力验证仍需完整历史KV缓存,内存开销未根本解决;(4)与部分最新稀疏RL方法的对比不够充分。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

提出S3R框架,利用稀疏注意力进行自推测起草(self-drafting),再通过全注意力验证和精确推测采样生成响应,从而在不改变稠密策略响应组分布的前提下加速RLVR的长上下文rollout生成。

实验合理度:★★★★☆

pass@1(%)、rollout生成时间、端到端训练步时间、训练吞吐量(tokens/s/GPU)、块效率τ、草稿token接受率

学术研究价值:★★★★☆

提出S3R框架,利用稀疏注意力进行自推测起草(self-drafting),再通过全注意力验证和精确推测采样生成响应,从而在不改变稠密策略响应组分布的前提下加速RLVR的长上下文。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

在Qwen3-1.7B上端到端训练吞吐量为3213.8 tokens/s/GPU(1.39倍于AR),Qwen3-8B上为1302.6 tokens/s/GPU(1.35倍于AR);rollout生成时间在Qwen3-1.7B上从10.

复现难度:★★★☆☆

现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:现有材料尚未充分覆盖分布外泛化、部署成本、长期稳定性和失败案例。


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球