论文基本信息
文中简称:电脑使用技术(Computer-Using);图形用户界面技术(GUI)。
模型名称:电脑操作智能体模型(OS-Helix);约270亿参数模型(OS-Helix-27B)。
原文标题:OS-Helix: Unifying GUI Interaction and Code Execution in Native Computer-Using Agents
首次公开:2026年10月16日(北京时间)
署名单位:中国科学技术大学、上海人工智能实验室等
原论文:https://arxiv.org/abs/2610.22234
龙哥导读
你让电脑智能体把一批文件按规则归档,它可以逐个打开窗口、点菜单、拖动文件;也可以写几行代码,一次处理完。哪种方式更好?答案常常是:看任务走到哪一步。真正有用的智能体,可能需要先看界面、再批量处理文件,最后回到界面确认结果。
OS-Helix 想解决的正是这种“该点鼠标,还是该执行代码”的选择问题。它不是简单地给原有电脑智能体加一个代码按钮,而是把图形操作与代码执行放进同一套训练和决策流程中,让模型在一个任务里组合使用两种能力。
论文报告的核心结果是:在标准电脑任务评测系统(OSWorld-Verified)上,强化学习版本模型(OS-Helix-27B-RL)的平均成功率为 66.44%。我们下面会拆开看:这个数字是怎样来的,图形与代码怎样配合,以及训练中一个看似细小的权重设计为何会影响最后成绩。
一、电脑任务不只是一串点击
很多电脑智能体的基本工作方式,是观察屏幕,再决定点击哪里、输入什么。对打开应用、填写表单、检查页面布局,这种方式很自然;但遇到大量重复的文件操作、精确的数据计算或批量整理,逐个点击就可能又慢又容易出错。
反过来,只靠代码也不够。代码擅长重复、精确、可批量执行的工作,却未必知道某个应用当前显示了什么,也不一定能判断按钮是否变灰、弹窗是否出现、最终页面是不是用户想要的样子。电脑任务经常同时包含“处理数据”和“操作应用”,单一方式会把另一半工作留给人。
论文的出发点因此很直接:不是把电脑操作简化为鼠标,也不是把所有任务改写成程序,而是让同一个策略能够在两种动作之间切换。模型可以用界面理解当前状态,用代码完成适合批处理的部分,再回到界面检查变化。关键问题随之变成:它能不能学会何时切换,而不是只会调用更多工具?
图1把这个差别画得很清楚。左侧代表只走图形界面,操作路径是看屏幕、点控件、逐项完成;中间代表只走代码,任务依赖可访问的数据和执行环境;右侧的混合方式把两类动作放在同一个任务过程中。它的价值不在于“两种工具同时存在”,而在于模型能根据当前子任务选择更合适的动作,并继续对整个任务负责。
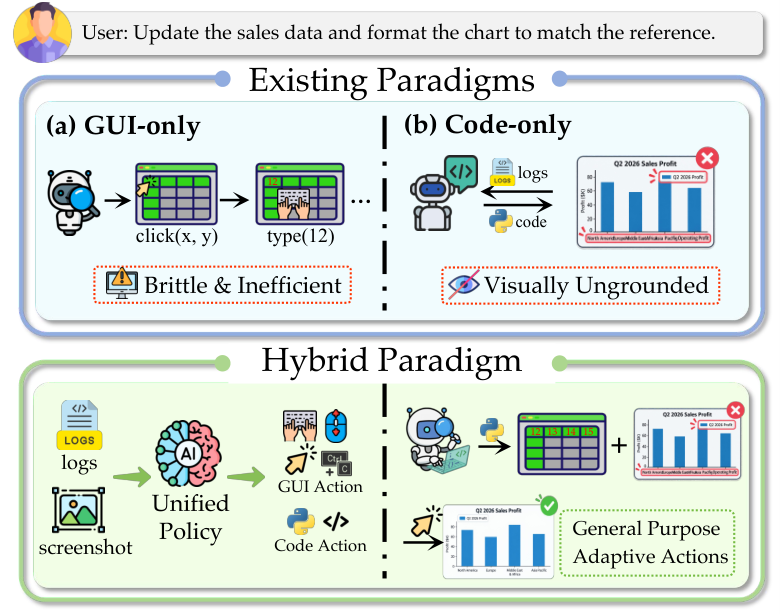
图1|三种电脑操作路线的对照。混合方案试图让模型在界面观察、程序化处理和结果核对之间形成连续动作,而不是把两种能力分给互不相干的模块。
二、先让两种动作进入同一条训练链
图2给出论文的训练流程。可以把它理解成四步:先准备包含界面操作和代码执行的任务轨迹;再筛选质量合格、结果可检查的数据;用监督微调(SFT)让模型学会基本操作与混合轨迹;最后在真实桌面环境中进行在线强化学习(RL),根据任务是否完成继续调整策略。
这里的“轨迹”不是一张操作截图,而是一连串有先后关系的观察和动作。模型看到什么、做了哪一步、环境发生了什么变化,都要能放回同一个任务过程里。训练样本还要有可核验的终态,否则模型可能学会模仿动作,却无法区分“看起来像完成”和“任务确实完成”。
图中的数据准备环节强调应用与文件状态的配合。一个任务可能要求在应用里找到对象,也可能要求对文件做批量处理;训练数据需要让模型看到这两部分怎样衔接。论文还通过筛选减少低质量轨迹对训练的干扰。这样的设计不是单纯堆更多操作记录,而是试图让每条记录都能说明:为什么此处选择界面,为什么另一处转向代码,操作之后又怎样确认结果。
图2中从监督微调到在线强化学习的顺序也值得注意。前者提供可模仿的起点,后者让策略在桌面环境里继续试错和改进。论文的消融结果显示,只做强化学习的变体成功率为 48.20%,只做监督微调为 62.75%,两者结合达到 66.44%。因此,强化学习不是凭空替代数据和示范;它是在已有操作基础上继续优化。
第一步把桌面拆成应用和文件材料:45 类应用与可打开、编辑的真实文件配对,形成能重复启动的环境。第二步由探索智能体观察环境、提出任务和可检查的完成条件,再交给独立评估器;评估器只判断最终状态,不规定鼠标或代码的解题路径。这样,同一任务可以有不同做法,验收看的是结果是否达成。
第三步把质量筛过的混合操作示范交给模型学习,第四步才进入在线强化学习。它们不是把“点击”和“写代码”当成两支互不相干的工具,而是让每个任务都带着观察、选择动作、查看环境反馈和确认终态的过程。
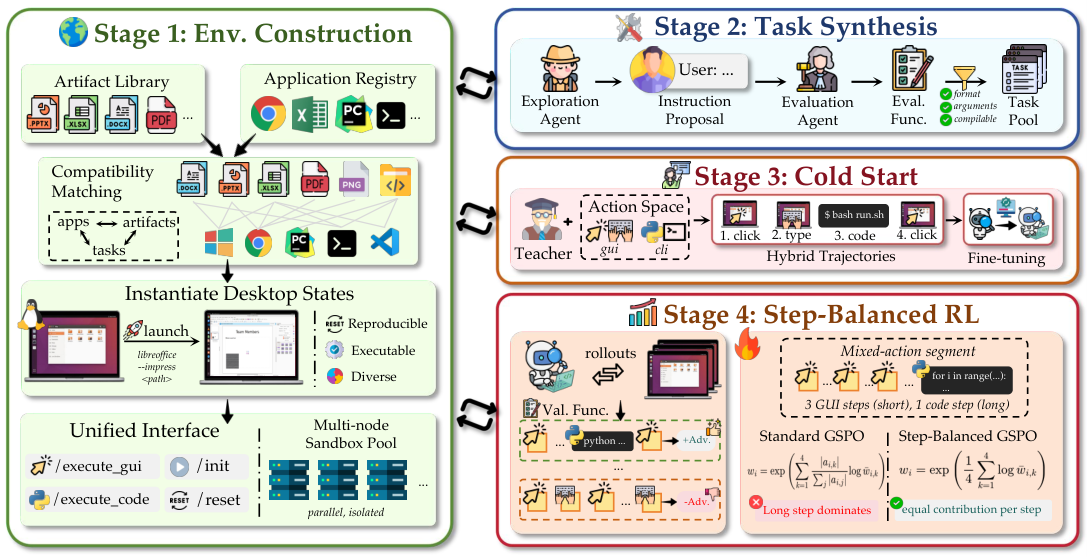
图2|训练流程示意。图中各阶段把混合操作数据、示范学习和桌面环境中的进一步训练串在一起;SFT 是监督微调,RL 是强化学习。
为什么不直接在每个操作上都使用同一种训练规则?原因藏在轨迹长度里。一次界面点击可能只对应少量文字标记;一段代码却可能很长,包含格式、参数、解释和实际命令。如果训练时按文字标记的数量汇总权重,代码步骤就可能因为“字多”而获得不成比例的影响,即使它在任务中只是一小步。
这不是说长代码天然不好,也不是要人为压低代码动作。真正的问题是:训练算法是否把“一个动作需要多少文字”误当成“这个动作应该有多大影响”。如果两次点击与一段长代码共同组成一个任务,后者可能单凭 token 数量主导整条训练样本的更新方向。
三、按动作步骤平衡:先算每一步,再汇总
作者为强化学习阶段提出按动作步骤平衡的组序列策略优化算法(GSPO)。先说明几个符号:i 表示一条训练样本,k 表示其中第几个动作步骤;一个步骤里可能包含多个文字标记。论文把这些文字标记对应的重要性变化先求平均,得到该动作步骤自己的平均值,而不是让长步骤天然占更大份量。
接下来,τ 表示动作类别,例如图形界面动作或代码动作;α 是给动作类别设置的非负权重;Z 用来把一条轨迹里的动作权重归一化;ω 则是归一化后的单步权重。论文的主实验把界面和代码两类动作设为等权。这样,一步动作的影响取决于“它属于哪一类、被设定了多大权重”,而不再只取决于该步骤写了多少文字标记。
公式里的 i 是一条样本,k 是样本中的第几个动作,Ki 是这条样本包含的动作数;θ 表示当前策略模型的参数。δ̄i,k 是第 k 步各文字标记重要性变化的平均值,ωi,k 是分给该步的归一化权重。公式把每一步的权重与平均变化相乘,对一条轨迹中的动作求和,再取指数得到样本级权重比。
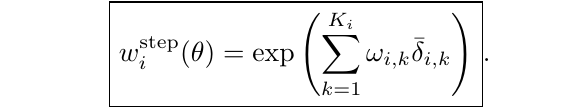
公式|δ̄i,k 是第 k 个动作步骤中各文字标记重要性变化的平均值;ωi,k 是该步归一化后的动作权重;对所有步骤加权求和后再取指数,得到样本级重要性比。
它与标准 GSPO 的差别,可以用“先算谁的平均”来概括。标准做法先在整条样本的所有文字标记上汇总;Step-balanced GSPO 先在每个动作步骤内部平均,再按动作类别权重汇总。这样,一段很长的代码仍然可以是关键动作,却不会仅因为它包含更多文字,就在样本级权重中压过几次重要的界面操作。
这个设计改变的是训练时动作信号的汇总方式。论文主实验把图形操作与代码操作设为等权;类别权重如何设置,会直接影响训练目标。面对以批量数据处理为主的任务,采用不同权重也可能带来不同策略。
四、表格里的 66.44%,到底是哪一步带来的?
表4把训练阶段和强化学习算法拆开比较。没有监督微调、也没有强化学习的混合骨干模型是 46.50%;只进行强化学习为 48.20%;只做监督微调为 62.75%;先监督微调、再强化学习的组合达到 66.44%。按论文表中的口径,最后一步比监督微调基线高 3.69 个百分点。它说明改进不是“只要做强化学习就会发生”,而是训练顺序和起点都很重要。
同一张表还比较了两种组序列策略优化目标。标准 GSPO 的成功率是 60.47%,比监督微调基线低 2.28 个百分点;代码动作占比则从监督微调策略的 27.9% 上升到 40.0%。这组变化与论文提出的问题相吻合:如果训练汇总方式让长代码步骤更容易影响样本权重,策略可能偏向代码动作,整体任务成功率反而下降。
改用按步骤平衡的 GSPO 后,成功率回到并超过监督微调基线,达到 66.44%;代码动作占比是 26.1%,接近基线的 27.9%。这里的占比是“分配给代码执行的动作比例”,不是代码执行成功率。真正值得看的是两个指标一起变化:任务成功率上升,同时动作组合没有明显偏向某一种方式。
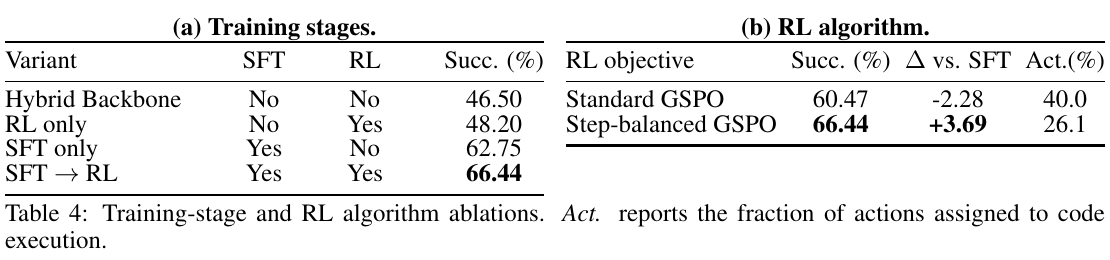
表4|左侧比较训练阶段,右侧比较强化学习目标。SFT 表示监督微调,RL 表示强化学习;Act. 是分配给代码执行的动作比例,不是成功率。
表3提供了另一条证据:训练数据生成者和任务领域构成都会影响结果。在论文给出的轨迹教师对照中,Claude Sonnet 4.6 对应 58.77%,Kimi K2.5 对应 54.03%;这些数字属于特定实验设置,不是对两个模型通用能力的排名。把九个应用领域从合成数据池中移除后,样本量约从 31K 降到 17K,成功率从 62.75% 变为 62.31%。
从 62.75% 到 62.31% 的变化较小。在这组消融设置里,移除九个与评测应用相关的领域后,剩余训练数据仍维持了相近成绩,说明合成轨迹中的任务结构并非只来自这九类应用。
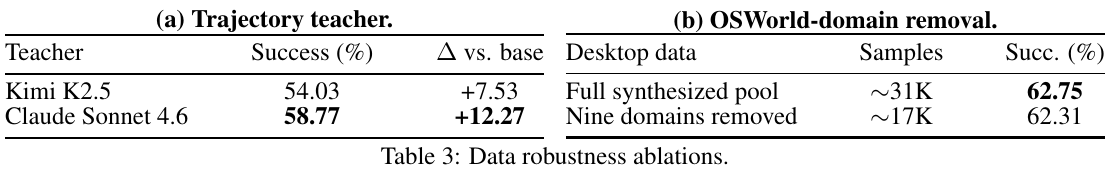
表3|左侧是轨迹教师对照,右侧是从合成桌面数据中移除九个应用领域后的结果。样本数和成功率应放在各自的实验设定中理解。
先看评测口径:这个平均分怎么读?
OSWorld-Verified 把电脑任务分成几类:系统级操作、办公软件操作、浏览器与邮件等日常应用、专业软件,以及需要跨多个应用的工作流。办公类覆盖表格、演示文稿和文字处理;专业类包含图像编辑与代码编辑任务。因而一个总平均分会把不同难度、不同应用形态的结果放在一起,不能替代对具体类别的观察。
论文把评测轮次限制在最多 50 个交互步骤,并保留最多 8 张历史截图和完整文字操作记录。对于复现的基线,作者使用相同的评测框架与环境配置。论文还按照评测器分数是否超过 0.5,把一次任务判为成功或失败。因此,66.44% 既受模型能力影响,也受任务集合、环境、交互上限和判分阈值共同约束。
最终测试集合排除了 8 项 Google Drive 任务,包含 361 项任务。这里的 66.44% 是论文报告的平均成功率,不是说模型完成了其中恰好 240 项,更不是现实用户每次使用时都有同样概率。不同任务的判定方式和成功率各不相同;理解总分时,要同时看任务范围与分类结果。
训练规模也有助于理解它不是单一技巧的效果:监督微调使用约 31K 条经过筛选的合成桌面成功轨迹,并混入 40K 条通用多模态样本;之后的在线强化学习从已完成监督微调的 27B 模型开始,进行 1,000 步训练,奖励来自规则式评测器。这样的数据与训练配置共同构成了论文结果,换成其他模型、任务池或权限设置,成绩可能不同。
五、代码真的有用吗?还要看它怎样进入任务
表5专门把“训练时会不会混合动作”与“执行时能不能使用代码”分开。固定的 OS-Helix-27B 模型在推理时没有代码访问权限,成功率是 52.13%;开启代码执行后是 62.75%,提高 10.62 个百分点。这个对照说明,在该基准的测试条件下,代码工具能补上部分电脑任务能力。
表5右侧进一步控制了监督微调样本量,两组都是 10K。只用图形界面轨迹的成功率为 57.56%,混合界面与代码轨迹为 60.61%;后者的代码动作比例为 37.1%,前者为 11.7%。这组数据提示,训练数据里的动作组合可能帮助模型更好地使用可用工具,而不只是执行时临时开放一个代码窗口。
需要区分两个结论:一是代码访问会改变执行时可选的动作,二是混合轨迹训练会影响模型怎样组合动作。表5分别给出这两方面的对照;涉及权限、不可逆删除、外部发送或安全确认的动作,则需要相应的策略与验证机制。
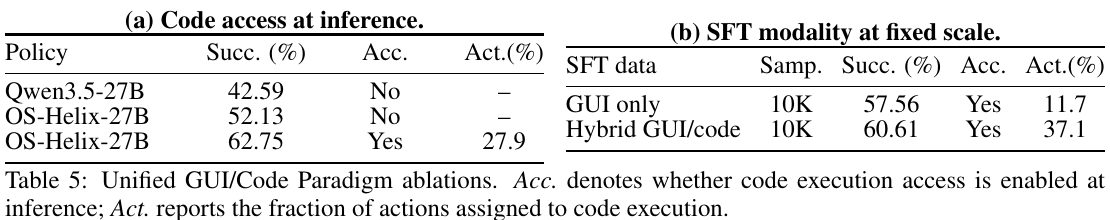
表5|左侧比较推理阶段能否执行代码,右侧在相同的 10K 样本规模下比较训练轨迹。Acc. 表示是否能访问代码执行,Act. 表示代码动作占比。
把视线放回主结果表,OS-Helix-27B-RL 的 66.44% 相比匹配的混合基线模型(Qwen3.5-27B)46.50% 高出 19.94 个百分点。论文把提升分布到不同任务类别中:办公类和跨应用工作流在监督微调阶段已经取得较强结果,强化学习后进一步提升主要集中在专业软件、系统级操作和日常应用。换句话说,强化学习的收益不是所有类别整齐地一起增加。
论文还在另一套 Windows 电脑任务评测系统(WindowsAgentArena)上报告 63.87% 的成功率,提供了跨到另一套操作系统评测环境的补充证据。该结果来自论文采用的这套迁移测试。
六、案例图:界面和代码不是二选一
数字能说明平均趋势,案例图则让动作衔接更直观。图6展示的路径之一,是先通过图形界面了解当前应用和任务状态,再用代码批量下载或整理文件;另一条路径则是先用代码查到需要的信息,再回到界面完成邮件等应用内操作。每一段动作都有自己的适用位置,任务完成仍要回到环境状态检查。
看图6时,不要只盯着代码框。关键是前后的状态转换:模型需要先获得足够信息,决定是否可以安全地批量处理;代码执行后,还要把结果带回后续的界面步骤。若它只会执行脚本,却没有检查目标文件是否正确;或者只会点击,却把本可批量完成的工作拆成几十次重复操作,混合策略都没有真正发挥作用。
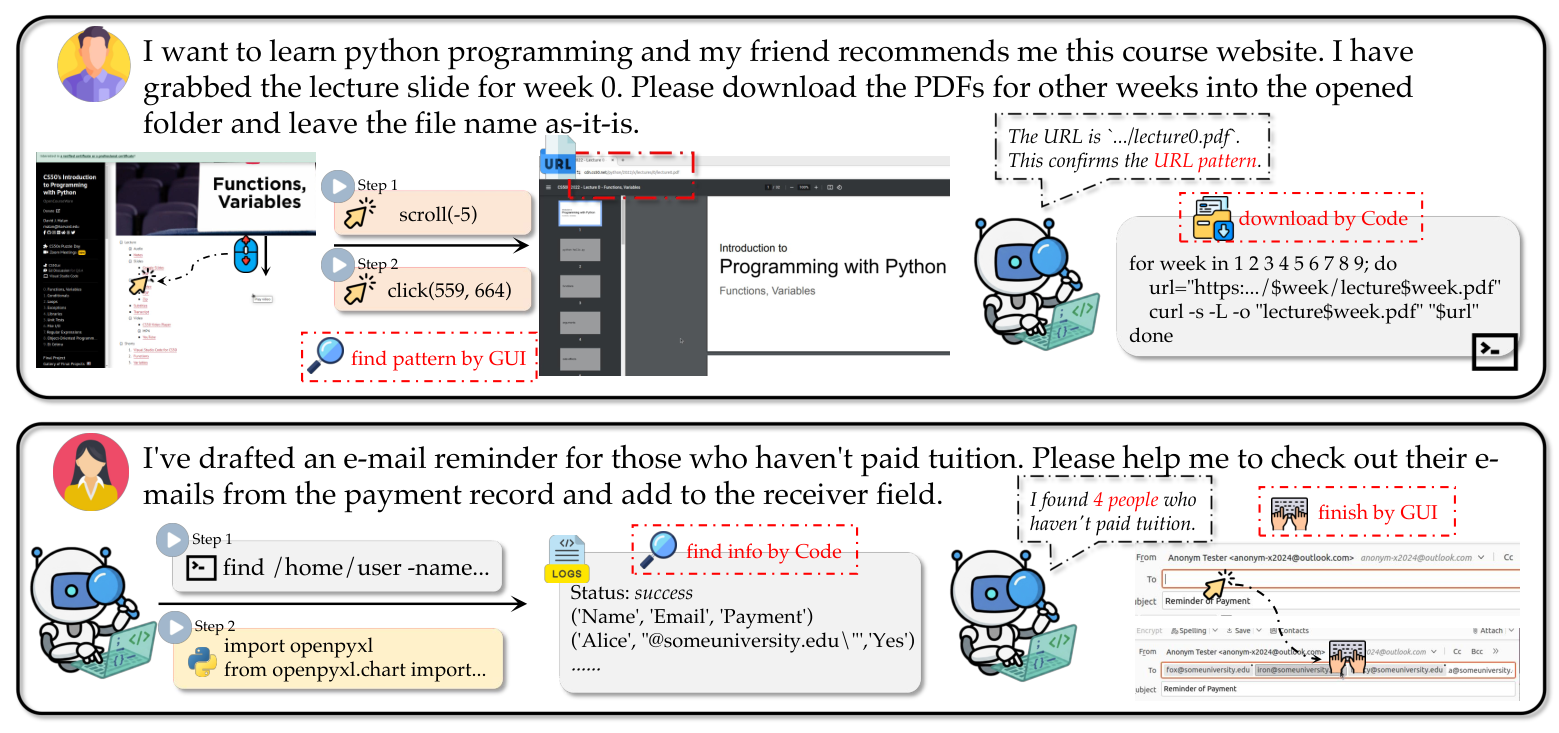
图6|案例强调两种动作的前后协作:先观察或获取信息,再执行适合当前步骤的操作,必要时回到应用中继续完成流程。
图7把“做完以后再核验”呈现得更具体。模型在界面里创建图表后,发现数据缺失;接下来不是假装图表已经正确,而是用代码检查并补齐数据,再回到界面确认结果。这个过程说明,工具切换不仅是为了快,也能把“发现异常—修正—复查”放在同一条任务链里。
这个案例把界面观察、代码纠错和界面复核放在一条任务链里,重点是动作顺序以及结果如何回到应用中核对。
图7下半部分还展示了演示文稿任务:智能体在第二页添加与标题相同的备注并加粗标题,随后通过读取文件确认改动已保存。上半部分负责发现图表缺少一组数据,下半部分负责核对文件状态;两者都把“操作完成”与“结果已保存”分开检查。
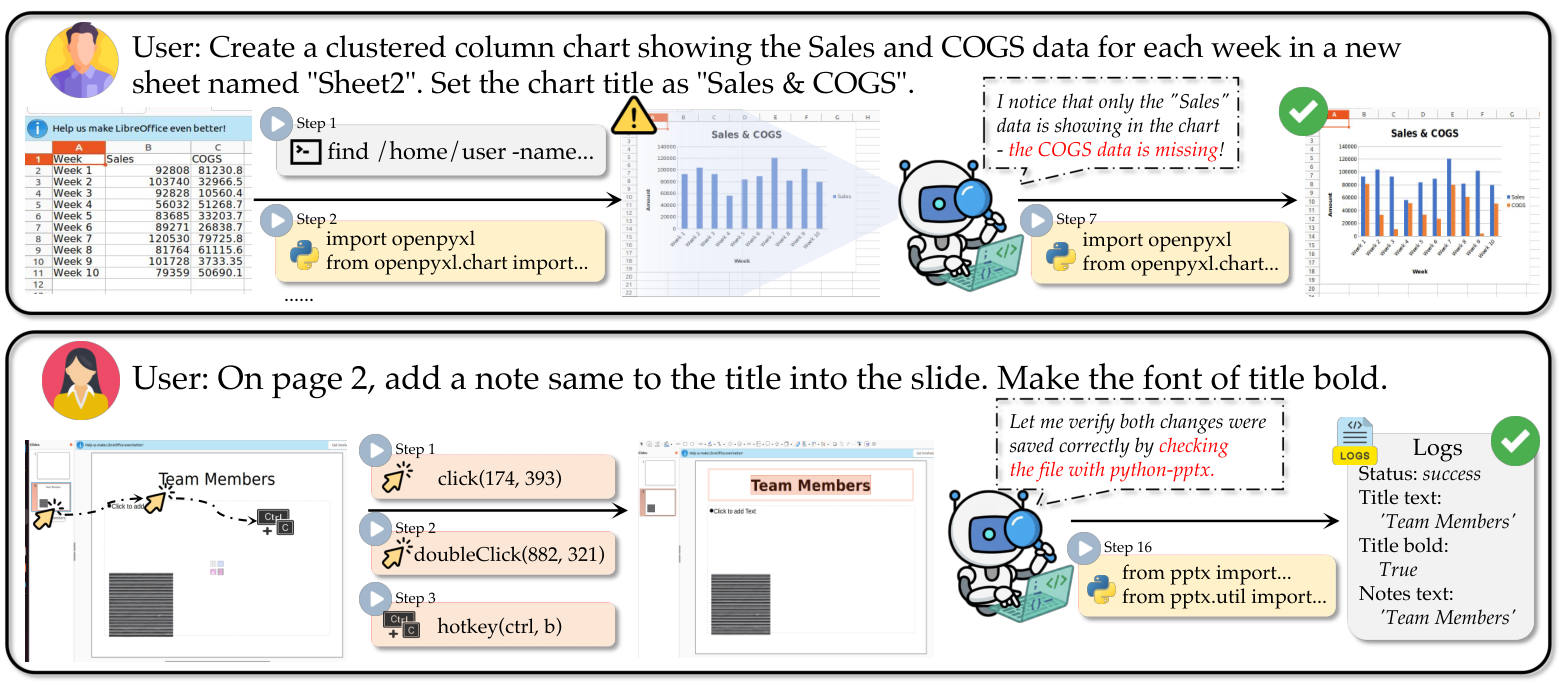
图7|从界面创建图表,到检查数据、用代码修正,再回到图形界面确认,展示完整的交叉操作示例。
七、融会贯通:电脑智能体的几道不同难题
智能体安全监督审计框架(HazardAuditor)把不同工具的交互整理成统一事件,再训练安全判断。其守卫策略优化方法(GuardPO)处理“长解释不应仅因文字更多就占更大训练权重”,优化对象是安全理由与最终判定。
OS-Helix 的按动作步骤平衡的组序列策略优化算法(GSPO),则平衡图形界面和代码动作,解决桌面任务里的动作选择。两项研究都在减少长度偏置,但一个调整安全判断的训练单位,一个调整桌面操作的训练单位。
《Do GUI Agents Know When Not to Act?》把问题放在冲突指令和界面状态:当要求互相矛盾或无法完成时,智能体能否及时停下。它补的是“何时不执行”;OS-Helix 补的是“何时切换界面和代码”。对真实系统来说,这两种能力要并存:既要挑选有效动作,也要能识别不该继续的动作。
跨设备智能体评测集(JarvisGUI)把评测推进到 Android、Windows 与 Ubuntu 之间的多设备工作流,重点观察中间状态能否跨平台传递。OS-Helix 主要研究同一桌面任务内的图形操作与代码协作。三项工作分别照亮安全、停止决策、跨设备状态和单任务内工具路由;它们是互补的问题切面,不是同一排行榜上的直接竞争者。
这几篇工作的共同背景,是电脑任务正在从单次点击走向更长的多步骤流程;它们关注的切口分别是安全、停止决策、跨设备组合和界面—代码协同。把它们并列阅读,比只比较一个成功率数字更有帮助:真实系统要能完成任务,也要知道什么时候不做、怎么验证以及何时请求人工确认。
八、从评测走向日常桌面,还要解决什么?
首先,66.44% 是基准测试中的平均成功率,不是所有真实桌面任务的成功概率。论文在 OSWorld-Verified 上评估,并排除了 8 项 Google Drive 任务,最终测试任务集合为 361 项。基准环境与日常使用在账号权限、网络状态、应用版本、文件损坏和用户临时改变要求等方面都可能不同,读者不应把两者直接画等号。
其次,能执行代码就意味着系统必须明确管理代码权限。哪些目录可读写、是否允许联网、能否删除或覆盖文件、敏感操作是否需要二次确认,都会改变风险。论文的性能提升不能替代这些部署规则;尤其是发邮件、提交表单、批量改文件等具有外部影响的步骤,系统需要更明确的确认边界和可追溯记录。
再次,训练时让界面和代码动作获得平衡,并不自动意味着实际运行时永远能选对工具。错误的屏幕识别、过时的文件信息、环境里缺少依赖、代码执行结果与界面状态不同步,都可能让下一步判断失准。评测结果告诉我们这条路线值得研究,但还需要更多关于失败类型、权限隔离和恢复策略的证据。
最后,训练数据和教师选择仍然是系统性能的一部分。表3显示,不同轨迹教师的实验结果有差异;移除九个应用领域后的结果也只反映这组数据设置。合成任务能扩大训练规模,但真实桌面工作的多样性还需要在更多应用、软件版本和用户流程中检验。
更稳妥的理解是:OS-Helix 展示了一个可行方向——电脑智能体可以在一条策略里组合界面操作和代码执行,并用按动作步骤平衡的训练目标,减少长代码步骤对训练权重的支配。要把它带进日常工作,还需要权限控制、失败恢复、状态同步以及更多真实环境验证。
龙哥点评
我觉得这篇论文最有意思的地方,不是“智能体终于会写代码了”,而是它把工具选择当成训练问题来处理。很多系统可以把屏幕控制和代码执行拼在一起,但真正困难的是:模型能不能在任务中决定该用哪一种、何时切回来、怎样知道自己真的做对了。OS-Helix 至少把这件事放进了数据、训练和消融实验中一起讨论。
表4也提醒我们,混合能力不是工具越多越好。标准 GSPO 的结果低于监督微调基线,而按动作步骤平衡后的版本才取得更好的成绩。这个差别说明,训练目标会影响模型偏向哪种动作;工程上不能只关心“接口接通了没有”,还要看策略是否把工具用在合适的地方。
如果把它放到实际产品里,我会特别关注三件事:代码运行范围能否限制,重要动作能否让用户确认,执行后能否留下清楚的结果记录。一个能点、能写代码的智能体,只有把这些边界设计好,才可能从演示走向可信的日常工具。论文已经给出能力路线的证据,距离“放心交给它处理电脑”还需要更多安全与真实环境验证。
一句话总结
OS-Helix 把图形界面操作与代码执行放进同一条电脑任务策略,并提出按动作步骤平衡训练信号的方法;在 OSWorld-Verified 的特定评测设置中,模型成功率达到 66.44%。这是一项关于“如何协同操作”的进展,不是通用电脑自动化已经可靠完成的证明。
主要参考资料
论文摘要页
https://arxiv.org/abs/2610.22234
论文全文
https://arxiv.org/html/2610.22234
论文原文文件
https://arxiv.org/pdf/2610.22234
官方项目页
https://os-copilot.github.io/OS-Helix/
官方模型集合
https://huggingface.co/collections/YYangzzzz/os-helix
官方数据集
https://huggingface.co/datasets/YYangzzzz/OS-Helix-Dataset
相近工作:HazardAuditor
https://arxiv.org/abs/2609.15134
相近工作:Do GUI Agents Know When Not to Act?
https://arxiv.org/abs/2609.03438
相近工作:JarvisGUI
https://arxiv.org/abs/2609.10451
图1、图2、图6、图7及表3、表4、表5和公式均摘自 OS-Helix 原论文:https://arxiv.org/abs/2610.22234
本文基于龙哥读论文PaperDaily数据库及PaperMiner的MCP进行汇总整理。本文为论文解读与个人学习笔记,不构成任何论文审核意见,及对产品能力、安全性或商业可用性的保证。

还没有公开留言,欢迎留下你的看法。