方法模型(VesperMUSE);多模态方法(Multi-Modal);可见光方法(RGB)。
室内数据集(PST900);户外数据集(CART);低照度数据集(LL)。
残差网络(ResNet50)和残差网络(ResNet18);平均交并比(mIoU)。
峰值信噪比(PSNR);结构相似度指标(SSIM);低照度增强方法(LLIE)。
各类交并比(IoU);浮点运算量指标(GFLOPs);平均绝对误差指标(MAE)。
真阳性指标(TP);误报指标(FP);漏报指标(FN)。
论文基本信息
原文标题:VesperMUSE: Multi-Modal Fusion Vision Transformer for Image Semantic Segmentation Under Diverse Light Conditions
首次公开:2026年10月15日(arXiv v1)
署名单位:曼彻斯特大学(The University of Manchester)
具体领域:低照度图像增强、热成像融合、语义分割
原论文:https://arxiv.org/abs/2610.21990
龙哥导读
暗光语义分割最麻烦的地方,不是把图片调亮,而是调亮之后仍然要认对人、路、车辆、岩石和水面。曼彻斯特大学的VesperMUSE把热成像、可见光和表面法线放进同一个融合视觉Transformer,并在户外数据集上把平均交并比做到76.72%;它的低照度增强模块只有0.454M参数。更有意思的是,论文同时把失败样本摊开:极暗噪声、颜色偏移、小目标和计算量,仍然是这条路线必须正面回答的问题。
先想象一个搜救场景:可见光相机只拍到一片黑,热成像能告诉你哪里像一个人,但地面、墙面、树木和车辆的边界还要靠视觉结构来判断。如果模型只追求“看起来更亮”,可能得到一张漂亮却不适合分割的图;如果只依赖热信号,又会丢掉颜色与纹理。VesperMUSE的核心问题就是:能不能让不同模态各自补上对方最缺的那部分信息?
这篇论文不是只提出一个分割头,而是把任务拆成三层:先用物理启发的方式合成更像真实世界的低照度图,再用热成像辅助恢复RGB信息,最后把恢复后的RGB、热成像和表面结构一起送入分割网络。这样做的好处是,增强模块和分割模块都能被单独检查,读者也能看清性能究竟来自“变亮”、来自“看到了热”,还是来自“理解了形状”。
一、低照度不是“把亮度滑块往左拖”
很多合成低照度数据的做法,是统一降低亮度,再叠一点噪声。但真实暗光会同时改变曝光、伽马关系、噪声强度、像素之间的统计关系和空间光照分布。只把图像变黑,模型学到的可能是一个过于干净的“暗色滤镜”,到了真实夜间场景就会失灵。
VesperMUSE从正常光照图像N生成低照度图像L,并用几组指标检查退化是否像真的。以信噪比为例,先用平均强度比例对齐整体亮度,再计算残差噪声:
α = μL / μN, σN = √[(1/|Ω|)Σi∈Ω(Li − αNi)²]
SNR = 20 log10(μL / σN)
直觉上,μL描述画面整体有多暗,σN描述暗化过程中引入了多少随机误差。论文还检查归一化互信息、曝光比例、伽马系数、平均亮度和亮度变异系数。PST900 LL与CART LL的平均亮度分别为12.86和12.71,远低于过度变亮的合成数据;伽马系数约为1,说明它没有把暗化过程强行变成夸张的非线性曲线。
这个步骤的价值不在于多了几项统计量,而在于为后面的增强模块提供了更难、更接近真实的输入。论文报告两组低照度数据与正常光照之间的归一化互信息只有0.31和0.29,结构信息确实被大幅压低;增强模型如果只会放大残留信号,很快就会暴露问题。
二、热成像负责“看见”,表面法线负责“分清形状”
VesperMUSE的输入不是单纯的RGB。系统先用热成像作为辅助信号,帮助低照度增强模块在RGB几乎没有纹理时保持边缘;再通过Depth Anything V2估计深度,并从深度计算表面法线。深度回答“远近”,表面法线更像在回答“这个位置朝向哪里”,对墙面、地面、车辆和人的局部几何边界更友好。
这种组合可以用一个夜间手电筒的比喻理解:RGB像眼睛看到的颜色,热成像像在黑暗里摸到的温度轮廓,表面法线像手指沿着物体表面滑过时感到的转折。三者并非重复信息,融合的目的也不是把三张图简单堆叠,而是让网络在某一模态失真时还有别的证据可用。
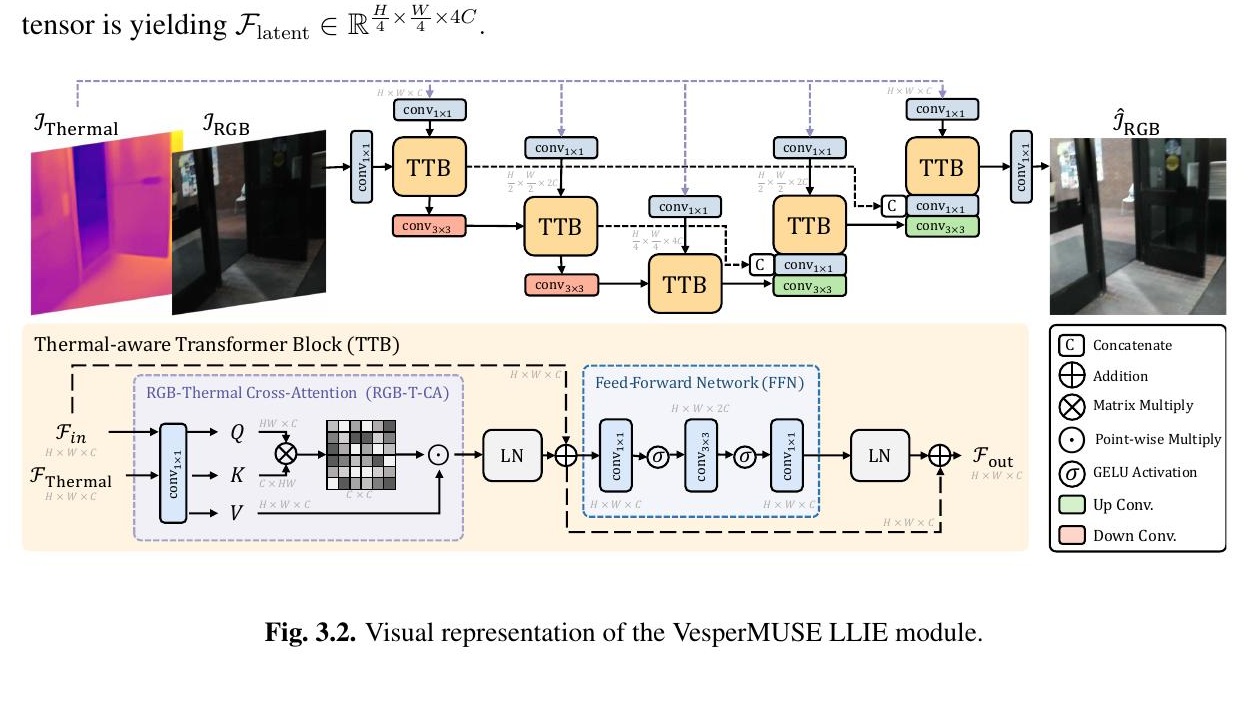
图1|论文Figure 3.2。上方是热成像与RGB输入经过多个Transformer模块得到增强RGB;下方展开一个热成像感知Transformer块,其中交叉注意力与前馈网络共同更新特征。图中C表示拼接,⊕表示相加。
图中的关键单元是Thermal-aware Transformer Block。它先把输入特征与热成像特征投影到查询、键和值,再计算RGB—热成像交叉注意力。可以把它看成“RGB提出问题,热成像提供补充线索”:在可见光边缘已经消失的位置,热信号仍可能帮助网络确定物体是否存在。
增强完成后,分割分支接收RGB、热成像和表面法线三种输入。Transformer负责在不同尺度上交换信息,卷积下采样和上采样维持空间层次,解码器再把高层语义恢复到像素网格。论文采用ResNet50/ResNet18组合骨干,并没有把所有工作都交给一个巨大视觉编码器。
对于语义分割,论文使用平均交并比作为主指标。第i个类别的交并比是TPi/(TPi+FPi+FNi),再对N个类别取平均:
平均交并比 = (1/N) Σi=1N TPi / (TPi + FPi + FNi)
mIoU的好处是不会让一个占满画面的背景类完全掩盖小目标的失败。也正因为如此,后面看到“整体分数不错”时,还要继续看Person、Vehicles、消防器材类inguisher等类别,否则容易把大面积地面和水面分得很好误读成所有目标都可靠。
三、先看增强:小模型也能接近更大的RGB基线
低照度增强模块用PSNR和SSIM与正常光照参考图比较。PSNR更关注逐像素误差,SSIM同时考察亮度、对比度和局部结构;两者一起看,才能避免“像素平均值不错、边缘已经糊掉”的情况。
在两组低照度数据上,增强模块达到27.47/27.74 dB峰值信噪比和0.870/0.858结构相似度。某基线的峰值信噪比略高,为27.58和27.81 dB,但参数量是1.85M;本文增强模块只有0.454M参数,约为其四分之一。
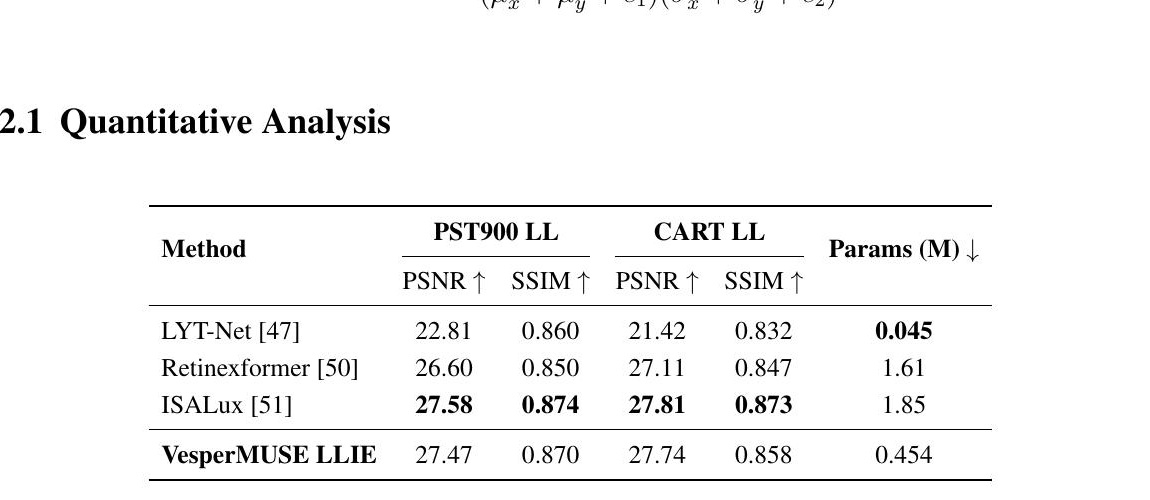
图2|论文Table 4.2。表格比较两组低照度数据上的峰值信噪比、结构相似度及参数量;箭头表示越大越好或越小越好。本文增强模块用较少参数取得接近最优的重建结果。
和另一种低照度增强方法相比,本文增强模块在两个数据集上的峰值信噪比分别高0.87 dB和0.63 dB,而参数量大约少3.5倍。另一轻量方法只有0.045M参数,却在两个数据集上明显落后;这说明轻量化不能只靠删参数,热成像提供的互补信息也可能是恢复质量的一部分。
定性图里,PST900的黄色头盔、红色灭火器和人物在极暗RGB中几乎被噪声吞掉。热成像保留了目标轮廓,LLIE输出进一步恢复了局部对比度;相较部分基线,边缘没有那么容易被抹平,颜色也更接近正常光照。
四、真正的主战场:增强不是终点,分割才是终点
如果增强只让画面更好看,却没有让分割更准,它对下游任务的价值就有限。在室内数据上,完整系统的平均交并比为0.8559,距离一个轻量基线的0.8590只差0.0031;但它在钻头类上达到0.8282,在灭火器类上达到0.8776,说明表面结构对边界清楚、几何形状稳定的物体确实有帮助。
更复杂的户外数据集给出的结果更醒目:完整系统平均交并比为0.7672,高于两个基线的0.7460和0.7400。裸地达到0.8706,道路达到0.6538,车辆达到0.6314;行人只有0.3426,说明“地面与环境结构”比“小而动态的人体目标”更容易被当前系统稳定识别。
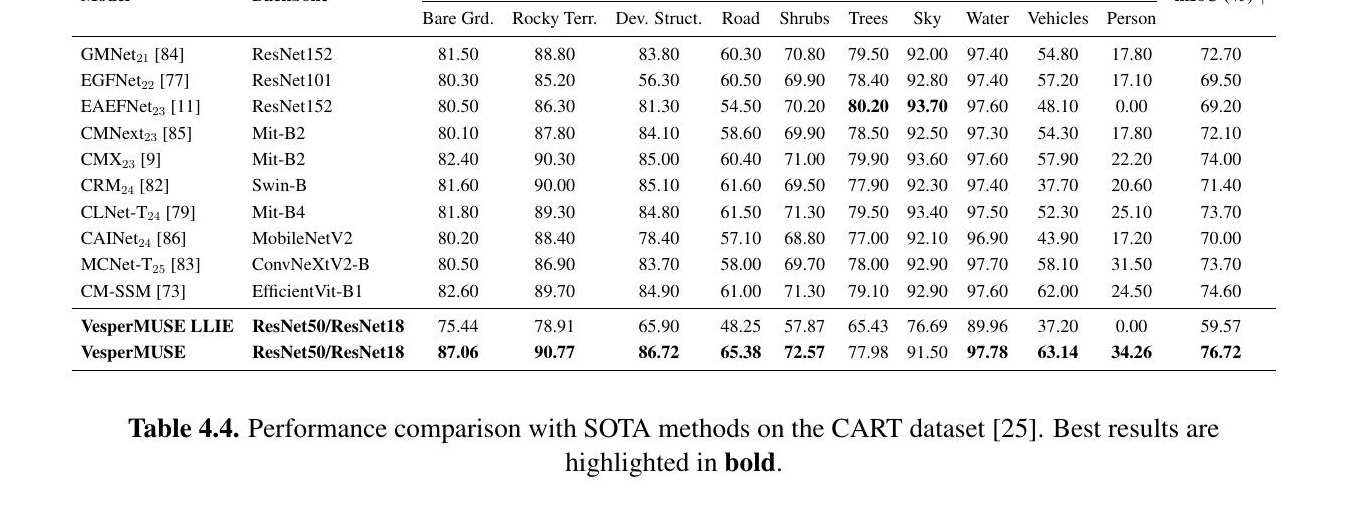
图3|论文Table 4.4。表格列出户外数据各类别交并比与总体平均交并比,比较本文系统和多种可见光—热成像分割基线;本文系统的总分为76.72%。
这张表有一个很重要的读法:VesperMUSE不是每一列都第一,但在大面积地面、岩石、水面和道路上保持了稳定空间结构,同时在车辆上取得较高结果。对于低照度户外场景,纹理被削弱时,热信号与法线提供的几何先验,恰好能够补上RGB缺失的那部分。
室内数据的定性结果也呈现类似逻辑。完整模型能较连续地保留人物和设备边界;单独增强配置在全黑场景中找回了一些被噪声覆盖的结构,但小面积类别仍容易错。户外数据的结果则显示,树木、岩石地形和裸地交错时,多个模型会混淆类别,VesperMUSE在这些复杂区域的主类别判断更稳定。
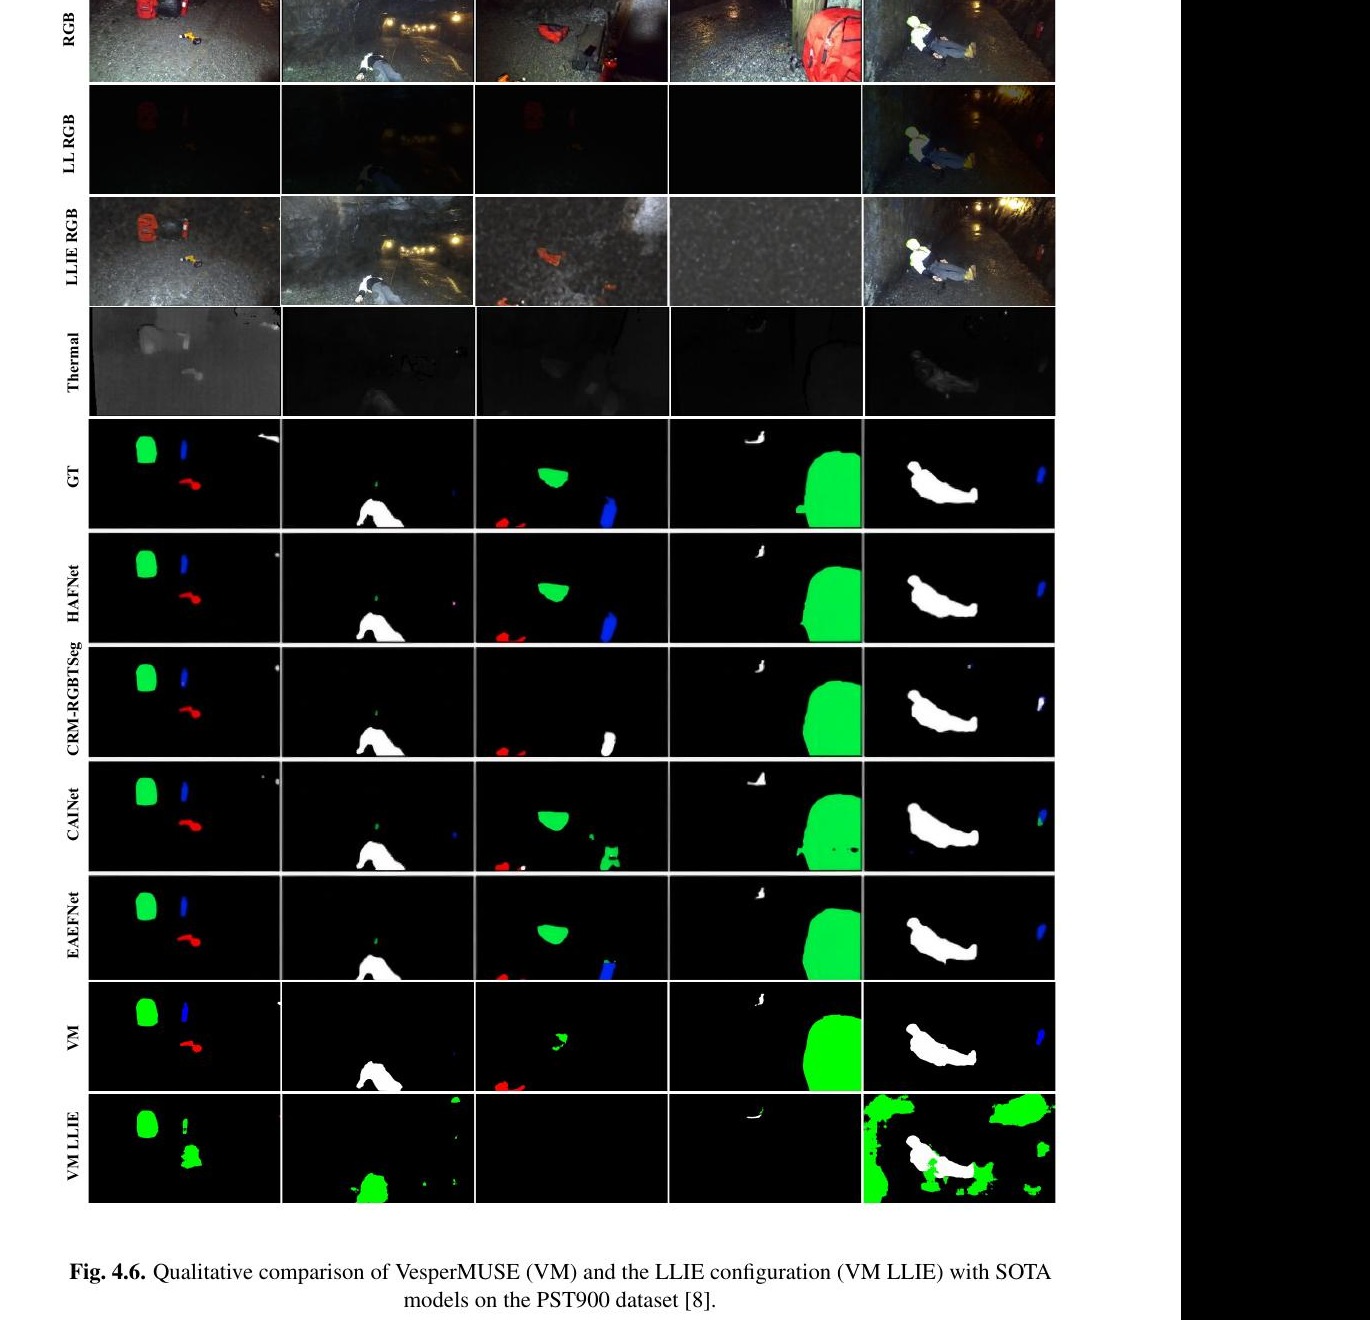
图4|论文Figure 4.6。PST900样例按RGB、低照度RGB、增强RGB、热成像、真实标签和多种分割结果排列,展示黑暗地下场景中的目标恢复与类别预测。
把低照度增强作为输入前处理,室内数据上的该配置平均交并比为0.7818,明显低于完整配置;户外数据上则是0.5957,尤其Person类别为0。增强模块能够改善宏观环境轮廓,却可能改变颜色与细粒度特征,最终是否有利要取决于数据集中的照明方式、噪声和目标面积。
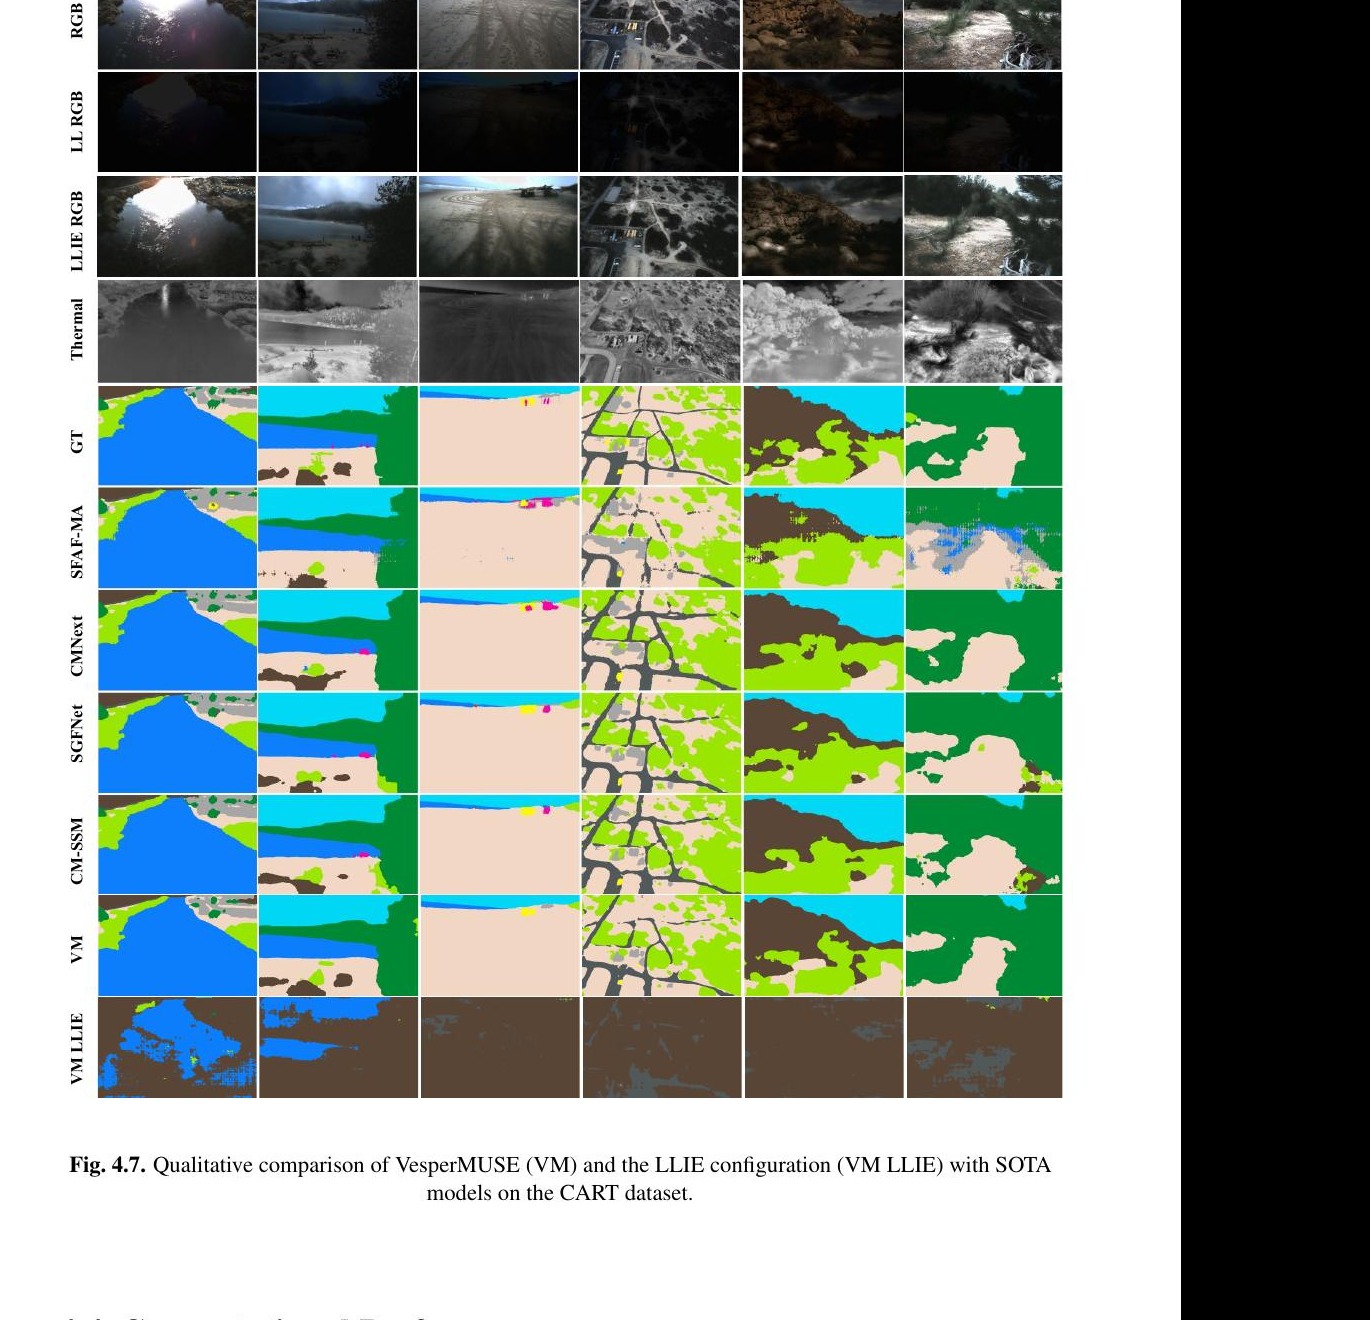
图5|论文Figure 4.7。CART样例对比低照度输入、热成像、真实标签和不同模型输出,底部的LLIE配置在小类别与动态目标上出现更明显的混淆。
五、消融告诉我们:三种输入不是简单叠加
论文的价值还在于没有停留在“多模态有效”这句口号。它比较了可见光、低照度可见光、增强可见光、热成像和表面法线的不同组合,并分别观察每个类别的变化。室内数据上,增强对消防器材类和Survivor帮助明显,两个类别的IoU增益分别约11.6和21.1个百分点;手持钻具与Backpack反而下降,说明小目标和低对比目标不一定从亮度恢复中受益。
CART的情况不同。自然光照更均匀,合成低照度与增强过程对颜色比例的影响更小,因此不增强的低照度RGB输入在多数类别上都更差。但Person类依然难以恢复,原因不是网络没有看到足够多的亮度,而是目标面积小、噪声覆盖比例高,增强前后都缺少可靠证据。
复杂度表也把代价写得很清楚:在480×640输入下,完整系统为321.28 GFLOPs、180.45M参数,平均交并比为76.7%;轻量基线只有10.34 GFLOPs、12.59M参数,平均交并比约74.6%。完整系统比另一基线少约19.3M参数,却仍有更高分数,但它显然不是资源受限设备上的轻量模型。
其中Depth Anything V2单独贡献约43 GFLOPs,三输入还意味着额外的骨干和编码路径。换句话说,表面法线不是免费的提示图;它用计算量换取几何先验。未来如果采用更轻的深度骨干、模态专用编码器、混合精度或量化,才可能把研究结果推进到更实际的端侧部署。
六、把论文实验翻译成几个可复用的判断
第一,热成像不是“万能夜视仪”。它擅长保留热目标的可见性,却不天然提供细腻的颜色、材质和类别边界;所以论文把它放在辅助模态位置,而不是直接用热图替代RGB主输入。这个设计也解释了为什么完整三模态配置比“热成像单独做主模态”更稳。
第二,表面法线的价值在于结构先验,而不是额外的视觉纹理。深度估计后取空间梯度,可以让网络看到物体表面的朝向变化;对于灭火器、手钻、道路边缘和裸地等几何边界更明显的类别,这种信息比继续堆叠RGB通道更直接。论文的消融显示,去掉表面法线会带来约3%的平均性能缺口,说明它不是装饰性输入。
第三,增强和分割之间存在张力。增强模块的目标是恢复颜色、亮度与局部结构,分割模块的目标是区分语义类别;一个对人眼更自然的颜色,未必就是分割器最容易识别的特征。因此论文采用包含MAE、感知、结构相似度和语义一致性的混合损失,把“看起来像正常光照”与“仍然服务语义任务”放进同一训练目标。
第四,mIoU必须和类别面积一起读。CART中的Water平均覆盖像素很多,Person只占很小比例;模型把水面分好,会显著贡献总体分数,但并不会自动带来对人的可靠识别。论文自己报告Person在LLIE配置中为0.0000,这个极端数字比一段“整体表现良好”的描述更能提醒部署者检查小目标。
第五,跨论文比较要分清任务。前两项工作代表可见光—热成像语义分割的背景,后两项更接近低照度增强基线;它们关注的输入、输出和指标并不完全相同。本文的亮点是把两个阶段接成面向分割的系统,而不是只在峰值信噪比榜上击败所有增强模型。
这条思路的可迁移部分,正是“按失败模式选辅助证据”。
因此,如果把这套方法迁移到夜间机器人或无人机,首先要确认设备是否同时提供时间同步的RGB—热成像对,以及深度估计在目标环境中的误差;其次要测小目标、遮挡目标和动态目标,而不能只复制CART的总体mIoU。只有当辅助模态的误差模式与目标场景匹配,多模态融合才是在增加证据,而不是增加噪声。
训练目标也体现了这种“先恢复、再理解”的安排。低照度增强的总损失写成:
LLLIE = α1Lℓ1 + α2Lperc + α3LSSIM + α4Lsem
Lℓ1约束像素强度,感知损失让输出在预训练特征空间接近正常光照,SSIM项维护局部结构,语义一致性项则防止增强把类别相关信息一起改掉。分割阶段采用多类Focal损失和加权Dice损失,并用深监督约束多个解码尺度;前者关注难分类像素,后者对类别不平衡更友好。
数据规模也决定了实验应如何理解:PST900包含894组同步RGB—热成像对,CART包含2282组配准对。论文先在这两组真实配对数据上形成低照度版本,再把增强结果与语义标签联系起来。它不是在一个普通的夜景分类集上做分数,而是在已有RGB—热成像场景中,模拟光照变化后观察分割链路是否仍然闭合。
这也是为什么论文同时报告增强指标和分割指标。PSNR/SSIM回答“恢复得像不像正常光照”,mIoU回答“恢复后还能不能按类别分开”。如果只看第一组指标,会漏掉颜色偏移对类别边界的影响;只看第二组指标,又看不到输入退化是不是已经超出模型可恢复范围。
把整条流程压缩成一句话就是:正常光照图先按曝光、伽马和噪声规律生成暗光版本,热成像引导增强器恢复RGB,Depth Anything V2把深度变成表面法线,三个输入经过各自编码器和融合Transformer,最后由解码器输出每个像素的类别。每一层都对应一个可以单独测量的误差来源。
工程上还要留意传感器配准。热成像、RGB和深度图必须落在相近的空间坐标上,时间不同步也会让移动目标产生错位;网络再强,也很难从互相矛盾的边缘中恢复真实轮廓。论文展示的配准数据结果说明方法在该实验条件下有效,但真正部署时仍需要把标定、同步和温度变化纳入测试。
这类系统的评价也应该增加置信度和失败检测:当Person类别面积很小、热信号与背景接近、或合成退化已经覆盖纹理时,模型应当输出“当前证据不足”的信号,而不是只给一个看似完整的彩色掩码。VesperMUSE已经把不同模态放进同一架构,下一步正是让融合过程对证据质量更加敏感。
还有一个容易被忽略的工程判断:多模态系统的收益必须和传感器同步、标定、深度质量一起评估。热成像画面看起来更稳定,并不等于它在每个物体上都提供同样可靠的边界;表面法线也依赖深度估计,深度一旦在反光、遮挡或极暗区域出错,融合网络就可能把错误先验当成真实结构。把这些输入质量纳入测试,才是从论文分数走向真实部署的关键一步。
七、龙哥点评:它真正贡献的是“让暗光分割有备用证据”
所以,这篇工作的评价不能只看“多模态”三个字,而要看每种模态是否在具体失败条件下提供了可辨认的补偿:热成像补可见性,法线补几何,增强模块补亮度与结构,语义损失则把恢复目标拉回分割任务。
我认为VesperMUSE最值得看的贡献,不是单个mIoU数字,而是把低照度问题从“增强一张图”改成了“为下游分割建立互补证据链”:物理启发的退化让训练输入更接近真实暗光,热成像补RGB丢失的可见性,表面法线补纹理不足时的空间形状,Transformer负责把这些线索放到同一预测里。
它的强项很明确:在CART这类户外环境中,水、岩石、裸地、道路和车辆的结构边界能被较好保留;低照度增强模块在参数量远小于部分基线时,仍保持接近最优的PSNR。对于搜救、夜间巡检、地下空间等需要“先看清再分类”的任务,这条路线比单独追求视觉观感更有工程启发。
但它的限制也同样具体:一小部分合成样本退化过强,信息已经丢失,LLIE无法凭空恢复;增强结果存在颜色失衡,暗部可能偏暖,高光又出现绿色通道裁剪;大规模Fusion Vision Transformer计算量很高。论文还显示Person等小面积动态类别仍不稳定,所以不能把76.72%的总体mIoU直接理解成“黑暗中所有目标都能被可靠识别”。
从这个角度看,VesperMUSE的结果更像一张路线图:先找出单一传感器在暗光下丢掉的证据,再决定用哪一种辅助模态补回来,而不是默认模态越多越好。
对研究者来说,下一步不只是换更大的骨干,而是要回答三个问题:合成低照度怎样避免极端噪声样本?颜色损失怎样约束增强而不压低必要亮度?热成像与表面法线在什么条件下会互相冲突?如果这些问题解决,VesperMUSE的多模态框架才可能从“有用的研究原型”走向“可以长期运行的视觉系统”。
总结:暗光视觉的答案,不是一张更亮的图
VesperMUSE给出的答案是:先模拟真实的光照损失,再用热信号和表面结构补回可见光缺口,最后用多模态融合完成语义分割。它在CART上达到76.72% mIoU,在低照度增强中用0.454M参数取得接近强基线的重建分数,说明“增强—融合—分割”可以形成一条完整链路。
但暗光场景的可靠性不能只由平均分决定。真正值得继续做的,是让模型知道哪些目标已经没有足够证据、让颜色与结构在增强时不被破坏,并把三模态计算成本降到设备可以承受的范围。看得见只是第一关,分得准、知道何时不确定,才是暗光视觉真正的终点。
主要参考资料
论文摘要页
https://arxiv.org/abs/2610.21990
论文官方全文页面
https://arxiv.org/html/2610.21990
论文原文文件
https://arxiv.org/pdf/2610.21990v1
相关论文:PST900
https://ieeexplore.ieee.org/document/9196877
相关论文:论文A
https://doi.org/10.1109/TASE.2020.2993143
相关论文:论文B
https://arxiv.org/abs/2401.15204
相关论文:Retinexformer
https://openaccess.thecvf.com/content/ICCV2023/html/Cai_RetinexFormer_One-Stage_Retinex-Based_Transformer_for_Low-Light_Image_Enhancement_ICCV_2023_paper.html
本文配图取自VesperMUSE官方论文,图号对应原文;表格为官方原文中的必要裁切,定性图保留原始输入、热成像、标签与模型输出排列。
本文基于龙哥读论文PaperDaily数据库及PaperMiner的MCP进行汇总整理。本文为论文解读与个人学习笔记,不构成任何论文审核意见,及对产品能力、安全性或商业可用性的保证。

还没有公开留言,欢迎留下你的看法。