论文基本信息
原文标题:视觉Token剪枝不再一刀切:按样本自适应选择策略
署名单位:新加坡国立大学;香港科技大学
首次公开:2026年9月9日
原论文链接:https://arxiv.org/abs/2609.10346
官方全文页面:https://arxiv.org/html/2609.10346v1
官方原文文档:https://arxiv.org/pdf/2609.10346v1.pdf
龙哥导读
很多团队做视觉Token剪枝时都会掉进同一个坑:为了省算力先固定一个压缩策略,结果线上一碰复杂样本就开始丢精度。样本自适应路由方法(VIP-Router)给出的答案很务实:不要问“哪一种剪枝永远最好”,要问“这一个样本现在最该选哪一种剪枝”。它把“策略选择”做成一个轻量路由器,必要时还能回退到全Token推理,核心价值是把精度损失从系统性问题,降成可控的按样本决策问题。
一、先把真实问题说透:为什么固定剪枝在生产里容易“翻车”
多模态大模型在看一张图时,常常要处理几百到上千个视觉Token。推理成本高,大家自然会想到剪枝:删掉一部分Token,让模型跑快一点、省一点显存。
问题在于,很多方案默认“一个策略吃遍所有样本”。这在论文里的离线平均指标看着可能还行,但上线会遇到两类麻烦。第一类是简单样本被过度保守处理,算力浪费;第二类是困难样本被过度激进压缩,精度突然掉层,尤其在复杂推理问题、长文本视觉问答和细节识别上更明显。
这篇论文不再争“谁是通用最强剪枝器”,而是提出一个更贴近工程的问题:在同一压缩率目标下,能不能针对每个样本动态选择最合适的既有剪枝策略,并在判断剪枝有害时直接回退全Token路径?这就是VIP-Router的出发点。
二、方法主线:不是重新造大模型,而是在外面加一层“样本调度器”
VIP-Router做的事非常克制。它不改主干多模态模型,不要求重训骨干参数,也不推翻已有剪枝器,而是把这些现有剪枝策略当成“工具箱”,再加一个轻量路由器负责“这次用哪把工具”。
路由器读取两类低成本预览信号:图像预览特征和文本预览特征。然后通过文本到视觉的交叉注意机制,把“这道题在问什么”和“图里大概有什么”对齐起来。最终输出不是答案本身,而是某个压缩率下的效用预测,进而选择最可能保住效果的剪枝策略。
如果路由器预测“剪枝会伤害当前样本”,它允许系统走全Token推理。这点很关键,因为它把“快”和“准”的关系从二选一,变成了按样本风险动态平衡。
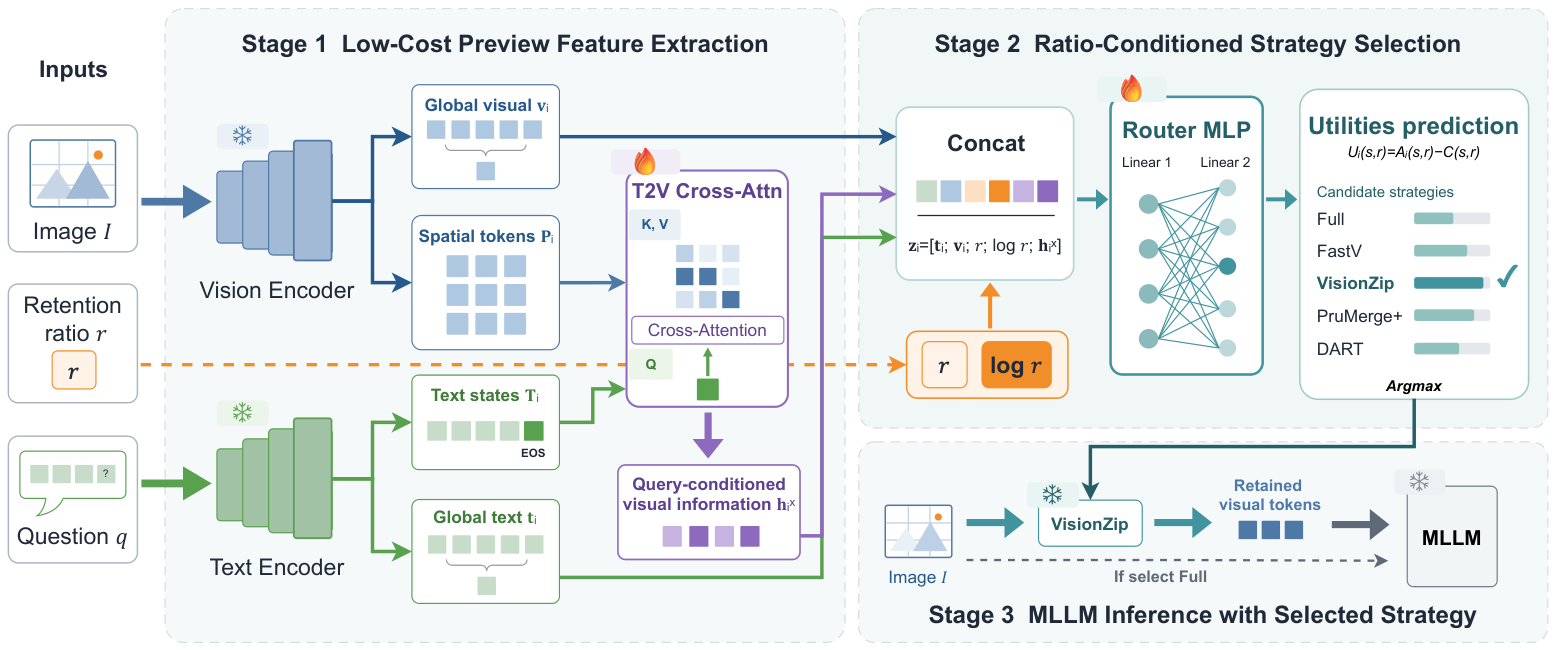
图1:论文给出的路由器框架。左侧是低成本视觉与文本预览,中央是跨模态融合和效用预测,右侧是策略选择与必要时的全Token回退。
三、这篇论文最值钱的点:把“策略互补性”变成可用能力
过去很多比较默认每个剪枝器都有一个稳定强项,然后选单一冠军。VIP-Router强调的是,剪枝器之间并非简单强弱关系,而是“样本依赖的互补关系”:A策略在某类样本上更稳,B策略在另一类样本上更好,固定用其中之一必然会吃到另一个区域的损失。
这也是为什么它的设计没有把重点放在“再造一个更复杂剪枝器”上,而是先把“路由决策”做对。对工程团队来说,这个路线更容易落地:你已有的剪枝器资产不用推翻,先把选择逻辑升级,就能看到明显收益。
论文里多次强调该方法是plug-and-play,这个说法不是营销词。它的真实含义是:路由层可独立迭代,主模型与候选剪枝器保持冻结,部署风险和改造范围都更可控。
四、先看一张总览图:为什么固定策略在不同压缩率下会互有输赢
论文给出的互补性图非常直观:同一批样本、同一批候选策略,在不同压缩率和不同子任务上“最优策略”会来回切换。也就是说,固定策略不是没有价值,而是只能覆盖部分区域。
如果你只盯平均分,很容易以为“选一个全局第一就结束了”。但在生产场景里,用户请求的分布会变,题目难度会变,固定策略的弱点会被放大。VIP-Router等于是给系统加了一个“按样本选路”的主动能力。
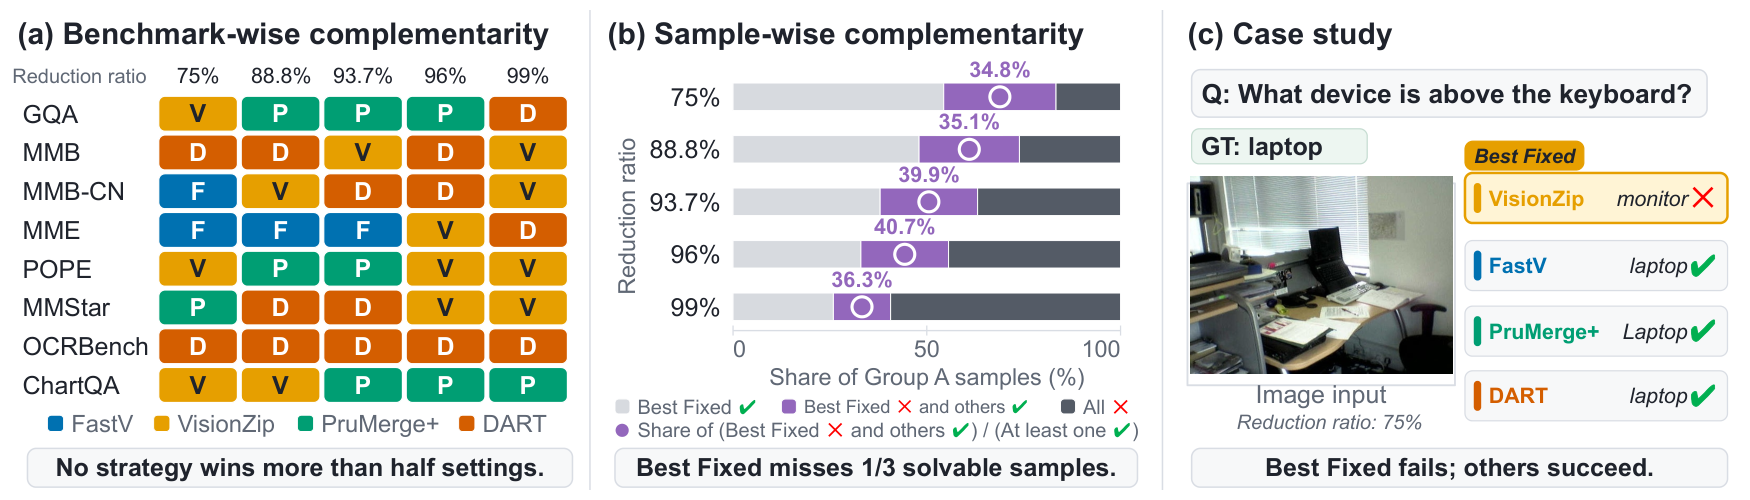
图2:论文展示的策略互补现象。重点不在某条曲线绝对最高,而在“最优策略随样本和压缩率变化”的事实。
五、关键结果不是小幅改进,而是跨压缩率的稳定拉升
论文主结果集中在视觉Token压缩测试集(VTC-Bench)Group A。这里给出的数字很硬:最佳固定策略平均准确率40.35%,VIP-Router到51.19%;最佳固定策略平均效用30.88%,VIP-Router到37.68。前者相对提升26.9%,后者相对提升22.0%。
这类提升的意义在于“跨压缩率都成立”。论文报告在五档视觉Token压缩率上,都有明显收益,不是只在一个甜蜜点偶然赢一次。并且在40个“基准×压缩率”组合中拿下30个第一,宏观Oracle Headroom恢复率26.5%。
对部署方来说,这意味着你不必把系统绑死在单一压缩配置上。业务流量波动时,你可以保持压缩目标不变,让路由器自己选更稳的策略组合。
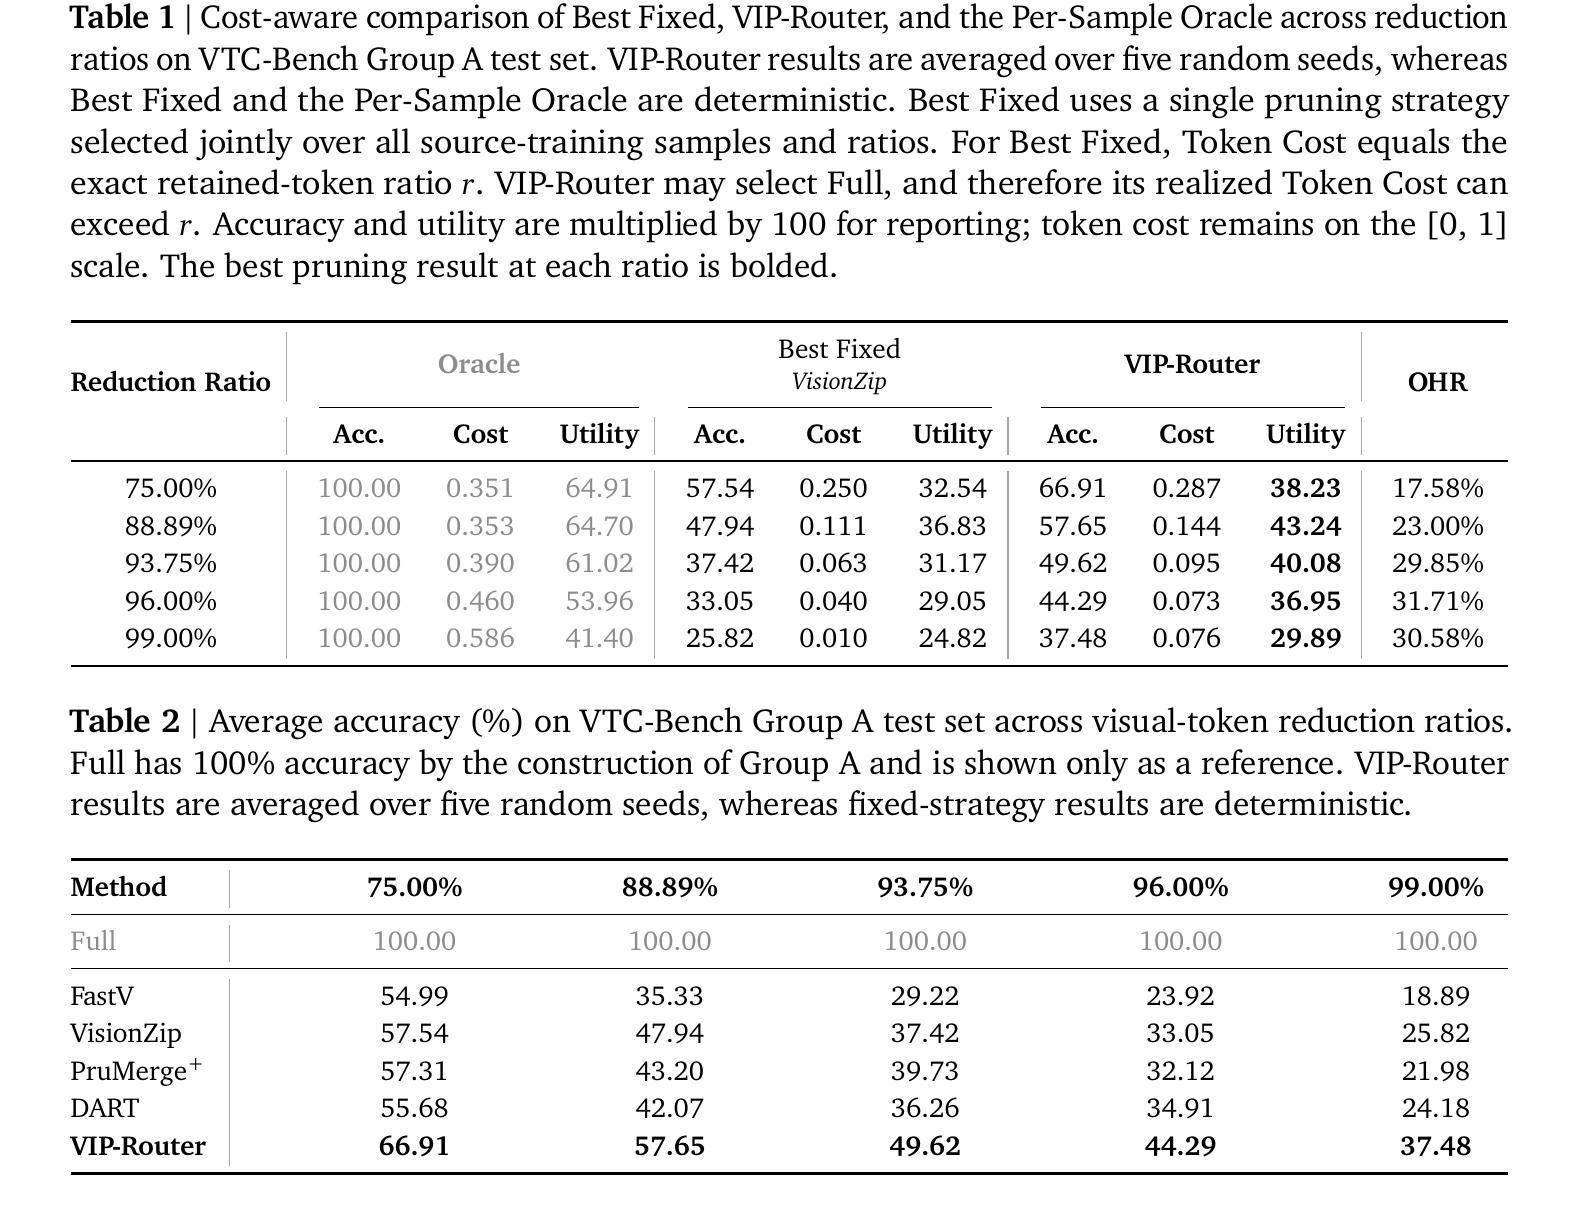
图3(论文表1节选):在成本约束下,VIP-Router相较固定策略保持更高准确率与效用,接近按样本最优选择的上界趋势。
六、为什么小模块能有大收益:它只学“决策”,不重学“理解”
很多人会问:这么大提升,是不是又加了大量参数?论文给出的数字是1.38M可训练参数,占8.291B主干的0.017%。这说明它把学习能力集中在“策略调度”这一个关键动作上,而不是把整个模型再重练一遍。
这类“轻参数、重决策”的设计特别适合上线环境。你不需要大规模重新蒸馏,不需要长周期迁移,也不需要改动主干权重治理流程。上线窗口和回滚成本都更友好。
从系统工程角度看,VIP-Router像是一个可插拔的推理编排层。未来即便你更换主干或引入新的剪枝候选,调度层仍可以独立继续演进。
七、跨主干与未见数据集表现:泛化有收益,但也有边界
论文并没有只在一个主干、一个数据集里报结果,而是覆盖四个主干和四个未见测试集。总体趋势是路由效用提升具有可迁移性,这让方法不只是“某模型某数据的特例”。
但作者也坦诚边界:跨主干直接零样本迁移时,路由器不一定保住全部增益,说明“剪枝偏好”会受主干表示方式影响。换句话说,它不是“训练一次永久通吃”的万能开关。
这个边界并不削弱方法价值,反而给出了清晰工程策略:优先在目标主干上做低成本校准;把零样本迁移视作加分项,而非上线前提。
八、和两篇代表性工作怎么对照看
论文里给出的相似工作之一,重点是把单一剪枝器本身做得更强,追求“一个策略更能打”。
另一条路线聚焦固定压缩范式下的高效视觉Token处理,目标同样偏向“固定范式的更优实现”。
VIP-Router的位置不同:它默认多个策略都可用,重点学习“什么样本该走哪条路线”。可以把它理解为策略层面的元调度器,而不是策略本体的替代者。这正是它能与现有方案叠加的原因。
九、给落地团队的实操建议:先做三步,再谈全量
第一步,把你当前线上样本按“剪枝后是否伤害任务结果”做最小闭环标注。没有这组反馈,路由器无法形成稳定的样本—策略映射,只能靠平均经验值瞎猜。
第二步,不要一次上太多候选策略。先放两到三种你最常用、行为边界清晰的剪枝器,降低搜索空间复杂度。等路由收益稳定,再逐步扩展候选池。
第三步,明确回退触发门槛。VIP-Router的一个核心优势就是“预测剪枝有害时回退全Token”,如果业务侧没有定义清楚回退条件,就会把优势浪费掉。
这三步做完后,再推进跨主干迁移与更细粒度策略。这样节奏更稳,也更容易向业务方解释成本收益。
十、这篇工作真正改变了什么
很多效率优化论文把“快”与“准”视作静态折中关系。VIP-Router把这件事改写为动态决策问题:同一个系统面对不同请求,可以选择不同压缩路径,必要时保留全量视觉信息。
这意味着推理优化从“统一参数调优”,进化成“面向样本的在线调度”。它更接近真实服务系统的运行形态,也更符合流量异质化场景。
从产品角度看,用户并不关心你平均省了多少Token,更关心关键请求是否稳。VIP-Router价值就在这里:尽量把风险留在路由决策层处理,而不是把误差传给最终答案。
十一、局限与适用边界(集中说明)
这篇论文的主结果主要来自剪枝敏感子集VTC-Bench Group A,因此对于包含大量“剪不剪都差不多”的简单样本集合,收益幅度可能不同。上线前需要先做你自己数据分布上的A/B验证。
另外,论文实验环境是单台H200。虽然参数开销极低,但真实生产中的端到端收益还会受服务框架、并发策略、缓存策略和调度器实现影响,不能把论文数字直接等同于业务最终收益。
最后,跨主干零样本迁移并非总是稳定增益。对于主干切换频繁的团队,建议把“轻量路由器快速复训”纳入标准上线流程,而不是把零样本迁移当硬指标。
龙哥点评
我给这篇工作很高评价,原因不在“又快又准”这句口号,而在它给出了一个可直接落地的架构分层:主干负责理解,剪枝器负责压缩,路由器负责调度,回退机制负责兜底。每一层职责清晰,工程上好维护。
它最值得借鉴的是“先承认策略互补,再学习如何选择”。很多团队习惯于找唯一最佳策略,但在复杂线上流量里,唯一最佳往往不存在。VIP-Router把这个常识变成了可训练、可评估、可迁移的模块。
如果你正在做多模态推理优化,这篇论文可以直接转化成行动清单:保留现有剪枝资产,补一个样本级调度层,定义回退门槛,逐步做主干内校准。相比大规模重训,这条路更现实,也更容易在季度内看到可复现收益。
一句话总结:视觉Token压缩不该只问“剪多少”,更该问“这个样本该怎么剪”。VIP-Router把这个问题第一次系统化地跑通了。
龙迷三问
第一问:你现在的线上多模态服务,是统一压缩率+固定策略,还是已经按请求类型做差异化调度?
第二问:你有没有统计过“因为激进剪枝导致答案质量明显下降”的具体样本比例?如果没有,路由器应该先从哪里拿监督信号?
第三问:当预测到剪枝有害时,你的系统是否有明确、低延迟、可观测的全Token回退链路?
主要参考资料
论文摘要页
https://arxiv.org/abs/2609.10346
官方全文页面
https://arxiv.org/html/2609.10346v1
官方原文文档
https://arxiv.org/pdf/2609.10346v1.pdf
相关工作(固定策略剪枝)
https://arxiv.org/abs/2408.02540
相关工作(视觉Token压缩)
https://arxiv.org/abs/2412.04467
本文基于龙哥读论文PaperDaily数据库及PaperMiner的MCP进行汇总整理。本文为论文解读与个人学习笔记,不构成任何论文审核意见,及对产品能力、安全性或商业可用性的保证。
欢迎添加小助手微信 kangjinlonghelper,交流论文阅读、多模态推理优化与线上部署实践。
还没有公开留言,欢迎留下你的看法。