论文基本信息
论文标题:Sample-Guided Exact Top-K Selection for Long-Context Sparse Attention
首次公开时间:2026-09-08
原论文链接:https://arxiv.org/abs/2609.08450
署名单位:Tencent Inc.
开源代码:https://github.com/Tencent/hpc-ops
龙哥导读:真正拖慢长上下文的,可能不是注意力本身,而是“选谁参与注意力”
很多人一谈长上下文注意力优化,第一反应是“把注意力算得更少一点”。这当然没错,但在线上系统里,你经常会遇到一个更现实的问题:你已经把后续注意力限制成固定 K 个 Token 了,结果整个链路还是慢。为什么?因为你每次要先从超长序列里把这 K 个 Token 挑出来,这一步如果挑得不够快,后面的优化就像堵在收费站后面的高速公路,主路再宽也跑不起来。论文聚焦的就是这一步“前 K 名精确选择”。
这篇腾讯的工作就盯住了这个“收费站”:在索引式稀疏注意力里,如何做精确 Top-K 选择,既不牺牲正确性,又尽量减少无效扫描。它不是把问题做成“近似检索”去换速度,而是把“该快的部分快起来,不该省的精确认证一步不省”。对做长上下文推理系统的人来说,这个取舍非常关键:你想要的是稳定可控的工程收益,而不是某些 case 很快、某些 case 翻车。
问题一:为什么精确 Top-K 在长上下文里会变成瓶颈?
先把场景说具体。索引式稀疏注意力的典型流程是:先打一行分数,再从这一行里选 Top-K,再只对这 K 个位置做后续计算。随着上下文从 128K 拉到 256K、512K,甚至接近 1M,单行分数长度会暴涨。你可以把它想象成:每次都要在一条特别长的成绩单里找前 K 名,而且这张成绩单不是定长模板,批次里每行还可能长短不一。
传统高性能精确选择实现,常见做法是先完整扫一遍,摸清排名边界;然后再来一遍,把候选精确收集出来。这个模式在中短序列里还行,但在超长序列下,“边界扫描 + 候选收集”的双重代价会非常显眼。更麻烦的是,线上推理往往不是单一形状,行数、列数、批次结构经常变化,导致固定套路很难一直跑在甜点区。
论文抓住的核心矛盾是:精确 Top-K 的“精确”必须保留,但并不是每个中间步骤都需要同等昂贵。于是它把流程拆成三个层次:先做低成本粗定位,再做必要的完整认证,最后只在剩余不确定边界上细化。这样做的目标不是改变数学语义,而是减少“对最终结果没有贡献的重复工作”。
问题二:腾讯这套采样引导精确选择,到底怎么保证“快了但没变近似”?
论文方法可以理解成“三段式精确筛选”。第一段是采样粗阈值:在当前分数行按固定步长采样,估一个高分区域的粗门槛。这里采样提出的是分数阈值,不是可以跳过的位置名单;没被抽到的位置仍会在第二阶段完整检查。
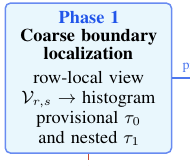
原图4第一阶段局部。row-local view 是当前行的规则采样视图;provisional τ₀ 是临时主阈值,nested τ₁ 是需要时才使用的较宽次级阈值。它们都是提议,不是最终答案。
第二段是完整行认证 + 候选收集:系统仍然做不可省的整行扫描,同时检查采样门槛给出的候选是否足够,并初始化首轮 32 位浮点直方图。关键点在这里:它没有跳过“该完整看的部分”,所以最终精确性底座还在。
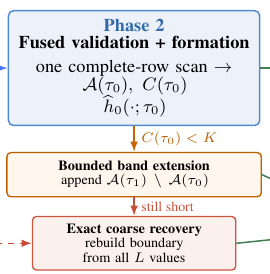
原图4第二阶段局部。C(τ₀) 是完整扫描后满足主阈值的候选数量。C(τ₀)≥K表示高分候选至少够选K个,可以继续精确细化;若少于K个,必须先扩展次级阈值,仍不足就从整行精确恢复,不能拿数量不够的集合直接交卷。
第三段是前沿精细化:只对尚未确定的边界区域继续细化,而不是把整行再重做一遍。如果采样门槛不稳,论文还设计了次级阈值与精确恢复路径,确保在极端分布下也能回到严格正确的结果。换句话说,采样只影响常见路径上的工作量分配,不会把算法本质改成近似检索。
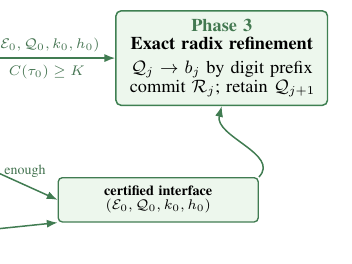
原图4第三阶段局部。certified interface 是认证后的统一状态;exact radix refinement 用原始32位浮点分数继续区分边界候选。已经确定的高分位置不再反复参与细化,只有未解决的边界集合继续推进。这里要求的是精确Top-K集合,并不要求输出按分数排序。
从计算直觉上看,这个流程相当于把“先看全体、再看重点、最后做判决”拆成三个预算层。第一层预算很轻,只负责发现高价值区间;第二层预算最重,但它和最终正确性直接绑定;第三层预算只花在边界争议样本上。这样做的好处是,你把 GPU 时间集中用在“会改变 Top-K 结果”的位置,而不是平均摊到所有位置。
实验配置按步长128采样,粗阈值瞄准的候选总量约为1.5K,不是在K之外再额外留1.5K。这里K=2048,目标约3072个候选,给门槛估计留一些余量,再精确收紧到2048个。采样只用于粗定位,细化依旧使用原始32位浮点分数。
工程实现根据形状切换常驻内核、KV-split和直接精确路径,并支持计算图捕获。KV-split在这里是拆分长分数行的扫描,不是拆分键值缓存:几个计算块分别扫互不重叠的区域,把计数、候选和直方图合并,再由一个收尾单元完成精确细化。它主要解决少量长行的并行度问题。
一个示意例子:假设一行分数长度接近 1M,K=2048。传统做法会在大范围里反复确认“谁靠近边界”;这套方法先用采样把注意力集中到更可能进入前 K 的区间,再在完整扫描时同步认证与收集,最后仅对边界附近继续精排。最终集合与精确基线一致,但大量“无贡献扫描”被消掉了。
问题三:实验结果到底说明了什么,哪些场景能拿到真实收益?
论文实验环境是 NVIDIA H20 96GiB,K 固定 2048,输入来自真实索引器的 32 位浮点分数。它覆盖了 20 种配置(行数 512 到 8192,列数 128K/256K/512K/约 1M),并且逐组做了集合级精确性验证。结果显示,这套方法相比每种形状下最快的外部精确实现,速度提升在 1.29 倍到 1.75 倍之间,几何平均 1.55 倍。
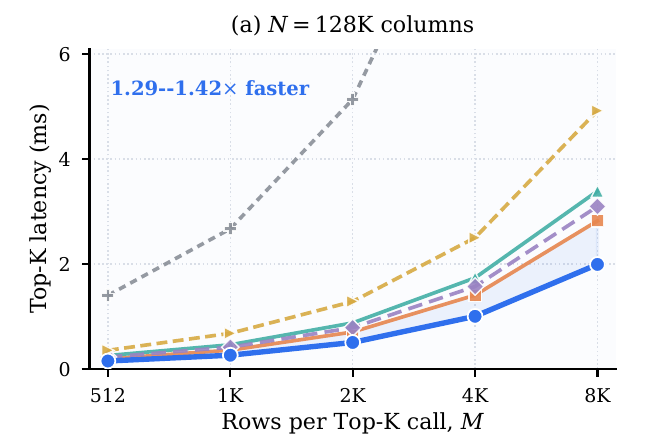
原图7(a)单独放大。横轴是一次调用的行数,纵轴是Top-K耗时,单位毫秒,越低越好。蓝色实线为HPC-Ops,橙色为SGLang,青色为vLLM,紫色为TensorRT-LLM,黄色为FlashInfer,灰色为PyTorch。列宽128K时,相对各形状最快有效精确基线快1.29—1.42倍。
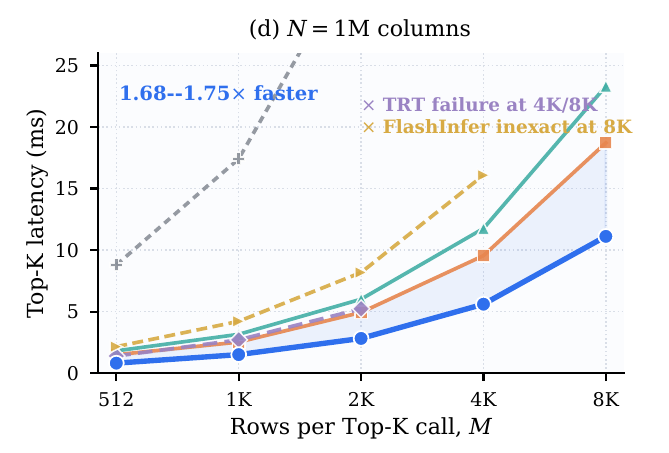
原图7(d)颜色含义相同,分配列宽增至1M时,蓝线相对最快有效精确基线快1.68—1.75倍。图中的失败或不精确标记不是“可用但更慢”的成绩,不计入有效基线。两图的差异说明,在这些捕获输入上,减少额外整行扫描对更宽分数行更有价值。
只看算子速度还不够,论文还做了框架轨迹回放:245K 与 430K 两个长上下文轨迹里,前 K 名选择总时延分别从 77.15ms 降到 56.53ms、从 233.50ms 降到 158.12ms,对应 1.36 倍和 1.48 倍。再接到同一套低精度矩阵打分内核后,整条“打分 + 选择”链路分别节省 9.15ms 和 13.31ms。
这几个口径不能混用:1.55倍是20种算子配置加速比的几何平均,不是平均每次调用省了55%的时间;1.36和1.48倍是两条框架轨迹里的Top-K总时延之比;9.15和13.31毫秒是“打分加选择”这段链路的节省。它们都不是完整模型端到端的提速倍数。做容量评估时,应先看这段原来占业务总耗时多少。
从适用性看,这套方法最适合已经采用索引式稀疏注意力、并且 Top-K 开始卡住整体吞吐的系统。尤其在分数行更宽、上下文更长时,收益通常更明显。它的价值不是“让所有系统都立刻翻倍”,而是提供一个不牺牲精确语义、可并入现有推理栈的稳定提速方案。
如果你是推理平台负责人,可以把这类优化放在“中层算子治理”里理解:上层是模型策略,下层是硬件内核,中层负责把不同模型调用模式压进稳定的算子执行形态。HPC-Ops 这篇的实用意义就在这里——它不要求你重训模型,也不要求你改业务协议,而是在推理内核层给出可落地、可回归、可观测的提速杠杆。
问题四:边界在哪里?哪些结论现在还不能直接外推?
第一,证据主要来自单一硬件平台(H20)、固定 K(2048)、32 位浮点分数和特定索引器分布。迁移到别的硬件、不同 K、低精度分数,理论上可以尝试,但“能快多少、还稳不稳”需要你自己补验证。
第二,论文重点是 Top-K 选择算子与框架回放,不等于完整模型端到端吞吐和最终任务指标都已覆盖。换句话说,它非常适合回答“这一段卡不卡、优化后能省多少”,但还不能单独回答“整个产品体验会提升多少”。
第三,算法仍然需要完整扫描每行,优化点是减少额外边界扫描和重复工作,不是把复杂度彻底改成与序列长度无关。这意味着当你系统里真正最慢的环节不是 Top-K 时,收益会被上游或下游吞掉。
第四,若你线上负载的形状分布与论文实验差异很大,比如极端短行比例很高、或者 K 的配置经常变化,建议先做 A/B 基准,再决定是否全量切换。论文已经给了一个很好的“可验证范式”:先算子级,再轨迹级,再整链路级,逐层确认,不赌一次性上线。
迁移验证时,除了平均时延,还建议按不同批量大小、上下文长度观察最慢一小部分请求。P95/P99指95%或99%的请求都能在该时间内完成。这是部署建议,不是论文已经报告的收益:精确恢复保证的是候选不足时结果仍正确,不能据此声称它已经降低了线上尾延迟。
龙哥点评:这类工作最可贵的不是“更快”,而是“可控地更快”
我最看重这篇的点有三个。第一,它把问题压在真实痛点上:不是泛泛谈“长上下文优化”,而是盯住精确 Top-K 这个很多团队都会遇到、却不容易讲清楚的瓶颈。第二,它坚持精确语义,不靠近似结果换速度,工程落地风险更可控。第三,它给了多层证据:形状基准、轨迹回放、整链路节省,信息密度高、可复现实验路径清楚。
我也有两个担心。一个是跨硬件、跨精度、跨 K 的泛化还需要更多公开证据;另一个是很多团队会在“看到 1.55 倍”后预期过高,却忽略整链路里只能省 9~13ms 这种更真实的口径。真正上线时,最怕的不是提速不够,而是预期管理失真导致决策摇摆。
如果你准备验证这篇,我建议下一步就做三件事:1)复现论文同形状基准,确认精确一致;2)放进你自己的真实轨迹做回放,重点看 P95/P99;3)把收益折算到端到端业务指标,再判断值不值得投入迁移成本。做到这三步,这篇论文就不只是“看过”,而是能转化成你的系统决策依据。
参考资料
1. 论文主页(arXiv):https://arxiv.org/abs/2609.08450
2. 论文网页全文:https://arxiv.org/html/2609.08450v1
3. 官方代码仓库:https://github.com/Tencent/hpc-ops
本文基于龙哥读论文PaperDaily数据库及PaperMiner的MCP进行汇总整理。本文为论文解读与个人学习笔记,不构成任何论文审核意见,及对产品能力、安全性或商业可用性的保证。

还没有公开留言,欢迎留下你的看法。