龙哥导读
DNA是储存遗传信息的分子。同一段DNA发生变化,在不同细胞里可能产生不同影响。谷歌DeepMind发布基因调控预测模型(AlphaGenome)的第二代,让基因AI从组织的“平均值”,进一步走向具体细胞类型和状态。在作者的一项免疫细胞评测中,保持90%精确率时,关键变异候选的召回率从16%提高到30%。
心肌细胞和免疫细胞,可以拿着同一本DNA“说明书”,却做着完全不同的工作。原因之一是:它们打开、关闭基因的方式不同。
因此,要判断一个DNA字母变化会带来什么后果,光读序列还不够,还得问一句:它发生作用的,究竟是哪种细胞、什么状态?
北京时间2026年11月11日23:00,Google DeepMind公布AlphaGenome 2。这次升级瞄准的,正是基因研究里这个常被“平均值”掩盖的问题。
01 先找到细胞,再理解变异
想象一栋办公楼:每个房间都备着相同的操作手册,但财务室、机房和实验室,需要执行的章节不同。这只是理解基因调控的类比——相同的文字,在不同环境中,未必产生相同效果。
旧版AlphaGenome已经能读入长达约100万个字母的DNA,预测多种分子活动。不过,它主要学习整块组织或培养细胞系的数据,再同时预测一组预先设定好的输出。
这有点像知道整栋楼平均用了多少电,却不容易看清究竟是哪间房间在耗电。组织里少数细胞特有的信号,可能被平均掉。
二代模型把问题改成:给定这段DNA,在指定的细胞类型或细胞状态下,会出现什么调控活动?输入不只有DNA,还包括目标生物条件;技术报告同时明确了人或小鼠的物种输入。
它要预测的内容包括基因表达、染色质可及性等。前者可以简单理解为基因有多活跃;后者是DNA所在区域是否容易被细胞内的调控机器接近。二代还增加了DNA甲基化这一类读数。
02 16%到30%,真正变好的是什么?
DeepMind团队在技术报告中,使用单细胞评测数据集(TenK10K)的28类免疫细胞表达数据,比较了二代模型与经过单细胞数据微调的前代模型。
这里有两个不同的问题。第一个是:哪些变异更可能影响基因表达?第二个是:这种影响会把表达往上推,还是往下拉?
对于第一个问题,在精确率固定为90%时,召回率由16%升到30%。通俗地说,先把“挑出来的候选有多可靠”保持在同一个水平,再看能从评测中的目标里找回多少;二代找回的比例接近前代的两倍。
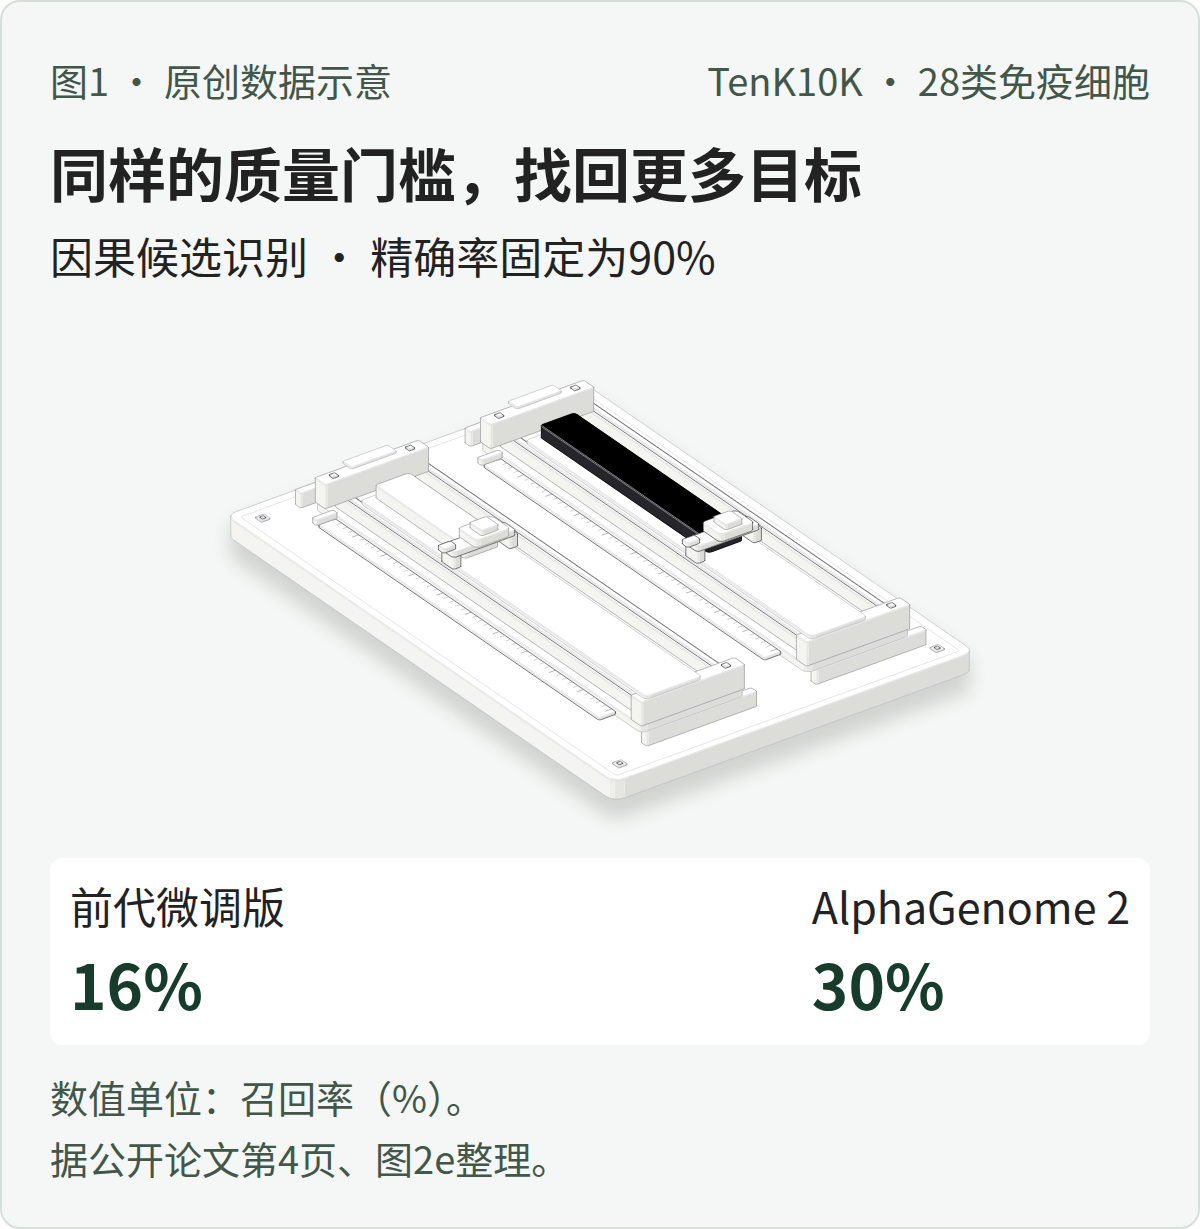
同一评测、同一精确率门槛下的召回率对比。原创数据示意。
对于影响方向,作者在方向判断正确率固定为90%时,报告召回率由23%提高到43%。这与上面的90%精确率不是同一个指标,不能混成一句“准确率翻倍”。
这些数字的科研意义在于:实验室往往没法把所有候选逐一做实验。如果在较高可靠性下,还能少漏掉一些目标,后续实验就有机会从更完整的候选名单出发。
03 不是最后加个标签,而是从前面就告诉模型
为什么细胞条件能带来变化?这次不是等DNA处理完了,再给结果贴上“免疫细胞”或“心肌细胞”的标签。
技术报告描述,细胞条件会进入模型的早期处理层,并贯穿编码、中央处理和解码过程。也就是说,模型从开始阅读这段序列时,就知道自己要回答哪一种生物环境里的问题。
作者还做了拆解比较:如果只在输出端或后面的解码层加入条件,改善很小;让条件进入更靠前的编码层和中央处理部分,才带来主要提升。这使得“把细胞状态放进去”不只是一个新输入框,而是模型处理信息方式的变化。
训练材料也跟着扩展。论文与公告列出了超过1.07亿个人类单细胞表达记录,覆盖68种组织;此外还结合了人和小鼠的组织级、单细胞相关数据。
更实用的一点是:研究者遇到新细胞状态时,可以提供该状态的单细胞基因活动数据,让细胞编码器把它转换成模型可理解的条件,不必为每一种新状态重新训练整套模型。
这回答的是一个真实需求:实验能测到的状态越来越多,而模型预先列好的类别,不可能永远跟上。
04 从“有哪些变化”,走向“在哪些细胞里起作用”
把这次工作与此前的AlphaGenome Atlas放在一起,路线就更清楚了。
AlphaGenome Atlas做的是大范围预计算:把人类基因组中可能发生的单字母变化,提前预测一遍,帮助研究者筛选和理解非编码变异。它更像一张广覆盖的查询地图。
AlphaGenome 2则在另一个维度上细分问题:同一个候选变化,在哪种细胞里更值得研究?前者强调覆盖面,后者强化细胞环境。两者有关联,但不是同一项资源换了名字。
例如,官方用炎症性肠病相关的ETS2调控机制说明新模型的作用:此前实验已经发现,一个远处调控区域的变异,会推动肠道巨噬细胞中的ETS2活动。二代模型在计算预测中重现了这一细胞类型相关的信号。
这个例子好理解:同一个调控开关,不是把全身所有房间的灯一起打开,而是在特定房间里更明显地起作用。它的价值,是把研究线索定位得更具体。
05 龙哥点评:AI开始学会问“在哪种环境下”
龙哥觉得,这次最值得关注的,不是又增加了一个“基因大模型”的名字,而是它把问题问得更像真正的生物学研究:同一段DNA,在什么细胞、什么状态下,影响什么活动?
很多AI系统习惯给出一个统一答案。但在科学问题里,环境经常就是答案的一部分。把所有状态平均起来,模型可能看似表现不错,却错过真正需要追查的那一小群细胞。
对做实验的人,更有用的结果未必是自动给出一个宏大结论,而是帮忙决定:有限的经费和时间,下一步先查哪个变异、哪种细胞、哪条调控链。这才是这类模型最值得争取的实际收益。
也要把成果放回合适的位置:上述性能数字来自作者的基准评测;候选变异的优先级不是临床诊断,计算预测也不等于又做出了一次独立生物实验。ETS2例子对应的是对既有实验机制的计算重现,不是这次才首次发现疾病原因。
发布公告明确,AlphaGenome 2面向非商业研究开放,商业研究处于私密预览,仅限研究用途;面向Antigravity的相关技能仍是后续计划。
接下来最值得等的,是独立实验室把这些候选带回真实实验:如果更多过去被平均值盖住的细胞信号能被找到,这次升级才会从更好的预测,走向更好的发现。
主要参考资料
Google DeepMind发布公告(2026年11月11日)
https://deepmind.google/blog/alphagenome-2-deciphering-how-cells-read-dna-to-better-understand-disease/
AlphaGenome 2 predicts regulatory activity and variant effects across cell states
https://storage.googleapis.com/deepmind-media/DeepMind.com/Blog/alphagenome-2-deciphering-how-cells-read-dna-to-better-understand-disease/alphagenome-2.pdf
AlphaGenome Atlas: in silico mutagenesis of the entire human genome improves prioritization and interpretation of non-coding variants
https://storage.googleapis.com/deepmind-media/DeepMind.com/Blog/alphagenome-atlas-a-predictive-map-of-every-possible-dna-letter-change-in-the-human-genome/alphagenome-atlas.pdf
The Decoder对新模型的报道(2026年11月12日)
https://the-decoder.com/google-deepmind-shifts-genomics-ai-from-bulk-tissue-predictions-to-single-cell-type-resolution-with-alphagenome-2/
本文依据Google DeepMind公告、技术报告及相关公开报道整理,性能结果按作者评测归因。本文基于龙哥读论文PaperDaily数据库及PaperMiner的MCP进行汇总整理。
更多论文解读、公开证据评分与评分依据:https://www.longzhangge.com/PaperDaily

还没有公开留言,欢迎留下你的看法。