← 返回 PaperDaily
大模型与智能体
arXiv最新定理:去掉单调性,LLM与压缩的等价就崩了
"压缩即智能"这句话流传了很多年,但一直停留在直觉和实验结果上。这篇论文第一次把它写成了定理:语言模型和单调压缩是等价的,误差只差2比特;而一旦去掉"单调"这个条件,等价关系就崩了,除非某个密码学假设不成立。
龙哥读论文
发布于 2026-10-16 01:12:05
阅读 11
查看原文
原论文信息如下:
LLM真的等于压缩吗?一个困扰学界多年的猜想 先抛一个问题:如果把整个互联网压进一个压缩包,解压之后出来的东西,算不算一个理解了世界的大脑?
这听起来像饭后闲聊,但它在AI理论圈被认真吵了好几年。
直觉是这样搭的:一段文字里如果全是随机乱码,谁都压不动;如果里面藏着语法、逻辑、反复出现的模式,好的压缩器就能用更短的编码把它描述出来。压缩率越高,说明它抓住的规律越多。而"抓住规律"换个说法,就是"理解"。
这个直觉在最近两年被大语言模型推到了台面上。Delétang 等人在 ICLR 2024 的工作证明,大语言模型可以直接拿来做强悍的压缩器,压缩率能和中上等的通用压缩算法掰手腕。Huang 等人在 COLM 2024 的工作进一步发现,一个模型的压缩能力和它在知识、推理、写代码这些基准上的得分高度相关——压得越好,答题越准。
正方向既然通了,那反方向呢?能不能从一个好的压缩算法,反推出一个能预测下一个词的模型?这样一来,"预测"和"压缩"就彻底打通了。
问题恰恰出在这儿。反向构造确实有人试过。Delétang 等人提出过一个启发式方案:想知道下一个词的概率,就看加上这个词之后压缩长度变了多少。方法能用,但效果和真正的大模型比差得远。正方向(模型→压缩)能打,反方向(压缩→模型)很弱。说好的"等价",为什么两个方向的表现差了这么多?这个悬案一直没人给出正式解释。
这篇论文把手伸向了这个悬案。作者是 Noam Mazor、Andrew Morgan 和 Rafael Pass 三人,2026年10月挂上 arXiv,标题直截了当:《Language Modeling is Monotone Compression》(语言建模即单调压缩)。它给出的答案是:这两个方向确实等价,只差在一个容易被忽略的限定条件上——单调性
一句话总结这篇论文的价值:它没有停留在"压缩和智能像不像一回事"这种玄学讨论上,而是把这个直觉做成了一条能被证明、能被反驳、还带定量间隙的定理。更难得的是,它顺手解释了为什么实践里两个方向会这么不对称。🤔
从香农到Transformer:压缩与智能的百年纠葛 要理解这个结论的分量,得先把"压缩"这件事的老底翻一翻。
1948年,香农在《通信的数学理论》里给出了信息论的地基。他定义了一个分布的信息量——熵,衡量的是"平均而言,描述从这个分布里抽出的一个样本最少需要多少比特"。这个定义至今还是所有压缩算法的天花板:
紧接着,香农的源编码定理给出了更硬的结论:任何前缀无关的编码方案,它的期望编码长度都不可能低于熵。这等于给所有压缩算法划了一条最低水位线。
把这条理论落到工程上,靠的是算术编码。它的思想很朴素:把每个可能的输出看成数轴上的一段区间,区间长度等于它的概率,然后按字典序把这些区间一段段排好,用落在区间里的一串二进制小数表示这个输出。概率越大的输出,区间越宽,需要的比特越少。
用神经网络预测器去喂算术编码这条路,1994年就有人试过。之后大语言模型出现,这条线的表现突然变得很强:模型输出的下一词概率越准,算术编码压出来的长度就越接近熵。数学上的原因很简单——模型的训练目标是最小化负对数似然,这个量乘起来取负对数,正好就是完整输出的码长。
反方向就麻烦得多。2000年 Feldman 和 Cole 曾用压缩算法做过文本分类;2024年 Delétang 等人提出的启发式构造,是用"前缀压缩长度"和"前缀加一个词后的压缩长度"之差来近似下一词概率。这个方案有个好处:它不需要压缩算法单调。但它有个代价,每生成一个词都要重新做一次部分压缩,每次近似都可能引入一份误差,而误差会在生成过程中一层层累积。所以反向构造的实际效果总是不够看。
这就是本文要捅破的那层窗户纸:为什么正方向顺水推舟,反方向磕磕绊绊。
核心定理:自回归模型与单调压缩的精确等价 先说清楚"单调压缩"到底指什么。压缩算法把输入映射成二进制码字。如果在输入上定义了一个字典序(按字符先后排出的顺序),压缩之后码字也保持同样的顺序——小的输入得到小的码字,大的输入得到大的码字——这个压缩就被称为单调的,也叫保序(order-preserving)。
第一,如果存在一个高效可计算的、对 D 是 δ-最优的自回归模型,那么可以构造出一个高效可计算的单调压缩方案,它对 D 的损失最多是 δ+2。
第二,如果存在一个高效可计算的、对 D 是 δ-最优的单调压缩方案,那么可以构造出一个 δ-最优的自回归模型。
一句话:自回归模型和单调压缩器,在相差2比特的意义上完全等价。而且这个2比特不是随口给的常数,它正来自前面算术编码的那个固定开销。两个方向都给了显式的高效构造,不是只证明存在性。
这里的 δ-最优该怎么理解?一个模型能压到的最优长度是熵 H(D),多出来的那部分损失用 KL 散度衡量。δ-最优的意思就是:模型的交叉熵最多比熵高出 δ。KL 散度长这样:
交叉熵、熵、KL 散度三者之间还有一个漂亮的恒等关系,整篇论文的证明都在用它:
第一个方向基本是把算术编码重新走一遍。给定模型 M,把它的输出分布 D_M 喂给算术编码,每个输出 x 得到一个码字,长度不超过负对数概率加2。对每个样本都成立的不等式,自然可以取期望:
再把交叉熵拆成熵加 KL 散度,就得到这条贯穿全文的不等式:
而算术编码本身的结构保证了单调性:它按字典序给各个输出安排概率区间,码字顺序也按同一顺序排。两头用的是同一把尺子,保序关系自然成立。
要让这套东西跑得动,还得能高效计算累积分布函数(CDF)。论文给出了一个递归公式,把"某个输出小于给定串 y"的概率,拆成"每一层前缀首次出现分岔"的贡献之和:
这个式子的意思可以掰开说:让一个随机输出和 y 从头逐位比。要么在某一位置 x 挑了一个比 y 对应位置更小的 token,此后 x 必然小于 y,无论后面怎么走;要么这一位和 y 完全一致,把分岔留到后面。把所有互不重叠的可能性加起来,就得到"x 字典序小于 y"的总概率。再补上 x 恰好等于 y 的那一部分,就是完整的 CDF。整个过程只需要多项式次的下一 token 概率查询,所以只要模型的下一 token 概率能高效算,整套 CDF 也能高效算。
反方向更有意思。给定一个前缀无关、单调的编码 Enc,要构造一个模型,让它的输出分布满足下面这条概率下界:
这个下界为什么有用?两边取负对数,就变成每个样本的损失不超过它的编码长度:
构造分两步。第一步,造一个采样器 Sample:抽一个长度为 ℓ 的均匀随机比特串 c,按长度从小到大检查它的各个前缀,找到第一个有效码字就把它解出来。因为编码是单调的,解码过程可以用二分查找完成;如果所有前缀都不是有效码字,就返回满足 Enc(x) ≤ c 的最小输入 x。这个采样器有一个关键性质:弱单调性
第二步,把这个采样器包装成一个自回归模型。对任意输出 x,只要随机串 c 以 Enc(x) 开头,采样器就必定返回 x——前缀无关性保证了没有更短的有效码字能抢先。而"c 以 Enc(x) 开头"这个事件的概率恰好是 2 的负编码长度次方,图9那条概率下界就是这么来的。
剩下的问题是:下一 token 的概率怎么算出来。论文的解法还是二分查找。把 ℓ 位随机串看成 0 到 2^ℓ-1 的整数,由弱单调性,所有满足 Sample(c) ≼ y 的随机串必然构成一段前缀区间 c < k(y)。找到最小的 c 使得 Sample(c) 严格大于 y,就确定了 k(y)。于是累积分布就是:
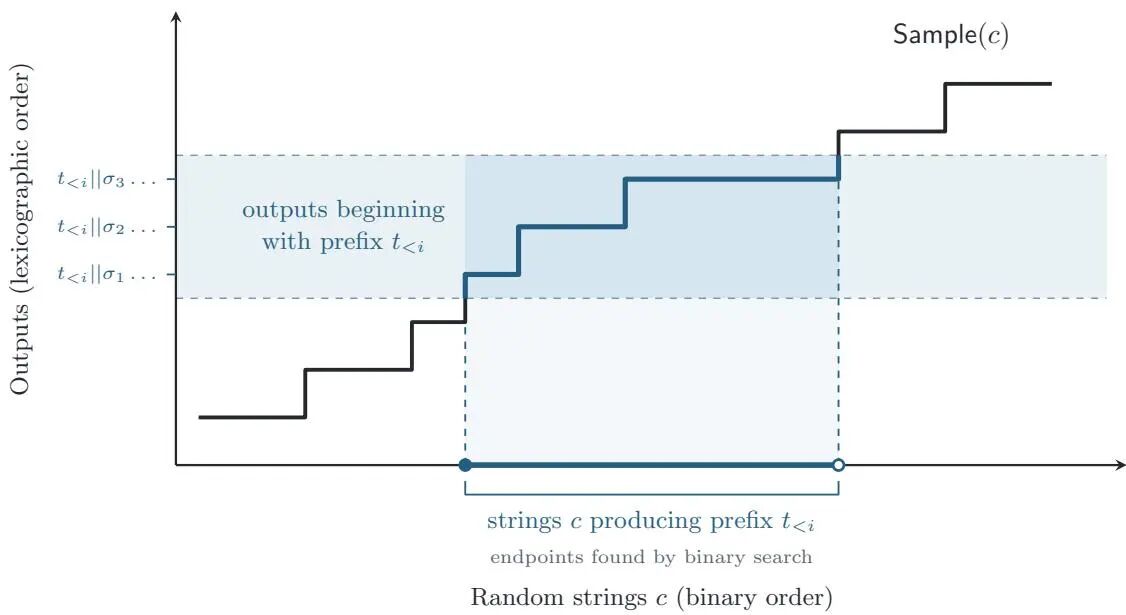
下一 token 概率则来自一个经典观察:共享同一个前缀的所有输出,在字典序里必然连成一段连续区间。所以前缀概率可以用两个 CDF 值相减得到,下一 token 概率再用前缀概率相除。这套流程的可视化就是全文最直观的那张图:
这张图是全文的枢纽。横轴是随机串空间,纵轴是输出空间,采样器把两者连成一道"阶梯"。想知道"以某个前缀开头的输出占多大比例",只需在横轴上圈出一段区间,数一数里面有多少个随机串。前缀概率、下一 token 概率,全都从这一次区间查询里推出来。赞。
和 Delétang 等人的方案比,差别就落在"看多远"这三个字上。他们的做法是"短视"的:只看前缀和前缀加一个词之后的压缩长度差,每次采样新 token 就重新近似一遍,误差一层层叠加。本文的构造是"向前看"的:先从压缩方案还原出一套完整的输出分布,此后所有 token 都相对这同一个分布采样,误差只在整体上算一次。这解释了为什么反方向用启发式方法效果差,用本文构造就能对得上。
单向函数:为什么单调性是必须的 到这里有个问题绕不过去:为什么非得是"单调"压缩?非单调的压缩难道不行吗?
本文的第二个定理给出了答案,而且答案和密码学挂上了钩。结论分成两半,取决于一个被广泛相信的假设:无限经常单向函数(infinitely-often one-way functions,简称 ioOWF)是否存在。
先解释单向函数。它是一个容易正向算、难反向求逆的函数:给 x 算 f(x) 很快,但知道了 f(x) 想反推出 x 却需要超出多项式的时间。现代密码学的半壁江山都架在这个假设上——如果单向函数不存在,公钥加密、数字签名这一类东西基本都不成立。而"无限经常单向函数"是它的弱化版本:只要求在某些(无穷多个)长度上难求逆,不要求每一个长度都难。
Theorem 1.2 的第一半是:如果单向函数存在,那么就存在一个高效可采样的分布族,以及一个非单调的压缩方案——它在分布上的期望编码长度恰好等于熵
换句话说,压缩做到满分,模型却差得离谱。这就证明了一件事:如果不要求单调性,就根本不可能证明 Theorem 1.1 那样的等价,任何"加性间隙比样本长度线性更小"的弱化版本也站不住。这正是开头那个疑问的答案——反向构造效果差,不再是"工程没做好",而是单调性缺失后理论上就不可能有好的等价
另一半是反过来的:如果 ioOWF 不存在,那么给定一个 δ-最优的压缩方案,就能构造出一个在统计上接近 δ-最优的自回归模型。也就是说,这时候单调性这个条件可以扔掉,代价只是一点统计误差。这个方向用到了一个密码学里的经典结果(Impagliazzo 和 Levin,1989)。
所以整个图景变成一个二选一的岔路:要么建模等价于单调压缩,要么(在允许一点误差的意义上)等价于全部压缩,取决于单向函数是否存在。单向函数被广泛相信是存在的,所以前一种情形成立——这也是为什么单调压缩和非单调压缩之间会划出一道实打实的沟。😅
伪熵与不可压缩性:一个意外的密码学收获 主定理还顺手带出一个密码学结论,论文把它列为 Corollary 1.3。
这里涉及一个概念叫伪熵(pseudoentropy)。熵衡量的是"叙述一个分布需要多少比特",伪熵把这件事放到计算视角下:如果一个分布和某个真正高熵的分布,任何高效算法都无法区分开,那它就拥有伪熵。真熵和伪熵的差别,就在于是否存在高效算法能看出破绽
密码学里有一条线,专门研究分布的可压缩性和伪熵之间的关系。Haitner 等人在 ITCS 2023 证明了:如果一个分布族不能被压缩到长度 k(n),那它至少有 (k(n)-2) 的下一比特伪熵(next-bit pseudoentropy)。但反方向不成立——如果单向函数存在,伪熵并不能推出不可压缩性。这就留下一个缺口。
本文把这条链补成了双向,只不过要在两端都加上"单调"这个限定:
对一个分布族 D,下面两件事等价(误差在2以内):
这相当于一个"紧"的刻画:单调不可压缩和下一比特伪熵,是同一枚硬币的两面。之前只证明了其中一个方向,现在两个方向都通了。虽说它是主定理的副产品,但它本身有独立价值——把"能不能压"这件事,翻译成了密码学里的伪熵语言。👍
开放问题与未来展望 通篇看下来,这篇论文的贡献很清楚:把一个流传已久的直觉,第一次做成了带定量间隙的定理,还顺带解释了正反两个方向为什么看起来这么不对称。
但留下的坑也不少。第一个就是那个2比特。2比特是算术编码的固定开销,能不能压到1比特、甚至0比特?在论文的证明框架里,这个常数是硬编码在算术编码里的,想消掉可能需要一套完全不同的构造。目前还没有答案。
第二个是理论的适用范围。全文讨论的都是高效可计算的模型和压缩方案,还用了非均匀算法这个设定(算法可以带一个与输入规模相关的"建议串")。真实世界里的大模型算不算"高效",不是这篇论文要回答的问题。理论和实践之间还隔着一层。
第三个是实践指导意义。既然本文证明了单调性是等价成立的关键,那对想走"从压缩造模型"这条路的人,方向就明确了:要么保证压缩方案单调,要么接受理论上就存在的性能上限。Delétang 等人方案的弱点,也因此有了更清楚的理论依据。
更大的意义上,这项工作把"压缩即智能"从一句口号,变成了一个可以被证明、被反驳、被精确定量的命题。它没有武断地说"智能就是压缩",它说的是"在单调这个限定下,预测和压缩是同一件事的两种表述"。这个限定到底是一道限制,还是智能的本质属性之一,会是一个值得长期琢磨的问题。😀
龙迷三问 这篇论文到底在解决什么问题? 这篇论文从理论上证明,语言模型与单调压缩算法可以互相构造,误差只差2比特;而一旦去掉单调性,这个等价关系就要取决于单向函数是否存在的密码学假设。这篇工作最值得看的点是什么? 本文为纯理论研究,通过严格的数学证明建立了自回归模型与单调压缩之间的等价关系,并给出了在单向函数存在/不存在条件下该等价性的完整刻画。理论结果精确到加性常数2的差距。这篇工作的边界或风险在哪里? 优点:(1)首次从理论上严格建立了LLM与压缩之间的等价关系,填补了理论空白;(2)等价性精确到加性常数2,结果紧致;(3)通过单向函数的存在性完整刻画了单调性条件的必要性,解释了已有经验工作中两个方向效果不对称的现象;(4)推导出next-bit伪熵与单调不可压缩性的等价性,具有独立密码学意义。缺点:(1)纯理论研究,缺乏实验验证;(2)假设模型和压缩算法均高效可计算,实际中LLM的训练和推理效率问题未涉及;(3)对非单调压缩的分离结果依赖于单向函数存在的假设,该假设尚未被证明。如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~
龙哥点评 论文创新性分数: ★★★★☆
本文从理论上证明了自回归模型(LLM)与单调压缩算法之间的等价性——给定δ-最优的自回归模型可构造(δ+2)-最优的单调压缩方案,反之亦然;并进一步证明单调性条件在该等价性中是必要的,当且仅当密码学单向函数存在时。实验合理度: ★★★☆☆
现有材料未完整覆盖数据划分、基线公平性和统计显著性,因此按中性评价处理。学术研究价值: ★★★★☆
本文从理论上证明了自回归模型(LLM)与单调压缩算法之间的等价性——给定δ-最优的自回归模型可构造(δ+2)-最优的单调压缩方案,反之亦然;稳定性: ★★★☆☆
现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。适应性以及泛化能力: ★★★☆☆
现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。硬件需求及成本: ★★★☆☆
现有材料缺少完整训练资源、参数量、显存和推理时延信息,成本暂按中性评价。复现难度: ★★★☆☆
现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。产品化成熟度: ★★★☆☆
论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。主要参考文献
[1] Mazor N., Morgan A., Pass R. Language Modeling is Monotone Compression. arXiv:2610.11031, 2026. https://arxiv.org/pdf/2610.11031v1.pdf [2] Delétang G., et al. Language Modeling Is Compression. ICLR 2024. [3] Huang Y., et al. Compression Represents Intelligence Linearly. COLM 2024. [4] Haitner I., Mazor N., Shaltiel R. Incompressibility implies next-bit pseudoentropy. ITCS 2023. [5] Shannon C. E. A Mathematical Theory of Communication. 1948. 欢迎加入龙哥读论文粉丝群,
扫描下方二维码或者添加龙哥助手微信号加群 :kangjinlonghelper。
一定要备注:研究方向+地点+学校/公司+昵称(如 大模型+上海+清华+龙哥) ,根据格式备注,可更快被通过且邀请进群。压缩即智能,进群一起把这条定理聊明白 📚
『龙哥读论文』微信群目前包含:图像处理、大模型及智能体、自动驾驶及机器人、AI医疗及AI金融5个群
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击 "阅读原文", 查看更多原论文细节哦!
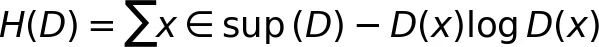
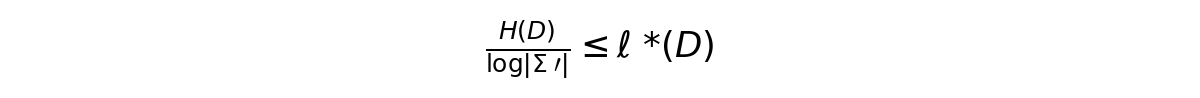
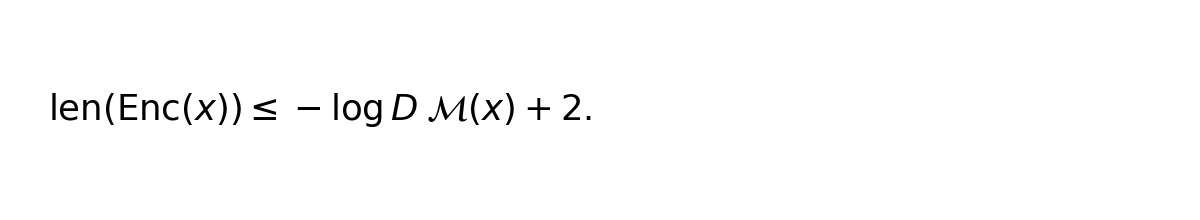

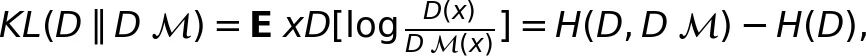
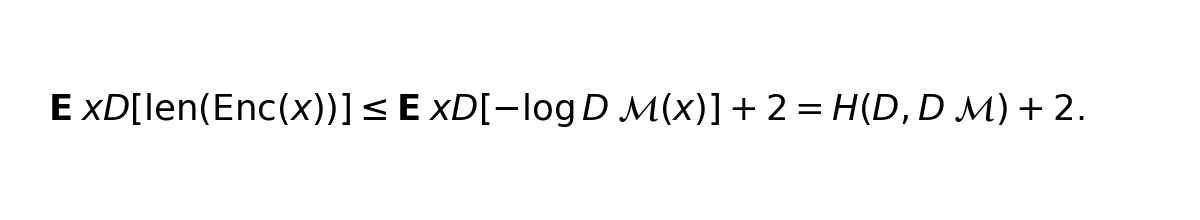
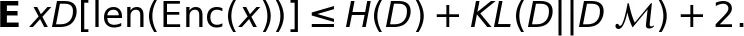
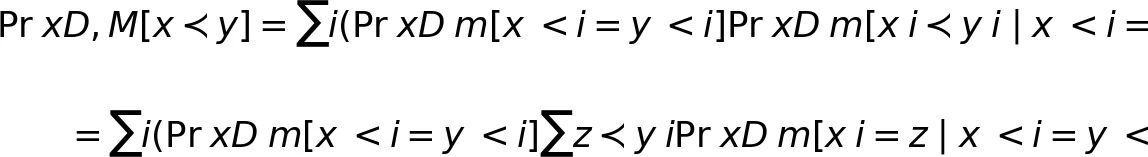
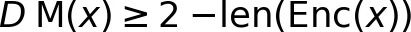
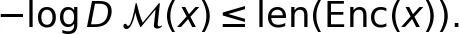
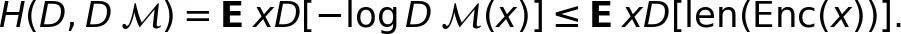
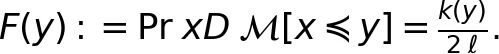
还没有公开留言,欢迎留下你的看法。