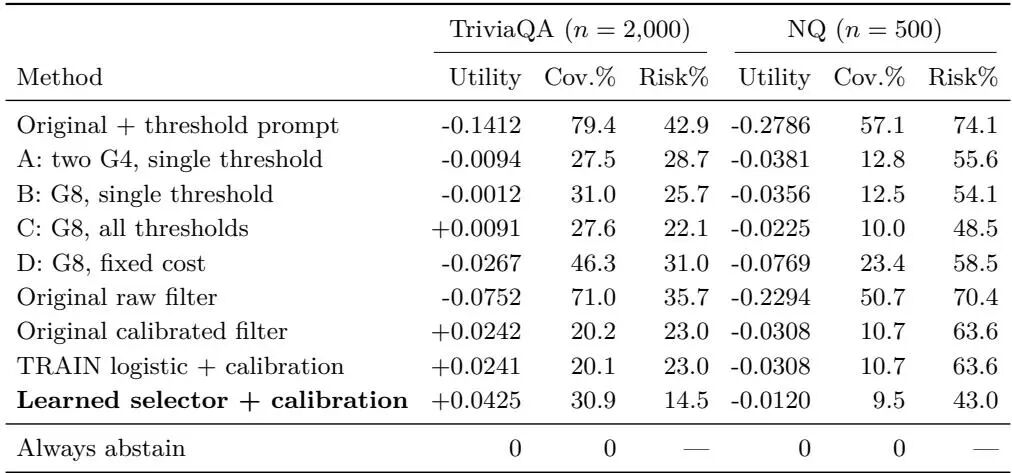
墨西哥国立理工学院:Qwen3-14B弃答实测,答得更多、错得更少
先讲一个大家都踩过的坑。你问一个模型某个偏门的事实问题,比如某本小众小说里配角的全名,或者某个 1998 年的会议在哪座城市举办,模型张口就来,语气笃定、句式工整、标点齐全——一查,全是编的。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
先讲一个大家都踩过的坑。你问一个模型某个偏门的事实问题,比如某本小众小说里配角的全名,或者某个 1998 年的会议在哪座城市举办,模型张口就来,语气笃定、句式工整、标点齐全——一查,全是编的。
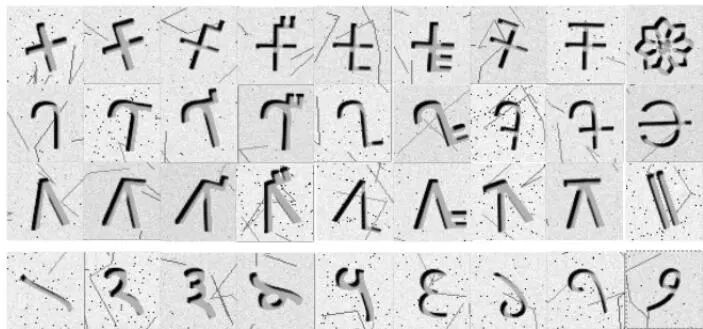
让AI去读两千多年前刻在石头上的字,听起来像考古队的活儿,可印度理工学院甘地讷格尔分校真把它做成了流水线:图像增强、字符识别、转写、翻译一步不落,还顺手开源了25.38万张字符图和2224对双语语料。方法不花哨,但“没数据”这个老大难被正面解决了,值得一看。
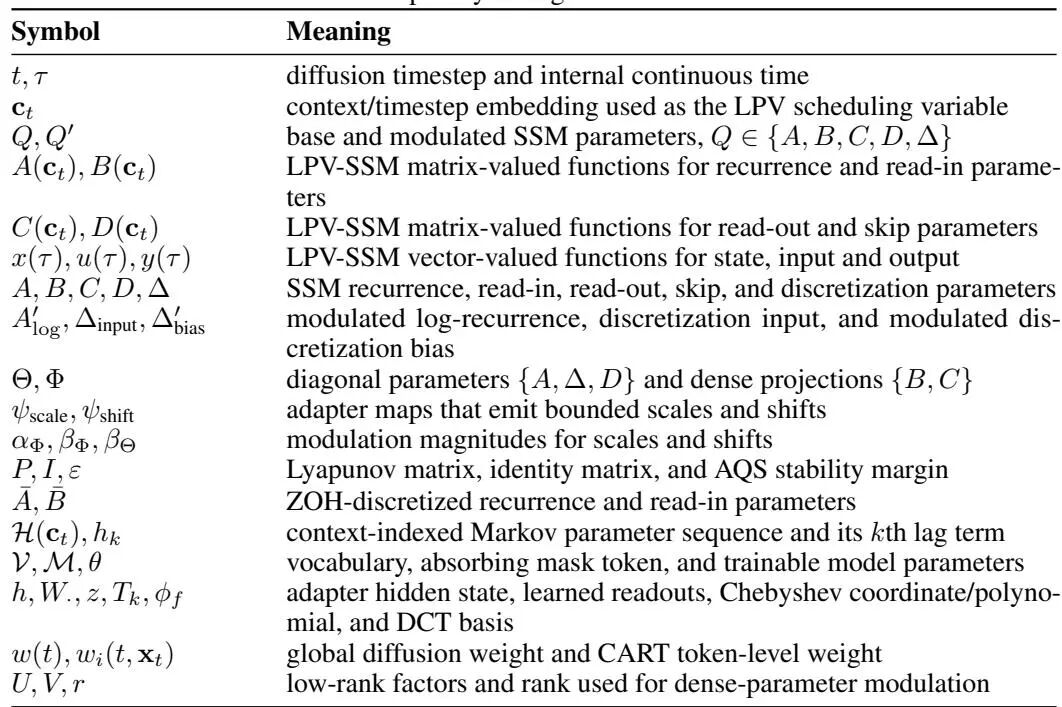
条件化这件事,主流做法要么把上下文塞进输入,要么用AdaLN去调激活,本质都是在外围打补丁。香港城市大学和英伟达AI技术中心这篇,直接把扩散时间步映射成SSM递归参数A、B、C、D、Δ的有界偏移,冻结111M骨干只训6.3到11M适配器,Chebyshev核平均验证损失压到2.55,还附送一份解析稳定性证书。能把"为什么稳"讲清楚的参数高效微调,不太多见,值
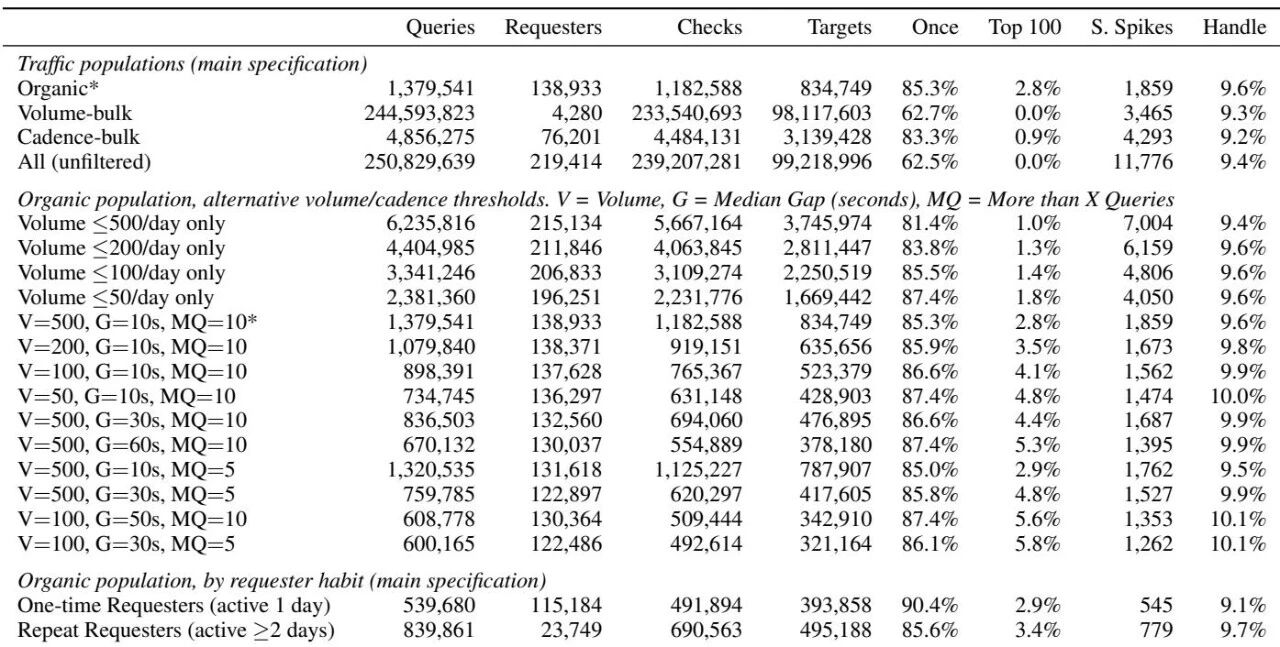
凌晨一点,你刷到一条推文:语法完美、情绪饱满、主页挂着三个外链和一份加密货币白皮书,而且它已经连续发了十四个小时。你盯着屏幕两秒,脑子里冒出一句话:这账号是不是机器人?
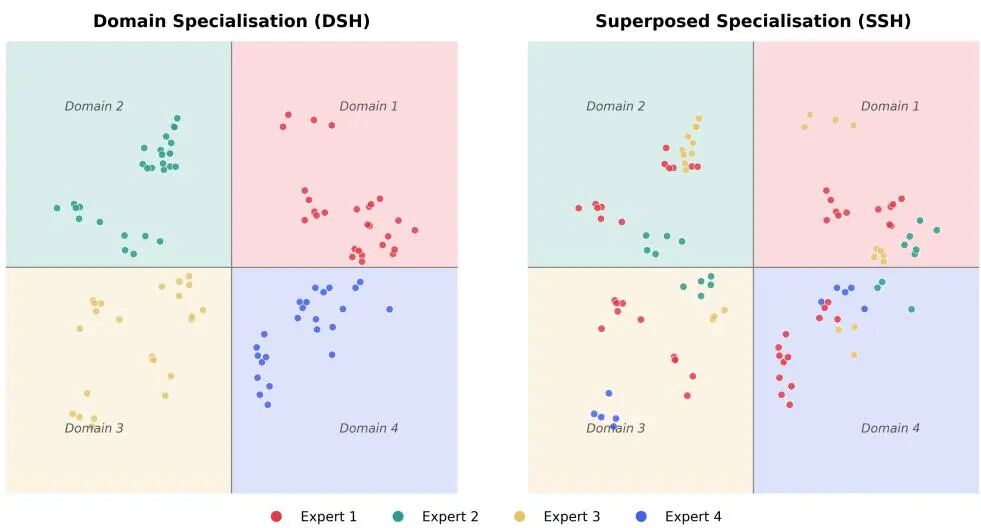
MoE模型火了好几年,可「专家到底在干嘛」一直没人说清。主流解释是每个专家管一个领域,但真去翻,翻不出来。维也纳工大等提出RouterInterp,用稀疏自编码器给出另一种答案:专家干的是「多份不相关特征的叠加活儿」。这个结论有点反直觉,但证据挺扎实。
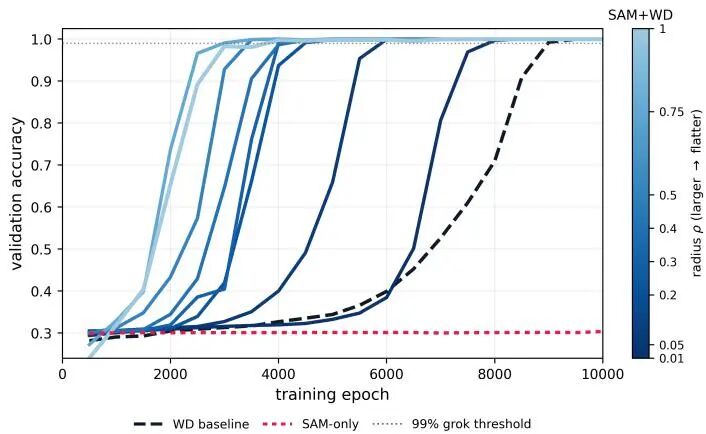
「平坦的最小值更容易泛化」这条被引用了快三十年的经验规律,这次被普渡大学拿出来单独审了一遍。结论有点扎心:用 SAM 硬把解压到最平,模型照样一点儿没泛化;真正把模型从记忆推向泛化的,是权重衰减带来的范数下降,SAM 只是在这个窗口里帮忙踩了一脚油门,把转变加速到最多 4 倍。理论构造那部分尤其漂亮:两种插值的平坦度一模一样,差距全在范数上。
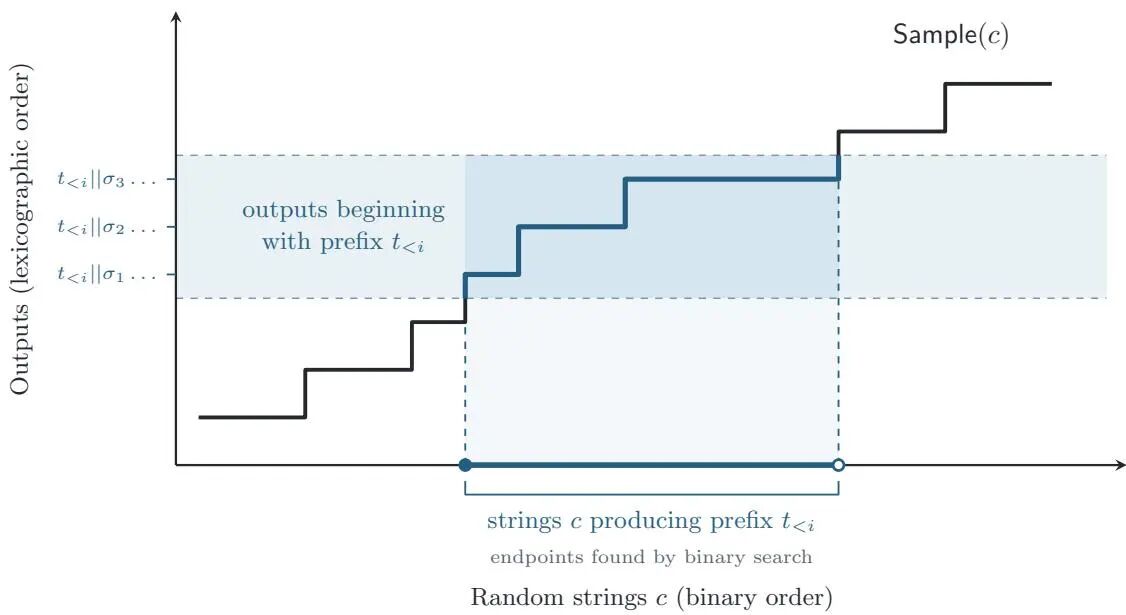
"压缩即智能"这句话流传了很多年,但一直停留在直觉和实验结果上。这篇论文第一次把它写成了定理:语言模型和单调压缩是等价的,误差只差2比特;而一旦去掉"单调"这个条件,等价关系就崩了,除非某个密码学假设不成立。
去中心化知识图谱听着很美,真去查能让人崩溃:引擎得顺着链接一根根摸,HTTP 请求一发一大把。这篇论文给查询引擎发了张"地图",也就是 RDF 形状索引——先看地图再走路,无关的房子根本不用敲门。最快提速 7 倍,一个原本怎么都跑不完的查询,现在跑通了。
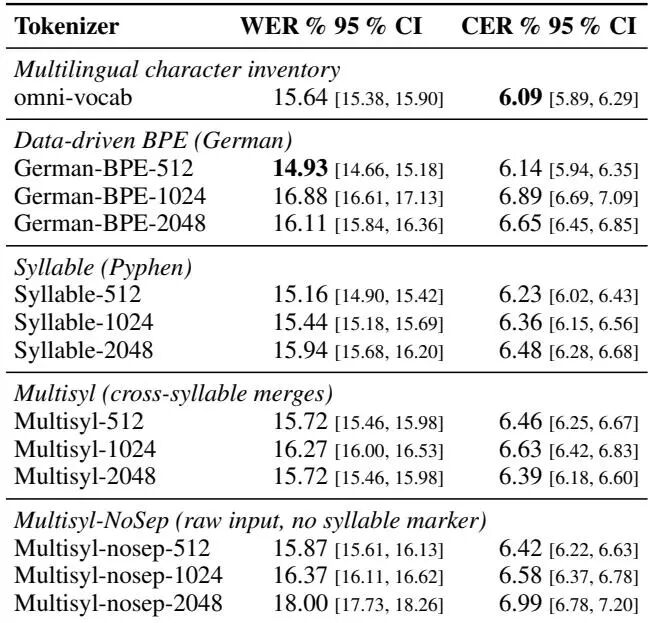
现代端到端语音识别系统(ASR,Automatic Speech Recognition,自动语音识别)的结构很像一条两段式流水线:前面是自监督预训练出来的声学编码器,负责把声音变成表征;
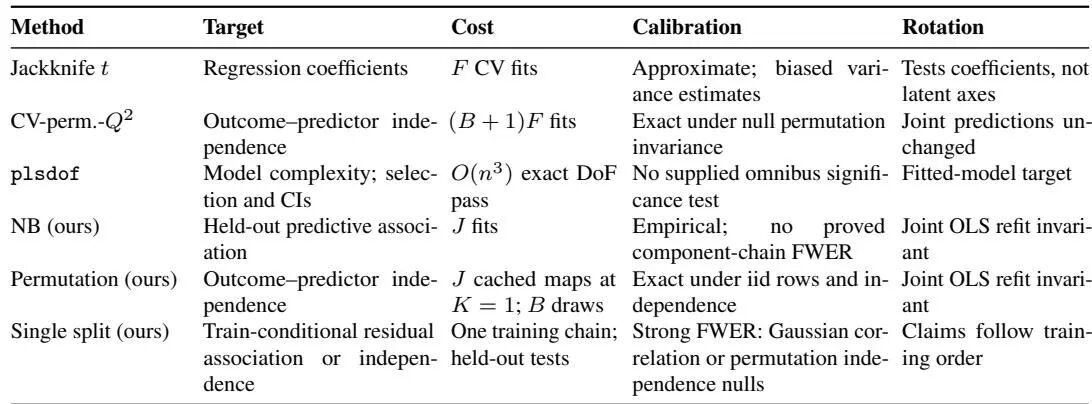
偏最小二乘回归(PLS)是一种处理高维数据的经典方法,广泛应用于化学计量学、神经科学和自然语言处理等领域。它通过从高维自变量矩阵中提取少数方向来预测结果,避免了普通最小二乘法的奇异问题。

事件抽取模型一出自家门就迷路?德国DFKI与奥尔登堡大学联合提出统一多域多任务生成框架:给T5加上领域指示和任务提示词,单模型就能横跨网络安全、生物医学、新闻等6大领域做事件抽取,多域联合训练还让多个数据集性能不降反升,这种"一个模型通吃天下"的玩法,值得认真聊聊。

数学解题能力强,不代表真的“懂数字”。这篇NAACL论文把数值能力当成自然语言推理任务来测,一口气跑了49个模型,结果发现数学专用大模型只在算术上占优,数字比较和归一化反而拉胯,值得每一位关注LLM推理能力的读者看看。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球