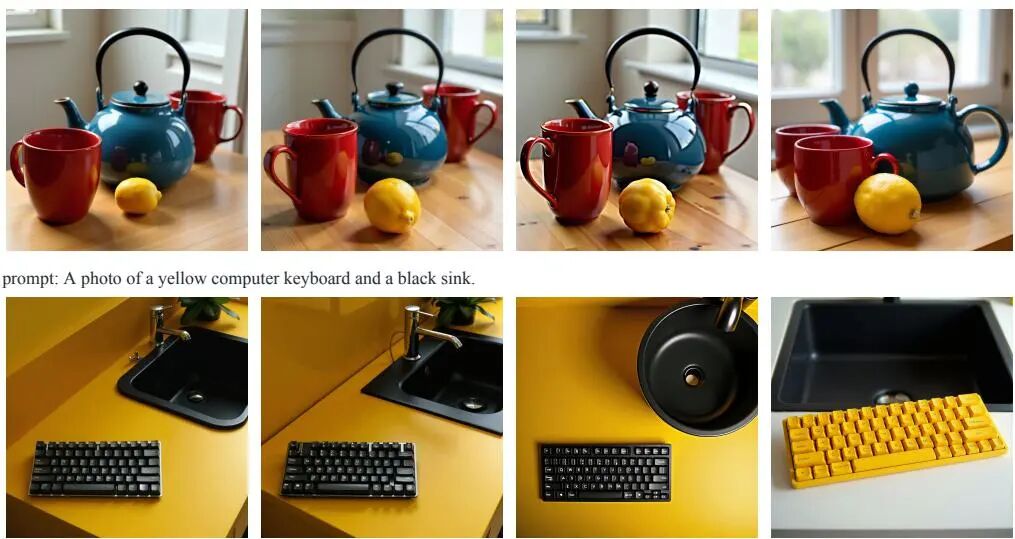
斯坦福&清华提出SFG:压制图像反馈,FLUX文生图GenEval涨至0.7479
文生图模型里藏着一个不太被讨论的回路:图像会通过联合注意力,把自己的内容"回写"到内部文本流里。问题是,这个反馈到底在纠错,还是在保留错误?斯坦福、清华的这篇论文用移植实验给出了答案,并顺手做了个叫 SFG 的训练无关引导,让 FLUX 的 GenEval 从 0.6661 涨到 0.7479。不改权重、不重训,推理期就能用,值得花时间看看。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
文生图模型里藏着一个不太被讨论的回路:图像会通过联合注意力,把自己的内容"回写"到内部文本流里。问题是,这个反馈到底在纠错,还是在保留错误?斯坦福、清华的这篇论文用移植实验给出了答案,并顺手做了个叫 SFG 的训练无关引导,让 FLUX 的 GenEval 从 0.6661 涨到 0.7479。不改权重、不重训,推理期就能用,值得花时间看看。
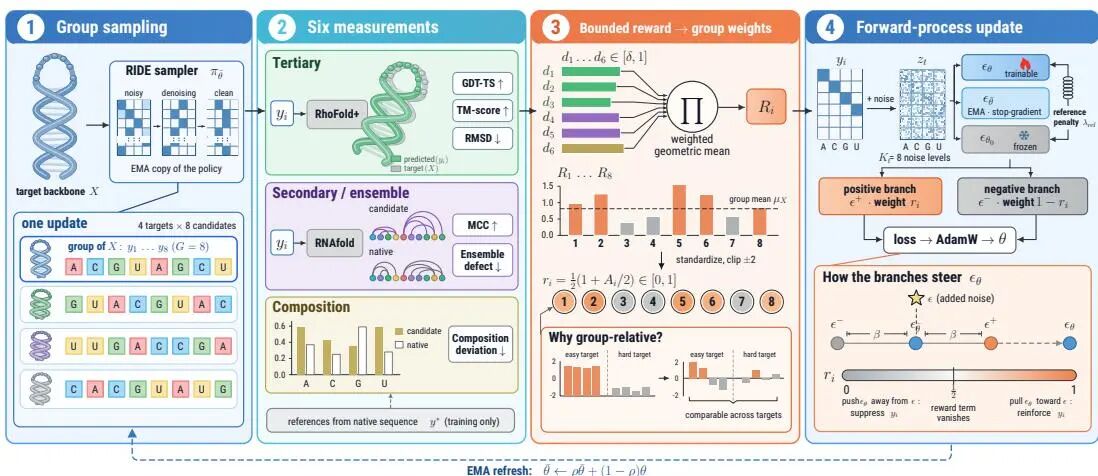
RNA逆设计是先定三维结构,再找能折叠成该结构的序列。
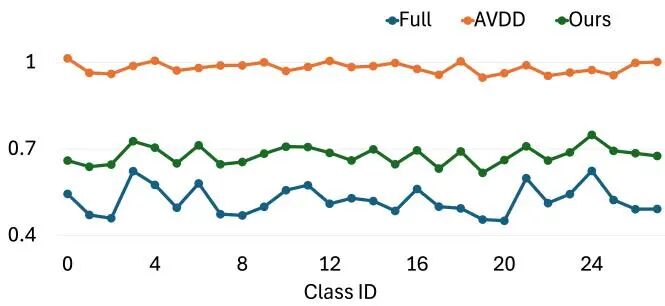
数据集蒸馏这名字听着很美:用一小撮合成样本,顶掉整个大训练集。可一到音视频这种双模态场景,就撞上两根硬钉子——显存炸裂,以及两个模态各说各话。印度理工海得拉巴分校这篇 X-AVDD 用双向交叉注意力把两件事一起收拾了:合成时间从10小时压到1.3小时,VGGSound 上的准确率从个位数跳到两位数。这波值得拆开看看。
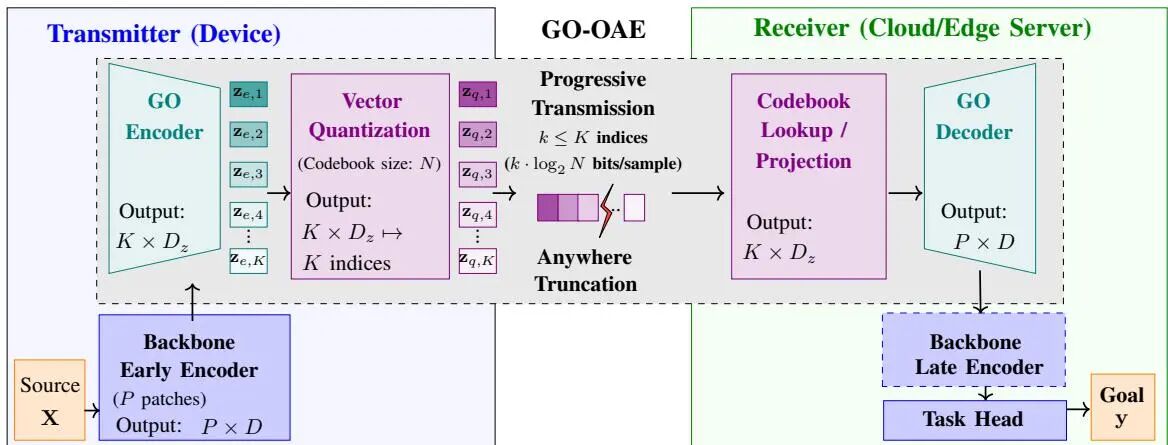
想象一个场景:无人巡检车在隧洞中运行,摄像头拍摄画面,信道抖动导致带宽骤降。视频链路降码率,画面模糊,而接收端的识别模型仍需回答轨道上是否有人。
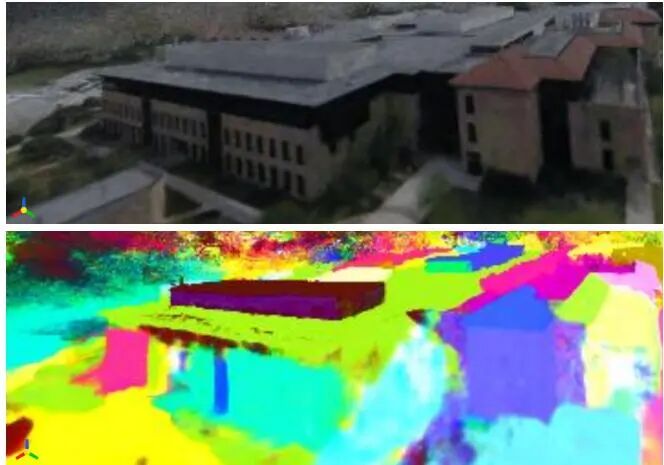
一栋楼站在那儿,几十米高,几千个构件。想把它搬进电脑,常见做法是让无人机绕着飞一圈拍上千张照片,再交给算法重建三维模型。
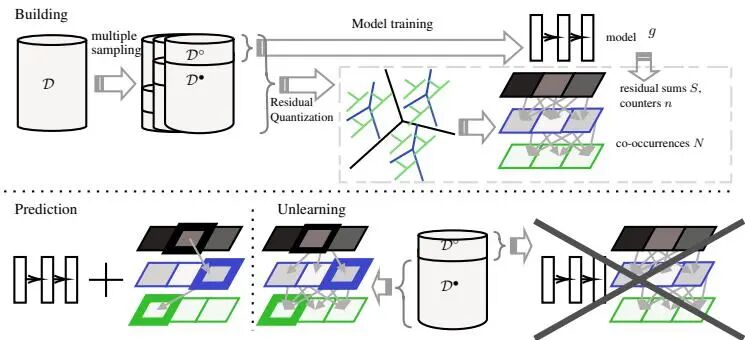
法规给了用户"删除权",可模型不会说忘就忘——过去想精确抹掉一个样本,基本只能重训。Meta这篇把模型拆成冻结的骨架和可加的内容,删除直接退化成算术减法,低类别数任务上期望延迟比SISA快483倍,还做到与重训比特级一致。值得花时间读。
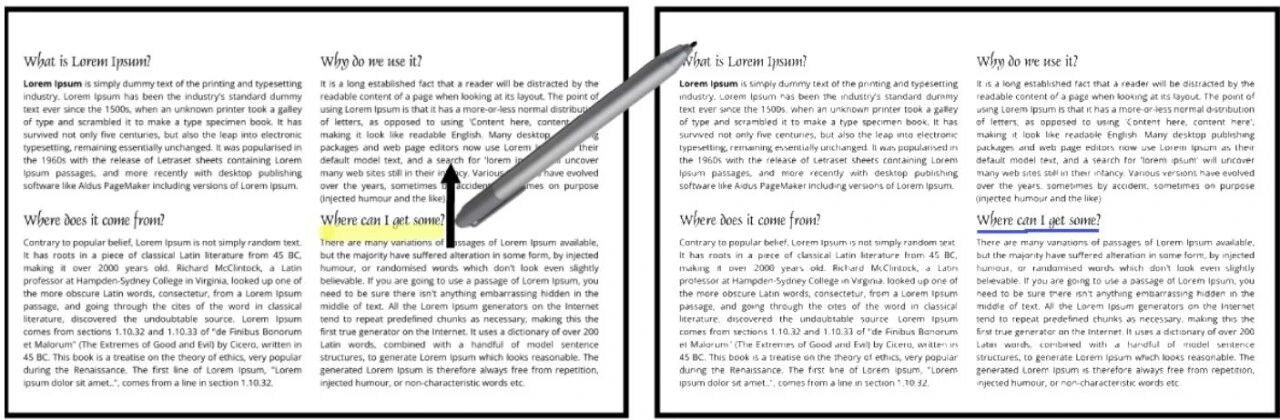
数字笔已经普及了很多年,但有一个问题几乎没怎么变过:模式切换。
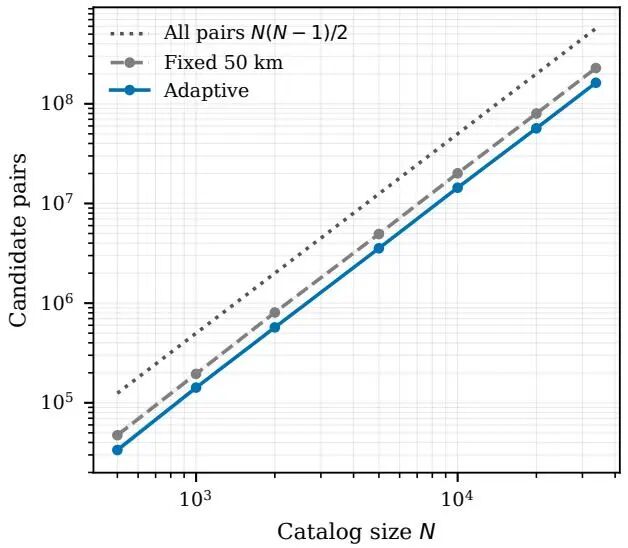
太空越来越挤,几万颗卫星的轨道交会筛选正在变成算力灾难。斯坦福这篇论文不换模型、不堆显卡,只用公开星历历史给每个目标单独估一个不确定度,把固定50公里阈值改成自适应阈值,候选对直接砍掉近三成,扫描速度还快27倍。在算力普遍吃紧的当下,用一次漂亮的"减法"换回大笔计算预算,这种思路值得每个做大规模筛选的人读一读。
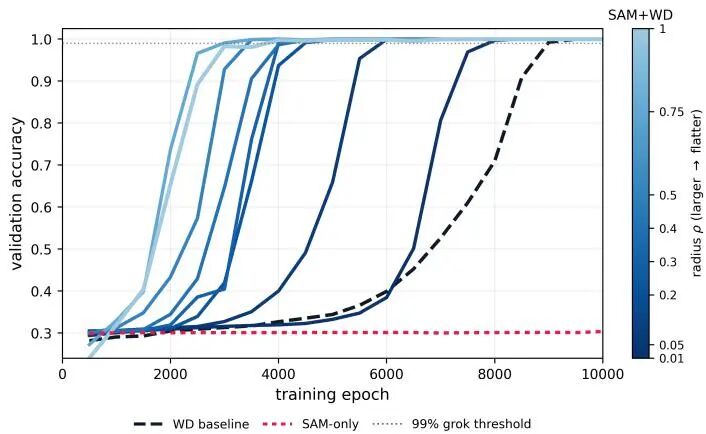
「平坦的最小值更容易泛化」这条被引用了快三十年的经验规律,这次被普渡大学拿出来单独审了一遍。结论有点扎心:用 SAM 硬把解压到最平,模型照样一点儿没泛化;真正把模型从记忆推向泛化的,是权重衰减带来的范数下降,SAM 只是在这个窗口里帮忙踩了一脚油门,把转变加速到最多 4 倍。理论构造那部分尤其漂亮:两种插值的平坦度一模一样,差距全在范数上。
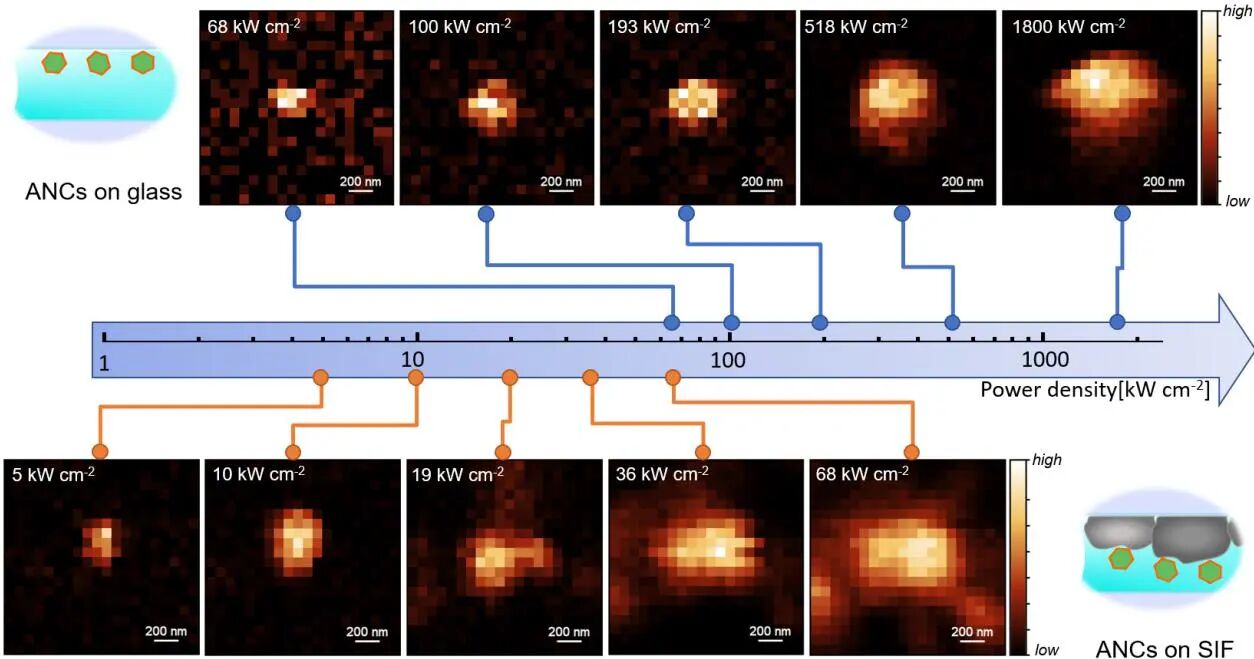
光子雪崩纳米晶的分辨率一直很能打,麻烦在于"点灯费电"——激发功率动辄上百 kW/cm²,活细胞先扛不住。波兰哥白尼大学团队在下面垫了一层银岛膜,靠等离激元把局域光场放大,阈值功率直接砍掉一个数量级,5 kW/cm² 还能拍出清楚的光斑。更妙的是,他们拿壳层厚度当旋钮,2 nm 时效果最好,6 nm 以上迅速失灵。
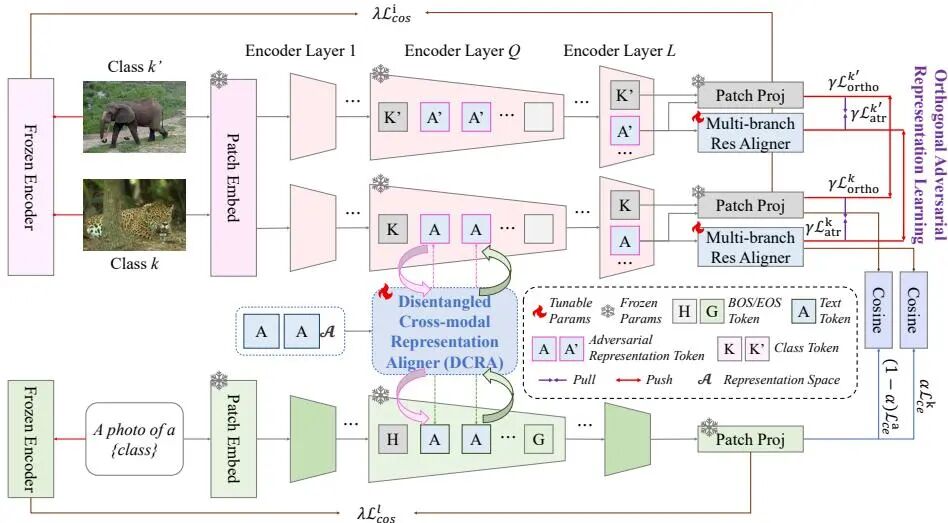
CLIP的提示学习已经被卷了三年,绝大多数工作都在往上叠模块;这篇先停下来问了一句:类特定判别信息和类无关的可迁移知识,是不是从一开始就被搅在同一个特征空间里?齐鲁工大等用解耦跨模态对齐器加正交对抗正则给出一种拆法,15个基准一致涨点,参数量还比上一版少了55.7%。涨点幅度不算炸裂,但这个诊断角度值得花时间读。
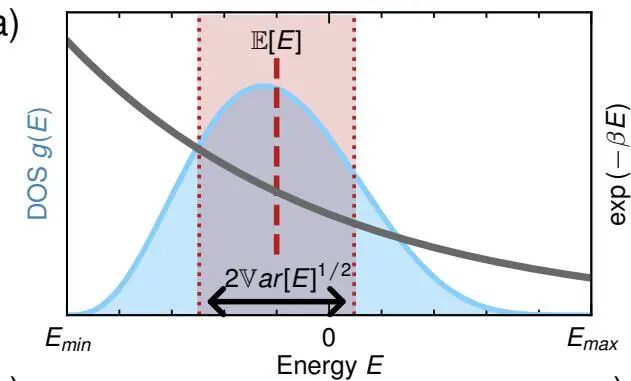
无序合金是几种金属原子随机占位的晶格。高熵合金是其中的代表,五种以上元素混合,靠熵稳定。材料合成与稳定性都与有限温度下的自由能相关。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球