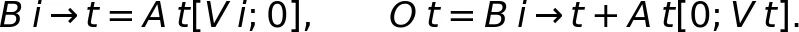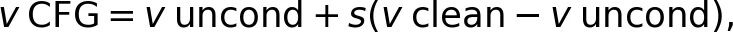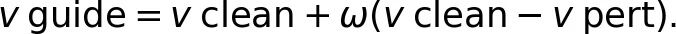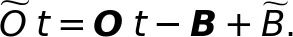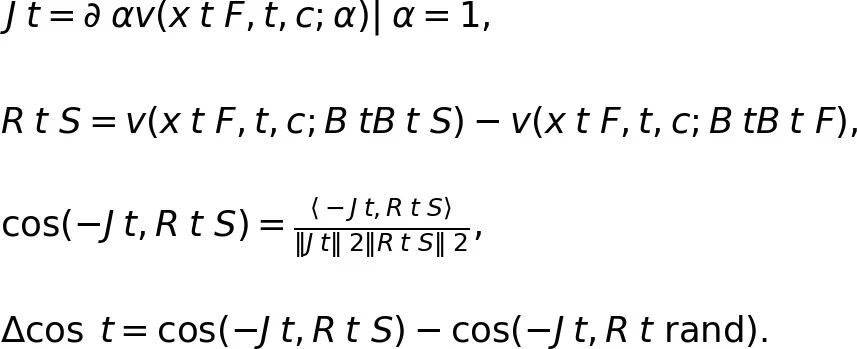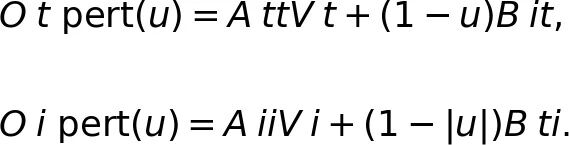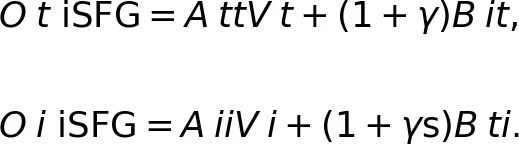← 返回 PaperDaily 视觉与图像

斯坦福&清华提出SFG:压制图像反馈,FLUX文生图GenEval涨至0.7479

文生图模型里藏着一个不太被讨论的回路:图像会通过联合注意力,把自己的内容"回写"到内部文本流里。问题是,这个反馈到底在纠错,还是在保留错误?斯坦福、清华的这篇论文用移植实验给出了答案,并顺手做了个叫 SFG 的训练无关引导,让 FLUX 的 GenEval 从 0.6661 涨到 0.7479。不改权重、不重训,推理期就能用,值得花时间看看。

斯坦福&清华提出SFG:压制图像反馈,FLUX文生图GenEval涨至0.7479
原论文信息如下:
论文标题:
Images Talk Back: Guiding MMDiTs by Suppressing Image-to-Text Feedback
发表日期:
2026年10月
发表单位:
斯坦福大学、清华大学、纽约大学
原文链接:
https://arxiv.org/pdf/2610.13941v1.pdf
开源代码链接:
https://github.com/yyc1215lll-creator/SFG

图像也会"说话"?MMDiT中的反馈循环之谜
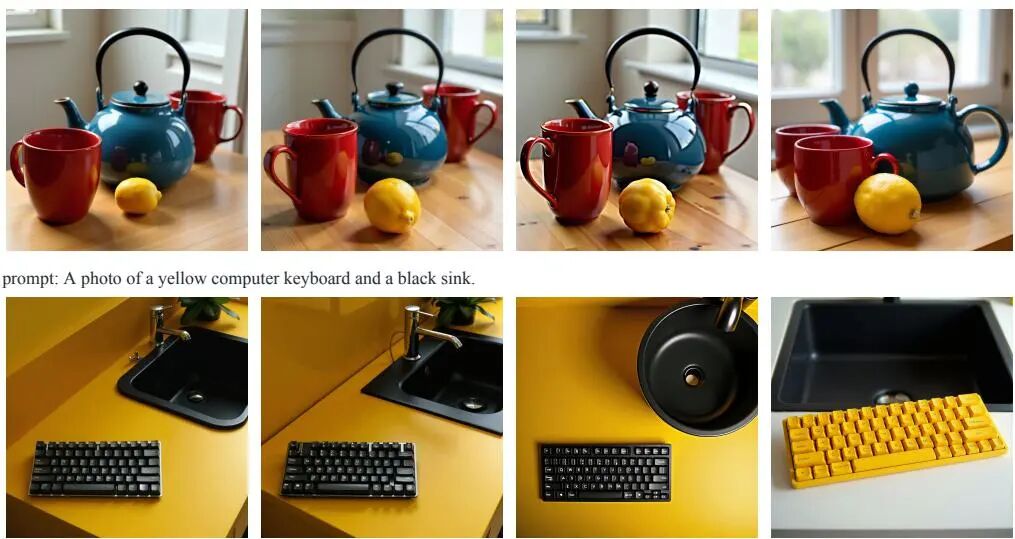
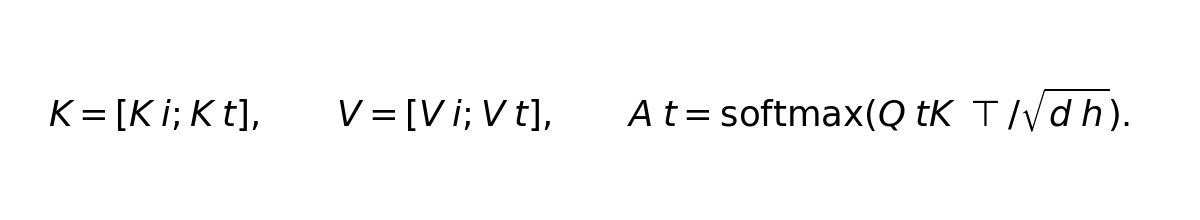
先说一个很多人没注意到的细节:现在的文生图模型,图像和文字之间并不是单向关系。早年的做法是文本编码成条件,图像去"读"它,读完就结束。而 MMDiT(Multimodal Diffusion Transformer,多模态扩散 Transformer)换了个玩法——图像和文本各自维护一条残差流,两边的 query 都去查询拼接在一起的图文键值,共用一个 softmax。
Figure 1
FLUX 上的匹配定性对比。面对更复杂的提示词时,本文方法在物体与属性上更贴合提示词的要求。
attention formula
联合注意力的键与值由图像和文本拼接而成,文本和图像各自的 query 共享同一个注意力分布。其中 Qt 是文本 query,K = [Ki; Kt] 与 V = [Vi; Vt] 分别是拼接后的图像—文本键与值,dh 为单个注意力头的维度。
这么一拼接,文本流的输出就被拆成了两块。
I2T message
Bi→t 是图像的值被写进文本流的那一部分,论文称之为 I2T 消息(image-to-text message,图像到文本消息)。对称地,图像流那边也有一条 Bt→i,也就是 T2I 消息(text-to-image message,文本到图像消息),大致对应平时说的"文本条件"。真正有意思的地方在于:后续的模块会把这条被图像"改写"过的文本流再读回图像里,于是图像→文本→图像 的闭环就成立了。1+1 不一定等于 2,也可能是一错到底。
补充一个容易忽略的细节:每一次去噪调用,文本流都会从编码后的提示词重新初始化,所以这条回路是在网络深度方向生效的,并不跨时间步持久保存。这个性质后面算成本的时候会用到。
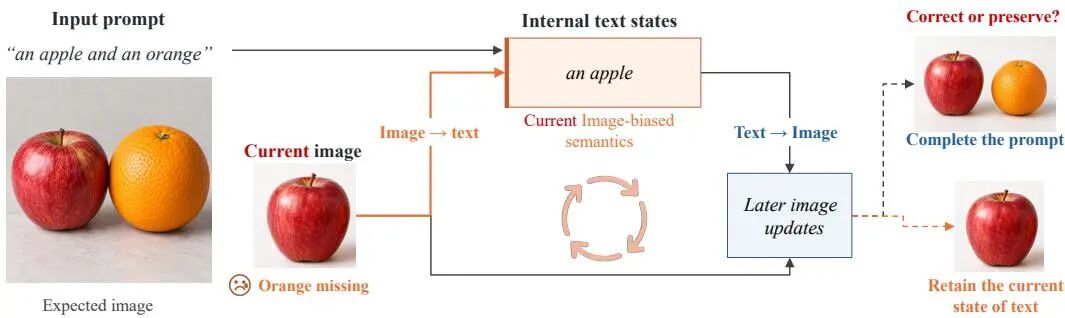
问题也就随之而来。假设提示词写的是"一个苹果和一个橙子",而画面上只有苹果,那么这条反馈回路到底是帮忙把橙子补回来,还是干脆把"这里没有橙子"写进文本流、让错误一路固化下去?论文用图2 把这个分叉画了出来。🤨
Figure 2
图2:图像到文本反馈示意。当前图像通过 Bi→t 写入内部文本状态,后续模块再读取它来更新图像。如果画面漏掉了一个物体,这条反馈是帮忙找回来,还是把不完整的画面保留下来?注意输入提示词全程保持不变。
要看懂这篇论文的解法,还得先补一点扩散模型里的引导(guidance)常识。CFG(Classifier-Free Guidance,无分类器引导,Ho 与 Salimans,2022)是最经典的一种,思路是把条件预测和无条件预测的差值放大后外推。
CFG formula
其中 vuncond 是空提示词下的无条件预测,vclean 是正常条件预测,s 是 CFG 尺度。代价很直接:每一步都要多跑一次无条件前向,采样步数越多账单越厚。
训练无关的自引导则更省事:不去训练第二个模型,而是把同一个模型"弄坏"一下,得到一个扰动预测 vpert,再沿着远离它的方向推。
self guidance formula
这条路线下已经攒了一堆方法。PAG(Perturbed-Attention Guidance,扰动注意力引导,Ahn 等,2024)靠篡改注意力图制造扰动;SEG(Smoothed Energy Guidance,平滑能量引导,Hong,2024)从注意力能量曲率的角度入手;S²-Guidance(Chen 等,2026a)另开一条路。它们的共同点是,负分支本质上都是"一个被损坏的模型"。本文的切入点不太一样:既然 MMDiT 里本来就有一条原生的图像到文本通路,那能不能不弄坏模型,直接把这条通路本身当旋钮来拧?
先把这篇论文的整体设定梳理成一张表,方便对照着往下看。
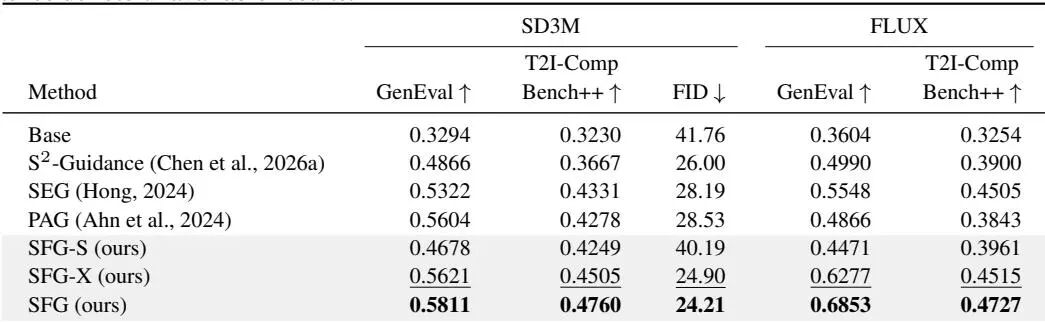
*表格超出部分左右可以滑动 Table 1: Text-to-image generation without CFG on SD3M and FLUX. All methods use cfg = 1. GenEval and T2I-CompBench++ are averaged over six and eight categories, respectively. FID uses 5k COCO images on SD3M; CFG (Ho & Salimans, 2022) at s = 7.5 gives 32.49 for reference. Dashes denote unavailable results.
Table 1: Text-to-image generation without CFG on SD3M and FLUX. All methods use cfg = 1. GenEval and T2I-CompBench++ are averaged over six and eight categories, respectively. FID uses 5k COCO images on SD3M; CFG (Ho & Salimans, 2022) at s = 7.5 gives 32.49 for reference. Dashes denote unavailable results.

反馈是敌是友?移植实验揭示 I2T 反馈的双面性
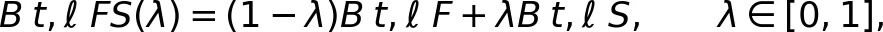
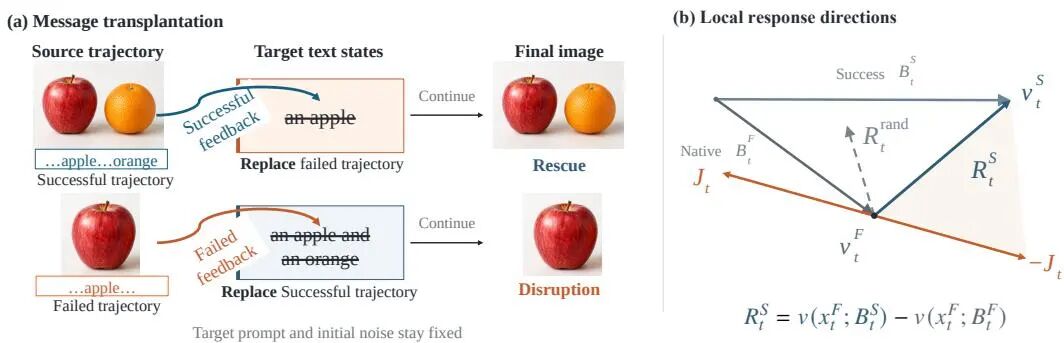
要回答"反馈是敌是友",最笨也最可靠的办法是动手术。论文构造了 400 组同提示词的成败配对轨迹,两个样本之间唯一的差别就是随机种子。成对筛选标准卡得很死:GenEval 判对、或 T2I-CompBench 得分不低于 0.75 才算成功,不高于 0.45 才算失败,中间地带的样本直接剔除。这样每一条轨迹的标签都没有歧义,移植结果才有意义。
移植的对象就是 I2T 消息 Bi→t。做法是按采样步和模块把成功轨迹的消息缓存下来,在 softmax 之后、输出投影之前插进失败轨迹里。
transplant formula
BF 是失败接收者自己的消息,BS 是成功供体的消息,混合权重 λ 从 0(完全不换)到 1(完全替换)。接收者的提示词、种子、采样器、初始潜变量以及其他激活值全部保持不变。工程上实现起来也不复杂:把原来的消息减掉再加回新的即可。
message replace formula
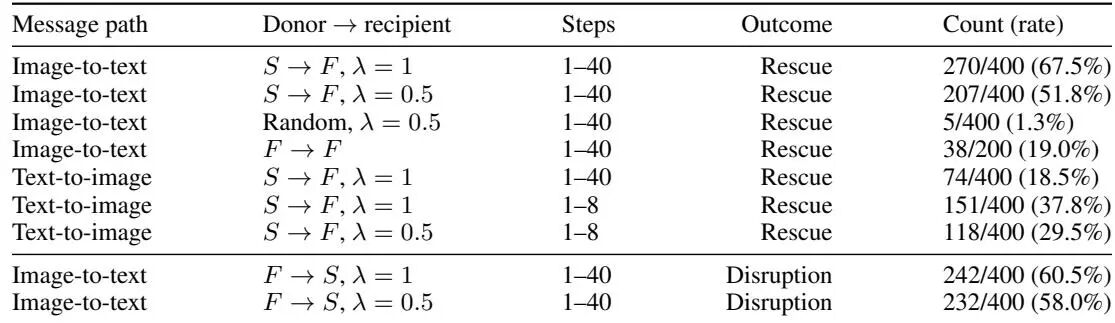
结论相当有画面感。把成功供体的消息移植进失败轨迹,能把一部分失败救回来;反过来把失败供体的消息移植进成功轨迹,也能把好图带沟里。而用范数匹配的随机消息去做同样的操作,几乎不会改变结果。也就是说,这条反馈通路携带的确实是实打实的图像内容信息,既包括对的,也包括错的。
Figure 4 and Figure 5
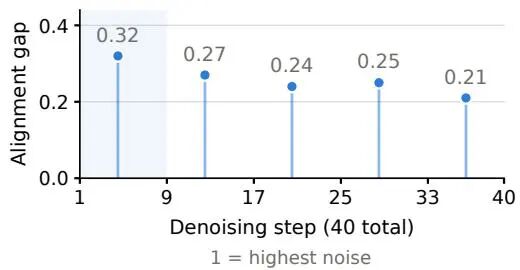
图4与图5:消息移植及对照结果(上),以及在 SD3.5M 与 FLUX 共 400 组配对轨迹上的时机与方向对齐结果(下)。S/F 表示成功/失败轨迹,箭头由供体指向接收者,标签给出混合权重 λ 与移植步区间;下图阴影标注的是第 1–8 步。
Table 21
表21:配对生成轨迹上的消息移植与对照实验。S 与 F 分别表示成功与失败轨迹,箭头由供体指向接收者。图像到文本与文本到图像的移植使用同一批 400 组成败配对,失败到失败的移植使用 200 组失败配对。λ 为消息混合权重,Steps 指定移植窗口,统计的是被拯救的失败或被破坏的成功所占的比例。
Figure 3
图3:消息移植与局部响应方向。(a) 把供体的图像到文本消息移植进接收者的文本状态,接收者的提示词与初始噪声保持不变,成功到失败与失败到成功两种移植分别测试破坏与拯救。(b) Jt 与 −Jt 是两个方向相反的局部响应,RtS 与 Rtrand 分别是成功供体消息与随机消息干预带来的速度变化。
知道了"带信息",还得知道"往哪拧"。论文在另一批固定的 400 组轨迹上,把每个联合块中的 I2T 消息整体乘一个系数 α,然后考察预测速度对这个系数的导数 Jt。取负号的 −Jt,代表的就是"减小 I2T 反馈"这个方向的局部响应。再把成功供体移植带来的速度变化 RtS、以及范数匹配随机扰动带来的变化 Rtrand,分别与 −Jt 求余弦相似度并做差,得到所谓的 cosine gap。
cosine gap formula
这里 Jt 是速度场对反馈强度的局部导数,RtS 是成功供体消息带来的速度改变,Rtrand 是范数匹配随机消息带来的速度改变,Δcost 则是两者的余弦相似度之差。结果在 SD3.5M 和 FLUX 上、在所有时间区间里,这个 gap 都是正的。翻译成人话:成功供体的作用方向,和"抑制反馈"的方向高度一致。这就是把抑制当作有用方向的直接证据。
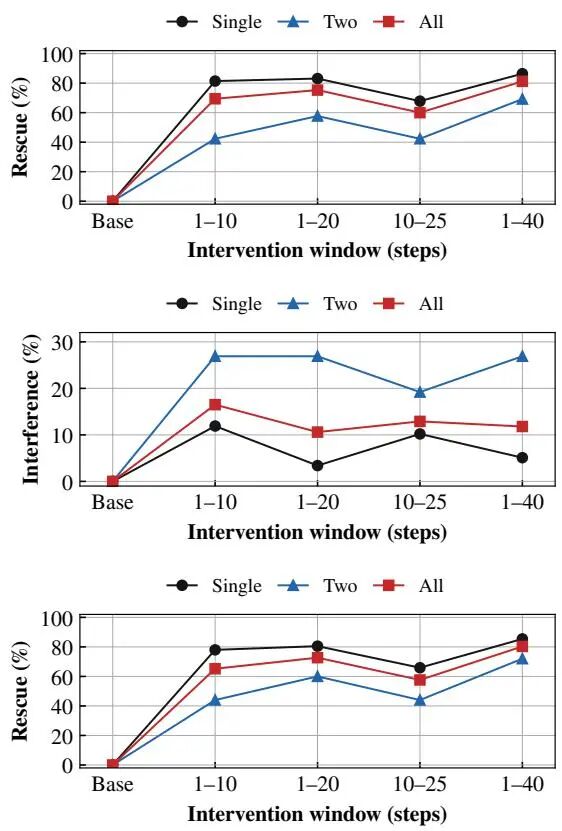
时机同样是关键变量。实验显示,在 40 步采样里只把移植放在第 1–8 步,就能恢复全程移植大约三分之二的效果;而放在后期,几乎不会改变最终结果。这和"物体布局在采样早期基本定型"的直觉是一致的。附录 G 还用了内部文本流上的缺对象探针做验证:一旦警告出现,不加干预往往就一直留着,而抑制反馈能降低这种症状残留的比例,并救回相当一部分失败样本。
Figure 22
图22:自上而下分别为失败拯救、成功破坏,以及"带警告的失败"被拯救的定性示例。
一个看起来像"帮忙纠错"的机制,实测下来更像"帮忙守住错误",这个反转确实让人愣一下。
621df26778f05KkH.gif

抑制反馈,提升生成:SFG 与 iSFG 的巧妙设计
方向找到了,接下来是把它做成可用的东西。SFG(Semantic Feedback Guidance,语义反馈引导)由两个互补的控制器拼成:SFG-X 在辅助分支里加强 I2T 反馈,SFG-S 在辅助分支里削弱 T2I 条件,两者共用同一次辅助前向。
SFG perturb formula
编辑强度取 u < 0。此时 1−u > 1,意味着辅助分支里图像对文本流的影响被放大;1−|u| < 1,意味着文本对图像的条件被削弱。第一条编辑定义 SFG-X,第二条定义 SFG-S。若只想用其中一个组件,把另一个消息的乘数保持为 1 即可;u = 0 则两个编辑同时取消。
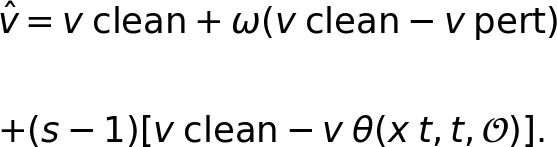
设当前潜变量下未修改的条件前向为"干净分支",其预测记作 vclean,带消息缩放的辅助分支预测记作 vpert,那么最终的引导速度就是下面这个式子。
SFG guidance formula
其中 u 控制消息乘数,ω 是 SFG 引导强度,s 是 CFG 尺度。式子的后半段就是标准的 CFG 项。结构上很清爽:SFG 只是在原有 CFG 的预测上,额外叠了一项"远离被放大的反馈"的修正,两者互不干扰。
这里有个容易被忽略的设计哲学差异。PAG、SEG、PG 这一类方法的负分支,都是通过"把模型弄坏"来构造的——模糊图像区域、打乱注意力、跳过残差块。而 SFG-X 反过来,是去加强一条模型本来就有的原生通路,然后引导远离它,等于把这条通路的影响力压回去。用论文自己的话说,是拿"增强"当负样本,而不是拿"损坏"当负样本。这条思路确实干净。
如果不想为辅助分支多付一次前向,还有 iSFG(in-place SFG,原位语义反馈引导)。它把对应的消息缩放直接写进普通条件前向里。
iSFG formula
I2T 消息的乘数为 1+γ,且 γ < 0;T2I 消息的乘数为 1+γS,且 γS > 0。也就是说,SFG 里 u < 0 是在辅助分支中加强反馈、再引导远离;iSFG 里 γ < 0 则是在原位直接施加抑制。没有 CFG 时采样器直接用这个预测,有 CFG 时则只在条件分支上做编辑。
插入位置是这套方法最讲究的地方。所有修改都发生在 softmax 与 value 聚合之后、输出投影之前,只缩放消息本身。这样一来,注意力 logits、联合归一化、以及各个模态内部的项都保持不变。换句话说,改动被限制在最小范围里,模型权重则全程冻结。
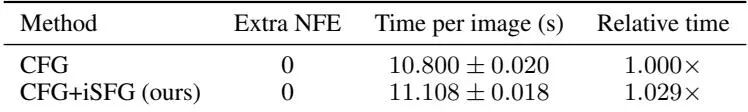
开销方面,论文把辅助分支的激活窗口压在前 20% 的采样步上。在没有 CFG 的情况下大约是 1.2 倍基础 NFE,叠加 CFG 后约 2.2 倍。作为对比,如果每一步都跑辅助分支,成本直接翻倍。NFE 指的是 Number of Function Evaluations,即模型前向评估次数,是衡量扩散模型推理成本最直接的指标。而 iSFG 不增加任何模型评估次数,运行时开销也极小。
Table 20
表20:iSFG 的运行时开销。数值为三次配对运行的均值 ± 标准差。
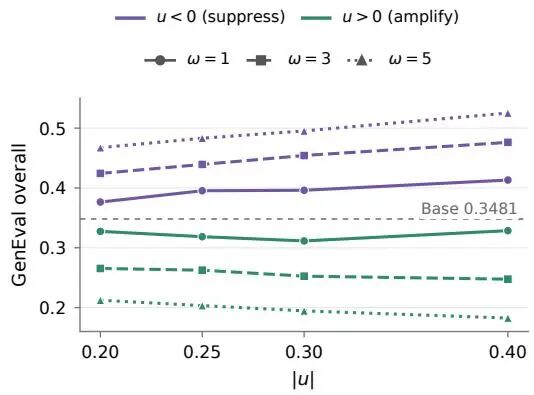
方向验证的消融做得比较硬。在 SD3.5M、cfg = 1 的设定下,论文用匹配的 |u| 和 ω 对比抑制分支与反号分支,12 组抑制设置全部优于无引导基线,12 组反号设置则全部变差,且引导强度越大,两者的分离越明显。组件消融则显示,SFG-X 单独使用就已经超过所有对比方法,SFG-S 单独使用略逊于 PAG 和 SEG,但两者合用效果最好——说明抑制反馈是主要贡献,强化条件则是锦上添花。
Figure 6
图6:SFG-X 引导方向的验证。在 SD3.5M(cfg = 1)上,用匹配的 |u| 与 ω 对比抑制分支(u < 0)与反号分支(u > 0),抑制/放大的标签表示净引导效果,Base 为无引导基线。
Figure 7
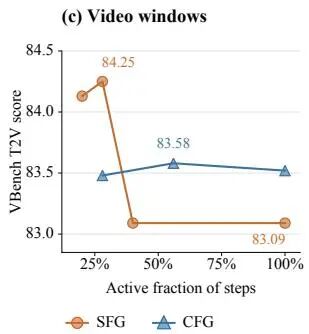
图7:引导组件与引导窗口。(a) 表1 工作点下的 GenEval 对比;(b) 引导窗口并非越长越好,FLUX 曲线用 28 步,SD3.5M 的 CFG+SFG 与 SD3M 的 SEG 用 40 步;(c) HunyuanVideo 文生视频共 25 步采样,SFG 分别激活前 5、7、10、25 步,CFG 分别激活前 7、14、25 步。
Figure 8
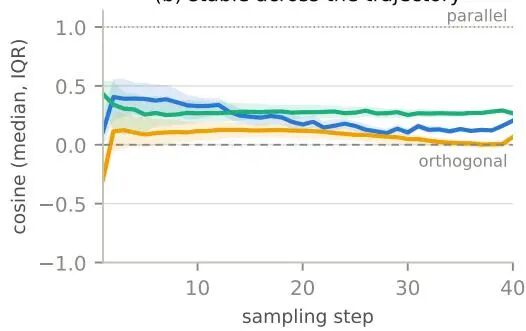
图8:互补方向。SFG-X 与 SFG-S 的修正,与 CFG 以及彼此之间的余弦相似度都很低,无论跨提示词还是沿采样轨迹都稳定成立,这解释了为什么两者可以叠加而不打架。

从图像到视频:SFG 的跨任务迁移能力

一个只在图像上有效的方法,说服力总是有限的。所以论文把同一套控制搬到了 HunyuanVideo-1.5 上,做文生视频和图生视频两类任务,同样是 cfg = 1、不训练、不加权重。
图生视频这个场景尤其值得一提。此时条件流不只有文本 token,还有参考图像的 token,两者共同组成条件序列。SFG 不做任何特殊适配,直接作用在这整条流上,等于从纯文本条件泛化到了多模态条件。
Table 4
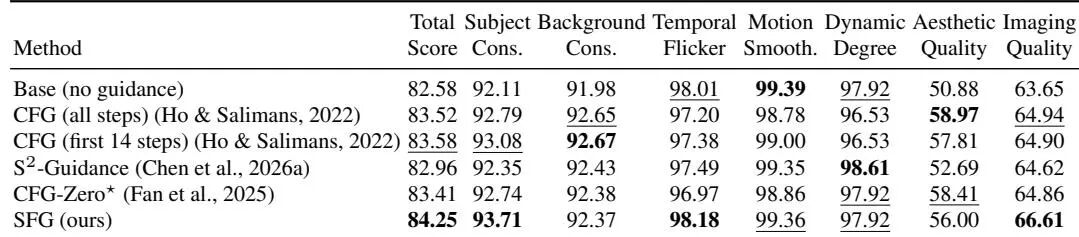
表4:HunyuanVideo 上不同引导方法的文生视频结果。报告 7 个 VBench 质量维度以及汇总总分。SFG 使用 cfg = 1,不需要无条件分支;两行 CFG 的区别在于引导窗口。表中缩写分别对应一致性、时序闪烁与运动平滑度。
Table 5
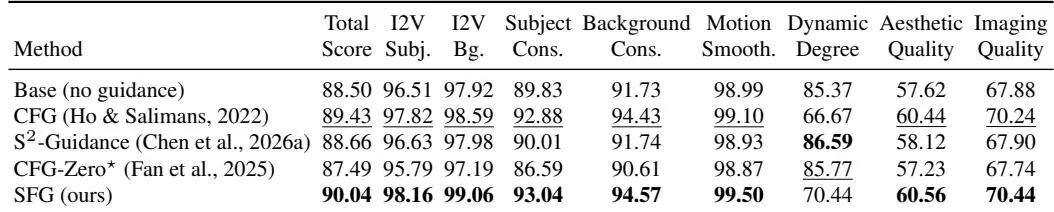
表5:HunyuanVideo 上不同引导方法的图生视频结果。报告 8 个 VBench 维度以及总分,涵盖参考图像一致性(I2V Subj./Bg.)与视频质量维度。
具体数字方面,文生视频任务上 SFG 在 7 个维度拿到 84.25 分,高于所有对比方法,也包括无引导的基线(82.58)。相对基线的 +1.67,是另一条自引导基线 S²-Guidance(+0.38)的四倍多。它在主体一致性和成像质量上领先,时序闪烁与运动平滑度也基本保持在基线水平附近,不像 CFG 那样把这两项压低。美学质量从 50.88 提到 56.00,算是一次明显的回升。
图生视频任务上,SFG 拿到 90.04 分,对比 CFG 的 89.43 与基线的 88.50,在报告的八列里有七列领先,与参考图像的一致性也最高。动态程度从 CFG 下的 66.67 升到 70.44,虽然仍低于无引导基线。另外值得注意的是,CFG-Zero⋆ 在这个任务上掉到了基线以下。
窗口设置的差异也很有意思。视频任务里,SFG 只在 25 步中的前 7 步激活,就能拿到 84.25;如果全程激活,反而只有 83.09,而且模型评估次数从 32 涨到 50。CFG 在测试的几个窗口之间变化不大,都低于 SFG 的早期窗口设置。这说明"反馈控制要趁早"并不是图像任务的特例,而是一条跨模态的规律。

实验全面领先:GenEval、HPSv2.1 等指标显著提升


实验结果分析

先看实验设置是否站得住。论文在图像任务上覆盖了 SD3M、SD3.5M、FLUX 三个 backbone,统一在 1024² 分辨率下评测。GenEval 的对比与引导尺度扫描用 553 条提示词、每条 6 个种子,单配置共 3318 张图;HPSv2.1 与 ImageReward 复用同一批 800 条提示词、四种风格、每条 4 个种子共 3200 张图。所有方法在同一配置下共享提示词和种子,这一点对公平性很关键——文生图的方差本来就大,不控种子的话差异很容易来自运气。
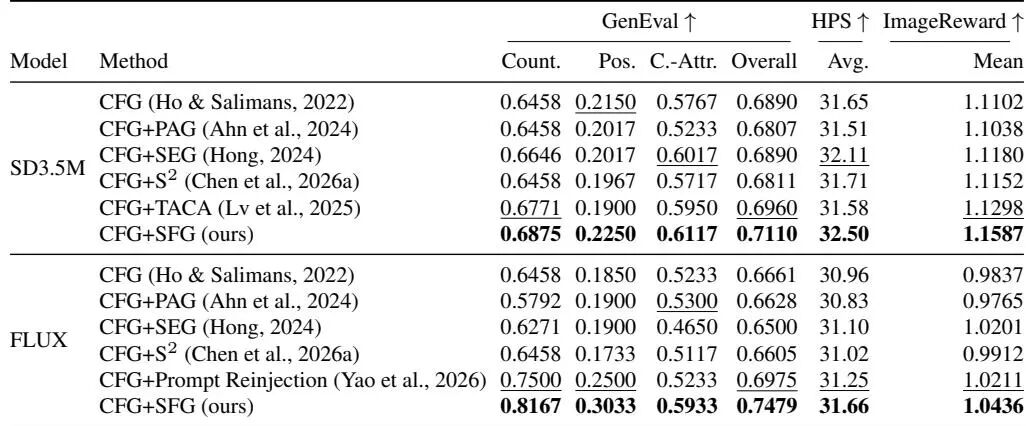
基线处理也算克制。PAG、SEG、S²-Guidance 都做了单独的权重扫描,取各自最佳设置再比,而不是随手拿个默认值凑数(对应附录中的表11 至表19)。TACA 被特意选作"加强文本到图像条件"方向上的对照,它和 SFG-X 的信息流方向正好相反,单独使用在 SD3.5M 上只能到 0.6960,明显低于 CFG+SFG 的 0.7110。这个对照很说明问题:单纯强化条件并不够,关键在于把反馈那条路压下去。
为什么这么做会有效?结合前面的机制分析,逻辑链是比较完整的:成功率与失败率的差异主要来自早期采样时物体布局是否定对,而 I2T 反馈会把已经画出来的内容(包括错的)回写到文本流,进而影响后续更新。在早期抑制这条反馈,等于给文本条件留出更大的话语权,让模型按提示词重新组织画面。后期的效果衰减、图生视频任务的同样规律,都跟这条解释自洽。
另外要提醒一句:结合 PaperDaily 已收录论文范围内的对比信息,目前在 GenEval、T2I-CompBench++、HPSv2.1 这几个基准上还没能拿到足量的同基准数值做交叉验证,因此本文正文里只按论文自报的数字陈述,不做"全领域绝对领先"的判断。文生图评测在不同实现里存在提示词拆分、判分模型版本、分辨率设置等差异,跨论文比较时需要留出余量。

主要实验结果

先看不用 CFG 的裸模型场景。在 cfg = 1 的设置下,SFG 把 SD3M 的 GenEval 从 0.3294 拉到 0.5811,T2I-CompBench++ 从 0.3230 拉到 0.4760;FLUX 上则从 0.3604 拉到 0.6853,从 0.3254 拉到 0.4727。对照最强竞争方法,GenEval 在 SD3M 上领先 PAG 0.0207,在 FLUX 上领先 SEG 0.1305。COCO 上的 FID 也从 41.76 降到 24.21,低于最好的竞争结果 26.00,也低于 CFG 在 s = 7.5 时的 32.49——而且这一切没有额外跑无条件分支。
Table 1
表1:SD3M 与 FLUX 上不使用 CFG 的文生图结果。所有方法的 cfg 均为 1,GenEval 与 T2I-CompBench++ 分别对六个和八个类别取平均;FID 在 SD3M 上用 5000 张 COCO 图像计算,作为参考,CFG 在 s = 7.5 时为 32.49。
叠加到 CFG 上之后,提升依然存在。SD3.5M 的 GenEval 从 0.6890 升到 0.7110,FLUX 从 0.6661 升到 0.7479,其中计数项从 0.6458 涨到 0.8167,位置项从 0.1850 涨到 0.3033,这两个恰是组合式生成里最难啃的部分。HPSv2.1 分别提升 0.85 和 0.70。相比之下,PAG、SEG 和 S²-Guidance 在两个 backbone 上都没能把整体 GenEval 抬到 CFG 之上。
Table 2
表2:SD3.5M 与 FLUX 上叠加 CFG 的文生图结果。每个额外的引导方法都与 CFG 组合使用。表中 Count.、Pos.、C.-Attr. 分别是计数、位置和颜色属性三个 GenEval 子项,用来展示 SFG 增益较大的类别;Overall 为六个类别的平均。HPSv2.1 对四种风格取平均,ImageReward 在同一批图像上取均值,各方法的提示词与种子完全一致。
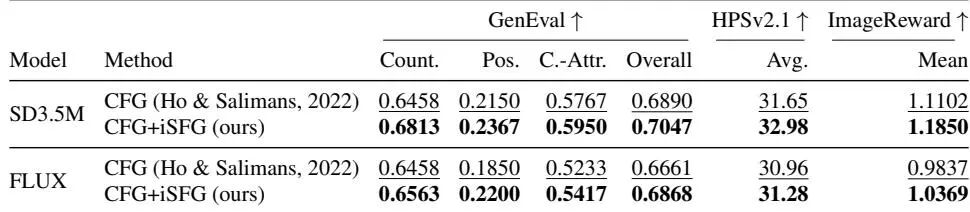
如果连辅助前向都想省掉,iSFG 在零额外 NFE 的前提下同样能把 CFG 往上抬。SD3.5M 的 GenEval 从 0.6890 到 0.7047,FLUX 从 0.6661 到 0.6868;HPSv2.1 分别 +1.33 和 +0.32,ImageReward 分别 +0.0748 和 +0.0532。有意思的是,iSFG 的整体 GenEval 增益小于 SFG,但在 SD3.5M 上的偏好分数反而更高(HPSv2.1 为 32.98 对 32.50),代价为零。这给实际部署留了一个很实用的选择。
Table 3
表3:在 SD3.5M 与 FLUX 上用 iSFG 改进 CFG,且不增加任何额外 NFE。iSFG 直接编辑条件前向,模型评估次数与 CFG 相同。Count.、Pos.、C.-Attr. 为增益较大的三个 GenEval 子项,Overall 为六类平均;HPSv2.1 对四种风格取平均,ImageReward 在同一批图像上取均值。
Figure 24
图24:SD3.5M 上的定性对比。每一组三联图在相同提示词与种子下对比 CFG+PAG、CFG+SEG 与 CFG+SFG(本文方法),提示词片段标出了所要求的物体与视觉属性。
Figure 25
图25:FLUX 上的组合能力对比。每一对在相同提示词与种子下对比 CFG 与 CFG+SFG(本文方法),提示词片段标注在图像对上方。

总结与展望:反馈控制为生成模型带来新思路

这篇论文的价值可以分两层看。方法层面,它给出了一个几乎"零门槛"的推理期控制旋钮:不改权重、不加模块、不重训,插进现有 MMDiT 管线就能用,甚至能零开销地用 iSFG 形式落地。机制层面,它把"图像回流文本"这条常被当作中性通道的路径,明确标注成了会放大错误的通道,并给出了从移植实验到方向分析再到定时窗口的完整证据链。
边界也很清楚。第一,SFG 原版依然要付出 1.2 倍以上的额外前向,iSFG 虽然零开销,但增益小于 SFG,是需要权衡的选择。第二,引导窗口和引导强度都需要针对具体模型和任务调,论文里图像用前 20%、视频用 25 步中的前 7 步,这个数字并非通用常数。第三,改善主要集中在文本—图像对齐类指标上,美学与画质类指标的提升幅度较小,甚至有回退,指望它一次性解决"更好看"的问题并不现实。第四,方法建立在 MMDiT 双流结构之上,对于纯 cross-attention 架构的老模型并不直接适用。
对写论文的人来说,这篇最有参考价值的其实是研究范式:先用可测量的干预实验把机制搞清楚,再依据测量出来的方向去设计模块,而不是先拍脑袋想一个模块再补一个解释。消息移植这套工具本身门槛不高,缓存一份中间激活、做基于 λ 的插值即可,换成其他多模态架构同样能复用。另外,"在哪一步干预"这类常被当成超参数的细节,一旦用实验量化出来,反而成了论文里最有说服力的部分。
往后看,这条思路最可能先落地在两类场景:一是对提示词忠实度要求高、但没预算微调的团队,比如电商素材、广告构图这类需要严格满足物体与位置约束的批量生成;二是视频生成里主体一致性与指令跟随的老问题。不过也别忘了前提,它改善的是"对齐",不是"想象"。如果你要的是天马行空的审美表达,这套抑制反馈的做法未必合胃口。

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?斯坦福、清华等提出训练无关的语义反馈引导SFG,通过抑制多模态扩散Transformer中图像到文本的回写反馈,让FLUX的GenEval从0.6661升至0.7479,iSFG还能零额外算力加成。
这篇工作最值得看的点是什么?在多个图像生成骨干网络上,SFG和iSFG在GenEval、T2I-CompBench++、HPSv2.1和ImageReward等指标上均取得显著提升。例如,在FLUX上,CFG+SFG将GenEval从0.6661提升至0.7479;在SD3.5M上,CFG+iSFG在零额外NFE下将HPSv2.1提升1.33。在视频生成任务上,SFG也提升了VBench分数。
这篇工作的边界或风险在哪里?优点:方法新颖,从机制分析出发,通过干预I2T反馈路径来提升生成质量,且iSFG零额外计算量,实用性强。实验充分,在多个模型和任务上验证了有效性。缺点:SFG需要额外的前向传播,增加计算成本;对I2T反馈的抑制可能在某些情况下过度,导致细节丢失;方法依赖于对MMDiT内部机制的深入理解,泛化到其他架构可能需要调整。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

提出语义反馈引导(SFG),通过构造一个增强图像到文本(I2T)反馈并削弱文本到图像(T2I)条件的辅助分支,引导生成远离该分支以抑制I2T反馈的负面影响,同时提出零额外计算量的原地变体iSFG,直接在前向传播中抑制I2T反馈并增强T2I条。

实验合理度:★★★★☆

GenEval, T2I-CompBench++, FID, HPSv2.1, ImageReward, VBench

学术研究价值:★★★★☆

提出语义反馈引导(SFG),通过构造一个增强图像到文本(I2T)反馈并削弱文本到图像(T2I)条件的辅助分支,引导生成远离该分支以抑制I2T反馈的负面影响,同时提出零额外计算量的原地变体iSFG,直接。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

SFG在无CFG时约需1.2倍基础NFE,有CFG时约2.2倍;iSFG无额外NFE,在A800上每张图增加约0.31秒(2.86%)

复现难度:★★★☆☆

https://github.com/yyc1215lll-creator/SFG

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:SFG需要额外的前向传播,增加计算成本;对I2T反馈的抑制可能在某些情况下过度,导致细节丢失;方法依赖于对MMDiT内部机制的深入理解,泛化到其他架构可能需要调整。


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球