太空越来越挤,交会筛选扛不住了
固定阈值一刀切的问题出在哪
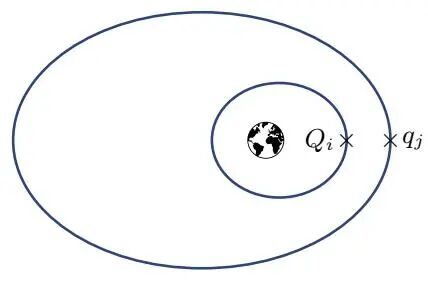
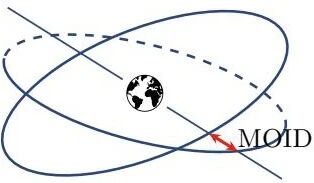
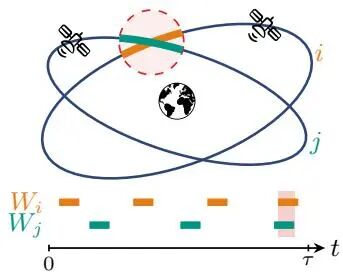
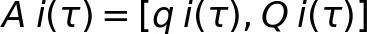
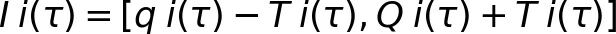
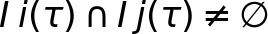
用公开星历历史"猜"出每个目标的不确定度
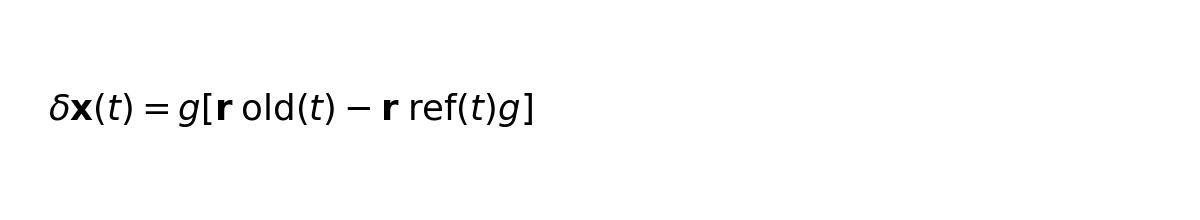
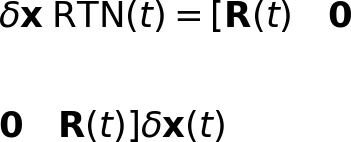

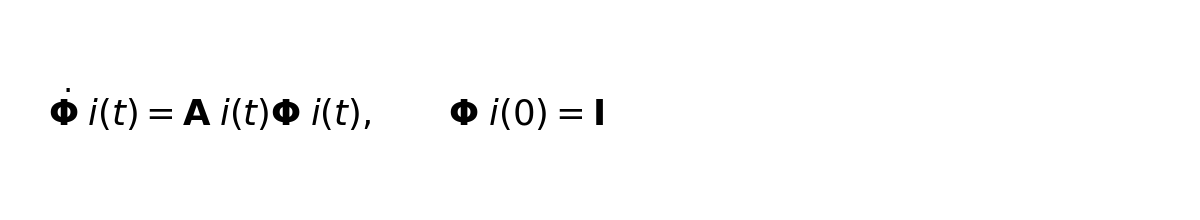
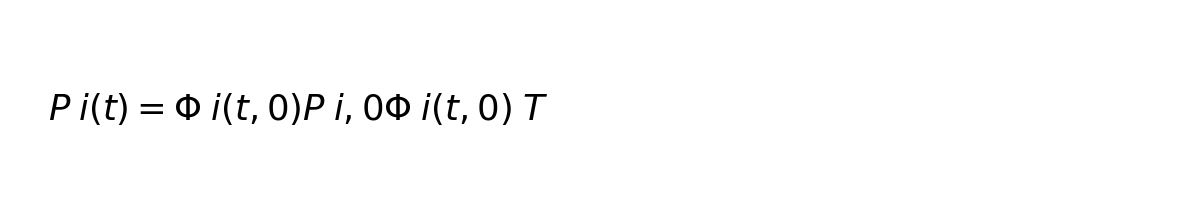
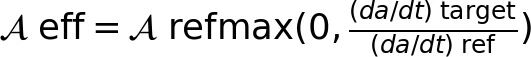


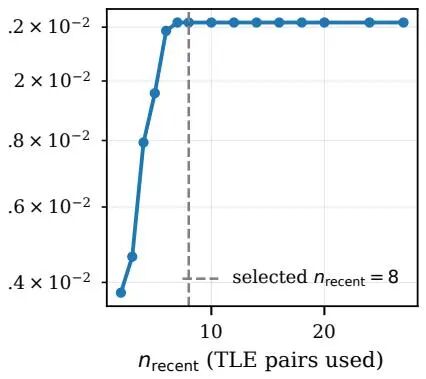
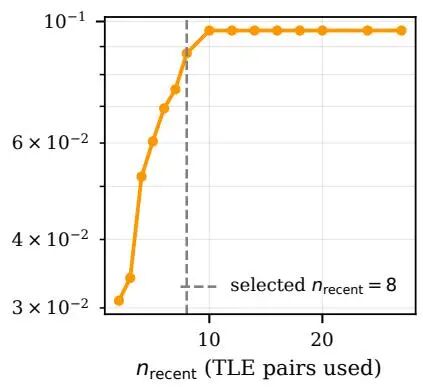
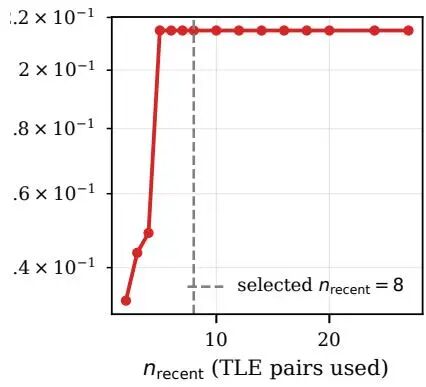
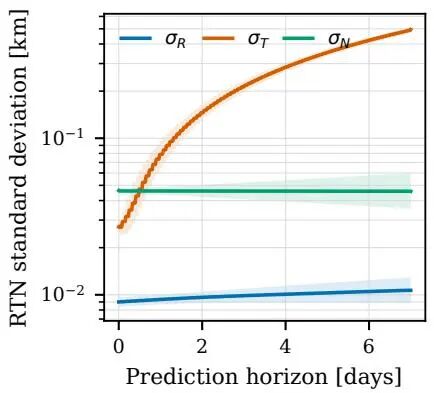
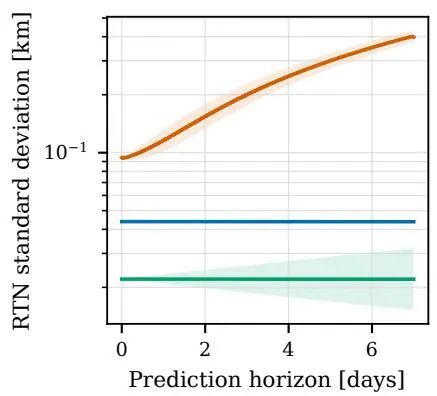
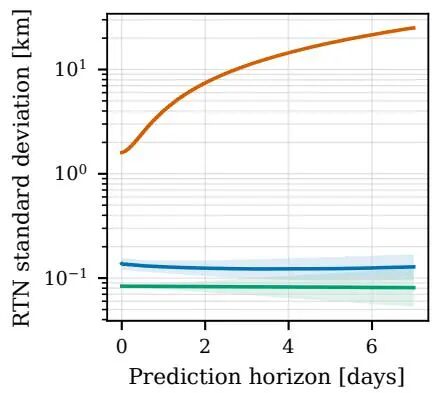
自适应阈值加二分搜索,快27倍还不丢目标
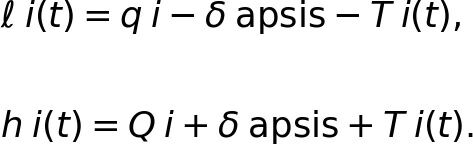
算法1:二分搜索式高度扫描

输入:撑开后的区间集合 {[ℓ_i(t), h_i(t)]},i = 1...N
输出:候选对集合 C

1. 将所有区间按下界 ℓ_i(t) 升序排序,保留物体标识
2. 初始化候选集 C 为空
3. 对 i = 1 到 N-1:
4.     j_max ← UPPERBOUND({ℓ_j(t)}, h_i(t)) - 1
5.     对 j = i+1 到 j_max:
6.         C ← C ∪ {(id_i, id_j)}
7. 返回 C结果有多硬核,边界在哪里
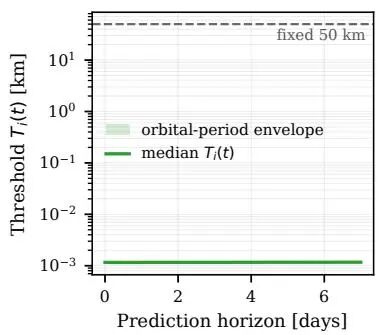
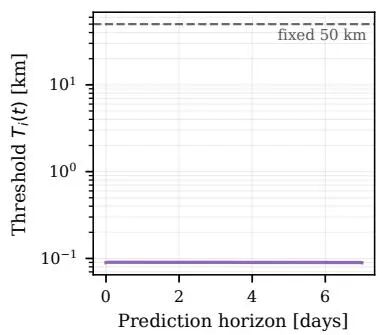
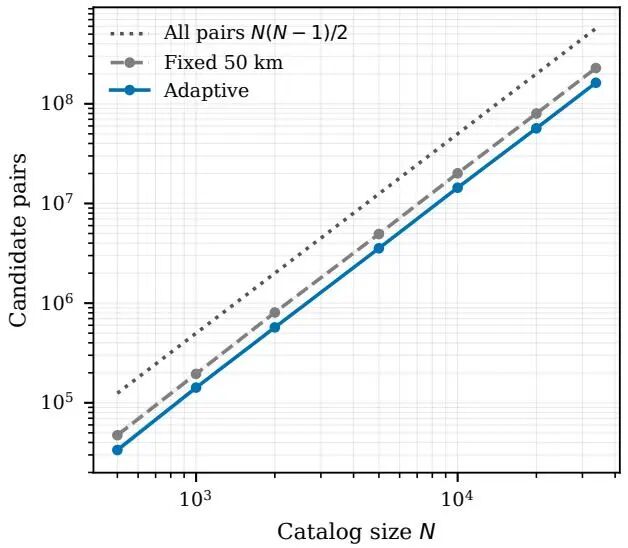
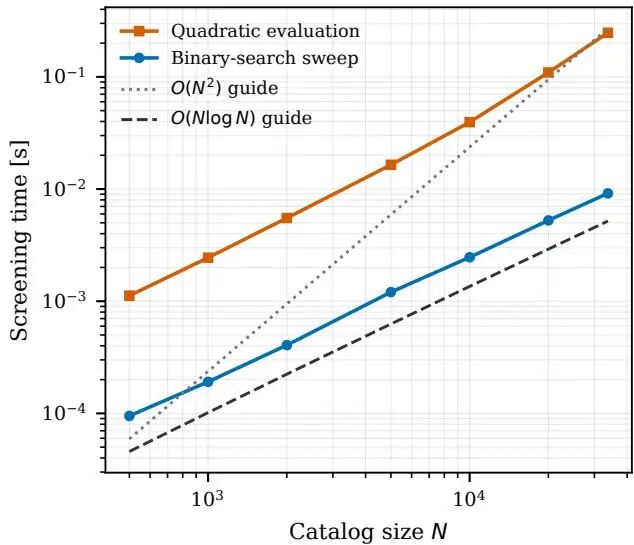
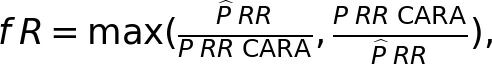
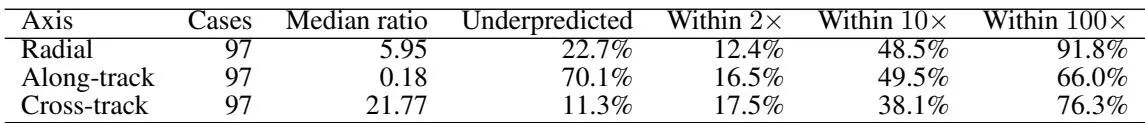
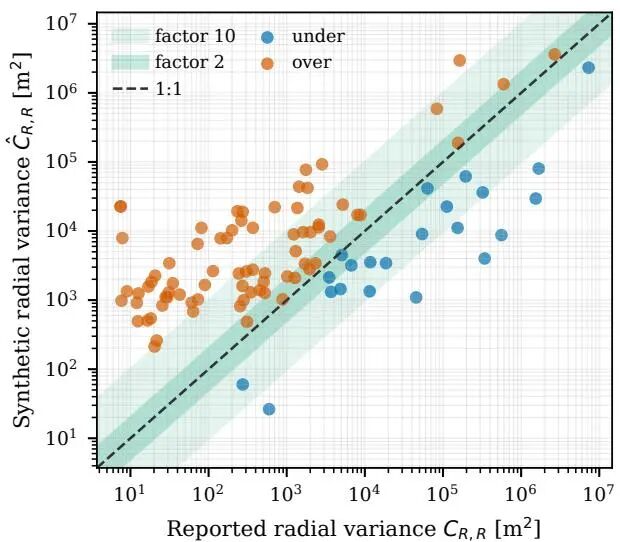
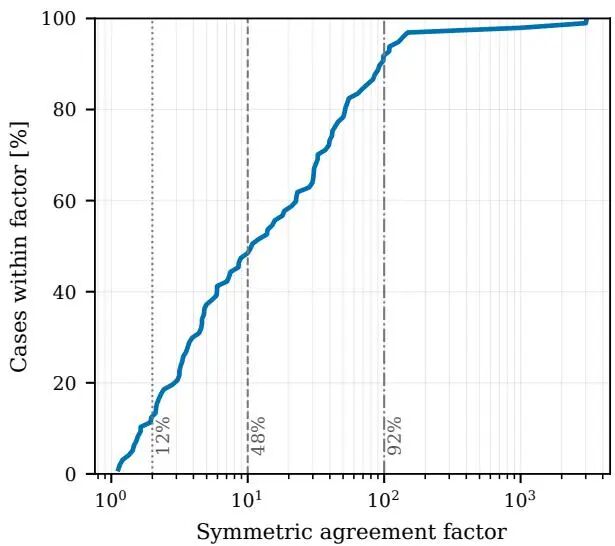
第一,合成协方差不是标定协方差。它度量的是公开星历之间的分歧程度,而不是经过标定的绝对轨道不确定度。所以这个阈值更像是"相对保守程度的分配器",而不是严格意义上的概率门限。论文附录拿 NASA CARA 的 PCTESTCASECDMS 数据集做了交叉对照,用 97 个低轨目标案例比较传播后的合成径向方差与 CARA 报告方差,整体落在同量级但也存在倍数级差异,这也是作者反复使用"covariance-like"这种谨慎措辞的原因。
第二,实验全部在低轨环境下完成。外推到大椭圆轨道或者深空轨道需要重新验证,因为那里的大气阻力几乎不存在,误差增长的主导项完全不同。
第三,窗口和采样都是设定值。七天预报窗口、30 分钟采样间隔、60 秒积分步长都是从工程角度拍定的,换窗口长度阈值分布会跟着变,需要重新调系数。
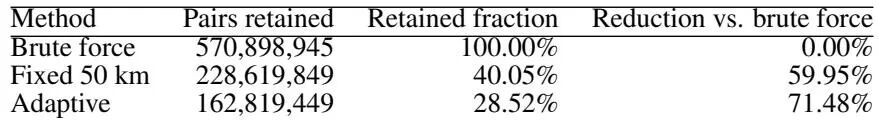
第四,8507 个目标直接落回固定阈值。这个比例不算小,接近编目的四分之一。历史星历不足的目标占不到自适应方案的好处,这也说明方法的覆盖能力受限于公开数据的完整性。
第五,也是最需要读者留心的一点:整个链路省下来的是候选对数量,但真正的计算瓶颈可能已经转移到协方差传播和 STM 积分那一侧去了。论文自己也说明,27 倍这个数字是排除轨道传播和协方差生成、只用预计算好的拱点区间测出来的。所以真实生产环境里的端到端加速比,绝对不是论文里这个 27 倍。这一点一定要拎
龙迷三问
龙哥点评
论文创新性分数:★★★★☆
用公开星历历史构造目标专属合成协方差并数值传播,将传播后的径向不确定度转化为随时间变化的自适应近地点阈值,配合二分搜索高度扫描实现星表规模的高效筛选。实验合理度:★★★★☆
候选对保留数量、候选对缩减比例、近距接近召回率、二分搜索与穷举评估的候选集一致性、CPU筛选时间、单目标查询延迟、合成协方差与CARA协方差的对称一致因子。学术研究价值:★★★★☆
用公开星历历史构造目标专属合成协方差并数值传播,将传播后的径向不确定度转化为随时间变化的自适应近地点阈值,配合二分搜索高度扫描实现星表规模的高效筛选;更关键的是问题定义是否可复用到同类任务。稳定性:★★★☆☆
现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。适应性以及泛化能力:★★★☆☆
现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。硬件需求及成本:★★★☆☆
全星表协方差与状态转移矩阵传播使用单块NVIDIA L40 GPU,固定批大小1500个目标,float32精度;二分搜索高度扫描在N=33777时CPU单线程耗时0.00916秒,穷举二次区间评估耗时0.247秒,加速27倍;复现难度:★★★☆☆
现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。产品化成熟度:★★★☆☆
论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。可能的问题:现有材料尚未充分覆盖分布外泛化、部署成本、长期稳定性和失败案例。
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!

还没有公开留言,欢迎留下你的看法。