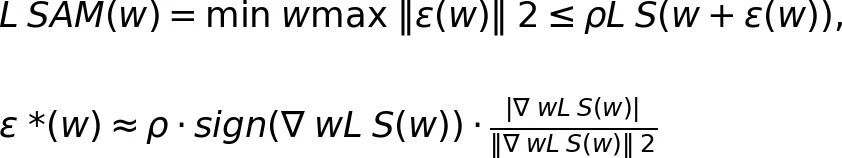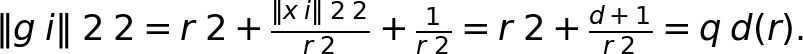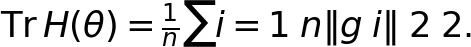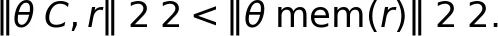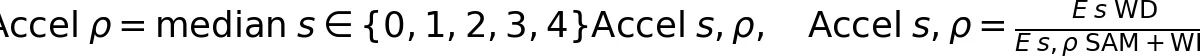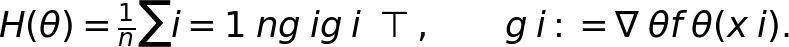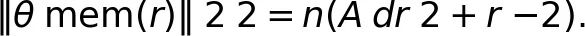← 返回 PaperDaily 大模型与智能体

普渡大学新研究:SAM能找最平坦解却不泛化,加速4倍要靠权重衰减

「平坦的最小值更容易泛化」这条被引用了快三十年的经验规律,这次被普渡大学拿出来单独审了一遍。结论有点扎心:用 SAM 硬把解压到最平,模型照样一点儿没泛化;真正把模型从记忆推向泛化的,是权重衰减带来的范数下降,SAM 只是在这个窗口里帮忙踩了一脚油门,把转变加速到最多 4 倍。理论构造那部分尤其漂亮:两种插值的平坦度一模一样,差距全在范数上。

普渡大学新研究:SAM能找最平坦解却不泛化,加速4倍要靠权重衰减
原论文信息如下:
论文标题:
Do Flatter Minima Drive Better Generalization? An Algorithmic Separation in Grokking
发表日期:
2026年10月
发表单位:
普渡大学(Purdue University)
原文链接:
https://arxiv.org/pdf/2610.11206v1.pdf

平坦的解一定泛化更好吗?Grokking现象给出反例
「平坦的最小值更容易泛化」这个说法在深度学习圈里流传的时间,比很多从业者的工龄都长。1997 年 Hochreiter 和 Schmidhuber 就讨论过平坦极小值与泛化的关系,2017 年 Keskar 等人关于大批量训练的研究又把它推到台前。大量实验反复观察到同一件事:收敛到平坦区域的模型,在没见过的数据上往往更稳。基于这条经验规律,研究者造出了一类专门「找平」的优化器,其中最出名的就是 SAM(Sharpness-Aware Minimization,锐度感知最小化,2021 年由 Foret 等人提出)。
但相关不等于因果。一个解又平又能泛化,只能说明这两件事经常一起出现,并不能说明平坦就是泛化的驱动原因。Dinh 等人 2017 年就指出,锐度这类指标可以通过重新参数化被随意操纵;Kaur 等人 2022 年也发现,SAM 能把最大特征值压下去,泛化却没有跟着涨。这篇来自普渡大学的论文,作者 Mohnish Harwani,换了一个更干净的实验场,想把这个问题问到底。
要检验「平坦是不是泛化的驱动力」,理想场景是能把记忆和泛化在时间上拆开。Grokking 正好是这样一个场景。Power 等人 2021 年在模运算任务上发现了它:模型先快速把训练损失降到接近零,测试准确率却一直停在瞎猜水平,看上去是彻底过拟合;继续训练几千个 epoch 之后,测试准确率会突然大幅拉升,模型仿佛突然想通了。中文里通常把 grokking 译成「顿悟」或者「延迟泛化」。
从机制上看,grokking 期间发生的是模型从记忆解(memorizing interpolant)迁移到了泛化解(generalizing interpolant)。记忆解可以想象成给每个训练样本单独开一个专属神经元,训练集背得滚瓜烂熟,可一旦输入稍微偏离训练样本,输出就废了;泛化解学到的是数据背后的共享结构,在模运算任务里通常表现为傅里叶式的电路。两条路都能把训练损失压到零,但对没见过的输入的预测能力完全不同。本文的做法很直接:把 SAM 丢进这个场景,看它能不能把模型从记忆解推到泛化解。
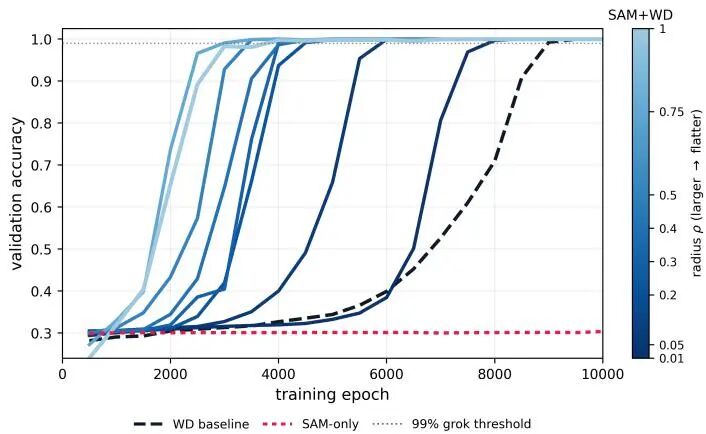
Figure 1
平坦化正则只在 grokking 已经发生的场景里加速泛化,它本身无法单独触发泛化。颜色越浅代表正则越强,更强的正则对应更快的泛化。
图1 给出的就是整体结论:只有权重衰减已经让 grokking 发生的设置里,更强的平坦化才会让泛化来得更快;SAM 单独上,并不会触发泛化。也就是说,平坦度在这里演的是加速器的角色,不是开关。
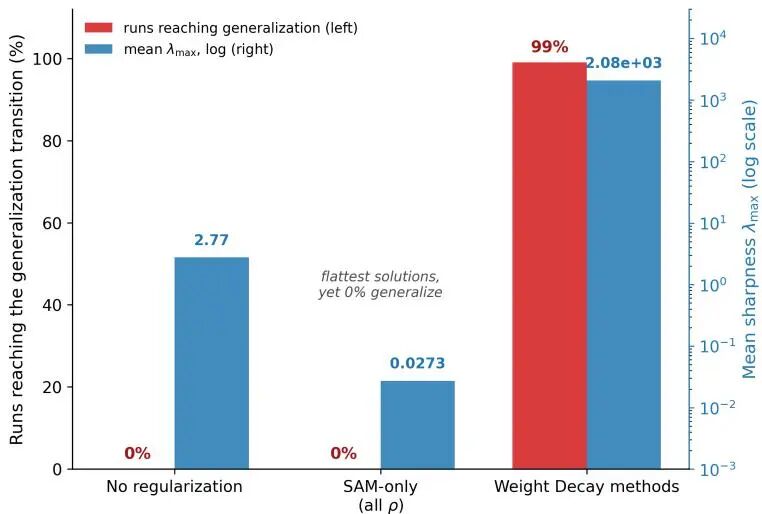
如果只看单一指标,这个结论会让人有点不适应。图2 把两类方法的最终锐度和泛化率放在一起对比:只用 SAM 的组找到的解是所有条件里最平坦的,最大特征值最低,却没有一次运行真正完成泛化转变;而带权重衰减的方法,最终解的锐度明显更高,泛化率却是 99%。这是一个相当直接的反例——平坦度和泛化率之间,并不存在一条稳定的因果链。
Figure 2
图2:平坦度本身解释不了泛化转变。红色柱(左轴)表示达到泛化转变的模运算运行比例;蓝色柱(右轴,对数刻度)表示训练损失 Hessian 的最终锐度均值。只用 SAM 的方案平坦得多,但没有任何一次运行泛化成功;带权重衰减的方案虽然在 99% 的情况下完成了泛化,最终解却陡峭得多。
这里的 λmax 指训练损失 Hessian 矩阵的最大特征值,它是衡量损失曲面局部陡峭程度的常用指标,数值越小说明当前解附近的曲面越平。本文用 Hessian 向量积配合 Lanczos 迭代来估计它,避免了显式构造 Hessian 矩阵的巨大开销。除了 λmax,论文还报告了它的尺度归一化版本 λmax/‖θ‖² 以及 Han 等人 2025 年提出的相对平坦度指标,三套指标的结论一致:SAM 类方法的解确实更平。

SAM单独使用为何无法触发泛化转变

要理解为什么 SAM 单独不行,先得看清它是怎么工作的。普通训练只要求当前参数点的损失尽可能低;SAM 多了一步——先在当前参数点附近找一个损失最高的邻域点,再让模型去压低那个最坏情况下的损失。用一句大白话说就是:不仅要自己成绩好,还要保证坐到隔壁座位成绩也不差。
SAM objective
公式:SAM 的优化目标与扰动近似。其中 L_SAM(w) 是 SAM 的损失函数,w 为模型权重,ε(w) 是参数扰动,ρ 是扰动半径,L_S 是普通训练损失,ε*(w) 是使损失上升最快的扰动方向,实际实现时用梯度的符号方向乘 ρ 来做近似。
公式里最关键的参数是 ρ(rho),它决定往周围看多远。ρ 越大,理论上要求解越平坦;但这个近似依赖一阶泰勒展开,ρ 超出某个范围后估计会失真,反而压不住锐度。这一点后面还会再遇到,它是解释「加速效果先升后降」的关键。
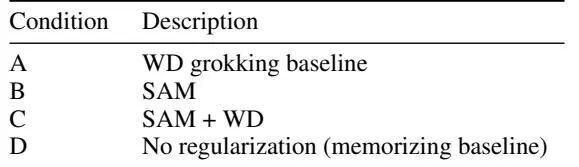
论文在 (a+b) mod p(p 取 97 和 113)这类模运算任务上,用 1 层和 2 层 Transformer 展开实验,一共 4 组条件,每组 5 个随机种子。四种实验条件见下表。
Table 1
表1:实验条件。A 为权重衰减的 grokking 基线;B 为只用 SAM;C 为 SAM 加权重衰减;D 为不加任何正则的记忆基线。WD 为权重衰减(Weight Decay)。
结果的反差很大。只用 SAM 的那一组确实找到了最平坦的解,Hessian 最大特征值在所有条件里最低,但不管 ρ 取多少、种子怎么换,都没有一次完成从记忆到泛化的转变。反过来,带权重衰减的两组——纯 WD 和 SAM+WD——最终解的锐度比 SAM-only 高出一大截,却在几乎所有设置里都完成了泛化,验证准确率也很高。
这个结果直接挑战了 Han 等人 2025 年提出的观点。那项工作认为平坦度是 grokking 中泛化转变的必要几何条件,而本文给出的反面证据是:最平坦的解可以完全不泛化。不过本文的表述比较克制,作者并没有说平坦度和泛化完全无关,而是把相关性和因果性明确区分开——相对平坦度确实经常和泛化开始的时刻同时出现,但这个相关性不足以支撑「平坦是选择器」的说法。
fine.JPEG
还有一个细节值得一提:作者指出 Han 等人提出的相对平坦度指标在置信度和尺度变化下并不具备不变性,直接拿它跨条件比较可能会被误导。这也是本文更倾向用 Hessian 最大特征值以及尺度归一化版本的原因。

权重衰减才是泛化的选择器:范数分离记忆与泛化解

既然平坦不是选择器,那谁是?本文的答案回到了参数范数。这个思路并不是全新的。Varma 等人 2023 年用电路效率框架给出了解释:存在一个范数阈值,当参数范数降到足够低之后,泛化电路所需的成本会低于记忆电路,于是模型转向泛化解。Liu 等人 2023 年也报告过类似现象,把那一段范数区间称为「金发姑娘区」。本文的工作是把这条线索和「平坦度」这条线索摆到同一个实验台上,看看到底谁在起作用。
为了把这件事讲清楚,论文构造了一个极简的两层 ReLU 网络。ReLU 即 Rectified Linear Unit,修正线性单元,就是那个把负数截成零的激活函数。网络的输入是 d 维的 ±1 向量,学习目标是 y(x)=x₁x₂,训练集由互不相同的输入和对应标签组成。在这个设定下,作者显式构造了两类插值解:记忆解和 (C, r)-泛化解。
记忆解的做法是给每一个训练样本配一个专属神经元:神经元的权重方向与该样本对齐,偏置设成只在这个样本上激活的形式,输出系数是标签除以尺度 r。这种神经元只对那一个样本有响应,所以模型在训练集上完美拟合,在其他超立方体点上输出接近零。
(C, r)-泛化解的做法不同:每个神经元对应一个长度为 C 的模式,多个输入可以共享同一个神经元,因为一个神经元覆盖了 2^(d−C) 个输入。由于不同输入之间共享了模式,模型学到的是 x₁x₂ 这个乘法关系本身,而不只是记住每个样本。C 越小代表学到的结构越稀疏, generalizations 的范围也越大。
两类解都有一个共同参数 r,它决定激活区域的「尺度」。论文定义了一个量 q_d(r)=r²+(d+1)/r²,用来度量插值解的平坦度。值得注意的是,这个量只依赖 r 和输入维度 d,和模式长度 C 完全无关。
q_d(r)
公式:单个样本的梯度范数平方 ∥g_i∥² = r² + (d+1)/r² = q_d(r)。其中 g_i 是网络输出对参数的梯度,d 是输入维度,r 是激活尺度。该量是后续平坦度比较的基础。
论文用的平坦度指标是 Hessian 的迹。在插值解处,Hessian 可以写成各样本梯度外积的平均,它的迹就等于各样本梯度范数平方的平均。结合上面的构造,每个样本的梯度范数平方恰好等于 q_d(r),于是迹平坦度也就被确定了。
Tr H
公式:在插值解处,Hessian 的迹等于各训练样本梯度范数平方的平均值。n 为训练样本数,g_i 为第 i 个样本对应的参数梯度。迹平坦度越大,说明损失曲面在参数空间中的整体弯曲程度越高。
这就得到了本文「算法分离」的第一条结论:记忆解和泛化解的迹平坦度完全相同。平坦度在这里变成了一把没用的尺子,它没有能力把两类解区分开。
Trace equality
公式:记忆插值解与泛化插值解的 Hessian 迹相等,都等于 q_d(r)。这说明在同等尺度下,平坦度无法区分两类解。
第二条结论转向范数。在同样的尺度 r 下,只要训练集足够大,泛化解的参数范数严格小于记忆解的范数。原因不难理解:泛化解用共享特征覆盖了多个输入,同样的参数预算能表达更多规律;记忆解则要给每个样本单独开支,样本一多,总范数自然水涨船高。
Norm inequality
公式:同尺度下泛化解的参数范数平方严格小于记忆解。∥θ_C,r∥² 为泛化解的二范数平方,∥θ_mem(r)∥² 为记忆解的二范数平方。
把两条结论放在一起,前面看到的实验现象就说得通了。权重衰减直接惩罚参数范数,于是它把优化轨迹推向范数更低、也就是泛化的那一支;平坦度不具备这种区分能力,所以 SAM 单独用得再狠,也选不对方向。这也解释了为什么 SAM-only 能找到最平坦的解却不泛化——它把曲面压平了,但没有改变模型选择了哪一支。

SAM如何加速泛化:低范数窗口内的局部稳定性分析

如果 SAM 既不是选择器,也不是完全没用,那它在 grokking 里到底扮演什么角色?论文的答案是:踩油门。前提是权重衰减已经把车开到正确的路上了。
要说明这一点,论文用的是局部稳定性分析。思路是:记忆解和泛化解都能把训练损失压到零,所以不能只看损失高低,要看在优化器的动力学下,哪一个解是「稳」的。具体做法是把优化器在某个解附近的更新线性化,如果对应的更新矩阵谱半径小于一,这个解就是一个吸引子,优化器会留在那里;反之,优化器就会从这个解附近逃出去。这套工具此前被 Chang 和 Khanna 以及 Dexter 等人用来分析优化器与极小值之间的关系。
在局部二次近似下,梯度下降的线性化更新矩阵是 I−ηH,其中 η 是步长,H 是 Hessian;SAM 的等效曲率则是 H(I+γH),对应的更新矩阵是 I−ηH(I+γH),其中 γ=ρ/α,反映扰动半径与步长的比值。差别就在多出来的那一项:SAM 对曲率更大的方向惩罚更重。
由此得到定理 1 的第三条,也是整篇论文最关键的机制结论:存在两个正的阈值 r_low 和 r_high,当尺度 r 落在 (r_low, r_high) 这个区间时,记忆解在梯度下降下是局部稳定的,在 SAM 下却是不稳定的。
这句话的直观含义是:在高范数阶段,梯度下降和 SAM 都会卡在记忆解附近;而当权重衰减把范数压到足够低、进入这个窗口之后,SAM 会比梯度下降更早察觉到记忆解的不稳定,从而更早逃离,转向范数更低的泛化解。SAM 没有决定去哪儿,它只是让转变发生得更快。
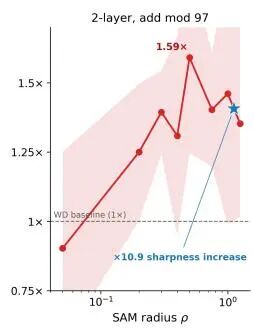
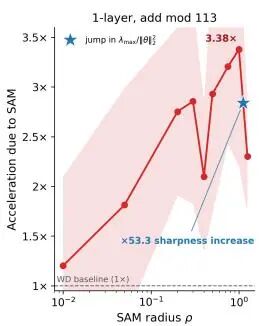
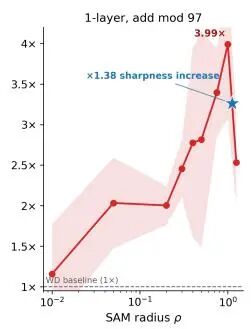
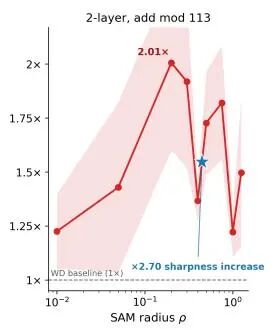
这个理论预测在实验里表现得很清楚。图3 展示了不同 ρ 下 SAM+WD 相对纯 WD 的加速倍数。在 p=97 的模加法任务、1 层 Transformer 的设置里,合适的 ρ 能带来大约 4 倍的 epoch 级加速。
Figure 3
图3:SAM 加速泛化。横轴为 SAM 半径 ρ,纵轴为 SAM+WD 相对纯 WD 的加速倍数,覆盖模加法任务上的多种 Transformer 架构。加速倍数定义为 WD 完成 grokking 的 epoch 数与 SAM+WD 对应 epoch 数的逐种子比值中位数,虚线为 WD 基线(1 倍)。阴影区域为 5 个种子上 SAM+WD grokking epoch 的正负一个标准差。蓝色星标表示尺度归一化锐度 λmax/‖θ‖² 开始上升的位置,说明 SAM 的一阶泰勒估计开始失真、无法再有效施加平坦性约束。
这里的加速倍数定义得比较严格:先对每个随机种子分别计算纯 WD 与 SAM+WD 完成泛化转变所需 epoch 数的比值,再取 5 个种子的中位数。这样处理的好处是同一实验条件下不同种子的方差不会互相干扰,得到的是配对比较的结果。
Accel
公式:加速倍数的定义。Accel_ρ 为给定半径 ρ 下的中位加速倍数,s 为随机种子编号,E_s^WD 与 E_s,ρ^SAM+WD 分别是纯权重衰减与 SAM+权重衰减在该种子下完成泛化转变的首个 epoch。
Figure 3 detail a Figure 3 detail b Figure 3 detail c
图3 分项曲线:不同任务与不同模型配置下,SAM+WD 相对 WD 的加速倍数随 ρ 变化的趋势。可以看出加速随 ρ 增大而上升,但到某个阈值后开始回落。
这个加速不是越大越好。ρ 增大到某个程度之后,加速开始明显回落。论文给出的解释是第一阶泰勒近似在高 ρ 下失真,SAM 对扰动方向的估计不再准确,约束平坦度的能力随之下降。补充材料中的锐度曲线也支持这个解释:ρ 增大到同一个大致阈值之前,Hessian 最大特征值持续下降,超过之后不再下降,甚至略有回弹。换句话说,加速能力和「能把解压多平」这两件事,共享同一个上限。

从模运算到图像分类和NLP:加速效应的广泛验证

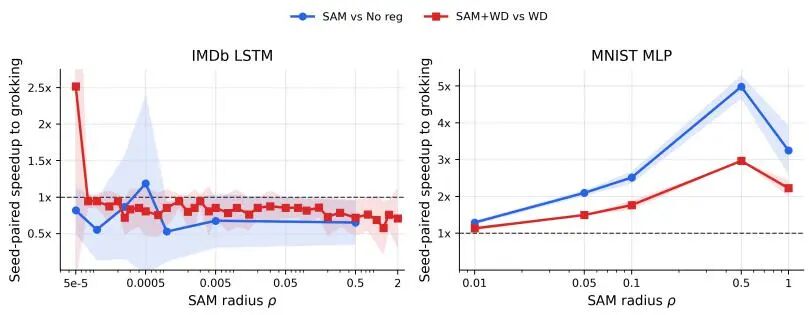
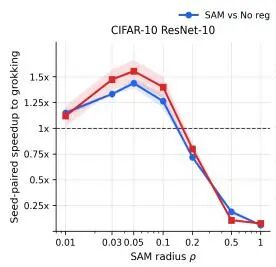
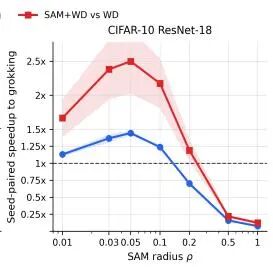
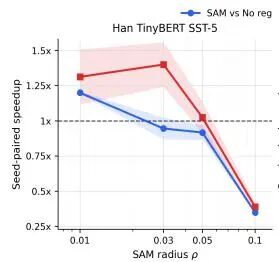
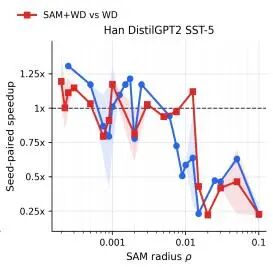
模运算任务的好处是可解释,但它的结构毕竟特殊。所以论文把实验扩展到了视觉和语言任务上。这部分借用了两项已有设置:一项是 Liu 等人 2023 年提出的 Omnigrok,它通过放大初始化尺度并配合正则化,在图像、语言甚至分子预测任务上复现了 grokking 式的延迟泛化;另一项是 Han 等人 2025 年通过锐度正则化在视觉和语言任务上诱导的延迟泛化。本文在这些设置上加了 SAM,训练了 CIFAR-10 上的 ResNet、SST-5 上的 TinyBERT 和 DistilGPT2,以及 Omnigrok 设置下的 LSTM 和 MLP。
结果显示同样的模式:ρ 增大带来更强的平坦化正则,在已经存在泛化驱动的条件下,泛化转变来得更快;ρ 超过一定值之后,加速效果回落。图4 是 CIFAR-10 和 SST-5 上的结果,图5 是 MNIST 和 IMDB 上的结果。
Figure 4 and 5
图4 与图5:SAM 半径 ρ 与 grokking 加速倍数之间的关系。左列为 CIFAR-10 上训练的模型,右列为 SST-5 上的模型;下方两幅为 Omnigrok 设置下 MNIST 与 IMDB 的结果。较大的 ρ 通常带来更强的平坦化正则,并在与权重衰减组合时加快 grokking 转变,直到 ρ 过大。阴影区域为 3 个种子上的中位数上下一个标准差。
作者在这部分保持了克制:在这些任务上,泛化的核心机制很难像模运算那样被干净地隔离,所以论文的表述是,SAM 在泛化已经发生时加速这个转变,而不是说 SAM 在这些任务上触发了泛化。这个边界划得比较清楚,也和前面理论部分的结论对得上。
从实验设计的合理性看,模运算部分每个条件跑 5 个种子,SAM 的每个 ρ 都作为独立条件对待,加速倍数用同种子配对后的中位数,这种处理避免了跨种子方差带来的虚高。视觉和语言任务上种子数是 3 个,统计功效相对弱一些,这也是论文把主要因果结论锚定在模运算任务上的原因。整体上实验设置是合理且完整的,没有出现只挑好看结果的情况;同时也要注意,本文在可解释任务上验证的是「平坦不是选择器」,在视觉和语言任务上验证的只是「加速趋势一致」,两部分的证据强度并不相同。

实验结果

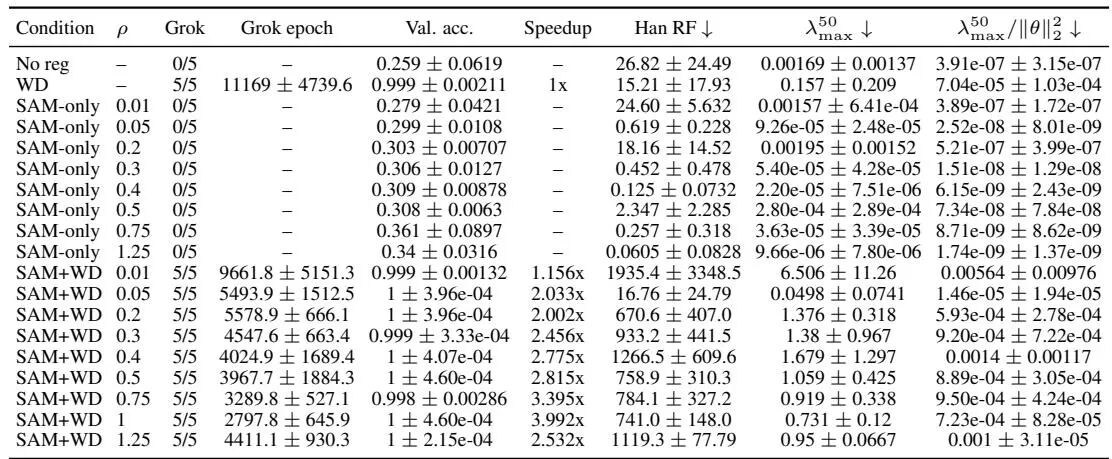
论文把模运算任务上的完整结果整理成了几张表。表2 是 1 层 Transformer 在模加法任务上的结果,包含是否完成 grokking、验证准确率、配对种子的加速倍数,以及三套锐度指标:Hessian 最大特征值、它的尺度归一化版本,以及 Han 等人提出的相对平坦度指标 Han RF。
Table 2
表2:1 层 Transformer 的模加法结果。Grokking 与验证指标来自 5 个配对种子的运行;Speedup 为 SAM+WD 相对 WD 的配对种子中位加速倍数;Han RF 为 Han 等人提出的相对平坦度指标;Hessian 各列来自按任务、条件和 ρ 匹配的 3 种子后验结果。
Table a
表(a):1 层 Transformer 在 add mod 113 任务上的全部模运算结果,同时列出三种锐度指标,包括 Hessian 最大特征值的参数归一化版本。
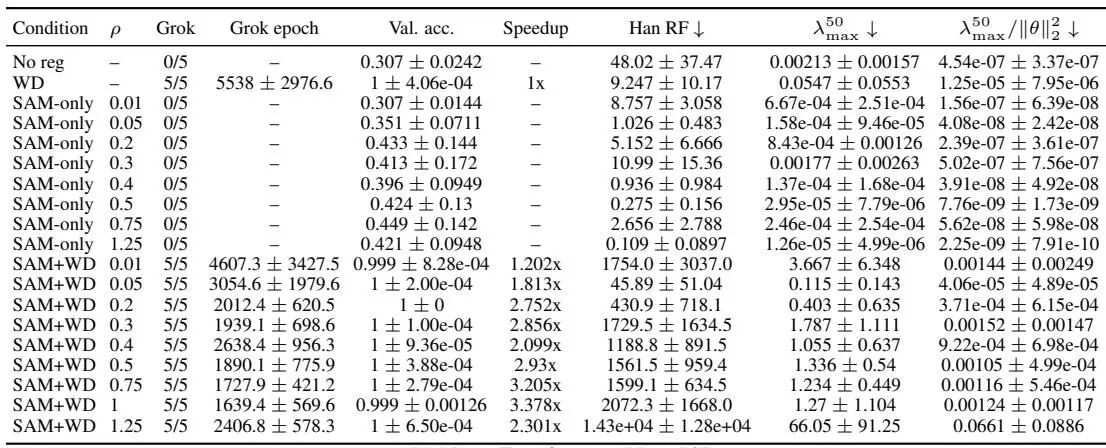
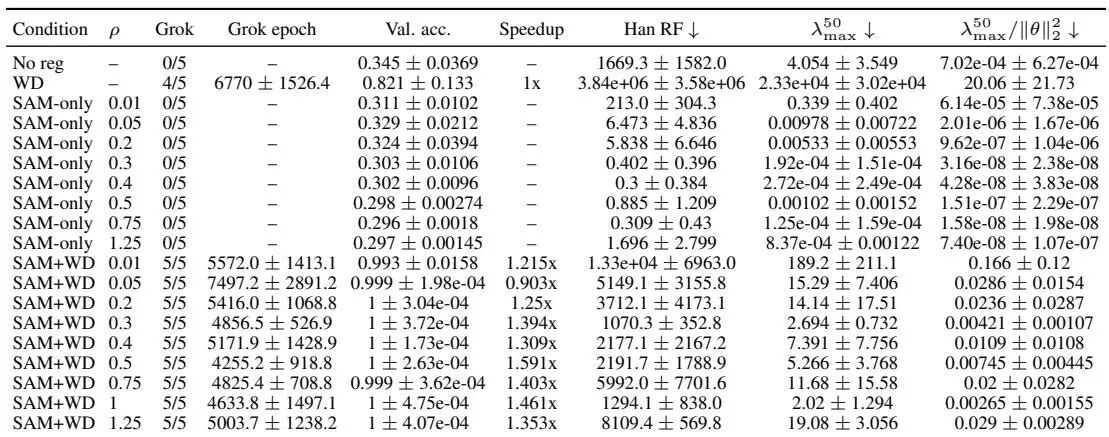
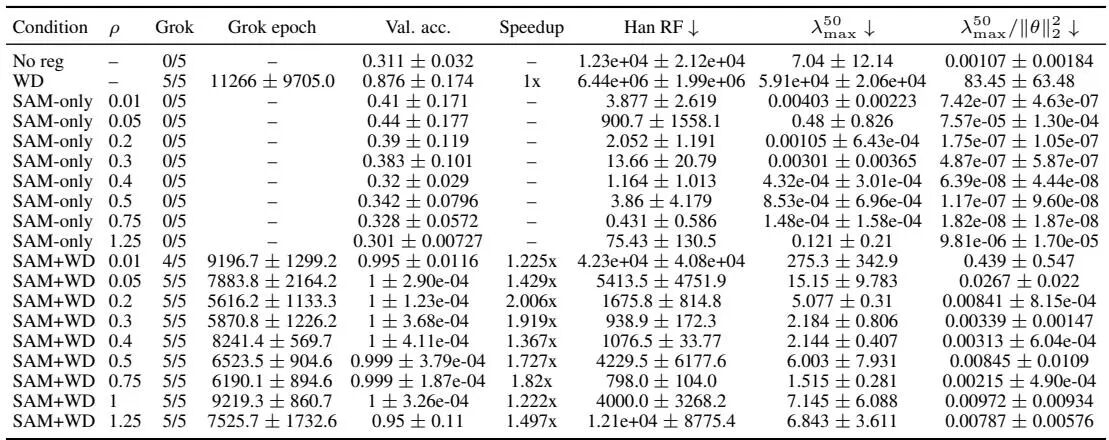
表3 是 2 层 Transformer 的结果,结论一致:只用 SAM 的组锐度最低但泛化率为零,带权重衰减的组完成了泛化,且加速倍数随 ρ 增加而上升。
Table 3
表3:2 层 Transformer 的模加法结果。各列含义与表2 相同,覆盖 add mod 97 与 add mod 113 两种任务。
Table c d
表(c)(d):2 层 Transformer 在 add mod 113 与 add mod 97 上的分项结果。
extra curve a extra curve b extra curve c extra curve d
补充对比曲线:不同 ρ 取值下泛化速度与锐度指标的变化趋势,用于说明加速与平坦化能力共享同一个上限。
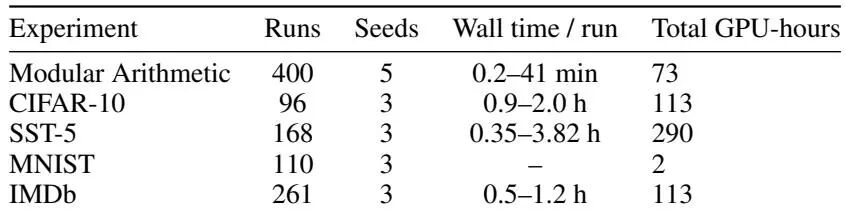
最后,表4 汇总了复现全部结果所需的运行次数、种子数、单次运行的墙钟时间和总 GPU 小时数,它同时也是评估这套方法工程代价的依据。SAM 每次更新要多做一次前向和一次反向传播,计算成本比标准训练明显更高,这直接限制了它在实际训练流程里的使用范围。
Table 4
表4:各任务独立复现全部结果所需的总运行次数、种子数、单次运行墙钟时间与总 GPU 小时数。

理论构造揭秘:两层ReLU网络中的算法分离

前面几节的结论都建立在一个极简的解析模型上,这里补充一下它的构造细节。网络是两层 ReLU 结构,参数包括每层的权重、偏置和输出系数,训练损失用平方误差。之所以选择平方损失,是因为在插值解处 Hessian 的结构会变得非常干净,可以直接写出解析形式。
Hessian
公式:插值解处的 Hessian。H(θ) 等于各训练样本梯度 g_i 外积的平均,g_i 是网络输出对全部参数的梯度。该矩阵半正定,其迹即样本梯度范数平方的均值。
对记忆解来说,每个神经元的权重是 r·x_i,偏置是 −r(d−1),输出系数是 y_i/r。计算梯度范数时分三部分:权重项贡献 r²,激活函数带来的输入项贡献 ‖x_i‖²/r²,由于输入是 ±1 向量,这一项等于 d/r²,偏置项贡献 1/r²,加起来就是 r²+(d+1)/r²。对 (C, r)-泛化解做同样的计算,会得到完全一样的表达式,这就是两类解迹平坦度严格相同的由来。
范数的差异则来自参数的组织方式。记忆解要为 n 个样本各配一个神经元,参数范数有一个显式表达:单个神经元贡献 A_d·r²+1/r²,其中 A_d 是与维度有关的常数,n 个样本累加之后整体量级随训练集规模线性增长。
mem norm
公式:记忆解的参数范数平方。n 为训练样本数,A_d 为与输入维度相关的常数,r 为激活尺度。范数随样本数量线性增长,这是记忆解「开销大」的直接体现。
泛化解的参数范数按 2^C 个模式累加,因为一个神经元覆盖了 2^(d−C) 个输入,参数量被摊薄。当训练集足够大时,泛化解的总范数严格小于记忆解——这就是定理 1 第二条的完整含义。
定理 1 的第三条给出的是稳定性窗口的存在性:在低范数区间内存在一段 r 的取值,使得记忆解在梯度下降下谱半径小于一(稳定),在 SAM 下谱半径大于一(不稳定)。这意味着 SAM 具备把模型从记忆解里「踢出去」的能力,但这个能力只在权重衰减把范数压进窗口之后才生效。在高范数区间,两者都会稳定在记忆解上,SAM 也救不出来。
作者也明确说了理论部分的局限:这个构造是解析可解的极简模型,用的是平方损失和 SAM 的二次近似,不能直接套用到交叉熵损失、注意力层、归一化层和随机小批量训练上。所以这套结论更适合被理解为提供了一个可解释的机制框架,而不是一条通用的稳定性阈值定理。另外论文也提到,这里的范数很可能只是「模型容量」的一个代理量,把结论推广到更一般的容量度量上,作者留作了未来工作。

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?普渡大学用模运算Grokking证明:最平坦的解未必泛化,真正挑选泛化解的是参数范数;SAM配合权重衰减可把泛化转变加速最多4倍。
这篇工作最值得看的点是什么?SAM-only找到最平坦的解但泛化率为0%;WD类方法找到较尖锐的解但泛化率约99%;SAM+WD相比WD单独使用可实现最高约4倍的epoch级加速;加速效果随ρ增大而增强,直到ρ过大导致一阶泰勒估计失效后加速效果下降。
这篇工作的边界或风险在哪里?优点:首次在grokking框架下通过算法分离清晰区分了平坦性、范数和局部稳定性三个常被混淆的角色;理论构造简洁优雅,可解析处理;实验覆盖模运算、图像分类和NLP多个领域,验证了结论的广泛性;对SAM加速效应的解释具有实践指导意义。缺点:理论分析基于简化的两层ReLU模型,与实际架构差距较大;视觉和语言任务上无法隔离因果机制;SAM的计算开销未纳入加速比计算;未提出新的优化器或正则化方法。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

通过SAM与权重衰减的组合实验及一个可解析的两层ReLU插值网络,从算法层面分离平坦性、参数范数与局部稳定性在grokking泛化转变中的不同角色,证明平坦性只能加速而非驱动泛化。

实验合理度:★★★★☆

泛化转变epoch数、加速比、验证准确率、Hessian最大特征值λmax、尺度归一化锐度λmax/||θ||²、Han相对平坦度指标

学术研究价值:★★★★☆

通过SAM与权重衰减的组合实验及一个可解析的两层ReLU插值网络,从算法层面分离平坦性、参数范数与局部稳定性在grokking泛化转变中的不同角色,证明平坦性只能加速而非驱动泛化;更关键的是问题定义是否可复用到同类任务。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

模运算任务总GPU时约73小时,CIFAR-10约113小时,SST-5约290小时,MNIST约2小时,IMDb约113小时;SAM每次更新需额外一次前向-反向传播

复现难度:★★★☆☆

现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:理论分析基于简化的两层ReLU模型,与实际架构差距较大;视觉和语言任务上无法隔离因果机制;


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球