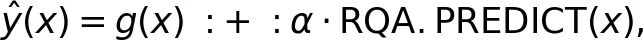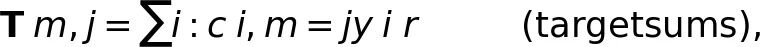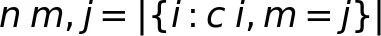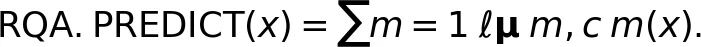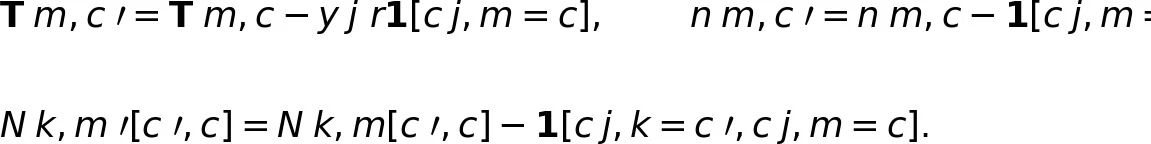
← 返回 PaperDaily 大模型与智能体

Meta提出QSS:机器遗忘删除提速483倍,15个数据集实测

法规给了用户"删除权",可模型不会说忘就忘——过去想精确抹掉一个样本,基本只能重训。Meta这篇把模型拆成冻结的骨架和可加的内容,删除直接退化成算术减法,低类别数任务上期望延迟比SISA快483倍,还做到与重训比特级一致。值得花时间读。

Meta提出QSS:机器遗忘删除提速483倍,15个数据集实测

paperdaily_reaction_gif


原论文信息如下:
论文标题:
Exact Unlearning via Quantized Sufficient Statistics
发表日期:
2026年10月
发表单位:
Meta Platforms, Inc.
原文链接:
https://arxiv.org/pdf/2610.07197v1.pdf
开源代码链接:
https://github.com/atavory/rqu

AI真的能"忘记"你吗?Meta提出精确遗忘新范式

2018年5月,欧盟《通用数据保护条例》(GDPR)正式生效,其中有一条被通俗地叫作"被遗忘权"。几乎同一时间,美国加州的《加州消费者隐私法案》(CCPA)也把类似的要求写进了法律。翻译成人话就是:用户有权说"把我的数据删了",而企业必须让模型表现得像从来没见过这条数据。
听起来不复杂,但真正落到工程上,这件事的难度远超大多数人的想象。数据库删一条记录是删一行;模型删一条记录,等于要把这条数据在几十亿参数里留下的所有痕迹抹干净,还得让最终产出的模型,和一个"从一开始就没见过这条数据"重训出来的模型,表现完全一致。学术上管这个叫精确机器遗忘(Exact Unlearning)。
问题的根子在"纠缠"两个字。标准的训练过程把每一条样本都编织进共享参数里,你没有一条干净的通道,可以把某一条样本单独抽出来。所以过去最稳妥的做法只有一个字:重训。把数据删掉,从头再训一遍,成本是 O(n),n 是数据集大小。数据量到了百万、千万级别,每来一次删除请求就重训一次,账单和延迟都很难看。
绕开重训的主流方案叫 SISA,全称是 Sharded, Isolated, Sliced, and Aggregated training,中文一般译作"分片隔离切分聚合训练"。思路很直白:把数据集切成 S 份,每份单独训一个小模型,最后集成投票。删除请求来了,只重训受影响的那一片,成本从 O(n) 降到 O(n/S)。
但 SISA 有一个绕不过去的死结:每一次删除请求,必然击中某一个分片,也就必然触发一次重训。想降低重训频率,只能把分片切得更细;分片越细,每个子模型能看到的数据越少,精度越差。这是一条硬邦邦的取舍曲线,SISA 自己没法往上挪。
meng
Meta 这篇论文给出了另一种解法。论文标题是《Exact Unlearning via Quantized Sufficient Statistics》,署名单位是 Meta Platforms, Inc.,作者包括 Ami Tavory、Shripad Gade、Tal Sarig、Noam Touitou、Ido Guy。他们提出的方法简称 QSS,全称 Quantized Sufficient Statistics,中文可以译作"量化充分统计量"。
一句话概括它的思路:不要让模型把样本"记住",而是把模型拆成一块永不变的"骨架"和一块可以随时做减法的"记忆",删除请求到了,骨架不动,记忆减一笔就完事。

把模型拆成"骨架"和"记忆":QSS的核心原理

QSS 的核心动作是"解耦"。它把一套完整的预测系统劈成两半:一半叫骨架(Schema),一半叫内容(Content)。
骨架包括两个东西:一个基模型 g,和一套残差量化码本。骨架只在一小撮随机抽出的数据 D° 上训练,训练完立刻冻结,此后再也不改动一个参数。内容则是剩下那绝大部分数据 D•,但它并不保存原始样本,只保存按码本索引排好的一堆"充分统计量"。
这里引入一个比例参数 ρ,定义为 n°/n,也就是骨架数据占总数据的比例。论文通篇取 ρ = 0.5%,意思是 99.5% 的数据都是"可删除内容",只有那 0.5% 是骨架,需要特殊处理。这个比例相当激进,相当于让极小一撮数据去定全局结构,剩下全部数据只贡献局部修正。
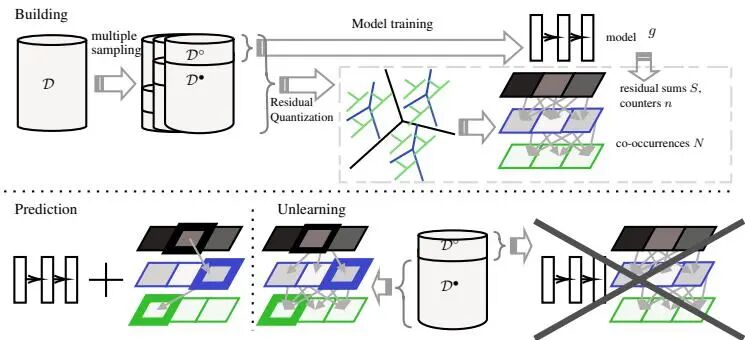
QSS三阶段架构图
图2:QSS 架构的三个阶段。上方为构建阶段,数据 D 被拆成保留子集 D°(用于训练基模型 g 和残差量化码本)与可删除子集 D•,全部数据被编码并累积成可变的充分统计量(残差和 S、计数器 n、共现计数 N)。左下方为预测阶段,查询样本经过冻结的残差量化层级编码,单元均值相加,再由基模型 g 补上自身预测。右下方为遗忘阶段,从 D• 中删除一个点只需递减对应累加器;只有当删除落在 D° 上时,该实例才会被标记失效并需要重建。
这套架构的关键在于预测形式。QSS 的预测输出由两部分相加而成,公式如下。
QSS预测公式
公式1:QSS 的预测公式。ŷ(x) 是最终预测,g(x) 是骨架基模型的输出,RQA.PREDICT(x) 是记忆查表给出的残差修正,α 是混合权重,靠交叉验证在留出折上确定。α 取 0 时公式退化成 g(x),也就是纯骨架模型的效果。
公式1 看似平平无奇,但它埋了一个非常重要的性质:预测等于"骨架 + 加性记忆"。删掉一条记忆,只是把这个和里的一项减掉,骨架完全不动。这就把"遗忘"从优化问题变成了算术问题。
论文还区分了两种边界清晰、但工程含义完全不同的删除关系,这一点很容易被读者忽略。

标签删除:保留输入 x,但抹掉它的标签 y 以及全部监督影响。典型场景是标注被撤回、结果被更正、用户撤回了反馈。论文记作 D^-y_j。

实例删除:输入和标签一起删,训练结果必须等同于这条样本从来没有出现过。论文记作 D^-j。这是 GDPR 语境下最严格的口径。
为了匹配这两种关系,QSS 给出了三种工作模式。QSS-E 的码本只在 D° 上训练,因此支持 D• 内样本的精确标签删除和精确实例删除;QSS-L 的码本用全部数据训练,分辨率更高、精度更好,但只支持精确标签删除,因为码本质心本身已经沾上了可删除样本的输入特征;QSS-DP 则在 QSS-L 基础上对发布的单元均值加高斯噪声,提供 (ε, δ)-标签差分隐私(Differential Privacy,差分隐私)。
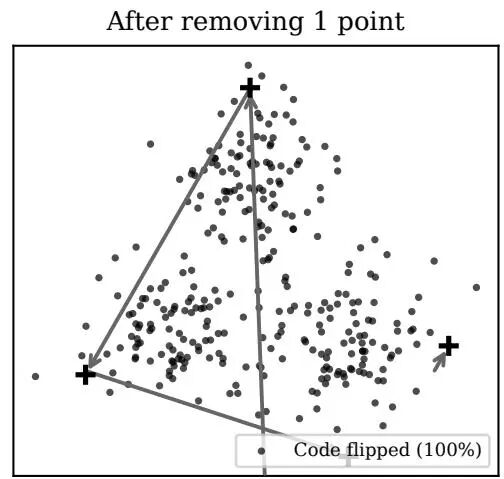
为什么 QSS-E 要这么小心,非要把码本和可删除数据隔开?论文专门用一个实验回答了这个问题:k-means 聚类对单点删除的敏感度远超直觉。在二维合成数据上删掉一个点再重新聚类,有 30% 的样本码分配发生了翻转;换到 768 维的 CLIP 嵌入上,翻转率直接变成 100%。
码本不稳定性示意
图6:码本不稳定性实验(二维合成数据,b=20,300 个点)。左图为原始 k-means 质心(+)与 Voronoi 边界;右图为删除一个点(×)后重新训练 k-means 的结果,质心发生位移(箭头),30% 的码发生翻转(深色点)。值得注意的是,翻转发生在远离被删点的位置,说明这个扰动是全局性的;在 768 维 CLIP 嵌入上,翻转率高达 100%。
这也顺便解释了论文里反复强调的一句话:希望获得实例级精确删除时,码本必须独立于可删除数据。QSS-E 的做法就是把码本锁在 D° 上,代价是它必须接受一块由 0.5% 数据定义的、稍微粗糙一些的空间划分。
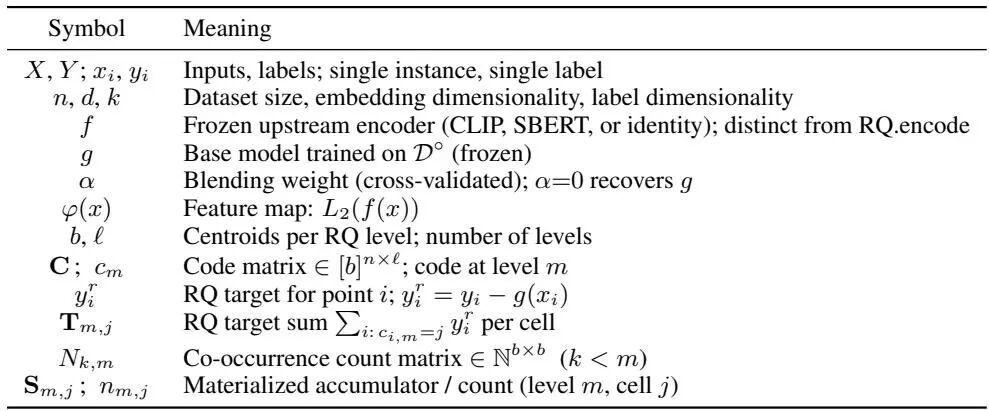
论文为这套符号体系配了一张完整的记号表,方便读者对照公式。
QSS记号表
表1:论文记号表。上标 ◦ 表示保留子集,上标 • 表示可删除部分。X、Y 是输入与标签;n、d、k 分别是数据集规模、嵌入维度与标签维度;f 是冻结的上游编码器(CLIP、SBERT 或恒等映射);g 是在 D° 上训练的基模型;b、ℓ 是残差量化每层质心数与层数;C 是码矩阵;T 是每个单元的目标残差和;N 是共现计数矩阵;S、n 是物化后的累加器与计数。

从残差量化到加性统计:删除只需做减法

要理解 QSS,得先理解它借用的基础设施:残差量化。残差量化英文是 Residual Quantization,简称 RQ,思想并不复杂:把每个嵌入向量表示成 ℓ 个质心向量之和,每一级从 b 个候选里挑一个,第 m 级量化的是前 m-1 级没描述干净的那部分残差。打个比方,就像画一幅画,先大面积定基调,再一层层往上补细节。
RQA 是 QSS 在这套码本上搭起来的数据结构,全称 RQ-Accumulator,中文可译作"残差量化累加器"。它不存原始数据,只存三类可以逐项相加、也可以逐项相减的统计量。
目标残差和公式
公式2:目标残差和。T_m,j 表示第 m 层第 j 个单元里所有样本残差目标的总和,y_i^r 是样本 i 的残差目标,即真实标签减去基模型预测后的差值。
单元计数公式
公式3:单元计数。n_m,j 表示第 m 层第 j 个单元里落了多少个样本,它和 T 一起决定了该单元的均值。
第三类是共现计数 N_k,m[j', j],统计的是第 k 层落在 j'、同时第 m 层落在 j 的样本数。这三类量全部是对样本求和得来的,所以加一个样本是加法,删一个样本就是减法,没有中间状态。
预测的时候,系统沿着查询样本的码路径,把每一层的单元均值加起来。
RQA预测公式
公式5:RQA 预测。c_m(x) 是查询样本在第 m 层的码,μ_m,c 是该单元的均值,ℓ 是量化层数。所有层的单元均值累加后,再乘上权重 α 加回基模型输出。
删除动作则写成了三行减法。
删除的减法更新公式
公式:遗忘更新。删掉样本 j 时,目标残差和 T 减去该样本的残差贡献,计数器 n 减去 1,共现计数 N 减去该样本覆盖到的所有层级对组合。由于一个点要穿过 ℓ 个层级,层级两两组合是 ℓ² 量级,所以整个更新复杂度是 O(ℓ²) 次递减,与数据集规模 n 完全无关。论文的复杂度表给出的完整快路径成本是 O(ℓ²b²k)。
这里有个容易被忽略的细节:为什么非要存共现计数 N?因为在残差量化里,第 m 层的残差目标是"标签减去前 m-1 层的单元均值",层与层之间是有依赖的。如果不记共现,想要重新算某一层某个单元的均值,就必须知道它和之前所有层级的联合分布,那个开销是 b^ℓ 级别的,层数一深就指数爆炸。有了 N,重算就退化成多项式时间。
残差量化到标签残差提升的转换
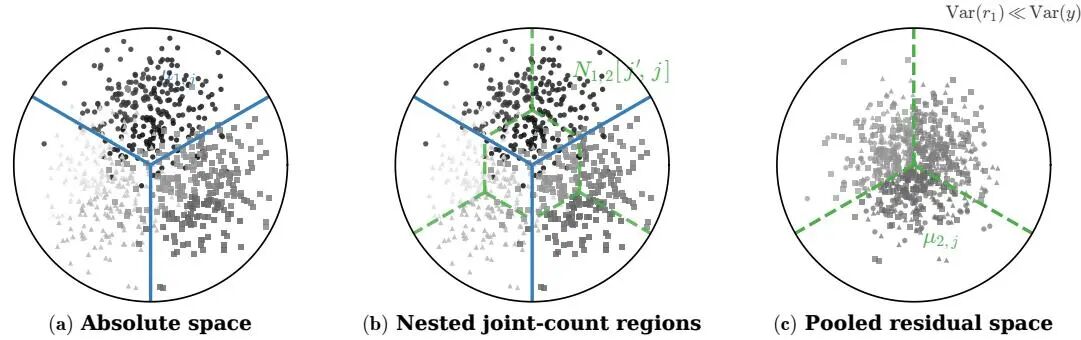
图1:QSS 把嵌入空间上的残差量化,翻译成了标签上的残差提升。标记形状(圆圈、三角、方块)表示单元归属,颜色深浅表示目标值 y_i。子图 (a) 中,第 1 层 Voronoi 单元(b=3)把嵌入空间切开,每个单元有各自的强度等级,但单元内部仍能看到明显的散布。子图 (b) 中,嵌套的第 2 层码本把每个单元继续细分,交叠区域定义了共现计数 N_{1,2}[j', j],这些计数以可加统计量的形式存储,使得精确遗忘可以通过简单的计数递减完成。子图 (c) 中,减掉第 1 层单元均值后,所有点塌缩到残差空间,原本宽泛的强度散布收缩成一条窄带,说明标签残差的方差远小于原始标签——每一级残差量化都在修正前一级,这与以量化质心为弱学习器的梯度提升思路一致。
论文给出的命题 1 说明了精确性到底有多精确:在 QSS-E 模式下,对 D• 中任意一个点执行 RQA.UNLEARN,产出的预测与"在删除该点后的数据集上从头重训整个系统"得到的预测逐比特一致。证明逻辑并不复杂:既然骨架(编码器 φ、码本、基模型 g)只依赖 D°,而 (x_j, y_j) 落在 D• 里,删掉它既不改变码分配,也不改变残差目标;而累加器本身是可加的,减掉 j 的贡献,得到的数值和在 D∖{j} 上重新构建完全一样;最后,物化过程是这三个统计量的确定性函数,所以最终预测必然一致。

冗余模式机制:如何让重建概率指数级下降

前面说的都是"删除落在 D• 上"的理想情况。但如果删除请求恰好击中骨架数据 D°,骨架就必须重建。ρ=0.5% 意味着这个概率不算大,但也不是可以忽略的数字。
QSS 的第二招是冗余。它同时维护 p ≥ 1 个相互独立的实例,每个实例拥有自己随机抽取的 D°_i、自己的基模型 g_i、自己的码本。关键在于,每个实例的累加器都聚合了全部数据 D,D°_i 只用来训练骨架。
这样一来,一次删除最多只能击穿一个实例的骨架,因为各个 D°_i 是独立抽取的,同一条样本同时落在所有骨架里的概率是 ρ^p。只有当 p 个实例全部失效,系统才需要同步重建。
论文把这种设计称为拉斯维加斯式(Las Vegas)的运行时保证:结果永远是精确的,随机性只决定这次请求走的是算术快路径,还是重建慢路径。这与蒙特卡洛算法有本质区别,后者是用了随机性以后结果就带上了概率误差。
还有一个容易漏掉的好处:重建期间,其余 p-1 个实例继续以全精度提供服务。因为每个实例的累加器都看到全部数据,下线任何一个实例都不损失精度。这一点和 SISA 截然不同——SISA 把一个分片拿下去重训,整个集成模型就少看了 1/S 的数据。
期望延迟因此可以直接写成两段。
期望删除延迟公式
公式8:单次删除的期望成本。t_RQ 是快路径的累加器更新开销,与数据规模 n 无关;t_rebuild 是完整重建开销,包括重训基模型、重新抽取嵌入、重训码本、重新编码全部 n 个点并重新累积。ρ 越小,第二项的权重越低。
论文还分析了重建调度。在即时重建策略下,两次重建之间平均能撑过约 1/(pρ) 次删除;而离线最优策略的间隔是 H_p/ρ(H_p 是第 p 个调和数,p=3 时约为 1.83)。两者之比为 p·H_p,p=3 时大约是 5.5 倍。也就是说,即时重建虽然不是最优调度,但最坏情况下也只比理论最优多花 5.5 倍的代价。
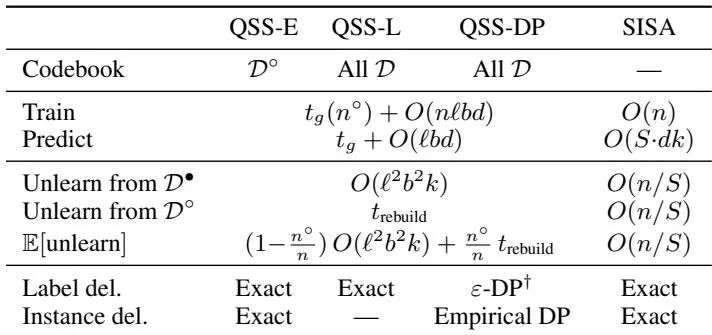
论文把三种模式、复杂度与删除保证整理成了一张表。
QSS复杂度与删除保证
表2:QSS 的复杂度与删除保证。QSS-E、QSS-L、QSS-DP 三者的差别在码本训练集和噪声上,三者都使用同一套 RQA 数据结构。当删除命中 D°(概率 n°/n)时,基模型 g 和码本都必须重建。可以看到 QSS 的预测开销是 O(ℓbd),删除开销是 O(ℓ²b²k),两者都与 n 无关;SISA 的对应开销分别是 O(S·dk) 与 O(n/S),后者随数据规模线性增长。
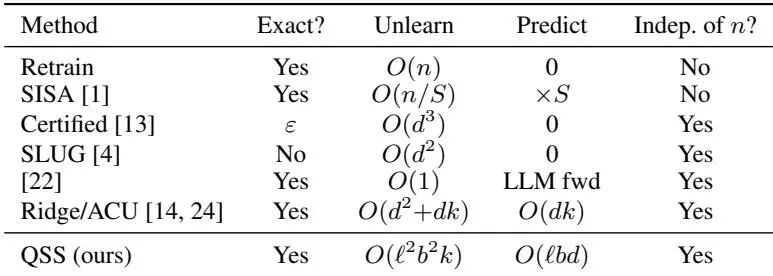
论文还把 QSS 放进了整个精确遗忘方法谱系里做横向比较。
遗忘方法架构对比表
表3:与已有遗忘方法的架构对比。全量重训是精确的但成本 O(n);SISA 精确但成本随 n 线性增长;认证删除只提供 ε 级近似保证;SLUG 并不精确;冻结 LLM 加聚类的方法虽然删除是 O(1),但每次预测都要跑一遍完整 LLM 前向;精确岭回归类方法在低维线性头上很高效;QSS 同时具备精确性、与 n 无关的删除开销,并且不需要 LLM 前向。

15个数据集实测:精度与速度的权衡

实验部分先交代数据准备与整体设计。论文挑选了 15 个规模 n ≥ 50K 的数据集,理由是删除速度只有在数据量足够大时才会成为真正的瓶颈;标签类别数 k 从 2 一直铺到 1000,横跨视觉、文本、表格三种模态。
特征侧统一使用冻结编码器:5 个视觉任务用 CLIP ViT-L/14,输出 768 维;4 个文本任务用 all-MiniLM-L6-v2,输出 384 维;6 个表格任务则用 LightGBM 的叶子贡献作为特征。所有嵌入都做了 L2 归一化。基模型 g 的选择规则是:n° 小于 5000 时用线性探针,否则用单隐层 MLP。码本宽度 b、层数 ℓ 以及混合权重 α 都在 D° 上做交叉验证。
对照方法设了三组。第一组是 D°-only,只用骨架数据训练基模型,作为精度下限;由于 α=0 时 QSS 精确退化为它,QSS 在结构上就保证了不会低于这条线。第二组是 SISA,把 D• 切成 S=5 片,每片单独训练同架构模型再多数投票,删除时重训受影响的那一片,这是精度上限。第三组是精确岭回归,用全部训练标签拟合一个线性头,靠维护 X^T X 和 X^T Y 做秩一更新来支持精确删除。
接下来是实验结果分析。
精度和速度这对矛盾,在这套设计里由一个旋钮控制,就是保留比例 ρ。ρ 越大,骨架数据越多,基模型 g 越强,码本分辨率越高,精度自然更好;但骨架越大,删除命中 D° 的概率也越高,重建越频繁。公式8 已经很直白地描述了这个取舍。
从结构上看,QSS 在精度上不可能比 D°-only 更差,因为当 α 交叉验证到 0 时它精确退化为 D°-only。这一点在实验里得到验证,QSS 在所有数据集上都持平或超过 D°-only,说明交叉验证出来的 α 确实能稳定地从可删除数据里榨出额外信息,而不会因为引入噪声而反噬。
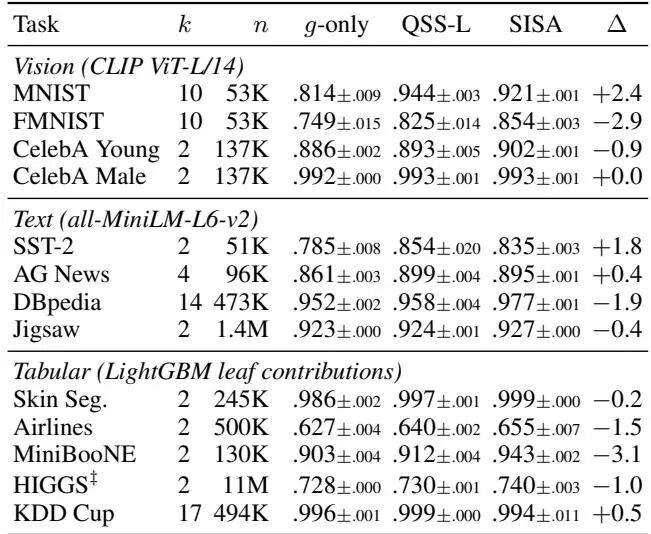
跟 SISA 比就没那么轻松了。论文的结论是 QSS-L 在 13 个低 k 数据集中有 4 个反超 SISA,另外 7 个差距在 2 个百分点以内,剩下 2 个差距更大一些。这个结果说明一件事:QSS 的定位不是"精度吊打 SISA",而是"用很小的精度代价换取数量级的删除速度优势"。SISA 用 S=5 的分片保留了较强的单模型能力,而 QSS 的骨架只用了 0.5% 的数据,能咬住 2 个百分点以内已经相当不容易。
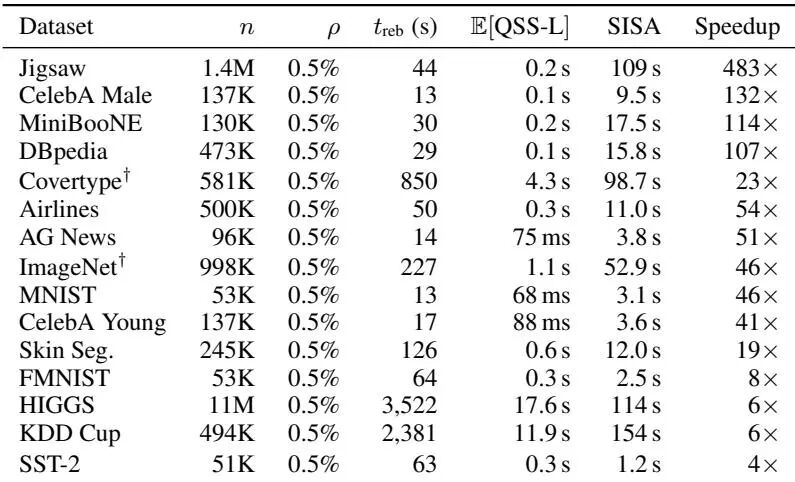
速度侧的优势来源很清晰。快路径的开销只跟 ℓ、b、k 有关,与数据集规模完全解耦;SISA 每次删除的重训成本 O(n/S)却是实打实跟着 n 走的。数据量越大,这个差距被拉得越开。论文报告在低类别数任务上,期望删除延迟比 SISA 低 4 到 483 倍,其中 483 倍这个上限数字出现在 HIGGS 这类 n 很大、k 很小的场景。
这里需要提醒一句:483 倍并不是普遍数字,它依赖"低类别数 + 紧凑骨架有效"这两个前提,论文自己也是这么表述的。高 k 任务上差距会明显收窄,下一节会专门讲。
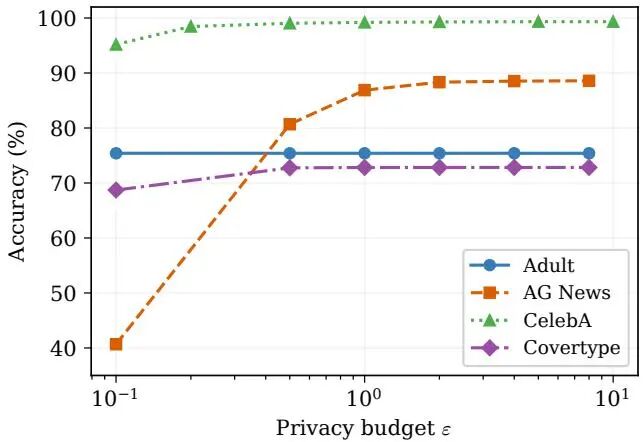
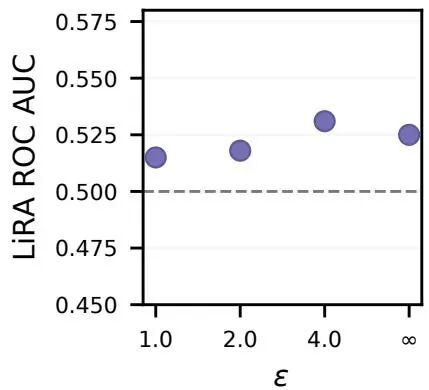
另一个值得关注的点是隐私侧。QSS-DP 加噪以后,二分类的 Adult 数据集几乎不受影响,7 类的 Covertype 和 4 类的 AG News 也只是平滑退化。论文还用了 LiRA(Likelihood Ratio Attack,似然比攻击)做成员推断测试,结果显示即使不加任何差分隐私噪声(ε=∞),攻击的 AUC 也只有约 0.52,接近随机猜测。这说明 QSS 在结构上本身就不怎么泄露成员信息,原因也不难理解——它压根不保存原始样本,只保存聚合后的计数和求和。
下面看具体实验结果。
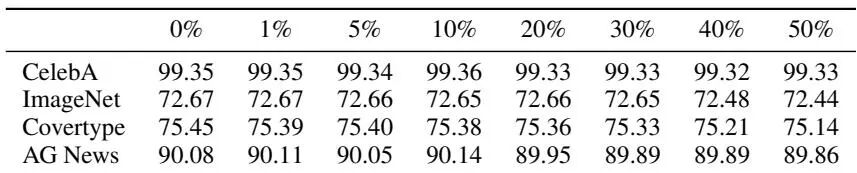
随机删除下精度保持
表7:随机删除下的精度保持情况。在任意删除比例下,遗忘更新与从头重训产出的预测逐比特一致,这是命题 1 在实验上的直接验证。
低k数据集精度对比
表4:ρ=0.5% 时低 k 数据集上的精度表现(5 次随机划分的均值±标准差,部分任务为 2-3 个种子)。g-only 表示只用 D° 训练基模型的下限;QSS-L 每条特征流水线固定一种标签删除构造,不使用测试精度来选模式;SISA 采用 S=5 分片重训;Δ 为 QSS-L 减去 SISA 的百分点差。可以看到 MNIST(−2.9)、SST-2(+1.8)、AG News(+0.4)、DBpedia(−1.9)、MiniBooNE(−3.1)等任务的差距分布,高 k 与 QSS-E 的结果在附录表11中。
期望遗忘延迟对比
表6:ρ=0.5% 时的期望遗忘延迟。QSS-L 的期望值为 (1−ρ)·t_RQ + ρ·t_rebuild,SISA(S=5)则是重训一个分片。t_rebuild 包含重训 g、重新抽取嵌入(LightGBM 为叶子贡献)、重新拟合 LDA 与码本、重新编码全部 n 个点以及重新累积,每部分耗时在附录表10中。表格中标注 † 的是高 k 任务的局限所在。HIGGS(n=11M)这一行给出的期望成本约为 18 秒,对应 SISA 的 114 秒。
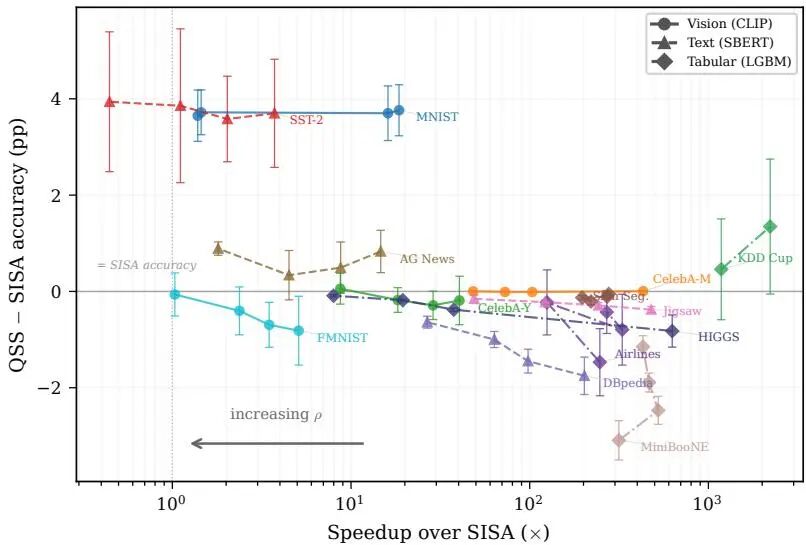
精度-速度帕累托曲线
图3:QSS-L 在 13 个低 k 数据集上的精度-速度帕累托曲线,ρ 从 0.5% 变化到 5%。两个坐标轴都相对于 SISA 归一化(x=1,y=0)。每条轨迹对应一个数据集,向左侧移动意味着 ρ 增大,速度优势减小、精度提高。大多数轨迹聚集在盈亏平衡线附近,用适度精度换取大幅加速。包含全部 15 个数据集的完整版本见附录图8。
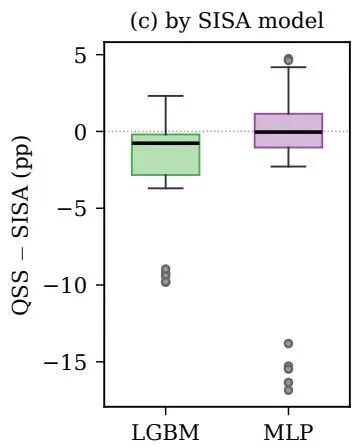
15个数据集聚合视图
图7:全部 15 个数据集的聚合视图(ρ=0.5%,按种子统计)。子图 (a) 按标签类别数 k 展示 QSS-L 与 SISA 的精度差距:二分类和低 k 任务紧贴零点,高 k 的 ImageNet 是明显的离群点。子图 (b) 按领域拆分,三种模态表现相近。子图 (c) 按 SISA 的基线模型类型拆分(LightGBM、MLP),说明无论基线架构如何,QSS 都具备竞争力。
差分隐私下的精度
图10:ε-标签差分隐私下的精度表现。二分类的 Adult 数据集对噪声不敏感;7 类的 Covertype 和 4 类的 AG News 呈平滑退化,在 ε ≥ 1 时仍能保留大部分精度。
成员推断攻击结果
图4(b):CelebA 数据集上的 LiRA 成员推断攻击结果。在所有 ε 取值下 AUC 都约为 0.52,包括 ε=∞ 的无噪声情况。实验使用 64 个影子模型和 1000 个审计点,说明即使不加差分隐私,QSS 也没有泄露可被检测到的成员信息。

高k任务的挑战与未来展望

论文没有回避自己的短板。在全部实验里,ImageNet(k=1000)是那个明显的离群点,QSS-L 与 SISA 的精度差距在高 k 任务上被显著拉开。
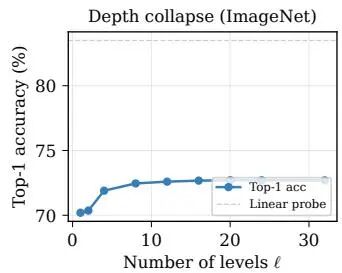
原因在论文的理论分析里有迹可循。命题 5 给出了残差方差的衰减规律:在残差量化级联中,经过 m 层后的残差方差等于原始残差方差乘以各层解释率之积。如果每一层的解释率 η 都不低于某个正数 γ,那么均方误差以 (1-γ)^ℓ 的速度衰减。这在理论上很漂亮,但现实中会出现"深度塌缩"——残差范数几何式收缩以后,更深的层级带来的只是估计噪声,而不是逼近误差的下降,于是层数堆多了也没用。
ImageNet上的码本塌缩
图9:ImageNet 上的码本塌缩现象(无监督残差量化)。左图为宽度塌缩:精度和 η₀ 都随码本宽度 b 增长。右图为深度塌缩:随着层数增加,η_ℓ 趋近于 0,精度随之进入平台期。附录 A.3 给出了解释这一收敛行为的方差衰减分析。
论文由此给出一条非常实用的经验法则:宽度优先于深度。宁可把每层的质心数 b 加大,也不要盲目加深层数 ℓ。从消融实验看,Covertype 从 ℓ=1 加到 ℓ=8 大约能拿到 2 个百分点的收益,其他数据集基本在 ℓ=2 到 4 就饱和了,这和深度塌缩的预测一致。
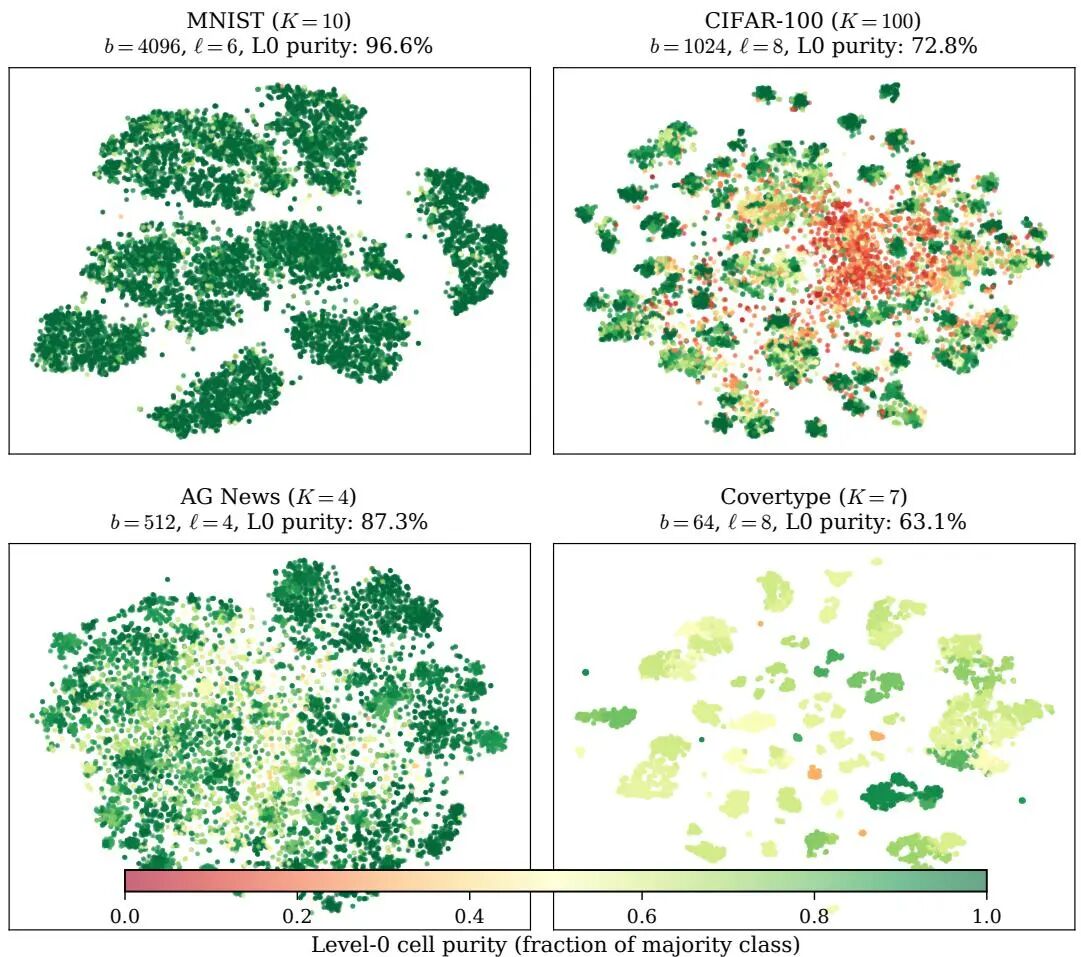
那高 k 任务为什么难?论文用一张嵌入空间的可视化给出了直觉:QSS 的精度上限取决于码本单元的分类纯度。
UMAP嵌入纯度可视化
图20:测试集嵌入的 UMAP 投影,按第 0 层单元纯度着色(每个单元中占多数类的样本比例)。深色区域代表纯度高(大于 90%)的单元,浅色代表混杂单元。MNIST 的平均纯度达到 96.6%,对应的 QSS-L 与 SISA 差距最小(+3.8 个百分点);Covertype 纯度只有 63.1%,在低 k 任务里差距最大(−10.7 个百分点)。类别数越多,单元越难保持纯净,这也是高 k 任务吃亏的根本原因。
展望层面,论文提到几个可以继续走的方向。一是增大 ρ 可以收窄高 k 任务的差距,代价是重建概率上升,公式8 的取舍需要重新权衡;二是分析型充分统计量更新(如精确岭回归的秩一更新)与 QSS 的量化残差统计是可以组合的,前者适合精度足够的低维线性头,

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?Meta提出量化充分统计量QSS,把模型拆成冻结骨架与可加内容,删除退化为算术减法,标签删除与重训比特级一致;低类别数任务上期望删除延迟比SISA低483倍。
这篇工作最值得看的点是什么?QSS-L在13个低k数据集中的4个超过SISA,7个差距≤2pp;期望删除延迟降低4-483倍。在Jigsaw上加速483倍,CelebA Male上132倍。QSS-E量化了精确实例删除的额外精度代价(中位数5.27pp)。删除100个点后预测与重建逐位相同。LiRA攻击AUC≈0.52,无成员泄露。
这篇工作的边界或风险在哪里?优点:首次将残差量化与充分统计量结合实现精确删除,删除复杂度与n无关;冗余schema机制将重建概率指数级降低且零精度损失;理论分析完整(方差衰减、DP保证、重建调度竞争比);实验覆盖15个数据集三种模态。缺点:高k任务上精度明显落后SISA(ImageNet -15.6pp);码本对嵌入空间的无监督划分在类边界复杂时效果差;重建成本随n增长,大数据集上加速比受限;QSS-E精度代价较大。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

将模型拆分为冻结的schema(基模型+RQ码本)与可变的sum-decomposable内容(量化区域上的加性统计量),使普通删除退化为常数时间算术减法,并通过p个独立冗余schema将同步重建概率降至ρ^p。

实验合理度:★★★★☆

分类准确率、回归Pearson r、期望删除延迟、加速比、LiRA AUC、TPR@FPR。

学术研究价值:★★★★☆

将模型拆分为冻结的schema(基模型+RQ码本)与可变的sum-decomposable内容(量化区域上的加性统计量),使普通删除退化为常数时间算术减法,并通过p个独立冗余schema将同步重建概率。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

训练成本为t_g(n°)+O(nℓbd);预测成本为t_g+O(ℓbd);普通删除为O(ℓ²b²k),与n无关;期望删除成本为(1-n°/n)O(ℓ²b²k)+(n°/n)t_rebuild。累加器存储≤51MB(ImageNet)。

复现难度:★★★☆☆

现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:高k任务上精度明显落后SISA(ImageNet -15.6pp);码本对嵌入空间的无监督划分在类边界复杂时效果差;


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球