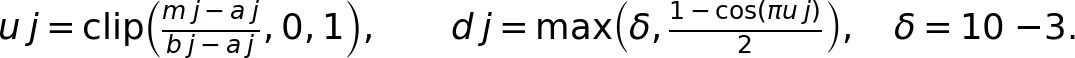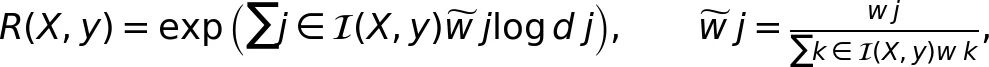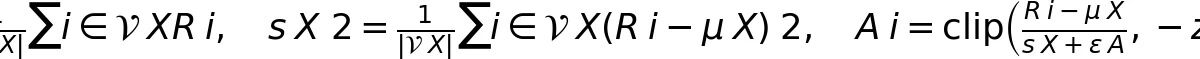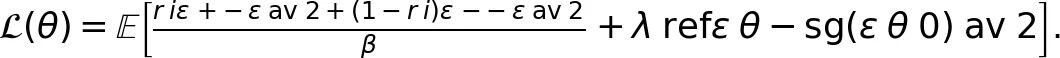
← 返回 PaperDaily 大模型与智能体

复旦大学MORAD:六维奖励让RNA逆设计GDT-TS涨16.0%

RNA逆设计是先定三维结构,再找能折叠成该结构的序列。

复旦大学MORAD:六维奖励让RNA逆设计GDT-TS涨16.0%
原论文信息如下:
论文标题:
MORAD: REINFORCEMENT LEARNING WITH MULTI-OBJECTIVE REWARDS FOR RNA INVERSE DESIGN
发表日期:
2026年10月
发表单位:
Fudan University
原文链接:
https://arxiv.org/pdf/2610.13305v1.pdf

paperdaily_reaction_gif

RNA逆设计新突破:一个模型搞定所有骨架
RNA逆设计是先定三维结构,再找能折叠成该结构的序列。
难点在于同一骨架可对应多序列,且评价标准多样。模型需采样条件分布,评估需考虑结构贴合度、碱基配对、热力学稳定性等。
现有模型如gRNAde、RDesign等提供初始分布,但缺乏生成结果改进模型的步骤。
复旦的MORAD通过在线强化学习在不同目标骨架上训练共享策略,而非单独训练。
MORAD结合骨架条件分组采样、奖励归一化和扩散目标。
实验显示,MORAD在三级结构精度、二级结构配对、热力学质量上超越RiboDiffusion、gRNAde和RDesign。
奖励使用RNAfold打分,评估用EternaFold,提升非“自己考自己”。
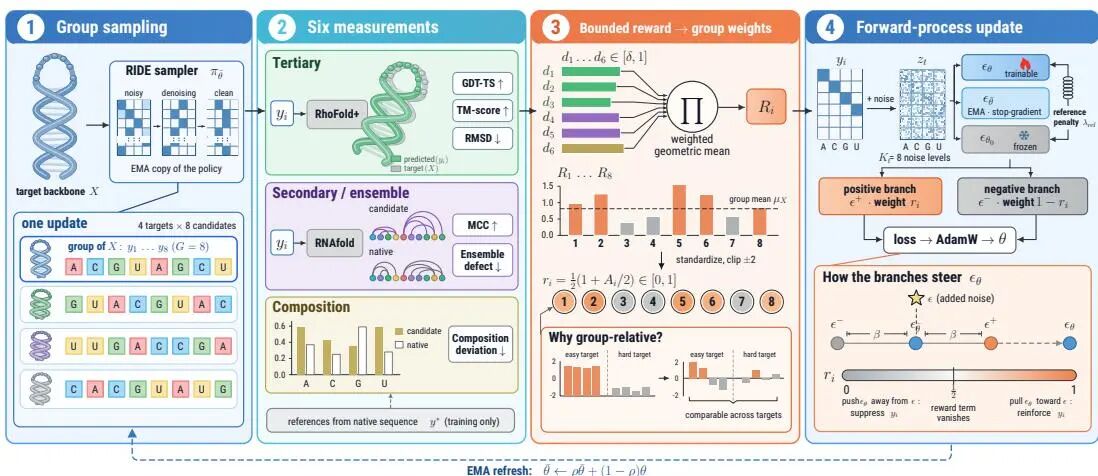
MORAD训练循环
图1:MORAD训练循环。骨架条件采样产生候选序列;三条评估通道给出六维奖励和组相对权重;前向加噪的候选在冻结参考约束下训练共享策略;EMA反馈用于刷新采样器。更新遵循公式(3)中的正向/负向目标,下方反馈路径表示EMA刷新。

MORAD核心揭秘:六维奖励如何协同优化RNA设计

术语:GDT-TS衡量结构对齐,TM-score对拓扑敏感,RMSD衡量原子偏离,MCC衡量配对一致度,NED衡量系综下未配对比例。
MORAD奖励分三级几何、二级结构、系综行为和序列组成。
六个数通过满意度分数映射成标量奖励,避免量纲不统一。
升余弦满意度映射公式
公式(4):满意度映射。mj 是指标原始值,aj 与 bj 是低/高满意度锚点,uj 是裁剪到 [0,1] 的归一化量,dj 是最终满意度分数。对于越低越好的指标(如RMSD、NED),令 bj < aj 即可。δ 取 10-3,是地板值,防止后面取对数时出现负无穷。升余弦的好处是两端饱和:指标极端好或极端差时,奖励变化趋缓,避免个别异常值主导梯度。
六个满意度分数通过加权几何平均合成总奖励。
加权几何平均奖励公式
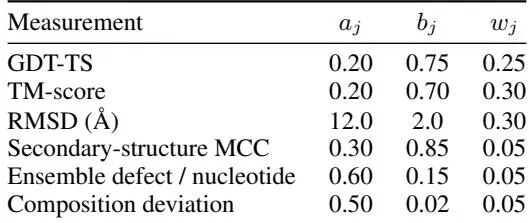
公式(5):标量奖励。dj 是第 j 项的满意度,wj 是原始权重,归一化后的权重 w̃j 为该项权重的占比,𝓘 是当前可用测量的集合。GDT-TS、TM-score、RMSD、MCC、集合缺陷、组成偏差的权重分别是 (0.25, 0.30, 0.30, 0.05, 0.05, 0.05)。三个结构项是必填的,辅助项缺失时会从集合里剔除并重新归一化权重。
几何平均对得分最低项最敏感,避免高分项掩盖问题。
RIDER与MORAD奖励构造对比
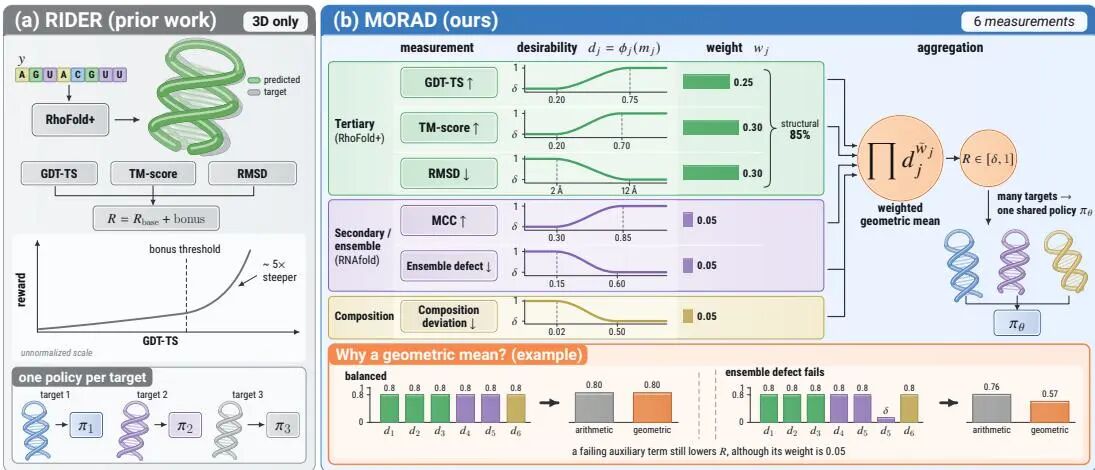
图2:RIDER与MORAD的奖励构造对比。RIDER只对三级结构一致性打分;MORAD综合了三个三级结构测量、配对一致性、归一化集合缺陷(ED)和组成偏差。每个满意度分数落在 [δ,1] 区间,φj 表示公式(4)的映射,w̃j 是公式(5)中的归一化权重。左右两栏直观对比了两种奖励定义。
对照组设计聪明,现有奖励只看三级结构,RIDER加阈值奖励。
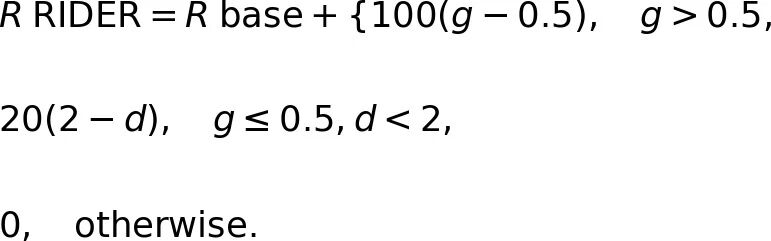
RIDER奖励公式
补充公式:RIDER的奖励定义。g 表示结构分数,d 表示某种距离度量,Rbase 是基础奖励。当结构分数超过 0.5 时给 100(g−0.5) 的加成,低于 0.5 但距离小于 2 时给 20(2−d) 的加成,其余情况不加成。这是一种分段、带阈值的奖励形态,和 MORAD 的连续满意度映射走的是两条路。
六维奖励参数表
表5:六分量奖励参数表。锚点 aj、bj 分别标识低满意度与高满意度位置,公式(4)使用 10-3 作为地板值。三个结构测量必须有限;可用的辅助项决定实际激活的权重。
三级结构项占85%权重,辅助项虽小但改变排序。

前向过程扩散RL:让扩散模型学会在线进化

奖励设计好后,需转化为扩散模型更新方向。传统RL假设模型逐步决策,扩散模型多步去噪,奖励仅在最后一步获得。
MORAD用奖励加权去噪目标更新,借鉴DiffusionNFT。训练循环有三套参数:可训练策略θ、滑动平均采样策略θ̄、冻结参考θ0。
采样和打分:对每个目标骨架X,用θ̄采出G个候选序列,打分器返回有效奖励。组相对只看序列在同骨架兄弟中排名。
组相对奖励归一化公式
公式(1):目标相对反馈。μX 是目标 X 下有效候选的奖励均值,sX2 是总体方差,Ai 是第 i 条候选的优势值,被裁剪到 [−zc, zc],zc=2,εA=10-8 用来防止除零。候选权重 ri = ½(1 + Ai/zc),落在 [0,1] 之间。这套做法的好处是把不同骨架的难度差异消掉了:一个本来就好设计的骨架,不至于因为绝对分数高就一直被强化。
组内有效奖励少于两个或不同序列少于两条的组,会重采样并提高采样温度;若仍不行,直接丢弃。奖励、组统计量和ri在优化中不参与梯度回传。
构造正负分支:序列做one-hot编码x0,加噪后以采样策略预测为中心,向可训练策略正负两侧分开。
正负去噪分支公式
公式(2):正负分支。εθ、εθ̄、εθ0 分别是在 (zt, t, X) 处可训练策略、采样策略、冻结参考的噪声预测。ε+ 是正向分支,ε− 是负向分支,β ∈ (0,1] 控制两个分支相对采样策略的偏移幅度。论文对 εθ̄ 施加了停止梯度。原文里 DiffusionNFT 是用流匹配的速度预测写的,MORAD 把它的正负构造搬到了 RIDE 的 ε 预测空间里。
损失函数:正负分支按候选权重加权,再叠加参考约束项。
MORAD优化目标公式
公式(3):MORAD优化目标。ri 是候选权重,ε 是真实噪声,‖·‖av2 表示在序列位置和通道上平均的平方残差,λref 是参考项系数,sg(·) 是停止梯度。期望覆盖有效候选、目标、采样噪声和时间层级。参考项惩罚对预训练去噪器的改动,正负分支则把相对奖励转成更新方向。论文指出,由于 1/β 因子的存在,携带奖励信息的交叉项不依赖 β,所以 β 只缩放二次偏移惩罚。实际取 β=0.1,λref=0.02。
优化器是AdamW。更新后采样策略做滑动平均,冻结参考不动。流程只需条件采样器、噪声预测适配器、标量评估器。
数据方面,每条记录存骨架、天然序列及坐标有效性掩码。训练集527个目标,评估集153个,评估集独立构建,长度覆盖15到186个核苷酸。
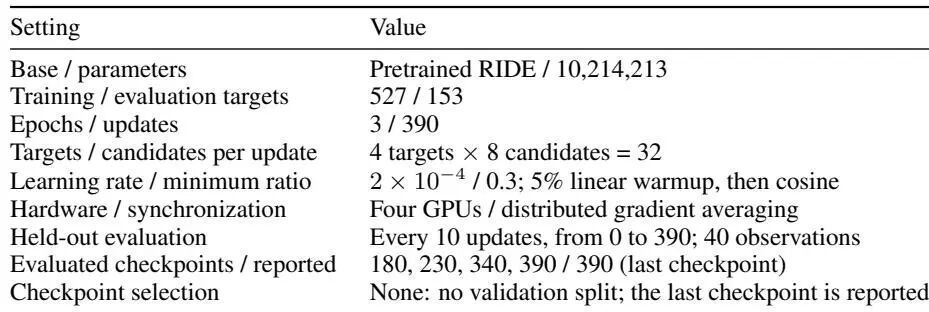
实验运行设置表
表6:本次报告的运行设置。包括模型规模、更新步数、硬件配置、学习率调度等关键超参数。

实验全面碾压:三级结构、二级结构、热力学三线告捷

实验设置公道,基线选用代表性方法,候选索引固定,不挑优。
训练从预训练RIDE出发,390次更新,报告模型为最终检查点。
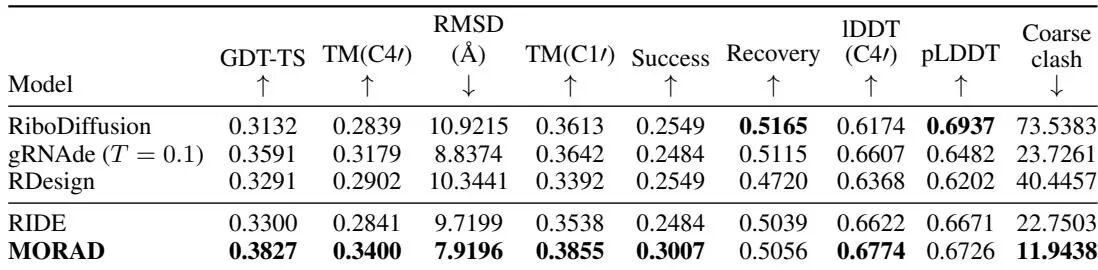
MORAD在16个指标中赢得14个最佳均值,结构和热力学表现突出。
三级结构:GDT-TS提升16.0%,TM-score提升19.7%,RMSD降至7.9196 Å。
三级结构评估表
表1:三级结构评估。153个评估目标各自取第一个采样候选(candidate 0);C1 TM 有126个有效目标。MORAD 是第390次更新的检查点。对齐分数和附加诊断一起展示,RMSD 单位为埃(Å)。粗体表示最佳均值,指标定义见附录 D.2。
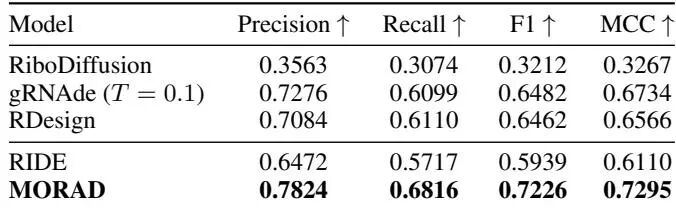
二级结构:配对MCC提升19.4%,跨工具测评。
二级结构一致性表
表2:candidate-0 的二级结构一致性。EternaFold 的预测结果与从天然三维结构中提取的碱基对进行比较。粗体表示最佳均值。各指标和模型的有效计数见附录 D.1.1,热力学缺陷单独在表3中报告。
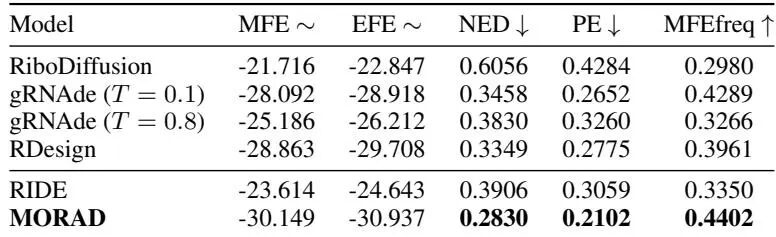
热力学:NED降幅27.5%,系综更集中。
热力学评估表
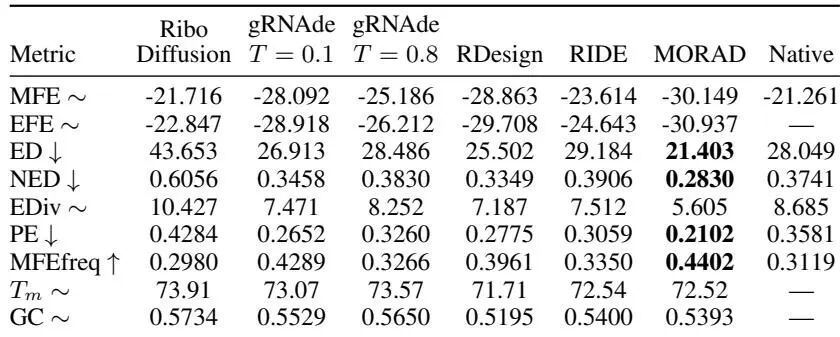
表3:153个目标上的热力学评估。MFE 是自由能最小值,EFE 是系综自由能(单位 kcal/mol);NED 是归一化集合缺陷;PE 是位置熵;MFEfreq 是最低能量结构的概率。MORAD 为第390次更新。粗体表示最佳均值,带波浪号标记的是没有偏好方向、仅作参考展示的指标。附录 D.3 报告了全部九项指标与天然参考值。
自由能稳定但偏离天然序列,未宣传为优势。
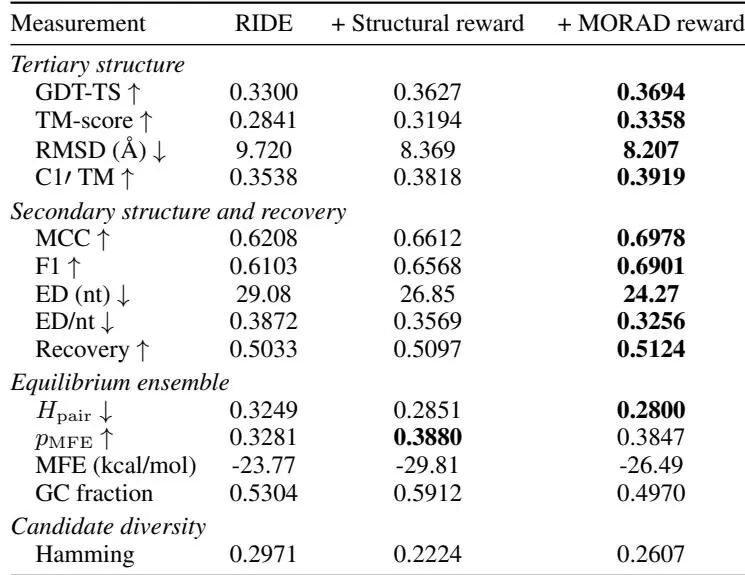
控制变量实验显示六维奖励优于单目标奖励。
奖励对照实验表
表4:相同训练设置下的奖励对比。两个策略从同一个预训练 RIDE 出发,用相同数据、优化器和调度后训练,唯一差异是奖励函数;各自展示最后一次检查点。只打结构的奖励与现有RNA设计强化学习奖励的范围一致。这些结果来自对照实验自己的评估运行,因此部分条目与表1—表3有所不同。粗体表示三项中最佳;MFE、GC 比例和目标内 Hamming 多样性仅作背景展示。
MORAD奖励在11个指标中赢得10个,唯一输掉的是MFE结构频率。
结构单目标策略偏离天然序列组成特征,MORAD奖励保持接近天然。
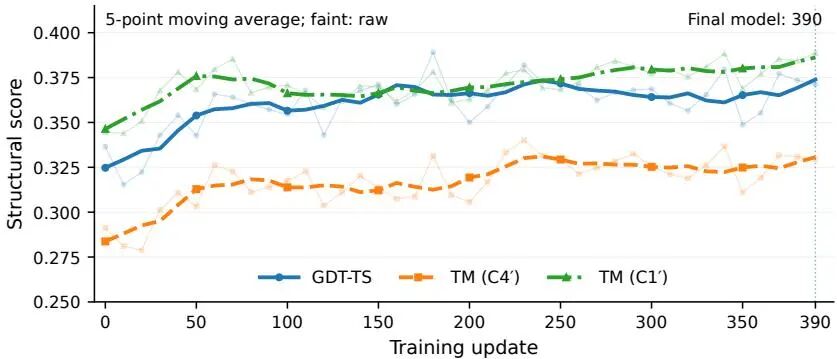
训练过程动态记录,GDT-TS和C4 TM分别提升10.3%和13.2%。
结构分数训练趋势
图3:全部40次评估的结构分数趋势。粗线是中心五点移动平均,浅色曲线是训练中记录的原始留出分数,每个目标采样一个候选。在两端附近,平均值只使用可用的点。表10报告了最后一次检查点(第390次更新)的评估结果。
完整RMSD轨迹
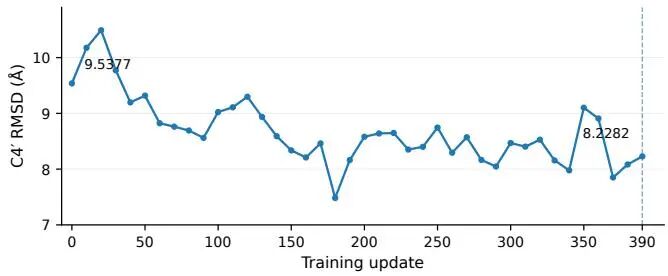
图4:完整的 RMSD 轨迹。40次留出测量的结果按时间顺序连成一条线,RMSD 越低代表对齐后一致性越好,竖直标记指向第390次更新。
检查点对比表
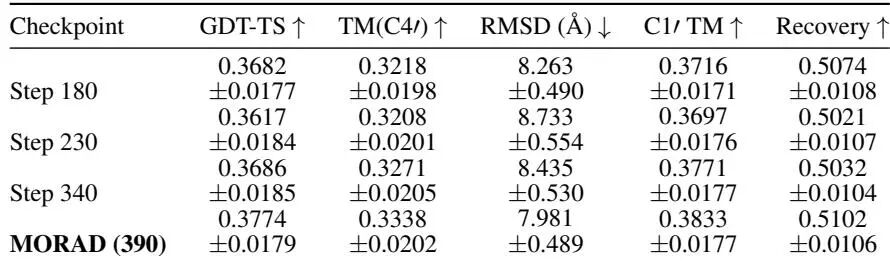
表10:检查点对比。每个目标八个候选的均值及标准误,来自早前一次评估运行的四个检查点;它们与表1、表2中的 candidate-0 结果不同,后者也报告了第390次更新这一最后检查点。
配对指标有效目标计数表
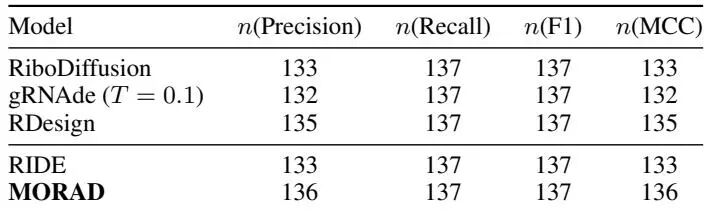
表7:candidate-0 配对指标的有效目标计数。计数直接对应表2;未定义的测量被排除,而不是用零替换。MORAD 为第390次更新。
完整热力学测量表
表9:153个目标上的完整热力学测量。MFE/EFE 单位为 kcal/mol;ED 单位为 nt;NED 无量纲;EDiv 是平均碱基对距离;PE 是位置熵;MFEfreq 是概率;Tm 单位为摄氏度;GC 为比例。MORAD 为第390次更新。粗体表示六个模型在指示方向上的最佳值;Native 是参考,不参与排名。短横线表示未报告的参考值,带波浪号标记的是没有偏好方向、仅作背景展示的指标。

质量与多样性的博弈:MORAD的局限与未来

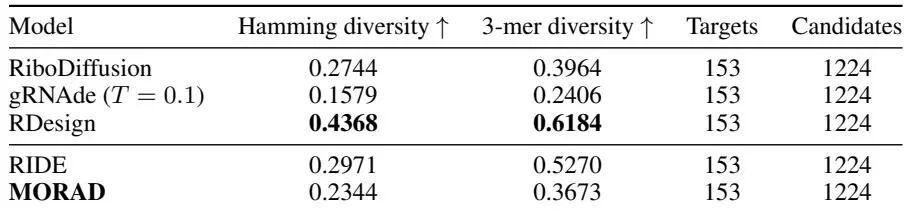
奖励提升代价是多样性下降,候选差异变小。
论文承认质量-多样性权衡,强调多样性高不等于结构精度高。
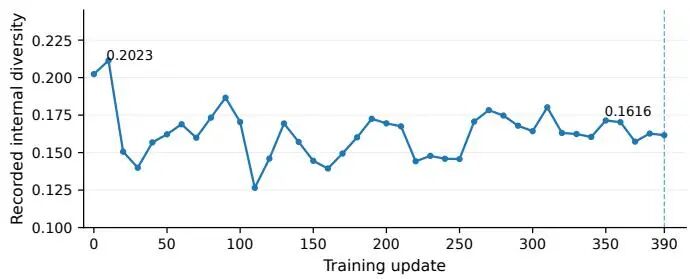
训练中目标内多样性曲线
图5:训练过程中的目标内多样性。多样性从 0.2023 下降到 0.1616,跨模型的八候选对比见表8。
序列多样性对比表
表8:序列多样性对比。每个模型使用153个目标和1224个候选(每目标八个)。粗体表示报告的最高多样性;但更高的多样性本身并不能证明结构精度更高。
论文局限:验证仅在10.2M参数的RIDE主干上,奖励打分和评估用同源工具,结果无湿实验验证。

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?复旦大学提出MORAD,用在线强化学习给RNA扩散模型做后训练:六项奖励协同优化,一个共享策略适配所有目标骨架。GDT-TS从0.3300升至0.3827,配对MCC提升19.4%,集合缺陷降27.5%,三级结构、二级结构、热力学
这篇工作最值得看的点是什么?MORAD在16个有方向偏好的指标中14个取得最优。GDT-TS从RIDE的0.3300提升至0.3827(+16.0%),TM-score从0.2841提升至0.3400(+19.7%),RMSD从9.7199降至7.9196Å,配对MCC从0.6110提升至0.7295(+19.4%),归一化系综缺陷从0.3906降至0.2830(-27.5%)。
这篇工作的边界或风险在哪里?优点:(1)首次实现共享策略的RNA在线RL后训练,一个模型适配所有目标骨架,避免为每个目标单独优化;(2)六分量多目标奖励设计系统性强,几何聚合自然处理异构目标的权衡;(3)前向过程扩散RL更新规则理论推导清晰,正/负分支设计巧妙;(4)实验全面,涵盖三级结构、二级结构、热力学和多样性多维度评估。缺点:(1)仅在10.2M小模型上验证,未展示在更大backbone上的可扩展性;(2)奖励评分和评估均依赖RhoFold+,存在自评估偏差;(3)缺乏实验结构验证;(4)多样性有所下降,质量-多样性权衡未深入探讨。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

MORAD是一个面向骨架条件RNA扩散模型的在线强化学习框架,通过共享策略在多样目标骨架上训练,结合骨架条件分组采样、组相对奖励归一化和前向过程扩散目标,将六个异构测量指标映射为有界满意度分数并通过加权几何平均聚合为标量奖励,实现多目标协同。

实验合理度:★★★★☆

GDT-TS、TM-score、RMSD、C1 TM、Recovery、lDDT、pLDDT、Coarse clash、配对Precision/Recall/F1/MCC、归一化系综缺陷NED、位置熵PE、MFEfreq、MFE、EFE、E。

学术研究价值:★★★★☆

MORAD是一个面向骨架条件RNA扩散模型的在线强化学习框架,通过共享策略在多样目标骨架上训练,结合骨架条件分组采样、组相对奖励归一化和前向过程扩散目标,将六个异构测量指标映射为有界满意度分数并通过加。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

10.2M参数模型,在四块GPU上训练390次更新,每次更新使用4个目标×8个候选=32个样本,每个候选采样8个分层log-SNR噪声水平,共训练3个epoch。

复现难度:★★★☆☆

现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:(1)仅在10.


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球