
加州大学欧文分校自动驾驶世界模型新论文:SafeDriveVLA先预演导航后果再决策
论文标题:SafeDriveVLA:面向冲突感知端到端自动驾驶的“导航条件世界模型预演”方法
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
论文标题:SafeDriveVLA:面向冲突感知端到端自动驾驶的“导航条件世界模型预演”方法
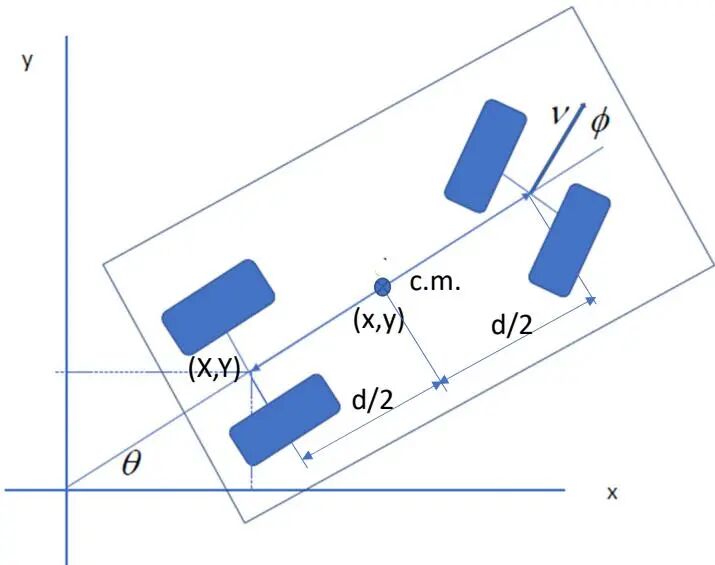
几十年了,类车机器人「最快怎么开」这个问题,一直建立在一个有点心虚的假设上——轮胎永远不打滑。这篇论文把自行车模型的轮胎接触力算进来,发现最优路径的清单上其实还缺三条基元,而且缺的正好是轮胎将滑未滑的那一瞬间。
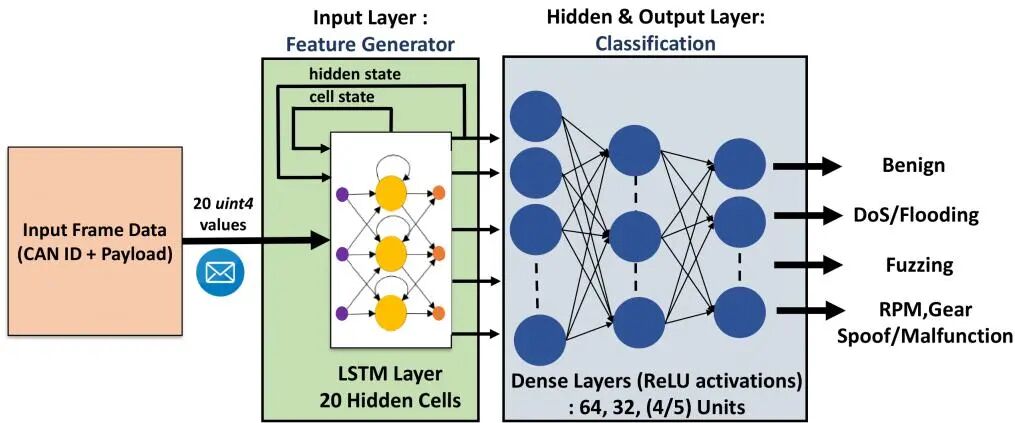
现代汽车内有多个电子控制单元(ECU),通过控制器局域网(CAN)总线通信。刹车、转向等功能都依赖这条总线,但CAN协议缺乏身份认证,任何节点都能发送消息,易受攻击。
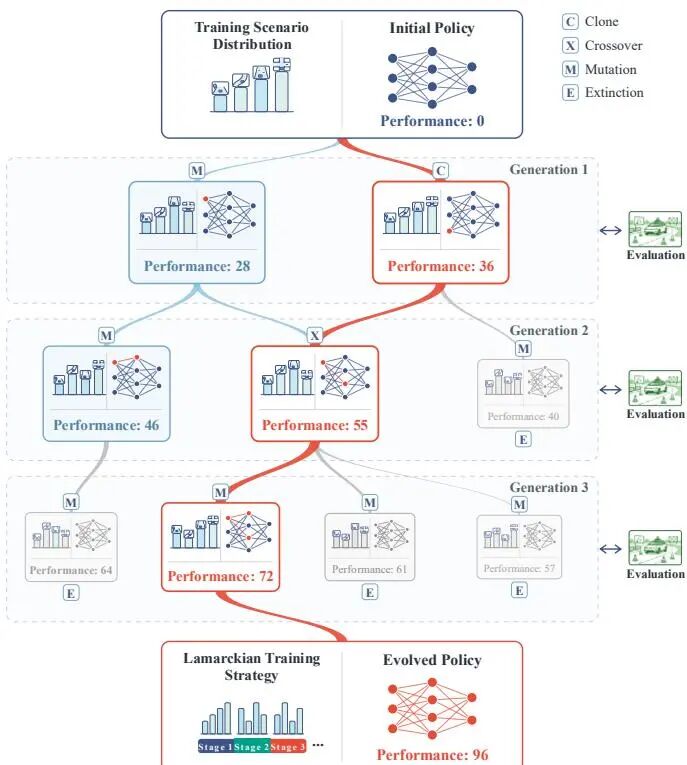
自动驾驶训练里,最容易被当成“背景板”的其实是场景分布。同济大学干脆把它变成会进化的变量:候选场景分布按“训完到底开得好不好”来竞争,优胜路径再蒸馏成一套六阶段轻量课表。完整进化让性能损失比 Replay 降低 25.07%,轻量策略也有 19.13%。
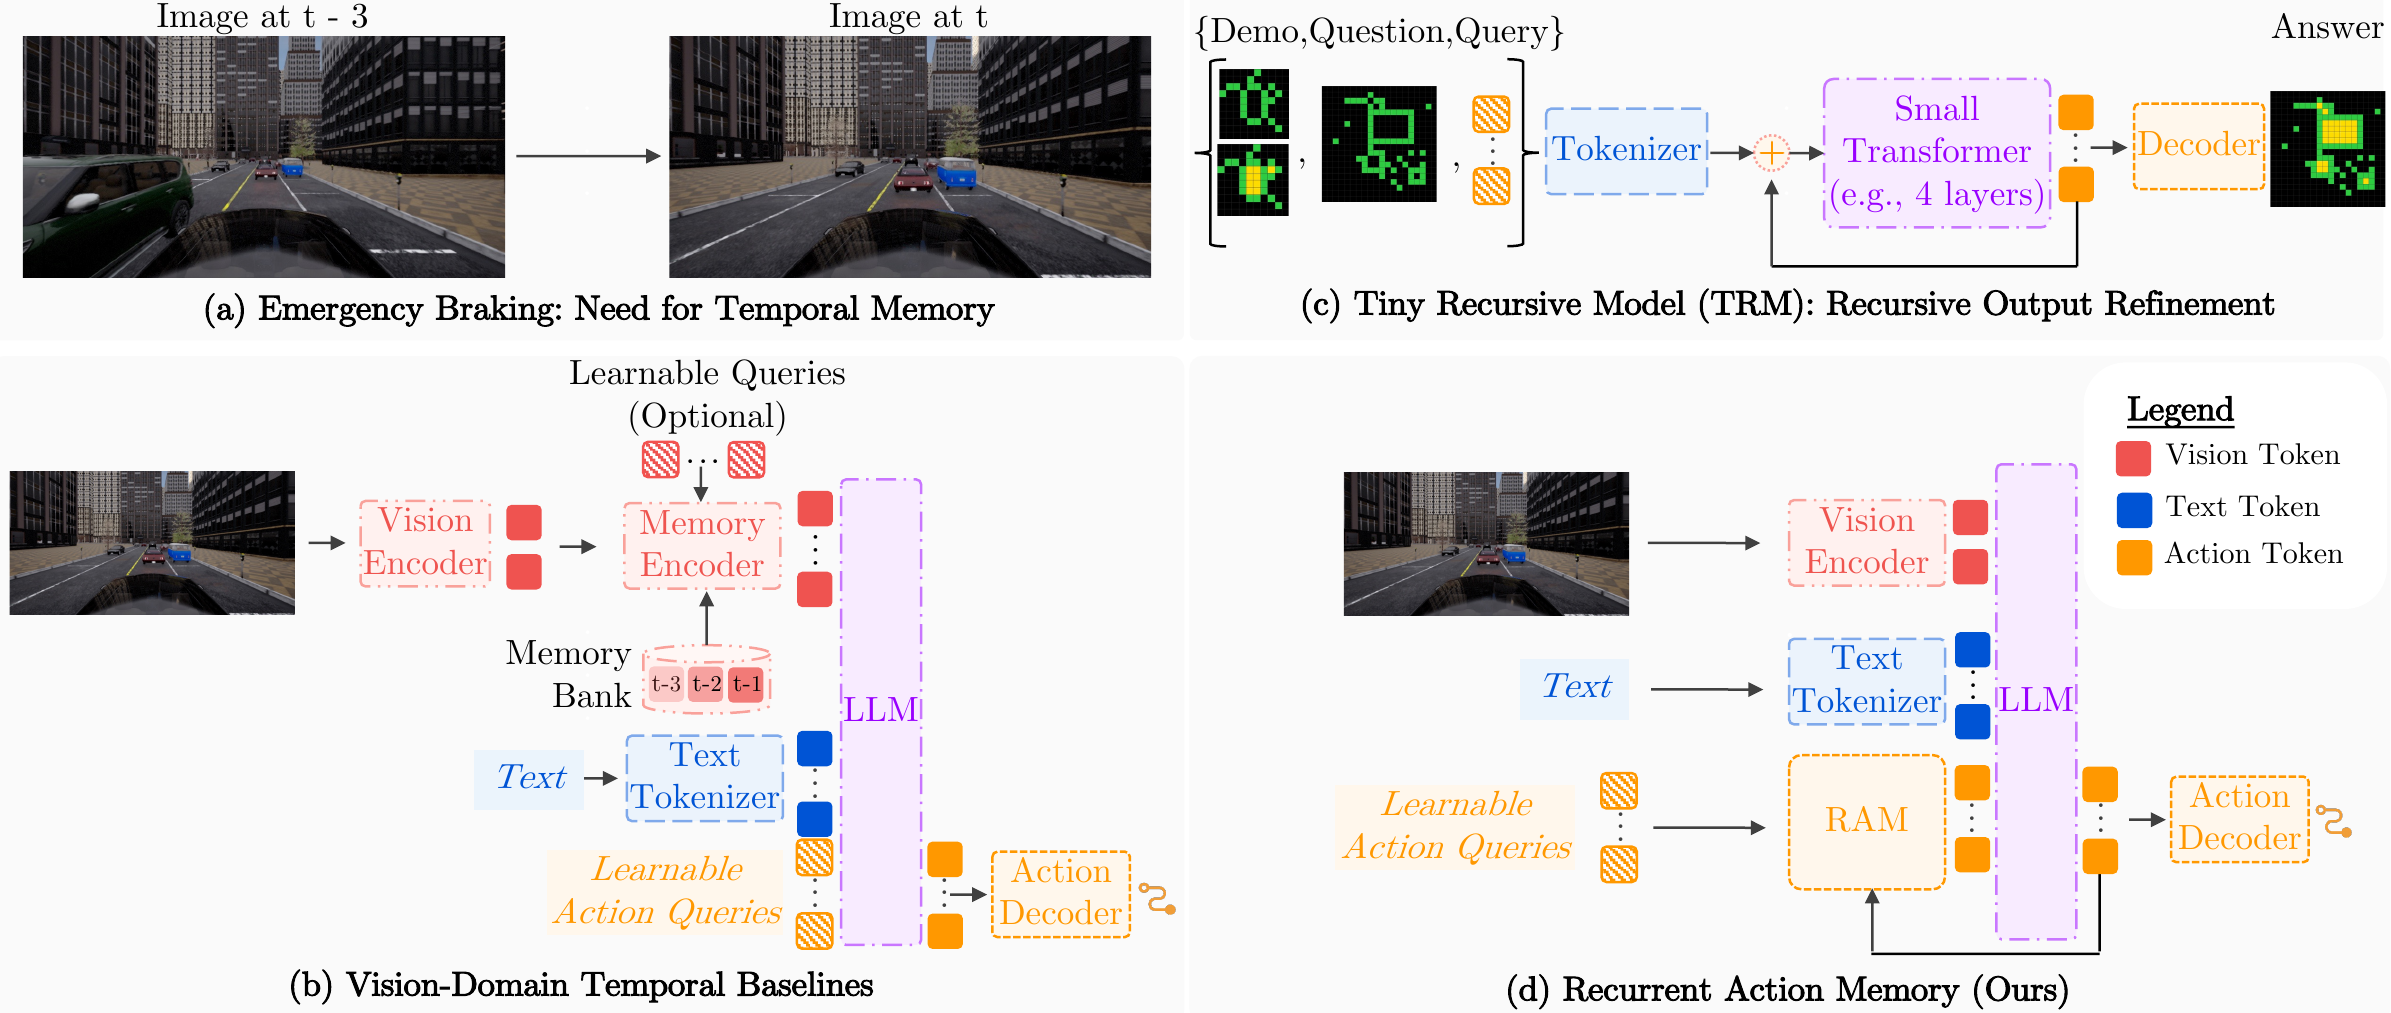
论文基本信息 方法简称: 快速高效自动驾驶视觉语言动作模型(FIVE-VLA) 原文标题: FIVE-VLA: Fast and Effective Autonomous Driving with Recurrent Action Memory 主要署名单位: 博世 合作单位: Five AI Ltd. 首次公开: 2026年9月16日(arXiv v1)

这篇文章切入角度很刁钻:别人都在优化模型算力,它却盯上了摄像头到内存的搬运能耗。用一个带语义感知的存储编码器,在保护行人检测精度的前提下,把前视相机接口能耗砍掉约36%,而且跨29个检测器、12个数据集验证,落地感很强。

联邦学习在车上,梯度在公开网络中传输,易被中间人攻击。论文结合差分隐私和同态加密,用DP参数决定加密哪些梯度,攻击下准确率从10.4%提升至78.2%,开销增加约8-10%。思路清晰,实用性强。

协同驾驶最怕的不是"看不见",而是"看见了却说不清谁看到的"。G-MARK用知识图谱把车辆间的观测证据变成显式可追溯的推理对象,遮挡推理提升42.2%、通信成本压缩25.6倍,是轻量级可落地的协同推理新范式。做自动驾驶、车路协同的朋友值得一读。

自动驾驶这事儿,有个特别拧巴的现象:你看那些端到端大模型,在 benchmark(标准测试基准)上跑分一个比一个高,可一放到真实世界里,偶尔会像个刚拿驾照的新手一样,干出些让人血压飙升的事儿——比如老老实实闯个红灯,或者。

一个统一框架同时接管监控、鱼眼和行车记录仪三类交通视频,在AI City 2026出战三个赛道,FETV与第一名只差0.0007。这套「观察-推理-行动-验证」的智能体工作流拆解起来很有嚼头,适合所有对多模态视频理解与跨域泛化感兴趣的读者。

自动驾驶3D感知,向来是深度、检测、占用各学一套。北航与北邮提出的GeoUP,直接把视觉几何基础模型VGGT改造成统一3D感知骨架,一个模型三大任务全包,在nuScenes、Waymo、Argoverse 2、KITTI、DDAD五大基准拿下SOTA。思路清奇,落地潜力值得关注。

老司机最怕的不是路况差,而是同一个坑栽两次。这篇论文给自动驾驶大模型装上一个"失败记忆库",用结构化解耦检索加上解耦LoRA测试时训练,让模型现学现卖、遇险纠偏,还把NAVSIM双榜SOTA收入囊中,代码已开源。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球