拉马克驾校开课了:让场景分布和驾驶策略一起进化
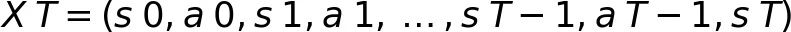
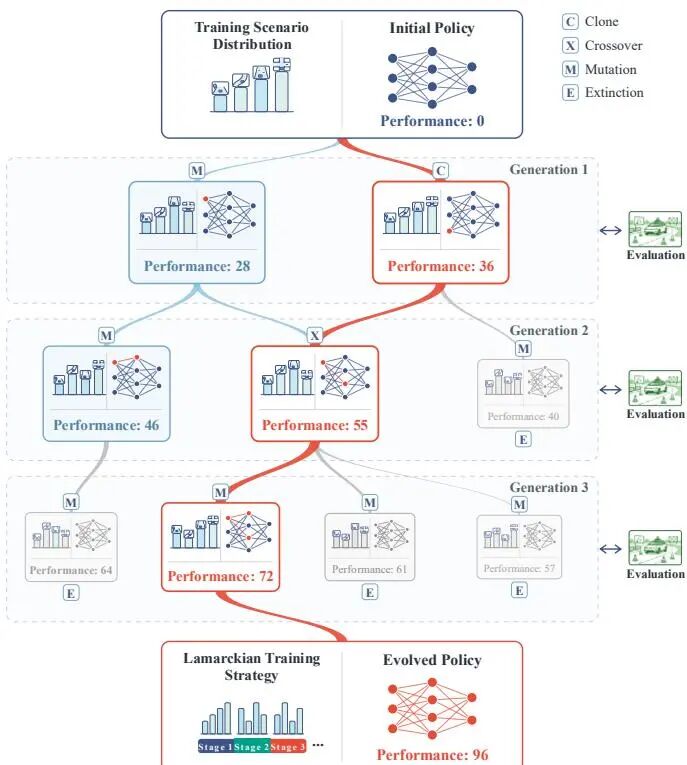
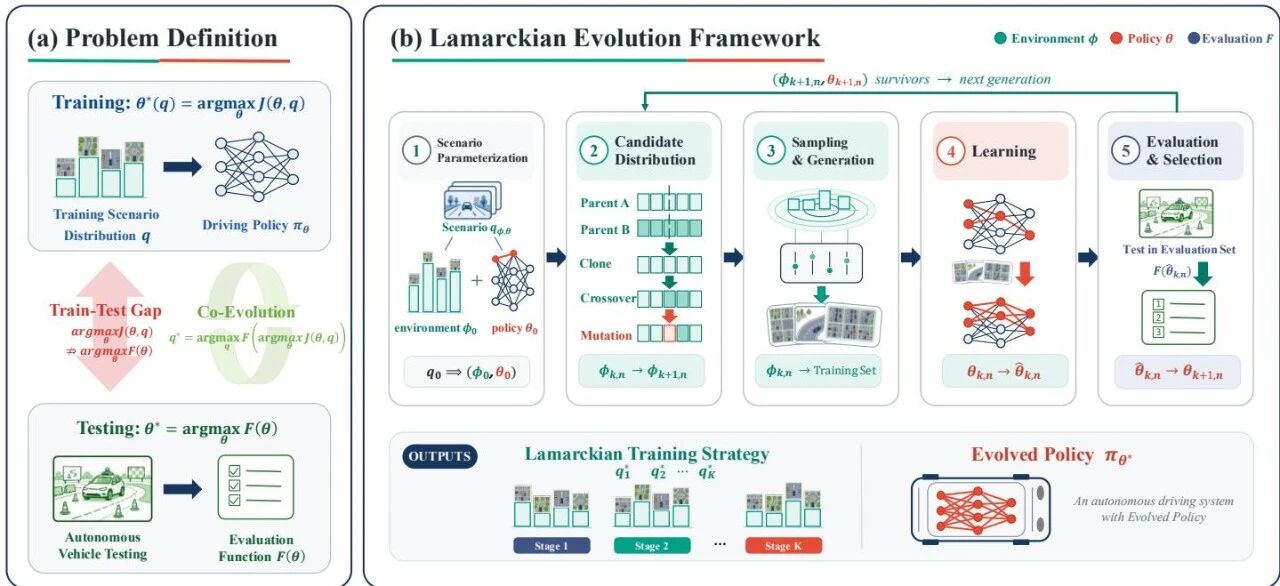
告别代理指标:用训练后性能直接驱动场景分布竞争
代理指标为什么不够用
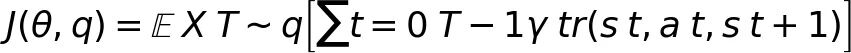
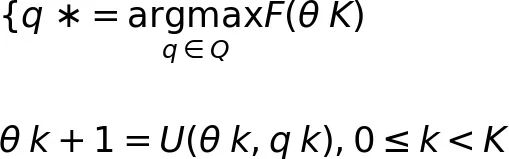
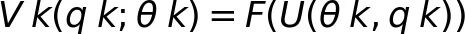
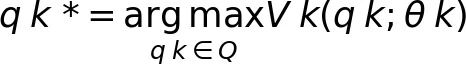
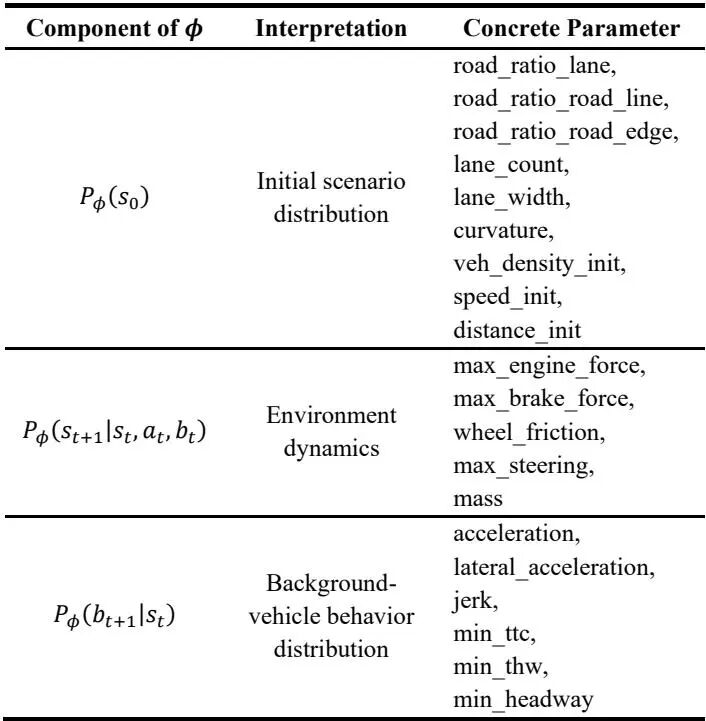
把抽象分布变成可搜索的参数
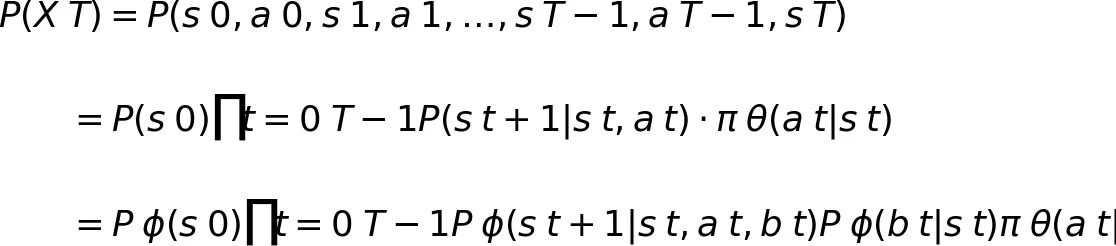
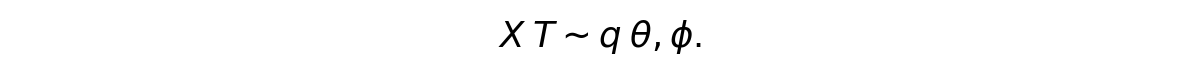
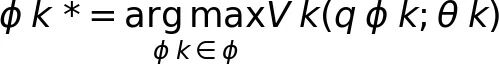
五步走完一轮拉马克进化
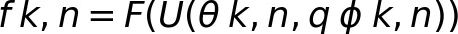
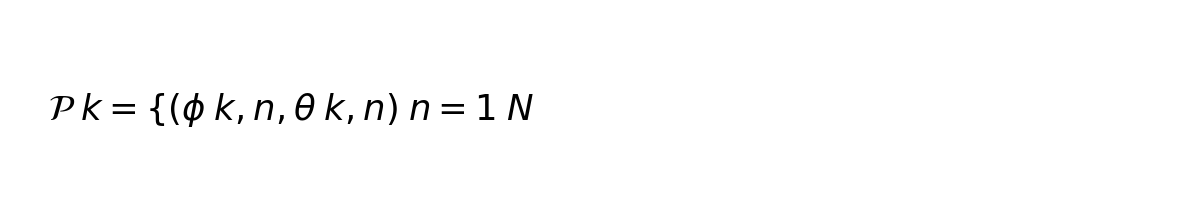
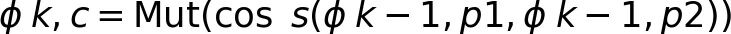
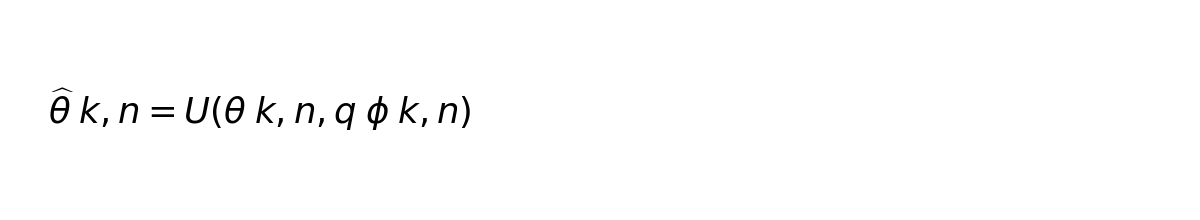
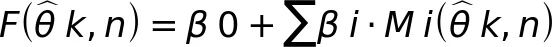
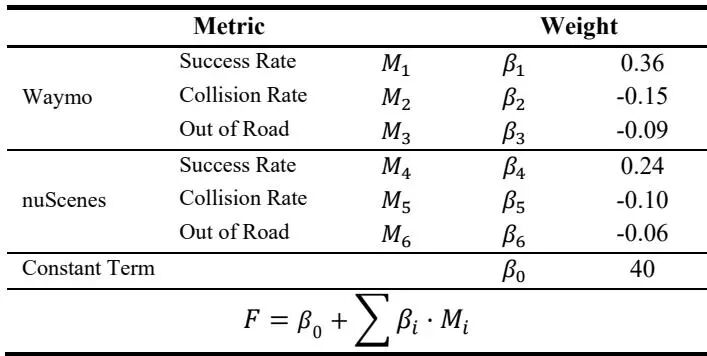
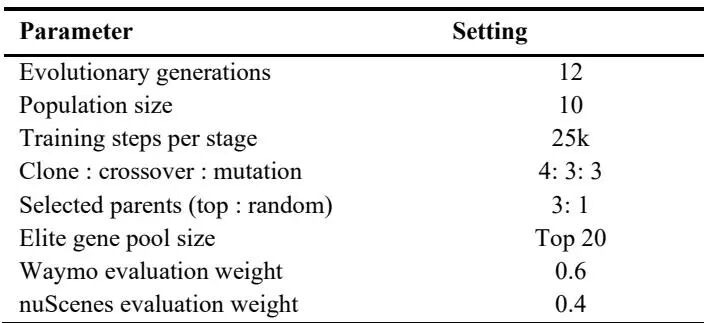
场景池怎么搭、基因锁怎么锁
六阶段挑战轮换:进化实验揭示的能力积累规律
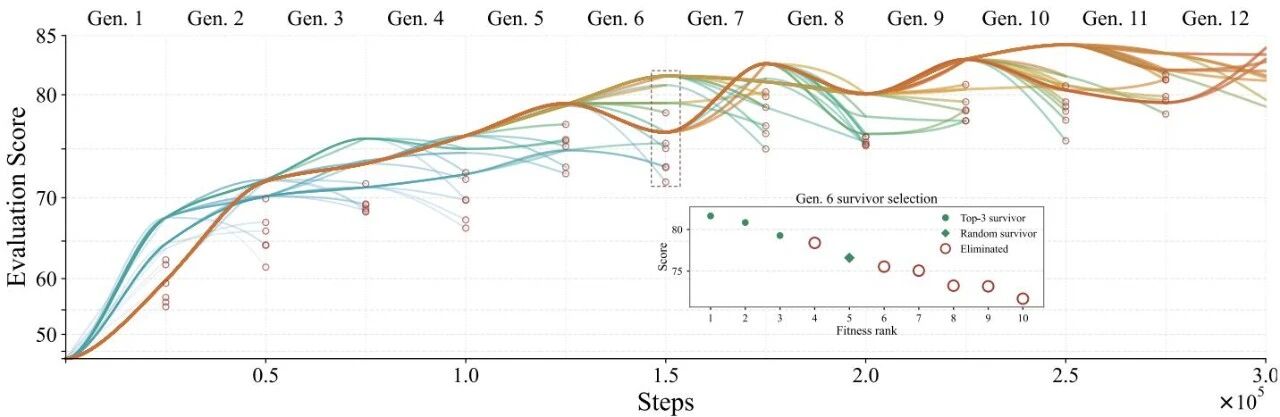
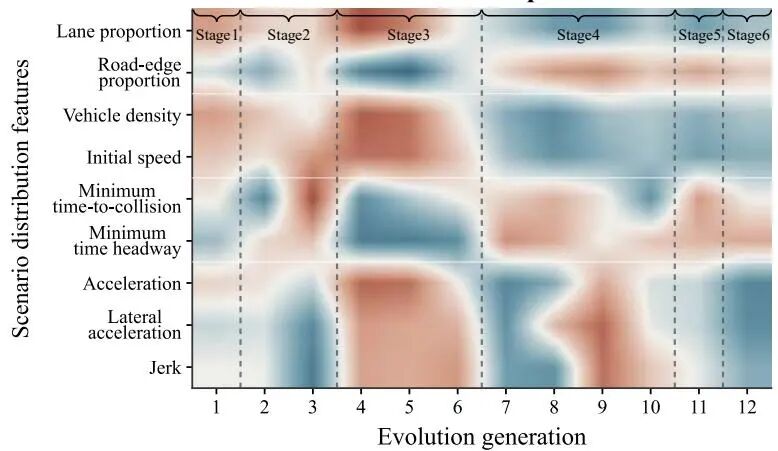
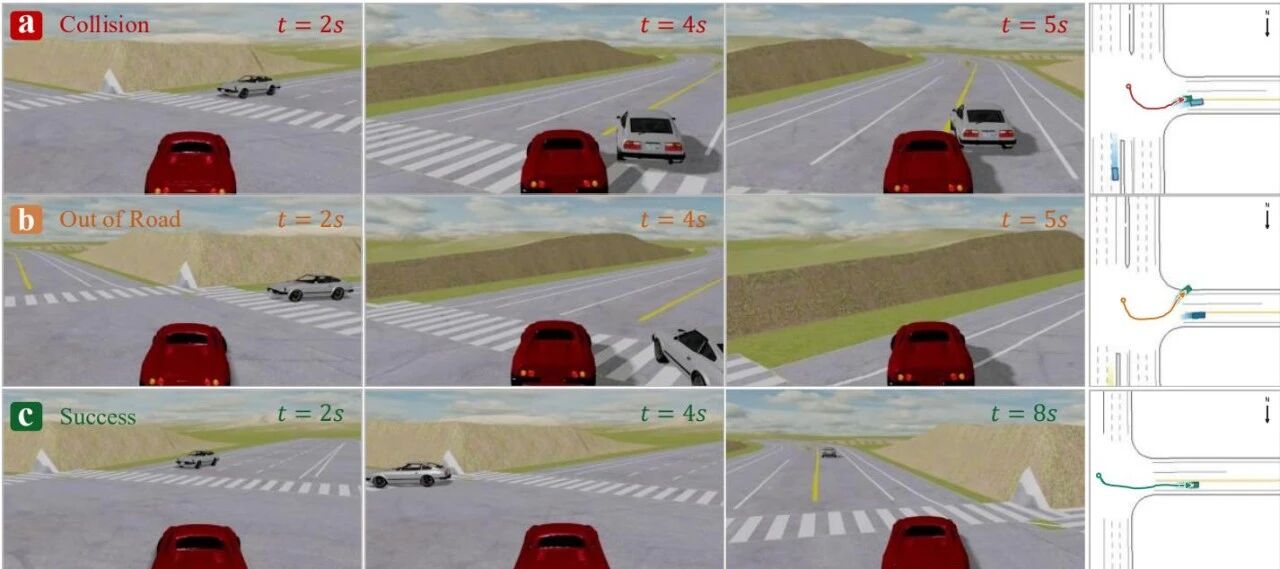
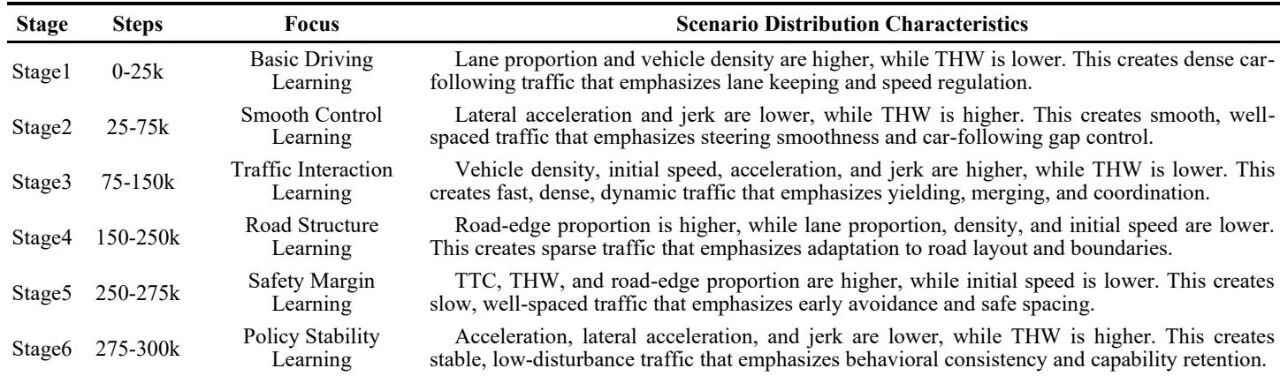
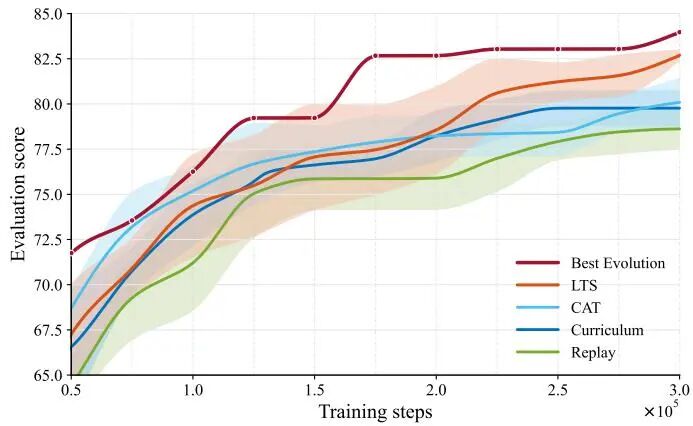
从3M步到300k步:轻量级拉马克训练策略的蒸馏与验证
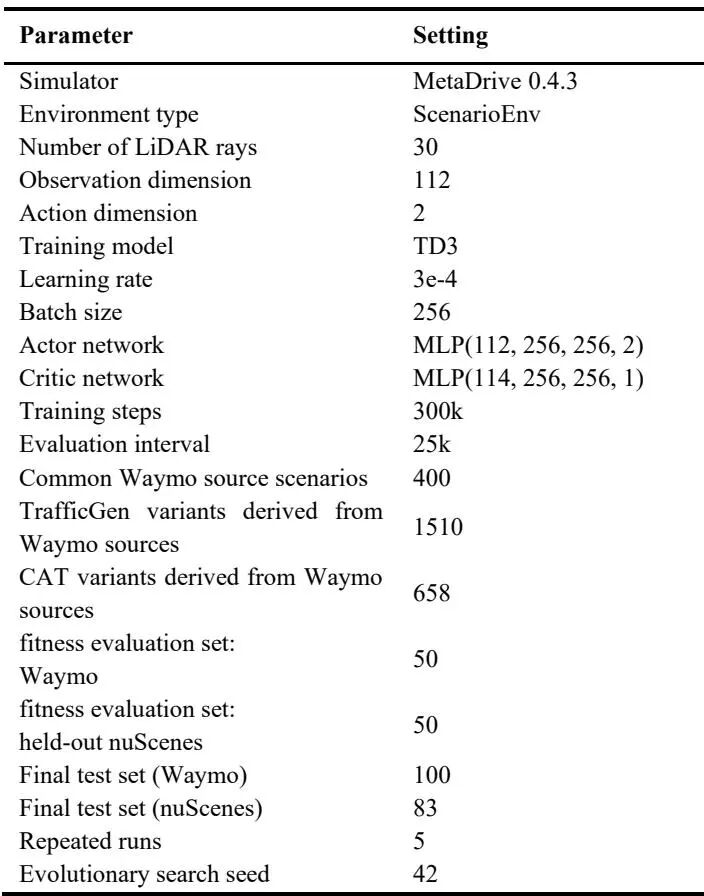
实验怎么搭的
考出来的成绩
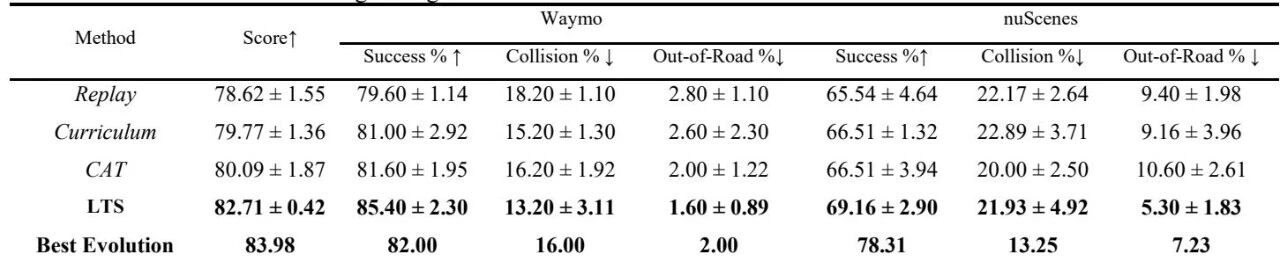
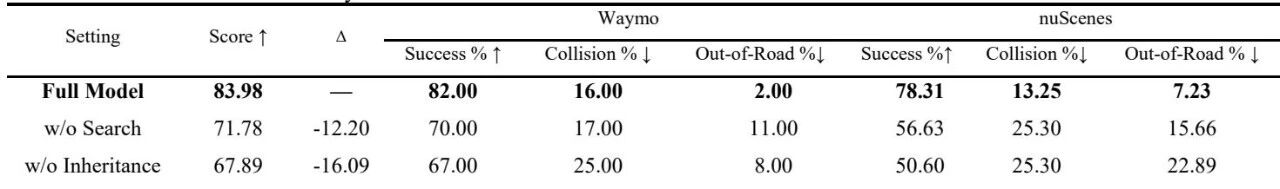
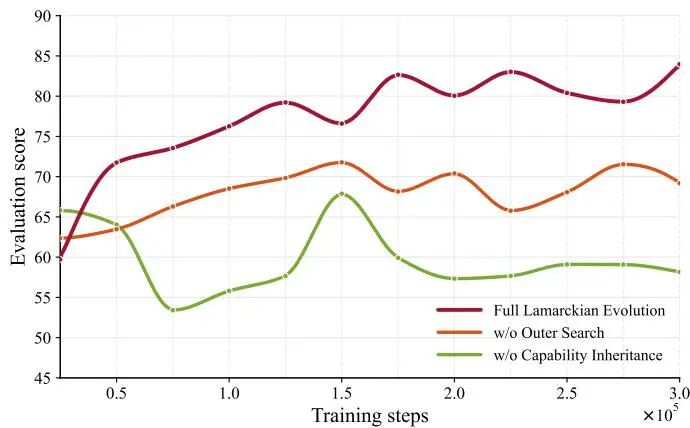
消融实验告诉你:场景搜索和能力继承缺一不可
龙迷三问
龙哥点评
论文创新性分数:★★★★☆
提出拉马克进化框架,将训练场景分布作为可优化变量,通过多阶段双层优化问题建模,外层用达尔文式交叉变异选择探索场景分布空间,内层进行策略学习并通过拉马克遗传将已获得的能力传递到后续阶段,使场景分布与策略能力协同进化,最终蒸馏出轻量级可复用的拉。实验合理度:★★★★☆
综合评分(加权评估函数,满分100),成功率(Success %)、碰撞率(Collision %)、驶出道路率(Out-of-Road %),覆盖Waymo和nuScenes两个数据集。学术研究价值:★★★★☆
提出拉马克进化框架,将训练场景分布作为可优化变量,通过多阶段双层优化问题建模,外层用达尔文式交叉变异选择探索场景分布空间,内层进行策略学习并通过拉马克遗传将已获得的能力传递到后续阶段,使场景分布与策略。稳定性:★★★☆☆
现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。适应性以及泛化能力:★★★☆☆
现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。硬件需求及成本:★★★☆☆
完整拉马克进化需要12代×10候选×25k步=3.0百万步策略训练(不含评估);蒸馏后的LTS仅需300k步训练。仿真环境为MetaDrive 0.4.3,使用30线LiDAR,观测维度112,动作维度2。复现难度:★★★☆☆
https://github.com/ (论文提到Code is available on GitHub但未给出具体链接)产品化成熟度:★★★☆☆
论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。可能的问题:形式化为多阶段双层优化,用训练后性能而非代理指标驱动分布设计,思路新颖;(2)拉马克进化框架将环境参数进化与策略能力继承有机结合,机制设计合理;(3)发现了"阶段性挑战轮换"的可解释模式,并成功蒸馏为轻量级LTS,实用性强;(4)实验在MetaDrive中验证,对比充分,消融合理。
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!

还没有公开留言,欢迎留下你的看法。