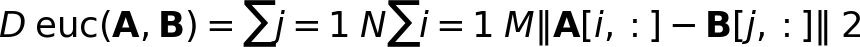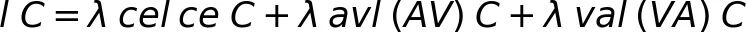
← 返回 PaperDaily 视觉与图像

印度理工海得拉巴分校:音视频蒸馏提速8倍,10小时压到1.3小时

数据集蒸馏这名字听着很美:用一小撮合成样本,顶掉整个大训练集。可一到音视频这种双模态场景,就撞上两根硬钉子——显存炸裂,以及两个模态各说各话。印度理工海得拉巴分校这篇 X-AVDD 用双向交叉注意力把两件事一起收拾了:合成时间从10小时压到1.3小时,VGGSound 上的准确率从个位数跳到两位数。这波值得拆开看看。

印度理工海得拉巴分校:音视频蒸馏提速8倍,10小时压到1.3小时

paperdaily_reaction_gif


原论文信息如下:
论文标题:
X-AVDD: Cross-Attentive Audio-Visual Dataset Distillation
发表日期:
2026年10月
发表单位:
印度理工学院海得拉巴分校(IIT Hyderabad)人工智能系、印度理工学院马德拉斯分校(IIT Madras)负责任人工智能中心
原文链接:
https://arxiv.org/pdf/2610.13687v1.pdf

音视频数据集蒸馏的两大痛点:内存爆炸与模态鸿沟

数据集蒸馏(Dataset Distillation,缩写 DD),也有人叫它数据集压缩(Dataset Condensation),干的事情很像速溶咖啡:把一整袋咖啡豆的风味,压进一小块方糖里。落到机器学习上,就是想办法合成一小撮带标签的假样本,让在这些假样本上训练出来的模型,表现尽量接近在完整大数据集上训练出来的模型。
这块方糖的价值在哪儿?它可以让你反复做神经架构搜索、反复调超参,而每次实验都只在小数据上跑;它还能当成一个紧凑的接口,把训练信号分享出去,同时又不用把原始数据交出去。
但数据集蒸馏一旦从单模态(主要是图像分类)跨到多模态,麻烦就多了一层:合成出来的样本,不光得保住每个模态自己的信息,还得保住让多模态学习真正有效的那层跨模态关联。本论文研究的对象,就是音视频数据集蒸馏(Audio-Visual Dataset Distillation)——给定一个大规模成对的音视频数据集,合成一个小得多的数据集,使得在这个小数据集上训练的下游模型依然好用。评估任务选的是音视频事件识别,可以理解为图像分类在音视频世界里的对应物。
这个方向的开山之作是 AVDD(Kushwaha 等人,2024),它把分布匹配(Distribution Matching,缩写 DM)从单模态搬到了成对的音视频数据上。所谓分布匹配,思路是让真实样本和合成样本在特征空间里的统计分布尽量对齐,而不是去做双层优化那种又贵又重的梯度匹配。思路没错,但落地就撞上两根硬钉子。

第一根钉子:内存效率。AVDD 走的是非解耦的分布匹配范式,优化循环里必须把整套合成样本同时塞在 GPU 显存里,才能去匹配全局特征分布。合成预算一涨、模型一复杂,显存直接爆给你看,也就是 OOM(Out of Memory,显存溢出)。有人会说,那就按类别分批喂进去呗?论文做了实测,这条路走不通——按类别分批会丢掉类间关系信息,而类间关系恰恰是分布匹配有效的前提,SPC 等于 20 的时候准确率会从 58.0% 掉到 49.5%。结果就是 AVDD 基本被锁死在简单的 ConvNet 架构和偏低的每类样本数(Samples Per Class,缩写 SPC)上,碰到 ViT 这种现代高参数量模型,或者 AudioCLIP 这种多模态大架构,就直接趴窝。

第二根钉子:模态鸿沟。这个词的英文是 modality gap,指的是不同模态的特征在共享空间里各站各的、靠不拢。AVDD 合成出来的数据,音频和视觉两类特征中心之间的逐类 ℓ₂ 距离,比原始数据集还要大不少。换句话说,它合成的"音画配对",音和画在语义上其实是各说各话。多模态领域里这个现象还有一个更狠的叫法,叫做模态崩塌(modality collapse),就是合成出来的配对把语义对齐给弄丢了。
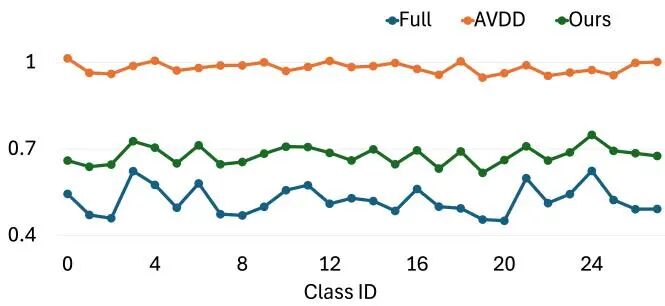
Figure 2 模态鸿沟对比
AVE 数据集上的模态鸿沟(特征空间中音频类中心与视觉类中心之间的逐类 ℓ₂ 距离),对比原始数据集、AVDD 蒸馏数据集与 X-AVDD 蒸馏数据集,统一使用 AudioCLIP 网络提取特征。X-AVDD 取得了持续更低的模态鸿沟。
这张图基本就是这篇论文的"立案证据"。柱子越低,说明音和画在特征空间里贴得越近,跨模态语义越健康。可以看到原始数据集本来就有一个基础距离,AVDD 蒸馏之后距离反而被拉大了,而 X-AVDD 把它压回去了。
两根钉子,一根是工程上的显存墙,一根是方法上的对齐病。X-AVDD 的做法是拿一把起子同时对付它们:用双向、多头的交叉注意力,在蒸馏过程中显式建模模态之间的关系;同时把跨模态对齐从联合优化里拆出来,交给一个预训练教师模型去做。拆出来之后,内存开销下来了,对齐质量反而上去了。

X-AVDD核心机制:双向交叉注意力如何实现模态对齐

交叉注意力(Cross-Attention)在多模态里其实是个老熟人。普通自注意力的玩法是同一串输入自己问自己,交叉注意力则是让一个模态出查询(Query),另一个模态出键(Key)和值(Value),通过查询去另一个模态里"捞"信息。放到音视频场景,就是让音频去视频里找跟自己对应的画面内容,或者让画面去音频里找对应的声音线索。
而双向交叉注意力(bi-directional cross-attention)多了一个对称的回程:第一遍让模态 A 去查询模态 B,第二遍让模态 B 反过来查询模态 A。两次互相交换之后,每个模态都能根据对方修正自己的表示,而不是把某一方当成主导。论文的说法是,这种双向交互比单向融合能抓住更丰富的对齐关系,对对齐、检索、生成这类任务都更友好。
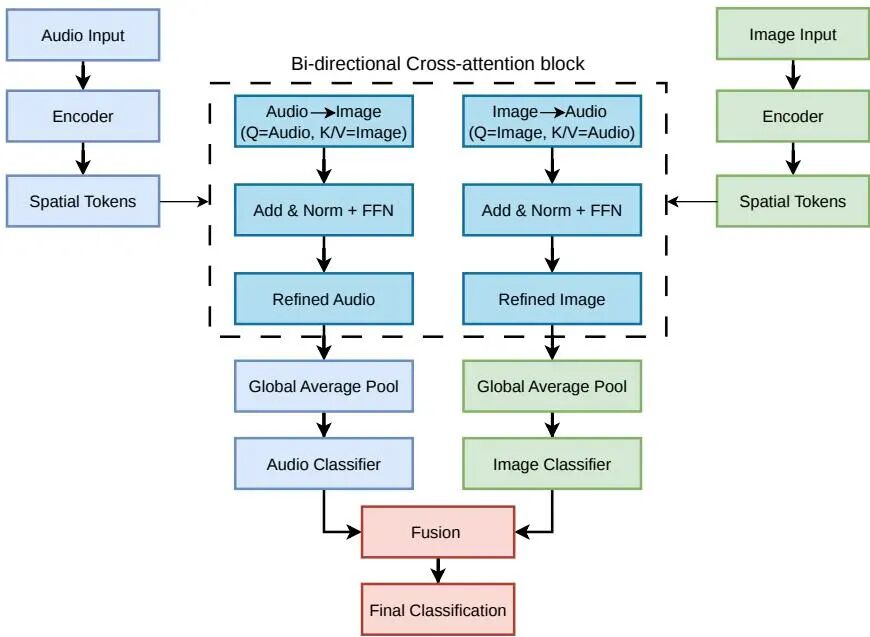
Figure 3 双向交叉注意力机制总览
图 3:用于音视频事件识别的双向交叉注意力机制总览。音频流与视觉流互为查询、键和值,双向交换信息后再汇总输出。
这张图是理解 X-AVDD 的关键。左右两条支路分别是音频到画面、画面到音频,二者对称,最后通过全局平均池化(Global Average Pool,GAP)压成定长的注意力嵌入向量。蒸馏阶段比对的就是这批嵌入向量。
在说清楚整体流程之前,得先明确本文的问题设定。设带标签的数据集为 𝒱 = {(xᵢᵃ, xᵢᵛ, yᵢ)},其中 xᵢᵃ 是第 i 个样本的音频模态,xᵢᵛ 是视觉模态,yᵢ 是对应标签。视觉输入取视频的中心帧,音频输入取对应的频谱图。蒸馏的目标是学出一个紧凑的合成数据集 𝒮 = {(x̃ᵢᵃ, x̃ᵢᵛ, ỹᵢ)},样本量 M 远小于原始样本量 N,使得在 𝒮 上训练出来的模型,泛化性能接近在完整数据集上训练出来的模型。
X-AVDD 的整体流程分成三步。第一步,预训练带双向交叉注意力的教师网络;第二步,把真实数据的音视频嵌入通过交叉注意力层算出来并存下来;第三步,通过匹配真实样本与合成样本的交叉注意力嵌入,迭代地学习合成数据集。第三步才是要反复跑的部分,前两步是一次性开销——这个结构上的安排,正是后面效率能掉一个数量级的根源。
合成样本的初始化方式和 Cazenavette 等人、Du 等人的工作一致,直接从真实数据里随机抽音视频对。为了公平,基线和本文方法用的是同一批初始化样本。
接下来是本方法的核心损失。先看两个矩阵之间的成对欧氏距离是怎么算的:
公式1 成对欧氏距离
式子 1:矩阵 A(维度 M×d)与矩阵 B(维度 N×d)之间的成对欧氏距离 D_euc。它把 A 的每一行和 B 的每一行两两求 L2 距离再累加,M 和 N 分别是两个矩阵的行数,d 是特征维度。这个量衡量的是两堆特征点整体上离得多远。
在此基础上,论文把真实数据经双向交叉注意力后得到的嵌入定义出来。设 h_a、h_v 分别为音频编码器和视觉编码器,τ_a、τ_v 为两个模态的标记化(tokenization)算子,g_a、g_v 为两路的全局平均池化算子,𝒯_a、𝒯_v 分别代表音频到画面、画面到音频两个方向的交叉注意力分支:
公式4 真实数据的注意力嵌入
式子 2:类别 C 下真实数据的两个方向的注意力嵌入。E_r(AV) 表示以音频为查询、视觉为键值得到的结果,E_r(VA) 则相反。这两批嵌入算完就存起来,蒸馏时直接取用。
合成样本这边的嵌入计算有一个很容易被忽略的细节——它是"混搭"的:
公式5 合成数据的注意力嵌入
式子 3:合成数据的注意力嵌入。注意这里的构造方式——以合成图像为查询、真实音频为键和值,得到音频引导的图像嵌入;反过来以合成音频为查询、真实图像为键和值,得到图像引导的音频嵌入。这个设计意味着合成样本必须去"迁就"真实样本的语义上下文,而不是自己跟自己玩。这也是它能压低模态鸿沟的直接原因之一。
为了让合成嵌入往真实嵌入附近靠,论文使用欧几里得分布匹配损失(Euclidean Distribution Matching,EDM),也就是最小化真实与合成两侧注意力嵌入的成对欧氏距离,然后和分类的交叉熵损失加权求和:
公式8 合成阶段总损失
式子 4:合成阶段的完整损失。第一项 l_ce 是分类任务的标准交叉熵损失,第二项和第三项分别是音频到画面、画面到音频两个方向的 EDM 损失,λ_ce、λ_av、λ_va 是三项对应的权重系数。这两个方向性的损失项能不能同时启用,直接决定了双向注意力是不是白装——后面的消融实验专门验证了这一点。

解耦式蒸馏:从10小时到1.3小时的效率革命

"解耦"这两个字是本文效率提升的钥匙,值得单独拆开讲。AVDD 的问题在于,跨模态对齐和合成数据集的学习被捆在同一个优化循环里,每更新一次合成样本,都要重新过一遍庞大的联合模型,显存里还得同时驻留全套合成样本。X-AVDD 把这两件事拆开了:跨模态对齐交给冻结的、带交叉注意力的教师网络去做,而且真实数据的嵌入只算一次、存下来复用;合成阶段退化成单个类别内部的、轻量的分布匹配。
这一拆带来三个直接后果。第一,蒸馏过程可以并行化,因为各类别的匹配互不依赖全局状态。第二,蒸馏不再需要访问原始大训练集,手里有嵌入就够了,这在数据不方便外传的场景下是实打实的好处。第三,也是最能被量化的那一条——峰值显存和总合成时间一起往下掉。
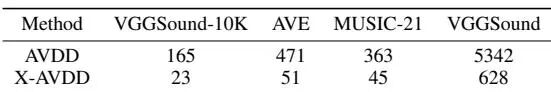
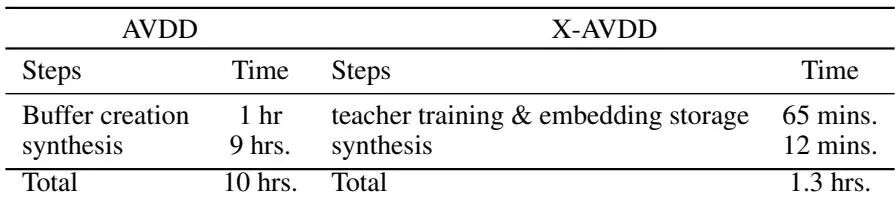
论文给出的数字是:在单张 Tesla V100 GPU 上,端到端合成开销从 10 小时降到 1.3 小时,减少约 8 倍 GPU 小时。看表格更清楚:
Table 5 GPU小时对比
表 5:AVDD 与本文方法在多个数据集上的 GPU 小时对比。
省下来的时间从哪来?论文在附录里给了一份更细的账本,也就是表 15。它点出一个容易被忽略的事实:AVDD 的合成阶段是一个反复执行的过程,换个 SPC 就得重跑一遍,而且还额外背着"缓冲区创建"的开销;本文方法里,教师网络训练和嵌入存储都是一次性的,真正反复跑的只有合成阶段。
Table 15 时间对比
表 15:在 VGGSound-10K 数据集上合成 SPC=20 时,AVDD 与 X-AVDD 的耗时对比。需要注意,AVDD 的合成阶段是反复执行的;而在本文方法中,教师网络训练和嵌入存储属于一次性开销,只有合成阶段是跨不同 SPC 设置反复执行的部分。
换个角度理解这件事:AVDD 每次做一次"浓缩咖啡",都得把整袋豆子重新烘一遍;X-AVDD 是先把豆子烘成浓缩液冻起来,之后每次只需要取一勺兑水。前者叫端到端重算,后者叫缓存复用。工程上这种改动的收益往往比换模型更大,因为它把一次函数调用变成了查表。

全面碾压:四大基准数据集上的性能表现

实验在四个音视频基准数据集上展开:AVE(Tian 等人,2018)、MUSIC-21(Zhao 等人,2019)、VGGSound(Chen 等人,2020),以及随 AVDD 一起发布的 VGGSound-10K 十分类子集。预处理和划分完全沿用 AVDD 的设定以保证公平,测试准确率在五个随机种子(0 到 4)上报告均值和标准差。骨干网络方面,先按 AVDD 的做法用 ConvNet 做音视频双编码器,然后进一步换上 ResNet-18、ViT 和 AudioCLIP。
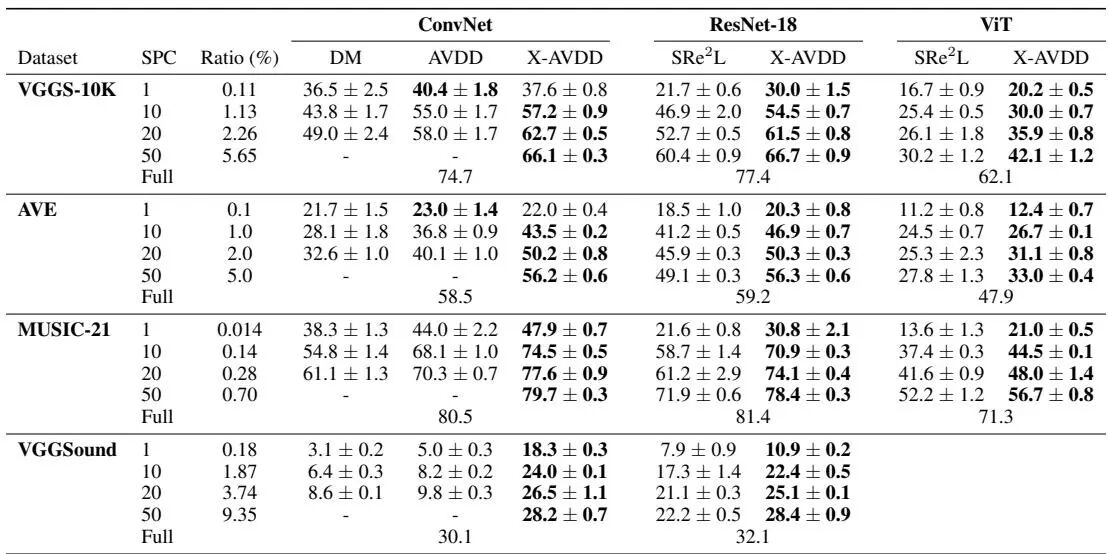
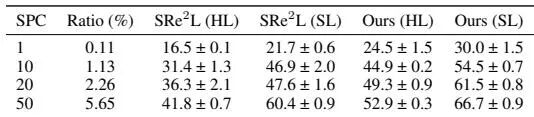
先看 ConvNet、ResNet-18 与 ViT 三档架构下的整体结果。这一组对比里,ConvNet 部分对手是 DM 和 AVDD,ResNet-18 与 ViT 部分因为 AVDD 在这些架构上直接显存溢出,论文专门实现了一个 SRe²L(Yin 等人,2023)的多模态适配版本当作基线。
Table 1 多架构准确率对比
表 1:在集成融合方式下,不同架构使用合成数据集的准确率(%)对比。ConvNet 架构对比 DM 与 AVDD,ResNet-18 与 ViT 架构对比 SRe²L 的多模态实现。SPC 表示每类样本数,加粗表示同架构组内最优,"-"表示显存溢出(OOM)。
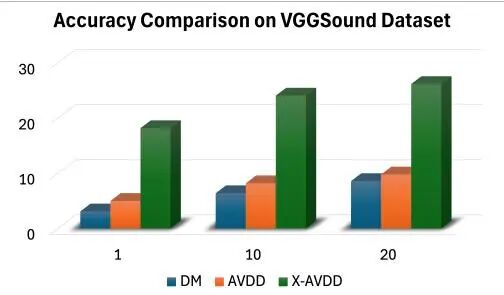
论文自己的总结是,在大多数 SPC 设置下 X-AVDD 显著优于 AVDD。最能说明问题的是 VGGSound——这是实验里规模最大的数据集,也是基线掉得最惨的地方:SPC=10 时从 8.2% 提到 24.0%,SPC=20 时从 9.8% 提到 26.5%,数字几乎是三倍的关系。VGGSound-10K 上 SPC=10 是 55.0% 到 57.2%,SPC=20 是 58.0% 到 62.7%,MUSIC-21 上 SPC=20 是 70.3% 到 77.6%,涨幅都不小。
但这里必须点出一个诚实的地方:在极低 SPC(SPC=1)时,X-AVDD 并不总是赢。VGGSound-10K 上它是 37.6%,AVDD 是 40.4%;AVE 上它 22.0%,AVDD 是 23.0%。论文对这一现象的解释是,合成样本本来就少的时候,额外的跨模态约束会变成过正则化,把模型压得太死;一旦合成多样性上来(SPC≥10),收益就立刻显现。这个解释在逻辑上站得住,也说明这套方法有自己的适用区间,不是无条件的全面领先。
Figure 1 VGGSound不同SPC下的准确率
图 1:VGGSound 数据集在不同每类样本数设置下的准确率。X-AVDD 在所有设置下持续优于 DM 与 AVDD。
这些结果值不值信?从实验设置看,几件事是站得住的:划分和预处理沿用基线,不给自己开小灶;五个种子报均值加标准差,方差普遍在零点几到两点几个点之间,说明结论不是靠一次幸运;极端低 SPC 下的劣势也照实写在正文里。相对不足的地方在于,DM 和 AVDD 的结果有一部分是直接引用 AVDD 原文,而不是在同一套环境下重跑;ResNet-18 和 ViT 上因为 AVDD 显存溢出,对比对象换成了论文自己实现的 SRe²L 多模态适配版,这个基线的调参强度是否和 X-AVDD 完全对等,原文没有给出足够细的说明。所以"全面提升"这个判断在 VGGSound 这种大差距上是可信的,在一两个点的差距上则要留一点余量。

跨架构泛化与基础模型迁移:从ConvNet到AudioCLIP

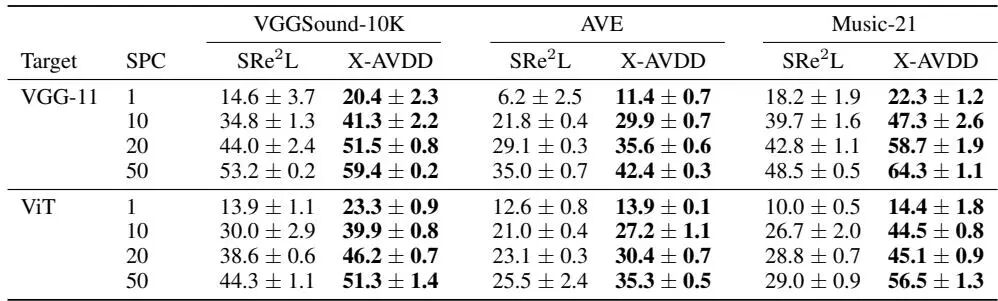
蒸馏数据集真正的价值不在于"喂给谁谁就能赢",而在于换一个模型照样能用。为了验证这一点,论文用 ResNet-18 生成合成数据,再换 VGG-11 和基于 transformer 的 ViT 去训练,看泛化还剩下多少。
Table 3 跨架构泛化对比
表 3:使用 ResNet-18 同时生成音频与视觉两路合成数据后,跨架构泛化性能的对比分析。目标架构为 VGG11 与 ViT,X-AVDD 生成的数据集在两者上都取得高于 SRe²L 适配版的泛化准确率,结果基于集成融合方式。
几个数字值得记一下:AVE 数据集上以 ViT 为目标架构、SPC=50 时,从 25.5% 提到 35.3%,接近十个点;MUSIC-21 上以 ViT 为目标架构、SPC=10 时从 26.7% 提到 44.5%,差距更大。跨架构差距能拉到这个幅度,说明合成数据里保住的不是某种特定卷积结构的偏好,而是更底层、更可迁移的跨模态语义结构。
再往上走一层就是 AudioCLIP。AudioCLIP(Guzhov 等人,2022)把 CLIP 扩到了音频模态,在图像和文本之外引入 ESResNeXt 音频模型。在这类大模型上,AVDD 已经跑不动了,X-AVDD 是少数能撑住的。
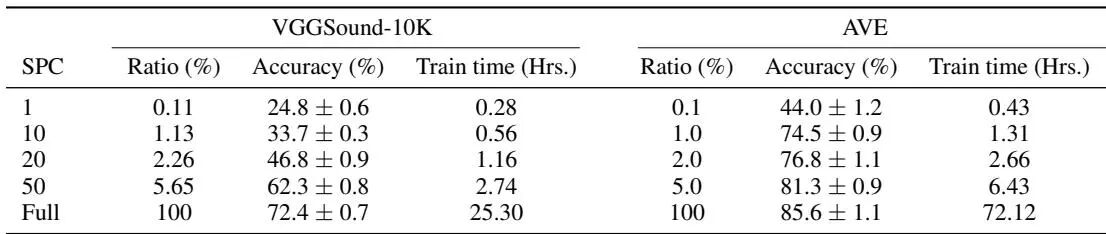
Table 2 AudioCLIP架构下的测试准确率
表 2:使用 AudioCLIP 架构时,X-AVDD 生成的合成数据在 VGGSound-10K 与 AVE 数据集上取得的测试准确率。Ratio 表示压缩后数据量相对完整数据集的百分比。用完整数据集训练模型所需时间的一小部分,蒸馏数据就能达到可比的泛化准确率。
这张表的性价比非常直观。VGGSound-10K 上 SPC=50,也就是只用完整数据集 5.65% 的样本量,准确率做到 62.3%,而全量数据训练出来的成绩是 72.4%;训练时间 2.74 小时对 25.30 小时,差不多九分之一。AVE 上 SPC=50 时,5% 的数据量拿到 81.3%,全量是 85.6%;训练时间 6.43 小时对 72.12 小时。数据少了十几倍,精度只差几个点,时间少了十倍量级——这就是数据集蒸馏想卖的东西。
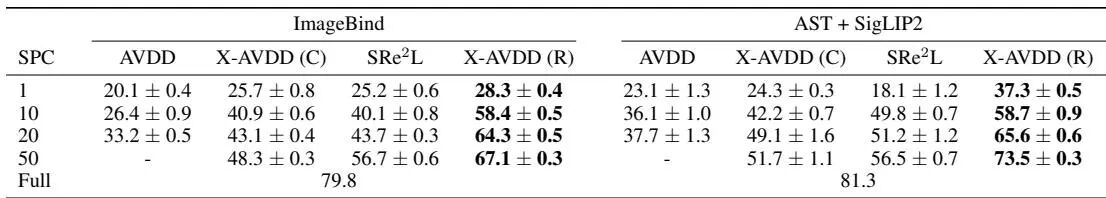
论文还试了一条更贴近真实生产的路径:把 ConvNet 或 ResNet-18 蒸馏出来的数据,拿去微调冻结的顶尖基础模型之上的轻量分类头。两套设置,一套用 ImageBind 的音频和视觉骨干,它擅长把多模态数据映射到共享特征空间;另一套用音频频谱 transformer(Audio Spectrogram Transformer,AST)做音频编码器,搭配 SigLIP2 做视觉编码器。选 AST 是因为它在 MAEB 基准的音乐与环境音频任务上表现强,选 SigLIP2 是因为 SigLIP 系列在 MIEB 上是开放图像嵌入模型里的第一梯队,而这两个基准都整合进了被广泛使用的 MTEB 体系。
Table 4 冻结骨干迁移学习
表 4:蒸馏数据集在顶尖模型冻结骨干上做迁移学习的性能分析。X-AVDD (C) 与 X-AVDD (R) 分别表示由 ConvNet 和 ResNet-18 生成的合成数据集。仅用每类 50 个样本,ResNet-18 生成、X-AVDD 蒸馏的数据就达到了与完整数据集训练可比的表现。
这组数字在工程上比前面的分类结果更有吸引力。ImageBind 上 SPC=50 时,X-AVDD (R) 拿到 67.1%,而此时 AVDD 在 SPC=20 只有 33.2%;AST+SigLIP2 上 SPC=20 时,X-AVDD (R) 是 65.6%,同条件下 AVDD 是 37.7%。值得注意的是,由更简单的 ResNet-18 蒸馏出来的数据,在强得多的大模型上依然能训出好用的分类头,这说明蒸馏过程抓住的是跨模态语义对应关系,而不是某个小模型的怪癖。

消融实验揭秘:双向注意力与软标签的贡献

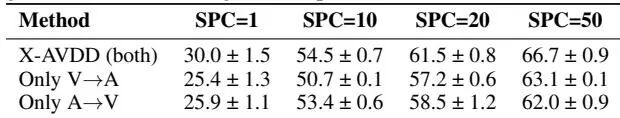
方法里最该被追问的是:双向到底有没有必要?如果只用一个方向的 EDM 损失,是不是也能跑出差不多的成绩?论文在 VGGSound-10K 上做了方向性消融,做法是在式子 4 里把两个方向的 EDM 损失权重关掉一个或两个。
Table 6和Table 7 方向性消融与IOR
表 6:VGGSound-10K 上的方向性消融,通过开关式子 4 中的 EDM 损失权重进行。表 7:不同数据集在不同 SPC 设置下的 IOR 取值。
这类实验的意义在于把"双向"从一个听起来很漂亮的词,变成一个能拿出数字的开关。如果关掉一个方向的约束、性能基本不掉,那说明另一条支路是冗余的,整个设计的成本就白花了;反过来,如果掉得明显,双向的必要性才算被证实。
另一个被单独拎出来考察的是软标签的作用。软标签指的是用教师模型输出的概率分布替代硬性的类别标签,好处是能把类与类之间的相似性信息带进合成样本。论文在 VGGSound-10K 和 MUSIC-21 上分别用 ResNet-18 做了对照。
Table 8和Table 9 软标签影响
表 8:软标签对泛化准确率的影响(VGGSound-10K,ResNet-18)。表 9:软标签对泛化准确率的影响(MUSIC-21,ResNet-18)。
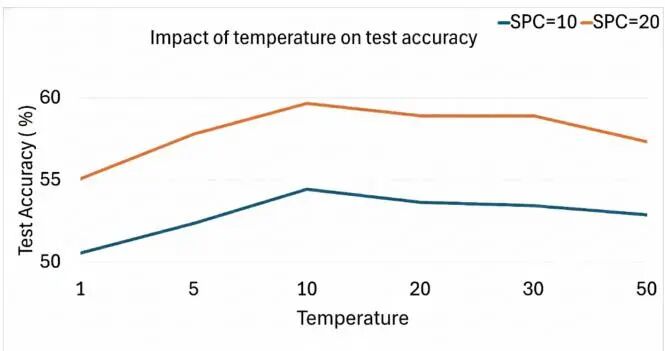
软标签生成过程中有一个关键的超参——温度。论文专门画了曲线观察温度对测试准确率的影响。
Figure 6 温度对测试准确率的影响
图 6:温度对测试准确率的影响,基于 VGGSound-10K 与 ResNet-18,SPC 取 10 和 20。可以看到准确率随温度升高先增后降,说明软标签生成时温度参数的选择相当重要。
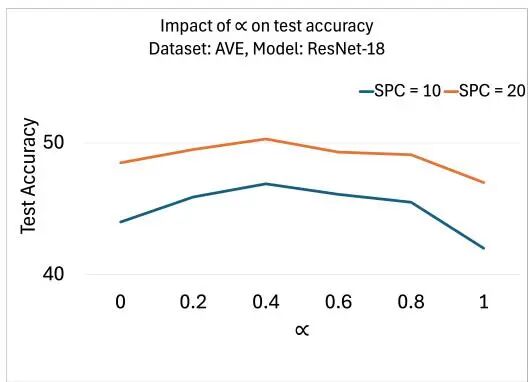
论文还考察了一个与损失项配比有关的超参数 α 对测试准确率的影响,分别在 VGGSound-10K 与 AVE 上、用 ResNet-18 画了两条曲线。
Figure 4 参数alpha对测试准确率的影响
图 4:参数 α 对测试准确率的影响,左图为 VGGSound-10K 搭配 ResNet-18,右图为 AVE 搭配 ResNet-18。
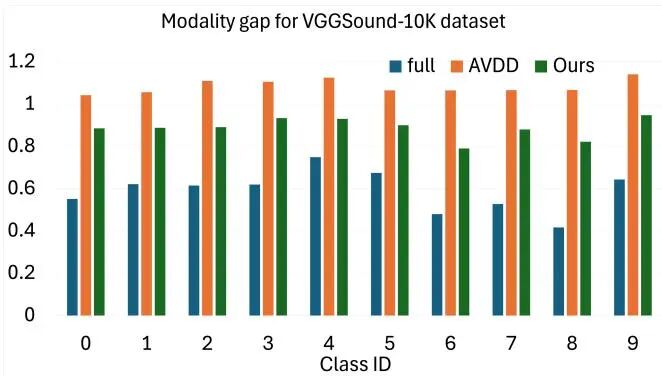
模态鸿沟本身也被逐类拆开看了。论文在 VGGSound-10K 上把真实数据、AVDD 合成数据、X-AVDD 合成数据的逐类鸿沟摆在一起比。
Figure 5 逐类模态鸿沟对比
图 5:真实数据集、AVDD 生成的合成数据与本方法生成的合成数据之间的模态鸿沟对比。可以看到本方法在 VGGSound-10K 的所有类别上都取得了更低的模态鸿沟。
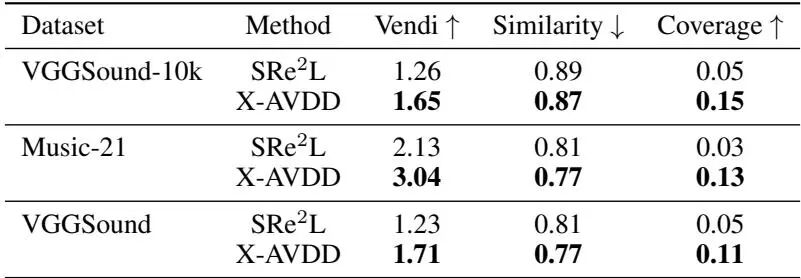
除了准确率,论文还做了一个多样性指标的对比,用三种多样性度量考察合成数据,X-AVDD 生成的样本全面优于 SRe²L 的多模态适配版。这一项值得留意,因为合成样本如果只是把少数几个模式复制粘贴,多样性指标会很难看,而多样性恰恰是低 SPC 场景下过正则化问题的解药——它和前面"SPC 越低越吃亏"的观察能对上。
Table 11 多样性指标对比
表 11:多样性指标对比分析。与基线 SRe²L 的多模态适配版相比,X-AVDD 生成的合成数据在三种多样性指标上表现都更好。
meng.jpeg
绕了一圈下来,这篇论文的逻辑链是闭合的:先用双向交叉注意力解决对齐,再用解耦把这项工作从昂贵的联合优化里搬出来,然后用跨架构、跨大模型、跨融合方式的一串实验证明合成数据本身够硬。整条链路里没有哪一步是靠"更贵的算力"堆出来的,恰恰相反,它是靠把贵的那部分变成一次性开销。这类思路在工程上通常比单纯换一个更强的骨干网更值钱。

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?印度理工学院海得拉巴分校提出 X-AVDD,用双向交叉注意力解耦音视频数据集蒸馏,合成时间从10小时降到1.3小时,VGGSound 上 top-1 从 8.2% 提升到 24.0%。
这篇工作最值得看的点是什么?X-AVDD在绝大多数设置下显著优于基线方法。在VGGSound上,SPC=10时准确率从AVDD的8.2%提升至24.0%,SPC=20时从9.8%提升至26.5%。在AVE数据集ViT架构SPC=50时,从SRe²L的25.5%提升至35.3%。在AudioCLIP架构上,仅用5.65%数据达到62.3%准确率(完整数据集72.4%),训练时间减少9倍。合成时间从10小时降至1.3小时,内存效率大幅提升。
这篇工作的边界或风险在哪里?优点:(1)首次将双向交叉注意力引入音视频数据集蒸馏,显式建模模态间关系;(2)解耦设计大幅降低内存消耗,使方法可扩展到更高SPC和复杂架构;(3)在多个基准上一致优于现有方法;(4)合成数据模态间隙更低,跨模态对齐更好;(5)可成功迁移到预训练基础模型。缺点:(1)在极低SPC设置下可能过正则化导致性能下降;(2)需要预训练教师网络,增加前期成本;(3)仅在分类任务上验证,未涉及时间定位、检索等下游任务;(4)对SRe²L基线的适配可能不够充分,影响对比公平性。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

提出X-AVDD,一种基于双向多头交叉注意力的音视频数据集蒸馏方法,通过将跨模态对齐从联合优化中解耦,显式建模模态间关系,在保持强跨模态语义对应的同时大幅降低内存消耗和合成时间。

实验合理度:★★★★☆

Top-1测试准确率(%)、GPU-Hour消耗、模态间隙(类间ℓ2距离)、Vendi Score、余弦相似度、Coverage、IOR(Improvement Over Random)

学术研究价值:★★★★☆

提出X-AVDD,一种基于双向多头交叉注意力的音视频数据集蒸馏方法,通过将跨模态对齐从联合优化中解耦,显式建模模态间关系,在保持强跨模态语义对应的同时大幅降低内存消耗和合成时间;更关键的是问题定义是否可复用到同类任务。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

X-AVDD在Tesla V100 GPU上合成SPC=20的VGGSound-10K数据集仅需1.3小时,而AVDD需要10小时,减少约8倍。

复现难度:★★★☆☆

现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:(1)在极低SPC设置下可能过正则化导致性能下降;(2)需要预训练教师网络,增加前期成本;


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球