← 返回 PaperDaily
大模型与智能体
安大略理工×微软:LSTM自动切笔模式,准确率88.55%
数字笔已经普及了很多年,但有一个问题几乎没怎么变过:模式切换。
龙哥读论文
发布于 2026-10-17 01:09:39
阅读 10
查看原文
原论文信息如下:
还在用菜单切笔模式?Magic Pen用LSTM让你告别来回点工具栏 数字笔已经普及了很多年,但有一个问题几乎没怎么变过:模式切换。
用笔在 PDF 上划重点,想从荧光笔切到写字,手要挪到屏幕顶端的工具栏点一下,再挪回来。划两笔,又得切一次。一次来回不算什么,几十次来回累积起来,注意力就被切碎了。
论文里把这件事叫做模式问题(Mode Problem)
更麻烦的是出错。如果忘了当下处在哪个模式,画出来的东西就是错的,而系统通常不会提醒——它就按当前模式默默给你画出来了。你得先意识到不对,再回头擦掉,再切模式,再重画。这一圈下来,阅读的节奏基本断了。
安大略理工大学(Ontario Tech University)与微软研究院(Microsoft Research)合作的这篇 Magic Pen,思路倒是很直接:既然输入法可以靠联想猜下一个词,笔模式为什么不能靠猜?
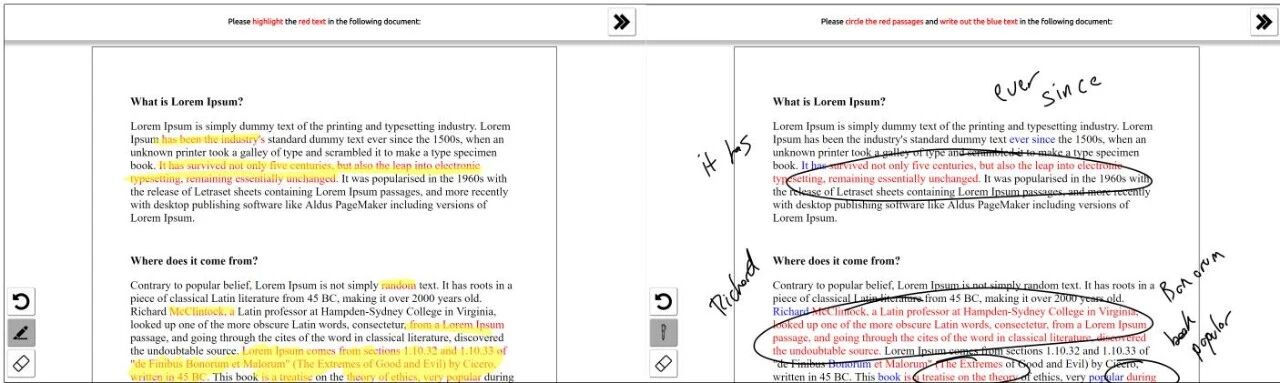
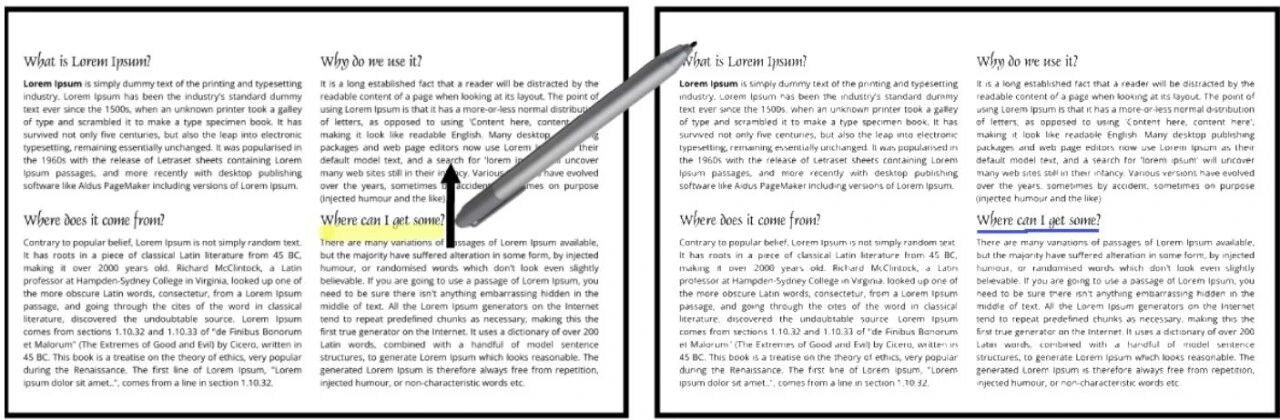
核心判断是:用户想画什么,身体其实已经提前交代了。高亮大多压在文字行中间,下划线贴近一行字的底部,画圈、画星号这类手写往往离文字更远。再加上压力、位移这些笔迹动力学信号,模式其实是有迹可循的。
于是 Magic Pen 训练了一个模型,在笔尖落下的最初几十毫秒内就开始判断模式,并且一边画一边修正。本方法的名字起得也直白——像魔法笔一样,落笔即知。
需要说明的是,自动推断笔模式这件事本身并不新。Saund 和 Lank 早年提出的“推断模式”(Inferred-Mode)协议,就用决策树在“绘制”和“选择”之间做过推断,只是判定发生在笔画结束之后,笔画外观已经被改掉了,视觉上会显得跳。Magic Pen 想解决的是这个时间差——判定要在笔画进行中完成,落在实时可感知的范围里。
Magic Pen怎么做到的?压力+位置+文本上下文,10个时间步就能判断你想画什么 任何分类器都得先有数据。研究团队做了一轮采集实验,招募9名右利手参与者(5男4女,年龄18–26岁)。只招右利手是有原因的:左撇子写字轨迹差异明显,样本量又不够,混在一起反而更难找到一致的模式信号。
每人要完成四类标注任务:高亮段落、在文字下方画线、在文字中间画线(删除线)、以及在文字周边画圆圈、括号、星号、箭头并用蓝色笔写字。任务设计参考了真实的批注场景,比如编辑改稿、学生复习、老师批作业。
设备是 Surface Pro 6 加 Surface Pen,平板被放平并固定在桌上,距离参与者约30厘米。这个设定牺牲了一部分自然性,确实有参与者反馈一开始姿势别扭,但目的是先控制住设备朝向这个变量,把笔压力和方向数据采干净。最终采集到11338条笔画
原始数据不能直接喂给模型。单个时间点的信息量太薄,判断不出模式。所以数据被切成了笔画窗口(stroke window)
还有一个细节是:坐标和压力都被转换成了“变化量”而不是绝对值。这样模型学到的是手上的动作规律,而不是“这块板子上坐标X意味着什么”,换台设备也不会失效。
特征筛选是一步步剔出来的。团队先画图观察各模式下的特征分布,再逐个加特征训练模型,看准确率有没有提升,直到达到最优组合。这个过程里发现一个棘手问题:删除线和高亮在数据上非常接近,都是横向压在文字上的笔画,模型分不清。最后他们做了一个取舍——把删除线模式从后续全部工作里移除
Delta X / Delta Y:
笔压力(Pen Pressure):
压力变化量(Delta Pen Pressure):
是否在文字上(Nearest Objects):
距最近文字底框的距离(Closest Bottom):
Magic Pen 一开始就设计了两个后端,想比一比谁更合适。
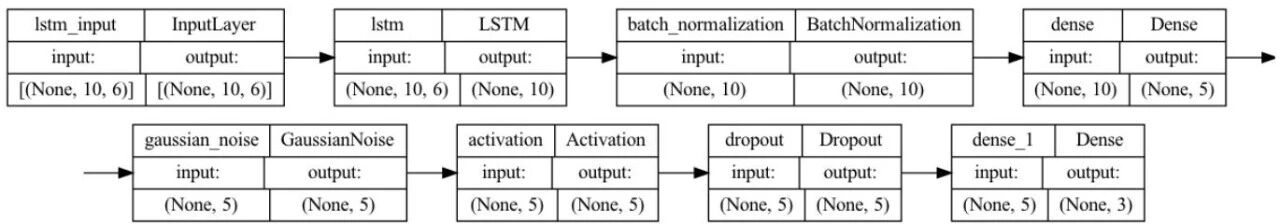
机器学习这一路用的是长短期记忆网络(Long Short-Term Memory,LSTM)
网络结构有意做得小:单层 LSTM,隐藏单元数定为10。隐藏单元越多,模型越能拟合复杂趋势,但越容易过拟合、越吃数据。10这个数字是团队用暴力穷举不同超参数组合试出来的平衡点。后面接两层全连接,中间用了批归一化和高斯噪声(0.1)抗过拟合,激活层后加了一个 Dropout(0.15)。训练批大小64,最多500轮,配合 EarlyStopping 回调,patience 设为20。另外还计算了类别权重,把训练数据中各类别不均衡的问题抹平,避免模型一头倒向某一类。
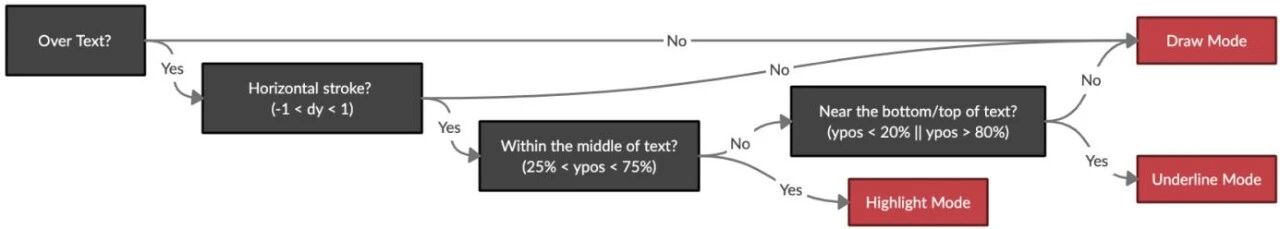
第二条路是规则方法。既然数据显示“笔在文字哪个位置”本身就有很强的指示性——笔在词中间时高亮概率大——那不用神经网络,人工写规则行不行?团队于是手工搭了一棵决策树,规则来自对初始笔画数据的可视化观察:笔落在文字中部偏上区间判为高亮,贴近底框判为下划线,离文字较远判为绘制。为了和机器学习方案保持一致的架构,决策树同样以笔画窗口为单位做判断。
规则法的优点一眼可见:完全可解释,用户能预判它怎么出错。缺点也同样清楚:它只看位置,不看压力、不看运动动力学,笔一落到页边空白处(没有文字对象可参考),基本就失效了。而机器学习方案恰恰能利用压力这些特征,在文字之外也能做出判断。两条路线谁更好,还得靠实验说话。
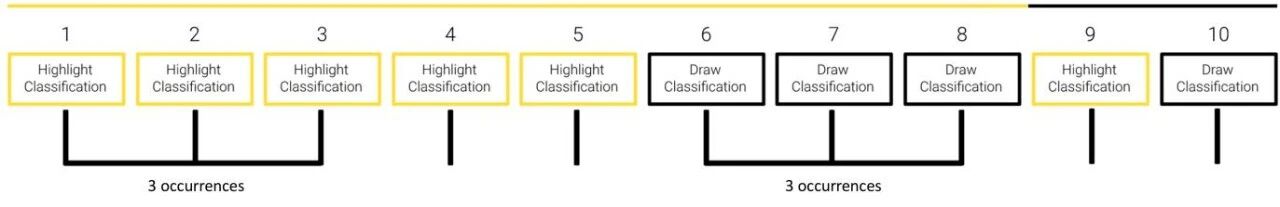
流程是这样的:给定一个笔画样本,系统先做预处理,判断有没有攒够10个时间样本。如果不够、但笔画已经结束且至少有2个样本,就用线性插值补齐剩下的样本,凑成一个完整窗口。窗口一旦成型,就送进机器学习或规则方法产出一次分类。每次分类都被追加到这条笔画的分类数组里。最终显示的笔模式,取决于数组末尾是否出现了连续 N 次相同的分类
也就是说,一笔画到中段的时候,屏幕上的外观有可能发生变化——本来是高亮,判着判着变成下划线。听上去有点跳,但因为窗口滑动很快,用户一般感知不到这个过程,只看到笔画很快就对了。
自动分类不可能百分之百正确。如果每次判错都得去点工具栏才能改回来,那自动切换的收益就被抵消了。
团队设计的弥补方案是甩动手势(flick)
为什么不用笔尖加侧键?团队考虑过这个方案,动作确实快,但笔尖加键意味着“边写边按”,和正常书写太接近,容易误触。改用橡皮擦端,天然把“我在纠正”和“我在写”分开了。这个细节考虑得挺细致。
规则方法更可预测但ML更准?18人对比实验揭示的意外发现 实验室数据只能说明模型跑得动,跑得好不好还得看人用起来是什么体验。为此团队做了一轮远程部署的混合方法实验,18名参与者(11男7女,年龄18–39岁),其中16人右利手、2人左利手。参与者需要自备一台支持笔的 Windows 设备,7人用的是带独立橡皮的笔,8人用的是带侧键的笔,剩下3人靠屏幕按钮进入甩动模式。
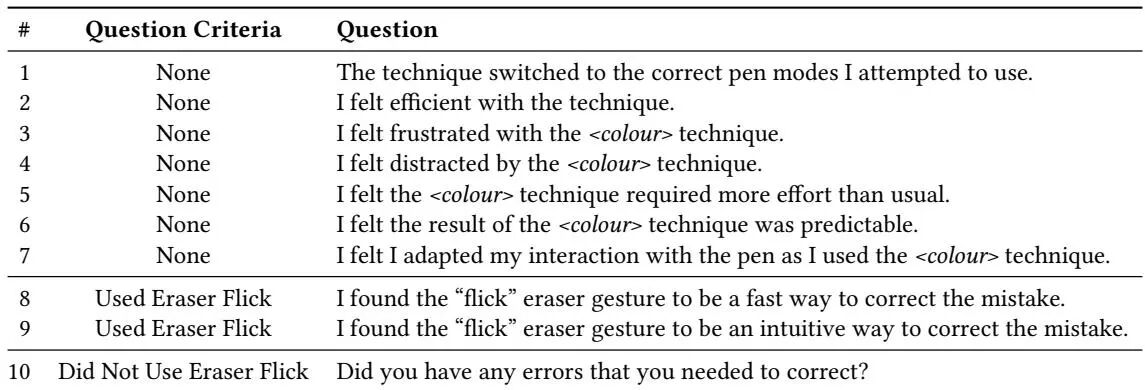
实验比较三种技术。为了不让名称影响判断,团队给它们起了颜色代号:红色=机器学习方案,蓝色=规则方案,绿色=传统工具栏菜单
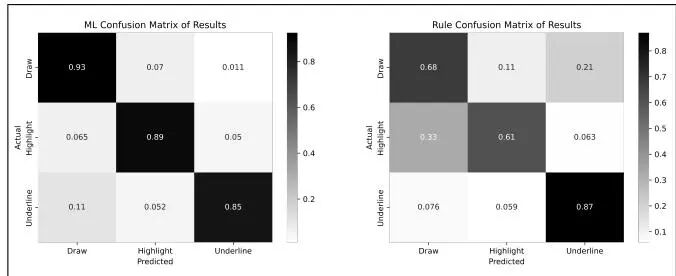
先看10折交叉验证的离线结果。在9名参与者、共计293997个笔画窗口上训练之后,机器学习方案的整体准确率为88.55% 72.67%
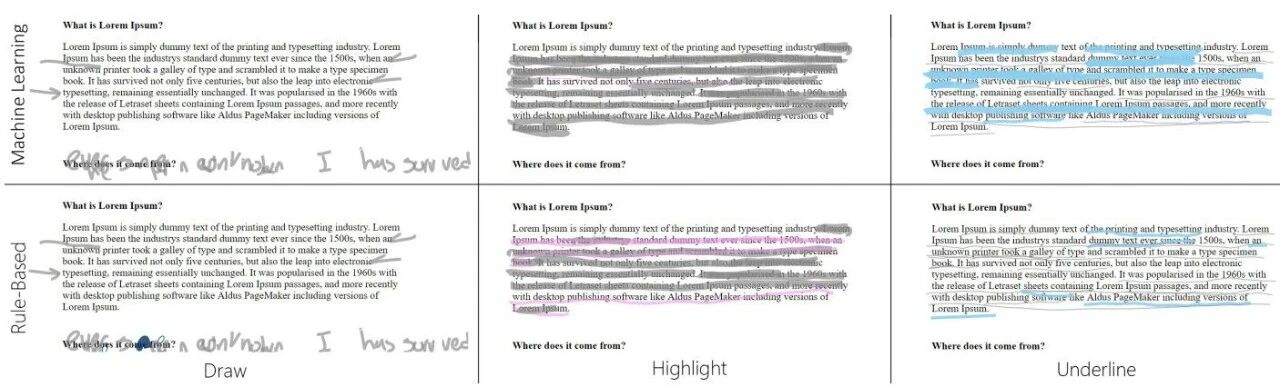
从矩阵里能读出一个挺关键的差别:机器学习方案在“绘制”和“高亮”这两类上比较稳,哪怕用户的高亮笔画画到了词的顶端、甚至直接盖在文字上,也还能判对。错误主要集中在“下划线”这一类。而规则方案反过来了——绘制判得很稳,但在高亮和下划线之间来回错,原因很明显:这两类的区分几乎全靠“笔在文字的什么位置”,位置一漂就判错。
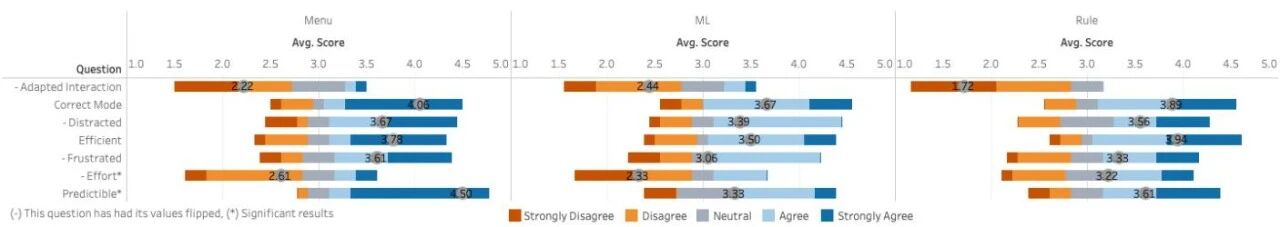
结果有点反直觉:机器学习方案准确率最高,但用户报告说它的“可预测性”不如传统菜单。也就是说,用户能明显感觉到——这东西大部分时候是对的,但没法百分之百猜准它下一秒会怎么做。而菜单虽然得动手点,但结果是确定的,主观上反而更“可控”。
龙迷三问 这篇论文到底在解决什么问题? 数字笔批注总得来回切模式。安大略理工大学与微软研究院提出Magic Pen,用LSTM从笔压、位置和文本上下文实时推断意图,三模式分类准确率88.55%;再用迁移学习按个人习惯微调,平均提升3.44%,多数参与者偏好自动模式。这篇工作最值得看的点是什么? ML方法达到88.55%的分类准确率,规则方法达到72.67%。在对比研究中,11/18参与者偏好自动方法,但无统计显著性。迁移学习平均提升3.44%的准确率,最高提升13.88%。部署研究中所有参与者完成了5次会话,大多数参与者对系统评价积极(准确M=4.38,效率M=4.50,可预测性M=4.50)。这篇工作的边界或风险在哪里? 优点:(1)首次将LSTM用于数字笔模式自动推断,实现低延迟实时分类;(2)迁移学习有效解决了个体化注释风格差异问题,平均提升3.44%准确率;(3)错误缓解机制(快速笔画移除)设计简洁实用;(4)完整的从数据收集到部署评估的研究流程。缺点:(1)ML方法准确率虽高但可预测性不如规则方法,影响用户信任;(2)短笔画和模糊笔画分类仍有困难;(3)样本量较小,泛化性有待验证;(4)迁移学习的验证集设计存在缺陷,导致准确率比较困难;(5)未与其他自动模式切换方法进行直接对比。如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~
龙哥点评 论文创新性分数: ★★★★☆
把自动模式推断系统性地落到笔式文档标注场景,配合迁移学习和长期部署研究,完成度不错。但自动模式推断本身不是全新概念,创新更多在工程整合和系统性验证上。实验合理度: ★★★★☆
两轮用户研究加一轮部署研究,样本和任务设计都比较扎实。但实验室阶段平板固定、只招右利手,外部效度打了折扣;对比实验和部署研究的人数也偏少。学术研究价值: ★★★★☆
对笔式交互、自动模式推断以及“信任与可预测性”之间的张力都有参考价值,把主观可预测性和客观准确率摆在一起对照的部分尤其值得借鉴。稳定性: ★★★☆☆
部署研究显示长期使用会变好,但手写漂移、书写习惯变化都会影响判断,跨设备、跨书写风格的鲁棒性还没做充分验证。适应性以及泛化能力: ★★★☆☆
主要在英文文档标注场景验证过,中文、公式、图表、多语言混排这类排版差异较大的场景都没有测试。硬件需求及成本: ★★★★☆
模型很小,单层 LSTM 加10个隐藏单元,能在浏览器端运行,不需要专用芯片,普通平板就能跑。主要成本在训练阶段的数据采集环节。复现难度: ★★★☆☆
论文对特征集、超参数、网络结构的描述比较完整,但训练数据来自9名参与者的11338条笔画,重新采集成本不低,代码是否开源也未在正文中明确说明。产品化成熟度: ★★★☆☆
交互设计已经接近可用状态,网页版 PDF 标注工具也做出来了。但个性化迁移学习需要先积累用户数据,冷启动体验和跨设备一致性还需要解决。可能的问题: 论文砍掉了删除线模式,也承认用户会为配合模型而改变书写习惯,这两点指向同一个隐含限制:当候选模式的动作特征高度重叠时,纯靠笔迹动力学的自动推断就会失守。边界可能不在模型能力,而在用户行为本身是否可分。
主要参考文献
Kevin Desousa, Adam Bradley, Ken Hinckley, Nathalie Henry Riche, Christopher Collins. Magic Pen: Automatic Pen Mode Switching for Document Annotation. arXiv:2610.11255v1. https://arxiv.org/pdf/2610.11255v1.pdf Marshall, C. C. Reading and writing the electronic book. In Proceedings of the SIGCHI Conference on Human Factors in Computing Systems (CHI), 1997. Saund, E., Lank, E. Stylus input and editing without prior selection of mode. In Proceedings of the ACM Symposium on User Interface Software and Technology (UIST), 2003. Hinckley, K., Baudisch, P., Ramos, G., Guimbretiere, F. Design and analysis of delimiters for selection-action pen gesture phrases in Scriboli. In Proceedings of the SIGCHI Conference on Human Factors in Computing Systems (CHI), 2005.
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击 "阅读原文", 查看更多原论文细节哦!

还没有公开留言,欢迎留下你的看法。