论文标题:
Domain Adaptation of SAM 2.1 for Building-Component Segmentation in Image-Based 3D Reconstruction
发表日期:
2026年10月
发表单位:
LSU Dept. Const. Mgmt., LSU Div. CS&E
原文链接: https://arxiv.org/pdf/2610.12786v1.pdf
建筑3D重建的痛点:为什么通用分割模型不够用
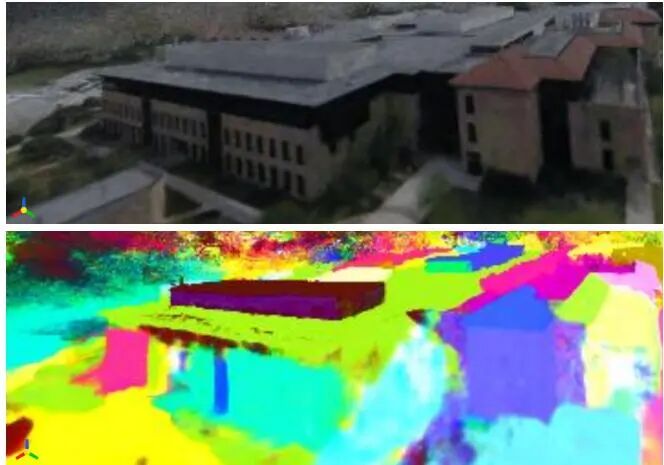
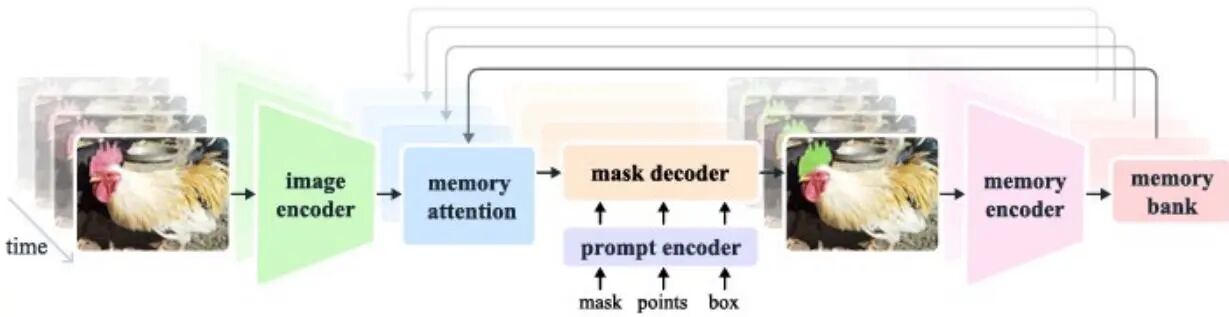
一栋楼站在那儿,几十米高,几千个构件。想把它搬进电脑,常见做法是让无人机绕着飞一圈拍上千张照片,再交给算法重建三维模型。这一步现在挺成熟:摄影测量(photogrammetry)能解出相机位姿和稠密点云,神经辐射场(Neural Radiance Field,简称NeRF)能学出一个可任意切换视角渲染的辐射场。几何这块,基本够用。真正麻烦的是另一件事:模型知道“这里有一块凸起的面”,但它不知道“这是一扇窗”。要把重建结果真用起来——做数字孪生、算工程量、做改造设计——就必须回答“哪块是墙、哪块是窗、哪块是屋顶”这样的语义问题,也就是建筑构件分割。本文要分的构件一共11类:Wall(墙)、Window(窗)、Ceiling(天花板)、Door(门)、Column(柱)、Beam(梁)、Floor(楼板)、Opening(洞口)、Curtain Wall(幕墙)、Roof(屋顶)、Lift(电梯)。作者的判断很直接:现成的分割模型不是为建筑准备的。YOLOv8走的是检测框那一套;SegFormer(一种基于Transformer的语义分割网络)只输出预先定义好的类别集合;SAM 3虽然能用文本提示做开放词汇分割,但3D重建需要的不是“按类别点名”,而是整张场景自动吐出掩码——只有掩码在全局范围保持一致,2D的分组结果才能在3D里被稳定地聚到一起。这里要交代两个基础模型。SAM(Segment Anything Model)是Meta AI提出的可提示分割视觉基础模型;SAM 2.1是它的图像加视频统一版本,架构由图像编码器(一个视觉Transformer)、提示编码器和掩码解码器三部分组成,用户给点、框或掩码提示,它就在图像或视频帧里把目标分割出来,训练数据是SA-V,包含5.09万段视频、64.26万个掩码片段(masklet)。另一个是GARField(Group Anything with Radiance Fields),它把2D分组掩码提升到3D,而它依赖的自动掩码生成器,需要覆盖不同尺度的掩码——同一扇窗,可能一张掩码框住整扇窗,另一些掩码只框住窗的一半。几个术语先垫一下。IoU是交并比,预测掩码与真实掩码的交集除以并集;Dice系数是两倍交集除以两个掩码面积之和;mIoU是按类别算完IoU再取算术平均,正因为按类平均,实例少的类才不会被数量多的类淹没。域适应(domain adaptation)指的是把在自然图像领域训好的模型,迁移到建筑图像领域继续训练,让它适应当地的数据分布。数据用的是Wong等人构建的HBD数据集,2,679张建筑内外景标注图像,覆盖42栋建筑,标注已划分好训练、验证、测试集。选它的理由很实在:这个数据集本来就是为建筑构件的3D重建准备的,注释覆盖大部分立面与室内,而不是随手抓一批街景图凑数。图1:由无人机图像重建的路易斯安那州立大学Patrick F. Taylor Hall。上图为渲染的照片视图;下图为同一视角下,用本文微调后的SAM 2.1完成建筑构件分割、再由GARField在3D中做层次化分组的结果,每个3D分组用不同颜色表示。
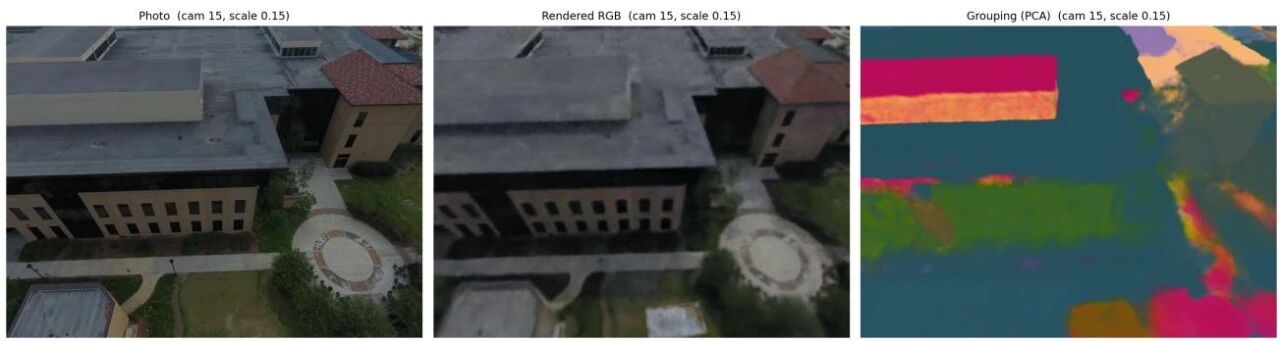
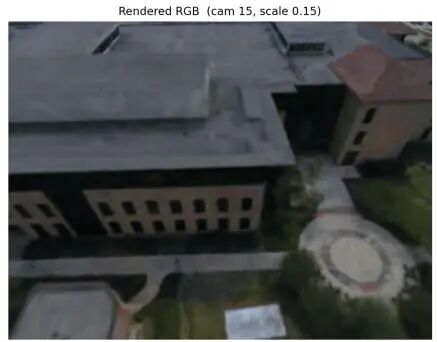
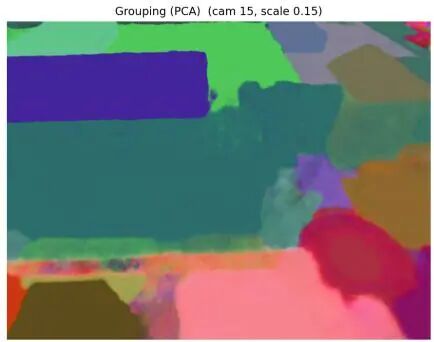
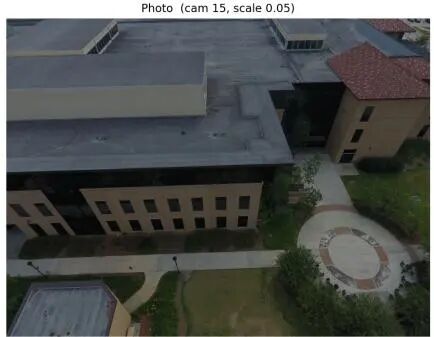
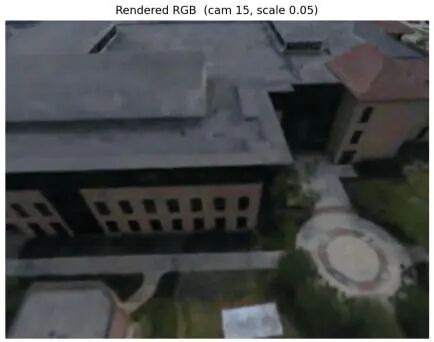
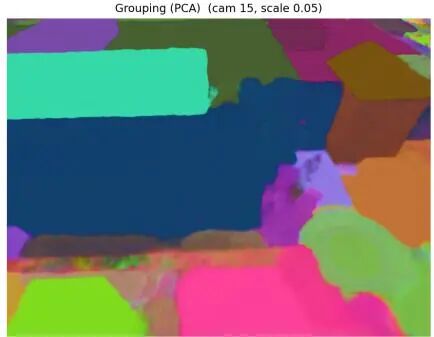
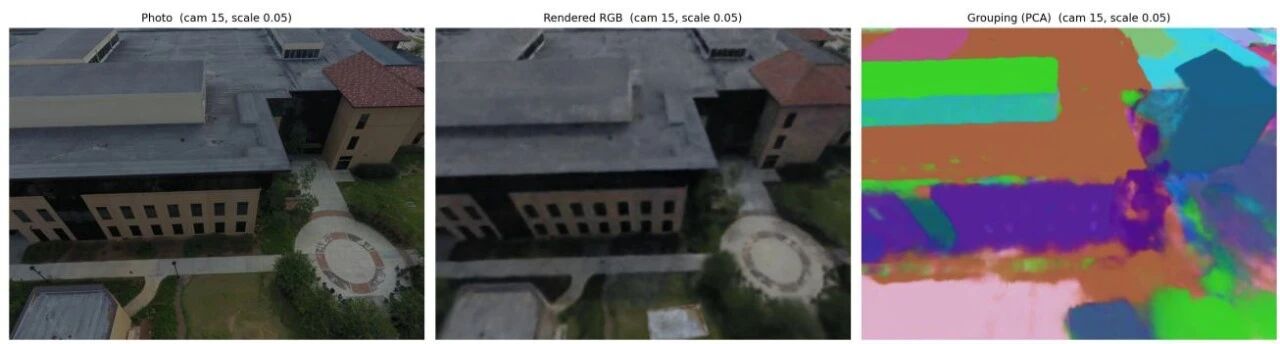
先补一句NeRF:它用一批带相机位姿的2D图像,学出一个三维辐射场,场里每个空间点带着颜色和密度,于是可以从任意新视角渲染图像。几何有了,但辐射场里没有“这是窗”这种语义。GARField的思路是把2D分组掩码蒸馏进3D,学一个尺度条件化的3D亲和场(scale-conditioned 3D affinity field):场里每个3D点都带一个高维特征向量,空间上属于同一构件的点,特征彼此接近;用户给一个分组尺度,算法就把亲和度足够高的点聚成一组。这个“尺度”是关键。尺度调大,窗、门、墙这些挨得近的构件会被合成一整片立面;尺度调小,一扇窗就是一扇窗,不会跟旁边的墙糊在一起。层次化分组本身是GARField的贡献,本文只是沿用并引用,它真正做的是换掉GARField背后的掩码生成器——把SAM 2.1塞进去,然后比较两种条件:预训练的SAM 2.1,和微调过的SAM 2.1。为了把“微调”这个变量单独摘出来,实验设计做得很干净:同一批图像、同一组相机位姿、同一个辐射场、同样的分组尺度和训练计划,GARField训练两次,唯一差别就是生成掩码用的SAM 2.1检查点。而且这一步的掩码是自动生成的(用点网格提示,没有任何真实标注引导),因为到了3D阶段,本来就没有标注可用。场景选的是路易斯安那州立大学的Patrick F. Taylor Hall,无人机拍了1,250张图,原始分辨率4000×3000,做重建时下采样4倍,等效分辨率1000×750;相机位姿和稀疏点云用COLMAP做运动恢复结构(structure-from-motion)得到。训练用nerfstudio搭建辐射场与GARField分组场,跑30,000步,硬件是一张NVIDIA GeForce RTX 4070 Ti(12GB显存),配Intel Core i9-13900K和128GB内存。评估方式是定性的:把分组场的逐点特征用PCA(主成分分析)降到RGB显示,和渲染图像并排放,看构件分组是不是更完整、更干净。这里有个细节得注意——PCA投影是每张图独立计算的,不同图之间的颜色不能直接比,能比的只有分组在空间上的一致性。图7(局部):固定视角下的输入照片。图7(局部):重建得到的RGB视图。图7(局部):GARField分组场经PCA投影到RGB后的可视化结果。图7(a):使用预训练SAM 2.1掩码,分组尺度0.15。图7(b):使用微调后SAM 2.1掩码,分组尺度0.15。图7(局部):分组尺度0.05条件下的场景视图之一。图7(局部):分组尺度0.05条件下的场景视图之二。图7(c)(d):分组尺度0.05下,预训练与微调后SAM 2.1掩码带来的3D分组对比。图7整体为Patrick F. Taylor Hall无人机场景在固定视角(相机15)、两个分组尺度下的定性分组结果;每行从左到右依次为输入照片、重建RGB、GARField分组场(PCA投影到RGB)。前两行分组尺度0.15,后两行0.05;(a)(c)用预训练掩码,(b)(d)用微调后掩码,两次训练配置完全相同,只差SAM 2.1检查点。从可视化上看,微调后的模型在屋顶和立面区域的分组更成块、更连续,而预训练模型会把一部分构件和邻近表面并到一起;这种差异在较粗的分组尺度上更明显,尺度变细之后就不那么突出了。论文自己也划了边界:这个实验是定性的,只能算示意性证据。
实验结果大揭秘:mIoU提升19.8个百分点的背后
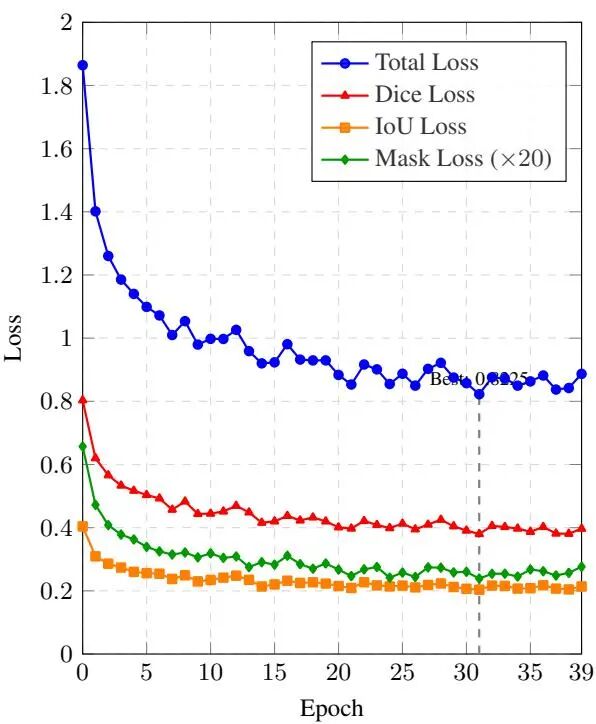
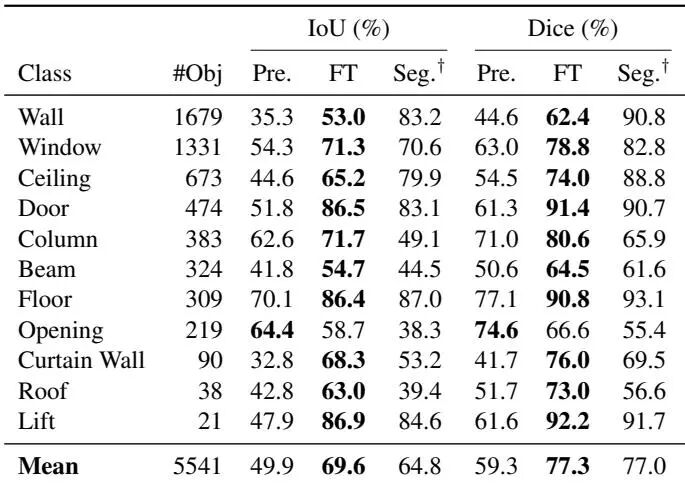
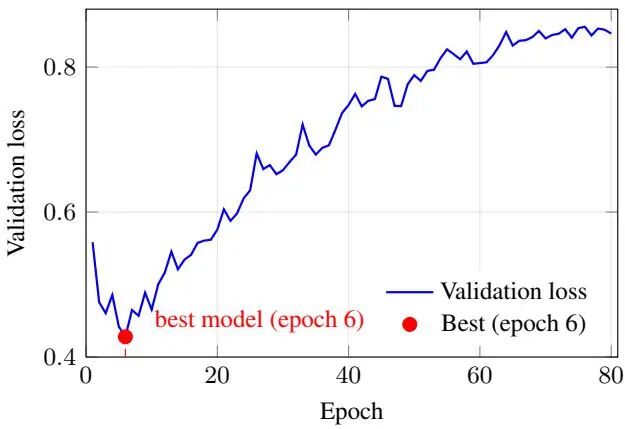
训练过程本身就是结果的一部分。总损失从1.864一路降到最低0.823,降幅55.9%,最低点出现在第31个epoch。这说明模型确实在往建筑这个领域收敛,而不是靠原有能力硬扛。图4:在HBD建筑立面数据集上微调SAM 2 Hiera-Large的40个epoch训练损失收敛曲线。总损失从1.864降到0.823(第31个epoch达到最低),降幅55.9%,说明模型成功适应了建筑领域;训练用了2,679张图像、4张NVIDIA A100、耗时18小时。测试集是349张图像、5,541个标注实例。在完全相同的中心点击提示协议下,微调把SAM 2.1的平均IoU从49.9%拉到69.6%,涨了19.8个百分点;平均Dice从59.3%提升到77.3%。11个类里,10个类都在涨。涨得最猛的是那些离SAM 2原有预训练领域最远的构件:幕墙涨35.5个点、门涨34.7个点、天花板涨20.6个点、屋顶涨20.2个点。高频结构类同样有明显提升,墙涨17.7、窗涨17.0。表1:HBD测试集上的逐类分割精度(349张图像、5,541个标注实例)。预训练SAM 2.1与本文微调后的SAM 2.1都用真实掩码导出的单次中心点击提示、按对象评分,加粗表示两者中更好的一个;SegFormer为全自动语义分割、自己预测类别并逐像素评分,仅作参考,不属于严格的同条件对比。分数按类别做宏平均。唯一没吃到红利的是洞口类,IoU掉了5.7个点。作者的解释是:洞口这种东西没有实体表面,空间范围本身就含糊,比如一个门洞、一条通道,边界在哪儿全靠约定;微调之后模型更倾向于把它并进周围的墙体。这个解释站得住——模型学到的是“建筑构件的实体表面”,而洞口恰恰不是实体表面。还有两处需要点名。一是即使微调之后,墙仍然是最难的类,IoU只有53.0%,大面积、弱纹理的表面靠单个点提示很难把边界划准。二是屋顶和电梯的实例数只有38和21个,样本太少,这两类的分数波动比较大,不宜过度解读。图5(a):微调后的SAM 2.1在Patrick F. Taylor Hall上的自动掩码生成结果,建筑立面、窗与地面的分离更清楚。图5(b):预训练SAM 2.1(Hiera-Large)在同一场景上的自动掩码生成结果,作为对照。评价协议的边界必须讲清楚:这里给的是单次中心点击提示,类别标签直接取自真实标注,所以测出来的是“在给定正确位置和类别的前提下,掩码画得好不好”,而不是“模型能不能自己找到并认对物体”。这两个问题的难度完全不是一回事😅。
SAM 2.1 Hiera-Large微调训练在4×NVIDIA A100 GPU上运行40个epoch(53,600步),耗时18小时5分钟。
复现难度:★★★☆☆
现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。
产品化成熟度:★★★☆☆
论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。
可能的问题:(1)3D分组评估仅为定性,缺乏定量指标;
主要参考文献
[1] Ehsan Agha Ebrahimi, Yong-Cheol Lee, Keith G. Mills. Domain Adaptation of SAM 2.1 for Building-Component Segmentation in Image-Based 3D Reconstruction. arXiv:2610.12786, 2026.[2] Nikhila Ravi, et al. SAM 2: Segment Anything in Images and Videos. arXiv, 2024.[3] Alexander Kirillov, et al. Segment Anything. arXiv:2304.02643, 2023.[4] Chung Min Kim, Mingxuan Wu, Justin Kerr, et al. GARField: Group Anything with Radiance Fields. arXiv, 2024.[5] Enze Xie, Wenhai Wang, et al. SegFormer: Simple and Efficient Design for Semantic Segmentation with Transformers. NeurIPS, 2021.[6] Alexander Wong, et al. HBD: A Building Dataset for Image-Based 3D Reconstruction(论文引用的建筑构件数据集).原文链接:https://arxiv.org/pdf/2610.12786v1.pdf
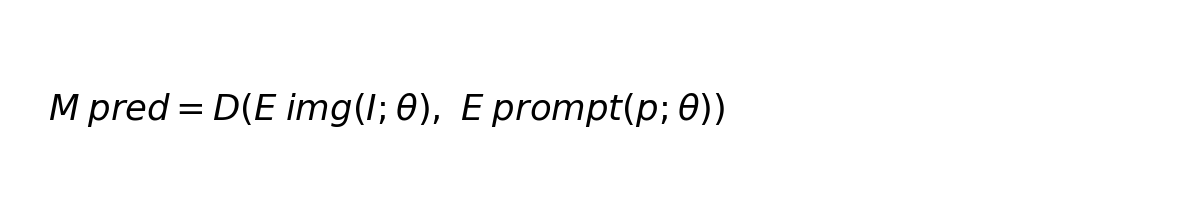
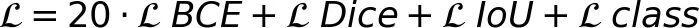

还没有公开留言,欢迎留下你的看法。