← 返回 PaperDaily
视觉与图像
齐鲁工大提出DiscoVL:参数砍55.7%,视觉语言模型反而更准
CLIP的提示学习已经被卷了三年,绝大多数工作都在往上叠模块;这篇先停下来问了一句:类特定判别信息和类无关的可迁移知识,是不是从一开始就被搅在同一个特征空间里?齐鲁工大等用解耦跨模态对齐器加正交对抗正则给出一种拆法,15个基准一致涨点,参数量还比上一版少了55.7%。涨点幅度不算炸裂,但这个诊断角度值得花时间读。
龙哥读论文
发布于 2026-10-16 01:12:05
阅读 12
查看原文
原论文信息如下:
过去三年,视觉语言模型的微调研究基本沿着一条很清晰的路径在走:先把主干冻住,再想办法在提示词上做文章,一层不够就加两层,一个模块不够就再堆一个模块。论文越写越长,模块图越画越密,最后的涨点却越来越像挤牙膏。
齐鲁工业大学(山东省科学院)山东省人工智能研究院与佛罗里达大学合作这篇 DiscoVL,难得地没有继续往上堆模块,而是回头问了一个更底层的问题:这些方法学到的特征里,到底混进了什么东西?这个问题问得有点刻薄,但也正是当前提示学习方法绕不过去的地方。
1 视觉语言模型微调的核心瓶颈:表示纠缠问题 要理解这篇论文在解决什么,得先把 CLIP 这套东西说清楚。CLIP 的全称是对比语言-图像预训练(Contrastive Language-Image Pre-training),它由两个编码器组成:一个图像编码器把图片压成一串特征,一个文本编码器把句子压成一串特征,训练目标是让配对的图文在同一个特征空间里靠得更近。这样训出来之后,分类任务可以变成"哪句描述和这张图更像"的问题,不需要专门训练分类头,这就是零样本分类的由来。
但零样本再强,落到具体业务上还是不够用。想让它认汽车型号、认卫星图像、认皮肤纹理,总得往下游数据上适配一下。于是有两条路:一条是全量微调,把所有参数都放开,效果通常最好,代价是显存和训练成本高得离谱,而且很容易把预训练时学到的通用语义"洗"掉,这就是常说的灾难性遗忘;另一条是提示学习(prompt learning),主干参数一动不动,只学少量的可训练 token,成本低、遗忘风险小,成了这两年参数高效微调的主流做法。
CoOp、CoCoOp、KgCoOp、MaPLe、PromptSRC、AAPL、MMRL 这一串方法,都是在提示学习这条主线上做微调。它们的共同思路是给提示加约束:用文本原型拉住,用手工先验拉住,用知识路由拉住,或者干脆叠好几个表示对齐器。听上去花样很多,但它们优化的其实是同一个纠缠在一起的特征空间
这篇论文把这个现象叫做表示纠缠(representation entanglement):一类是跟具体类别强相关的判别线索,决定"这张图是波斯猫还是暹罗猫";另一类是跟类别无关的可迁移知识,决定"这是一只猫,有毛、有耳朵、会看镜头"。在预训练阶段,这两类信息本来就是混在一起的,微调时如果只在同一个空间里加约束,就等于让两类信息互相污染:想让模型更会分辨细分类别,就会把那些通用的语义结构也一起挪动。
论文把这种纠缠带来的后果拆成三层。最表面的一层是特征漂移,类特定的适配把类无关的子空间污染了,导致表示偏离预训练特征,零样本迁移能力被一点点侵蚀。中间一层是跨模态的不一致,图像和文本各自的分布本来就不一样,把它们硬投影到同一个联合空间里做对齐,会忽略模态之间的分布差异,这种不一致还会随着层数加深被放大。最深的一层是表示 token 的坍缩,训练后期这些 token 会迅速向类中心聚拢,类无关结构被压平,新类上自然就分不开了。
所以这篇论文的定位不是"我又加了一个更好的模块",而是"你们优化的那个空间本身就是脏的"。它给出的解法是把适配后的表示空间显式拆成两块:一块是共享的、类无关的子空间,负责保留 CLIP 从四亿图文对里学来的可迁移语义;另一块是任务特定的子空间,只负责承接下游数据的判别线索。拆开之后,两类信息各走各的路,下游适配就不再需要拿通用能力去买单。
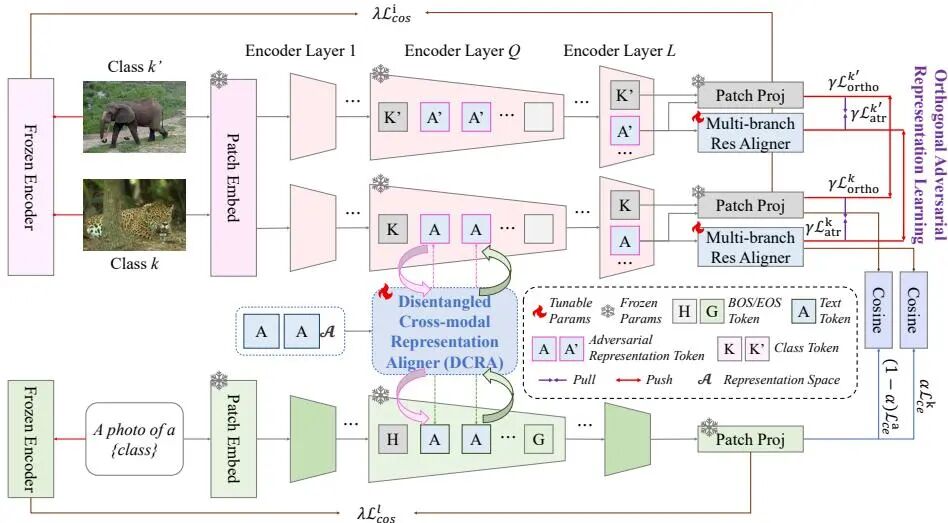
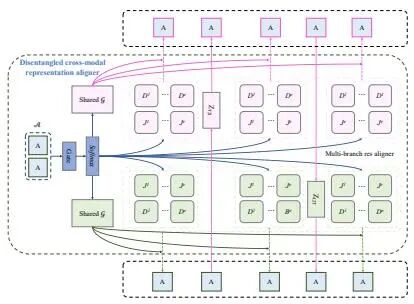
2 DiscoVL框架详解:解耦跨模态表示对齐器DCRA DiscoVL 的全称是解耦视觉语言模型(Disentangled Cross-Modal Representation Learning for Vision-Language Models),整体由两个模块撑起来:负责拆空间的解耦跨模态表示对齐器(Disentangled Cross-modal Representation Aligner,DCRA),以及负责守住类无关结构的正交对抗表示学习(Orthogonal Adversarial Representation Learning,OARL)。前者管"怎么拆",后者管"拆完之后别塌"。
先说 DCRA 要接的那个底子。它的出发点来自 MMRL(Multi-Modal Representation Learning),思路是在 CLIP 里额外插进一套可学习的表示空间:给一组表示 token,记作 A,维度是 M×d_a,M 是 token 数量,d_a 是表示空间的维度。这些 token 不会塞进所有层,而是从第 Q 层开始,通过轻量投影器映射到图像和文本各自的隐空间里,再注入到上层 transformer。低层保持冻结,是为了不破坏对比预训练学到的低层次先验;高层放开,是为了让高层语义能跟着下游任务走。
具体做法是把第 ℓ 层、模态 m 的投影权重 F 拆成两部分:一个跨层共享的核 F_shared,加上一个层特定的低秩残差 J 乘 D。这里 J 的维度是 d_a×a₁,D 是 a₁×d_m,a₁ 就是低秩分解的秩,取值小意味着残差部分的参数量被牢牢压住。共享核负责承载"所有层通用"的知识,残差负责吸收"这一层独有"的细节,两者相加就得到了完整的投影权重。
DCRA 的第二块设计是双向反馈。以往的多模态提示方法大多是单向的:文本提示影响视觉,或者视觉信息喂给文本,很少来回走。本文的做法是分层处理:在编码器栈的下半部分,把文本侧的表示经过投影 Z_T2I 融进视觉 token;到了上半部分,再把视觉摘要通过 Z_I2T 送回文本流。两个方向都受一个可学习的融合门 ρ(ℓ) 控制,这个标量决定当前层到底有多少比例的信息来自对侧模态、多少比例保留自己。
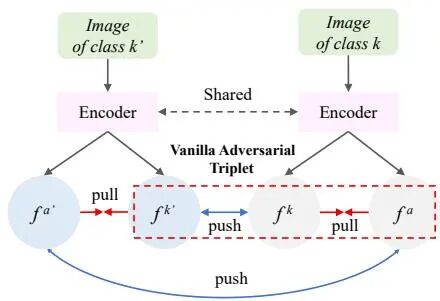
3 正交对抗表示学习OARL:防止token坍缩的关键机制 对抗三元组学习(adversarial triplet learning)不是本文首先提出的,它此前在 AAPL 等工作里就被用来分离类别语义,思路也比较直观:让图像特征和它自己对应的表示特征相互靠近,同时和不属于同一类的图像特征拉开距离。问题在于,只有一个"靠近加推开"的目标时,模型总会找到最省力的解,那就是把所有表示 token 都往类中心推。训练损失确实降下去了,可这些 token 之间原本还存在的那点结构差异也被抹平了,等到新类出现时,模型没有可用的类无关结构去支撑判断。
本文设计的三元组约束是跨类交互式的:给定一个属于类别 k 的图像特征作为锚点,正样本取同一类别的表示特征,负样本取另一个类别 k′ 的图像特征。损失形式上是一个带边距 m 的合页函数,只有当锚点到负样本的距离减去锚点到正样本的距离还不足 m 时,才产生梯度。这样做的目的是让图像特征和表示特征之间的语义关系既可对齐又可分离,而不是把所有东西压成一堆点。
真正撑起 OARL 的是正交正则这一项。本文给每个类别 k 构造一个矩阵 X,由该类对应的表示特征按 token 排布而成,维度是 M×d_i。然后用这个矩阵去算它自身的归一化外积,跟单位矩阵比对,取差值矩阵的弗罗贝尼乌斯范数(Frobenius norm,矩阵所有元素平方和的平方根)再平方,最后乘上一个正则系数 ζ。理想状态下,这个外积矩阵越接近单位矩阵,说明各维特征之间越互相独立。
训练阶段还有一个容易被忽略的不对称设计。本文同时优化类 token 和表示 token,但两者的分工不同:类 token 的投影用的是冻结的 CLIP patch 投影层,表示 token 用的是可训练的投影。为了不让类 token 在训练中被带偏,论文额外加了两个余弦一致性损失,一个约束图像侧更新后的类特征与冻结 CLIP 图像特征保持一致,另一个约束文本端 K 个类别的文本特征与冻结 CLIP 的文本特征保持一致。换句话说,模型允许表示 token 大胆适配下游数据,但要求类 token 不许走远。
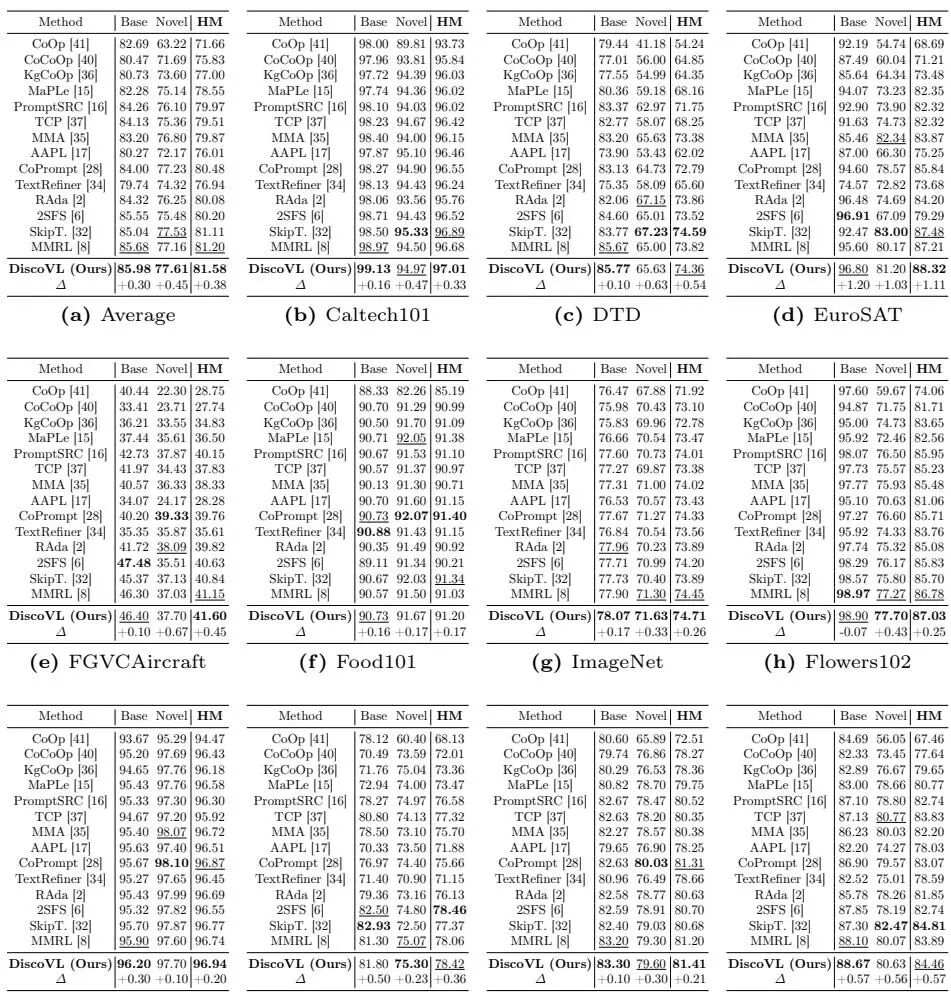
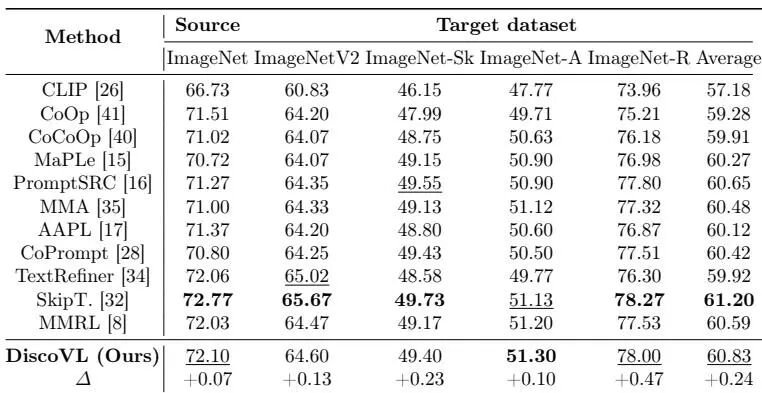
4 实验结果全面解读:15个基准上的表现 论文在四个任务、15 个基准上做了评测。前 11 个数据集覆盖了多种识别场景:ImageNet 和 Caltech101 是通用物体分类,Oxford-Pets、StanfordCars、Flowers102、Food101、FGVCAircraft 是细粒度分类,SUN397 是场景识别,UCF101 是动作识别,DTD 是纹理分类,EuroSAT 是卫星图像识别。域泛化任务另有四个 ImageNet 的变体,包括 ImageNet-V2、ImageNet-Sketch、ImageNet-A 和 ImageNet-R,它们跟 ImageNet 共享类别结构,但数据分布差异明显,专门用来测模型换个画风还认不认得出。
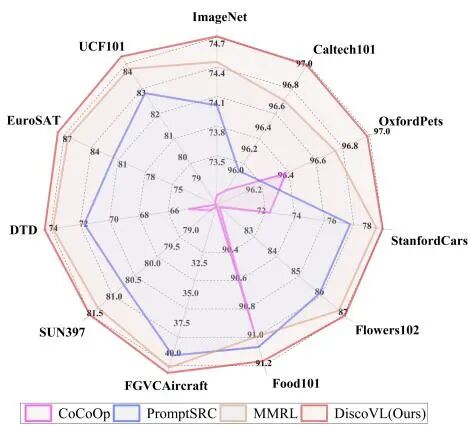
11 个数据集上的平均结果显示,本文方法的基类精度是 85.98,新类精度是 77.61,调和平均 81.58;上一版的 MMRL 对应数字是 85.67、77.16 和 81.20,三项分别提升 0.30、0.45 和 0.38。这个幅度需要说清楚:不是那种把榜单拉开一截的提升,而是稳稳压住、且在不同数据集上方向一致。对于已经卷到小数点后一位的提示学习赛道,稳定小幅进步本身就是比较难得的结果。
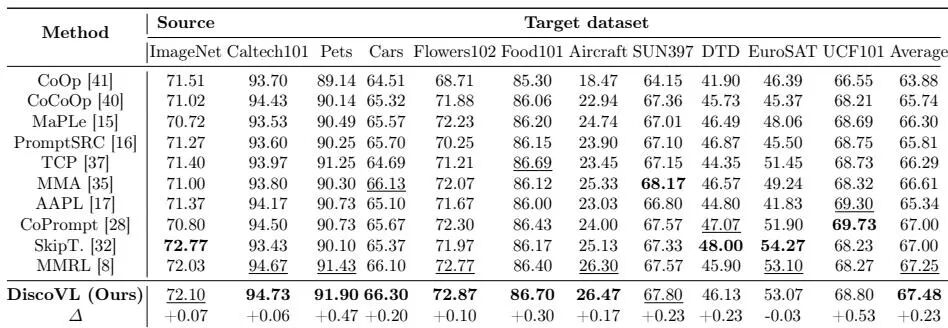
跨数据集评测是最能体现"解耦是否真起作用"的场景。训练在 ImageNet 上,测试换到其他数据集,如果模型在适配过程中把通用语义洗掉了,换域之后就会掉得很厉害。表 2 的结果说明这种跨域的迁移损失被控制住了,这跟论文强调的"类无关子空间被保护下来了"是一致的。
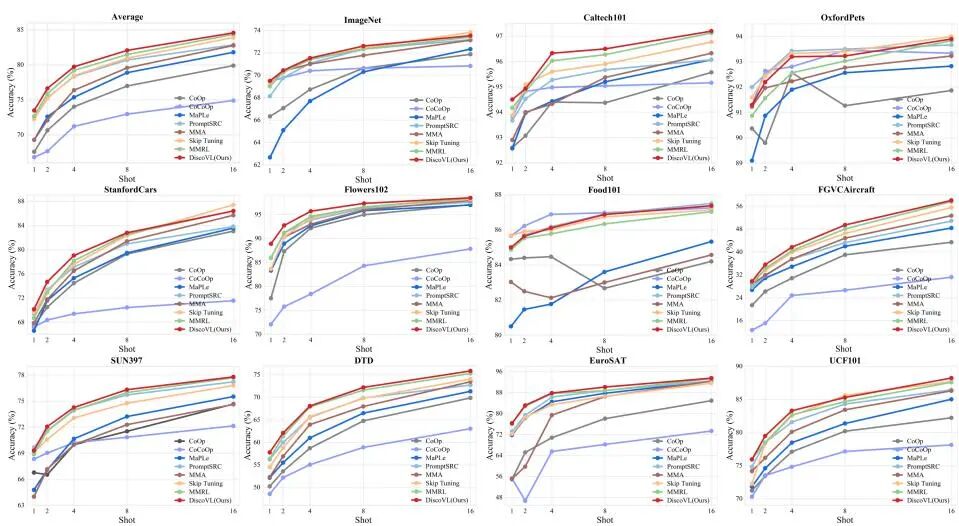
少样本这部分值得单独提一句。1 样本、2 样本、4 样本这类极端设置下,模型的自由度本来就少,稍有过拟合就露馅。本文方法在少样本上的表现,比它在全量基类上的提升更有说服力,因为它说明解耦并没有靠"多看数据"换性能。
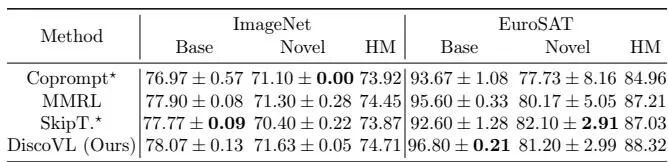
稳定性这个维度经常被论文们选择性忽略,毕竟只报一次最好结果最省事。这篇论文专门做了重复实验并给出标准差,态度上算是比较老实的。对抗三元组这类基于距离的约束,本身就容易在不同随机初始化下走出不同的坍缩模式,能把方差压住,说明正交项确实在管着这件事。
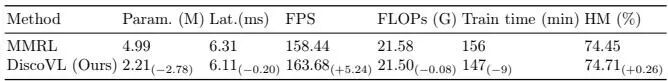
效率方面,论文给出的对比说明这套设计并没有用参数量去换精度:低秩分解把残差部分压得很小,多分支之间共享输入输出维度,整体可训练参数比此前的对齐器方案明显更少,单张消费级显卡就能跑完训练与评测。这一点对想在实验室里复现的学生团队来说很友好,模型选择和硬件门槛都被拉低了。
龙迷三问 这篇论文到底在解决什么问题? 视觉语言模型微调时,类特定判别与类无关迁移知识挤在同一特征空间,越调越容易忘。齐鲁工大等提出DiscoVL,用解耦跨模态对齐器与正交对抗正则分开两类表示,15个基准一致涨点,参数量反降55.7%。这篇工作最值得看的点是什么? 在base-to-novel泛化任务上,平均HM达到81.58%,超越之前最佳MMRL的81.20%,提升0.38%。在11个基准中7个取得最佳HM。跨数据集评估平均准确率67.48%,超越MMRL的67.25%。域泛化平均准确率60.83%,超越PromptSRC的60.65%。少样本学习在1/2/4/8/16-shot设置下均取得最佳性能,16-shot达到84.58%。训练稳定性优于MMRL,参数量减少55.这篇工作的边界或风险在哪里? 优点:(1) 首次将表示解耦引入VLM prompt learning,思路新颖;(2) DCRA多分支残差对齐器和双向反馈机制设计精巧,能有效融合跨模态信息;(3) OARL通过正交对抗正则化防止token坍缩,理论支撑充分;(4) 参数量少、效率高,在多个基准上取得一致提升;(5) 解耦分析实验设计完善,验证了子空间分离的有效性。缺点:(1) 提升幅度较小,部分数据集上优势不明显;(2) 超参数较多(α, β, γ, E, Q, M等),调参成本高;(3) 仅在ViT-B/16上验证,未测试更大模型;(4) 未与所有最新方法在所有数据集上全面比较;(5) 双向反馈的门控机制解释性不足。如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~
龙哥点评 论文创新性分数: ★★★☆☆
把表示纠缠立为根本瓶颈这个切入角度有新意,DCRA 与 OARL 的组合也算扎实,但模块本身是低秩分解、门控、三元组、正交正则这些已有组件的重新编排,属于思路层面的创新多于组件层面的创新。实验合理度: ★★★★☆
四个任务、15 个基准,还额外做了训练稳定性和效率对比,消融覆盖组件、损失项、超参、分支数、融合权重、可分离性和分支干预,完整度在同类论文里偏高。扣分点在于对比方法多为前作报告数字,缺少统一重跑。学术研究价值: ★★★☆☆
把"解耦"作为提示学习的一个明确诊断框架提出来,对后续研究有启发意义,尤其是那套可分离性度量方式,可以迁移到其他多模态适配工作中去。但它更多是完善现有范式,而不是开辟新赛道。稳定性: ★★★☆☆
论文给出了多次重复实验的均值与标准差,比只报单次结果的做法诚实;正交正则也确实在抑制坍缩。但超参多、敏感度高,换个主干或数据集是否需要重调,论文没有回答,因此不能算高枕无忧。适应性以及泛化能力: ★★★★☆
通用物体、细粒度、场景、动作、纹理、卫星图像都测了,还覆盖了四个分布偏移变体和少样本设置,泛化面铺得比较宽,这是本文相对突出的地方。硬件需求及成本: ★★★★☆
低秩分解加共享核的设计把可训练参数量压了下来,论文的效率对比是在单张 RTX 3060 上完成的,这意味着高校实验室和中小团队都能玩得起。训练时间相比更重的对齐器方案也有优势。复现难度: ★★★☆☆
论文把训练流程整理成了伪代码,公式和超参说明都比较完整,主干用的是公开的 CLIP,数据集也全是标准基准。但正文中没有看到代码或模型的公开链接,多分支加双向反馈的实现细节偏多,从零复现需要不少时间。产品化成熟度: ★★★☆☆
它解决的是适配阶段的表示质量,部署时仍然沿用 CLIP 的推理流程,没有额外的在线开销,这点对落地友好。但方法是面向小样本适配场景的,需要离线训练与调参,且性能优势只有零点几个百分点,在很多业务里未必能覆盖调参成本。可能的问题: 诊断漂亮,改造克制,涨点温和。把表示纠缠讲清楚是加分项,但零点几个百分点的提升配上五个以上需要调的超参,性价比需要读者自己权衡;另外解耦的直接证据仍以间接指标为主,共享子空间到底装了什么,论文没有给出令人信服的语义层面的回答。
主要参考文献
[1] Dong M, Li J, Li F. DiscoVL: Unveiling Disentangled Cross-Modal Representation Learning via Orthogonal Adversarial Regularization for Vision-Language Models. arXiv:2610.11113. [2] Radford A, et al. Learning Transferable Visual Models From Natural Language Supervision (CLIP). ICML 2021. [3] Zhou K, et al. Conditional Prompt Learning for Vision-Language Models (CoCoOp). CVPR 2022. [4] Khattak M U, et al. Self-Regulating Prompts: Foundational Model Adaptation without Forgetting (PromptSRC). ICCV 2023. [5] Zhu Y, et al. AAPL: Adding Attributes to Prompt Learning for Vision-Language Models. CVPR 2024. [6] Zhang Y, et al. MMRL: Multi-Modal Representation Learning for Vision-Language Models. CVPR 2025. 原论文链接:https://arxiv.org/pdf/2610.11113v1.pdf *本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击 "阅读原文",
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击 "阅读原文", 查看更多原论文细节哦!
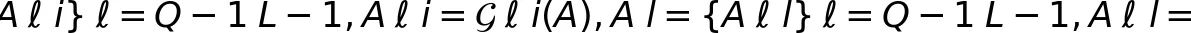
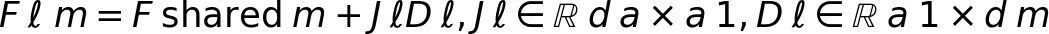
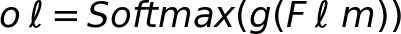
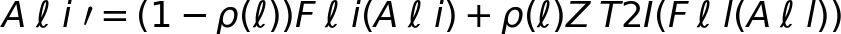
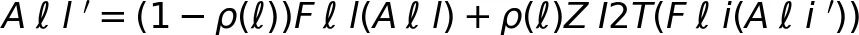
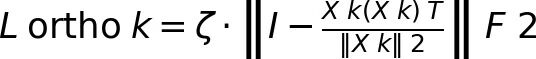
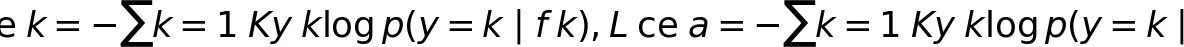

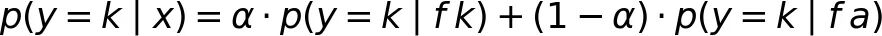

还没有公开留言,欢迎留下你的看法。