← 返回 PaperDaily
大模型与智能体
纽伦堡技术大学实测40个德语语音识别模型:分词器胜负由词汇量决定
现代端到端语音识别系统(ASR,Automatic Speech Recognition,自动语音识别)的结构很像一条两段式流水线:前面是自监督预训练出来的声学编码器,负责把声音变成表征;
龙哥读论文
发布于 2026-10-16 01:12:05
阅读 14
查看原文
原论文信息如下:
德语语音识别分词器怎么选?40个模型告诉你答案 现代端到端语音识别系统(ASR,Automatic Speech Recognition,自动语音识别)的结构很像一条两段式流水线:前面是自监督预训练出来的声学编码器,负责把声音变成表征;后面挂一个输出分词器(tokenizer),决定网络最终要预测哪些单元。这个分词器不是装饰品,它一次性锁死了三件事:网络能吐出哪些字符串、CTC(Connectionist Temporal Classification,连接主义时间分类)目标要对齐多少个目标单元、以及遇到训练时没见过的词形时模型会以什么姿势崩掉。
行业默认已经收敛到了两个选择。一个是数据驱动的 BPE(Byte Pair Encoding,字节对编码),拿训练转写文本自己学合并规则;另一个是预训练模型自带的多语言字符表。这两条路的共同点是:都语音学无感知
德语是个天然测试场:构词极其丰富(复合词一大堆、屈折变化多),方言变异大,而且域外语料的结构和域内完全不一样——既有跨九个方言区的自发语音,也有标准德语的自发谈判对话。于是这篇来自纽伦堡技术大学(Technische Hochschule Nürnberg Georg Simon Ohm)的论文问了一个很朴素的问题:那些对齐了音节和音素结构的“语音学先验”分词器,能不能打得过 BPE 和字符表?
作者的做法非常“暴力美学”:一口气训练了 40 个 CTC 微调模型
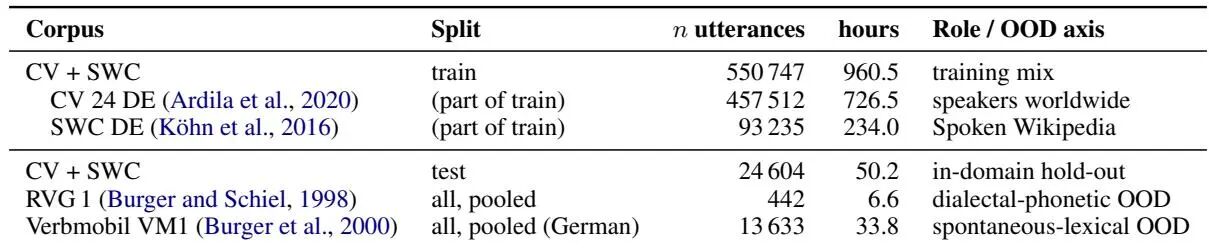
训练数据是 961 小时的德语混合集,由 Common Voice 24 德语部分(726.5 小时)和 Spoken Wikipedia Corpus(234 小时)组成。测试则用了三个结构上明显不同的集合:同分布的 CV+SWC 留存测试集,以及两个域外语料 RVG 1 和 Verbmobil VM1。RVG 1 是跨九个德语方言区录制的自发语音,它变化的是语音实现,底层词库大体上还是共享的;Verbmobil VM1 是标准德语的谈判对话,语音规范没变,但塞进了大量训练时没见过的词形——犹豫填充词、自我修正、口语缩略、话语助词。一个考音素鲁棒性,一个考词汇覆盖度,方向正好垂直。
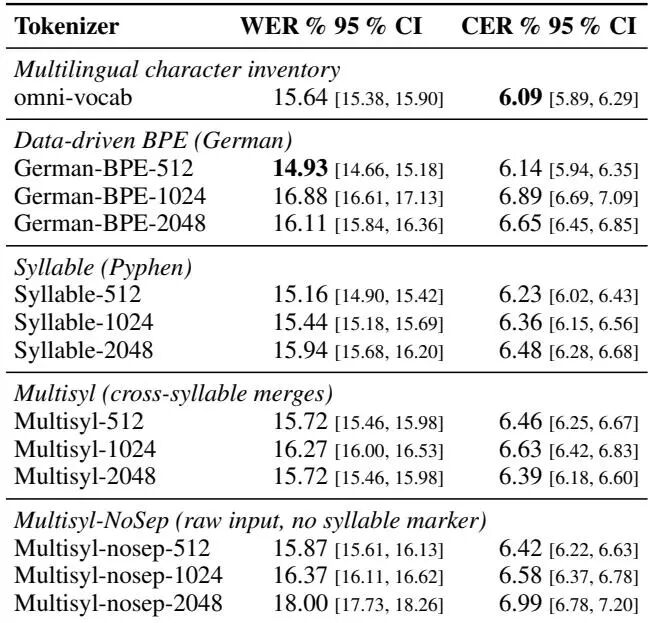
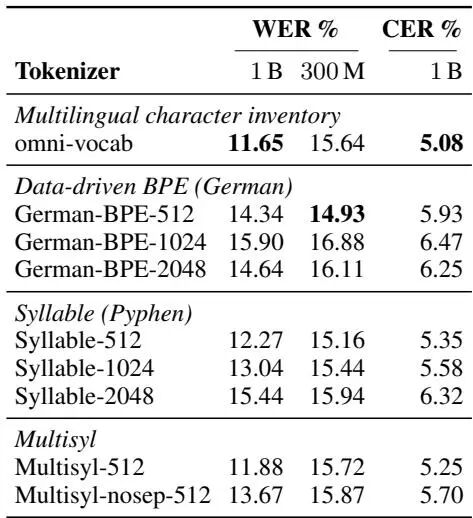
域内的结果先给一颗定心丸。300M 规模的 13 个正字法分词器里,WER(Word Error Rate,词错误率)的跨度是 14.9% 到 18.0%,最好的 German-BPE-512 是 14.93%,最差的 multisyl-nosep-2048 是 18.00%。但置信区间的半宽只有 0.25 到 0.27 个百分点,而且重叠得厉害:German-BPE-512、syllable-512、omni-vocab、syllable-1024 以及 512 词表下的多音节变体,在 WER 上统计上根本分不出高下
也就是说,在没有分布偏移的情况下,语音学先验不但没有帮忙,也没有拖后腿——它就是个“零代价”选项。这个结论看起来平淡,但它恰恰是后面所有反转的前提:如果域内就已经分出胜负,那跨域比较就没什么信息量了。
从音节到音素:语音学先验知识能否打败BPE 要理解这篇论文的设计,得先把六类分词器分清楚,因为它们的差别不只是“粒度”,而是选择在哪条边界上切
OMNI-VOCAB
GERMAN-BPE
SYLLABLE-k
MULTISYL-k
MULTISYL-NOSEP-k
音素轨
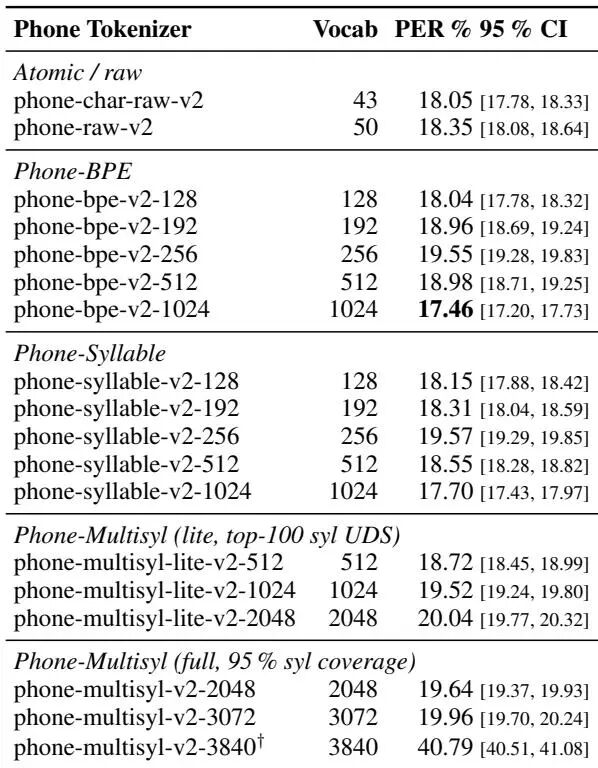
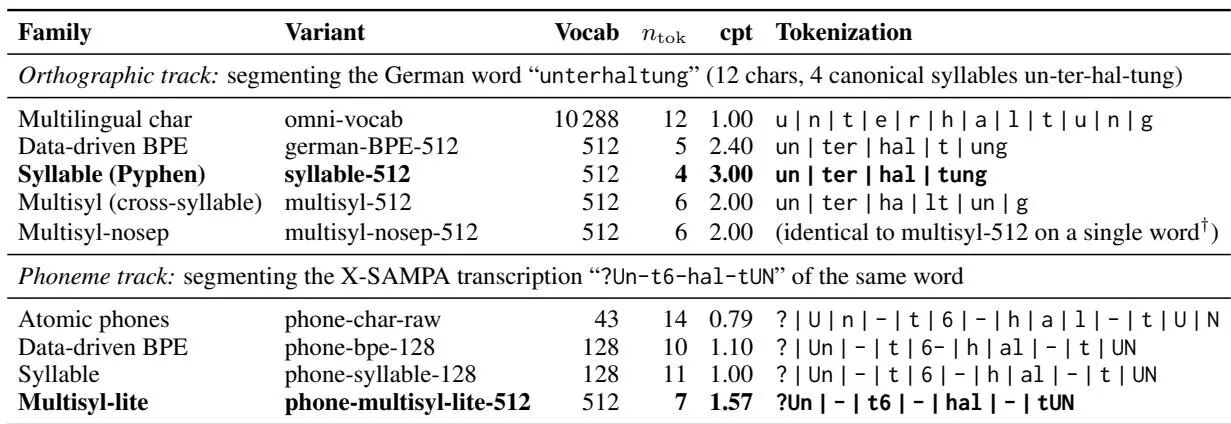
这些分词器到底差在哪?论文用德语单词 Unterhaltung 做了一个很直观的对照。这个词 12 个字符、四个规范音节 un-ter-hal-tung,X-SAMPA 转写是 ?Un-t6-hal-tUN。omni-vocab 老实切成 12 个字符,一个音节都不认识;german-BPE-512 靠数据自己学出了 un、ter、hal 三个,但把后缀 tung 拆成了 t|ung;multisyl-512 切得更碎,挑的是一些音位配列上更合理的簇,并且允许跨音节合并;只有 syllable-512 把四个规范音节完整还原成四个 token。音素轨上情况类似,phone-multisyl-lite-512 是唯一把四个 SAMPA 音节都当成单一 token 的配置。
把编码器放大到 1B 之后,域内的排序出现了第一次反转,而且反转得相当干脆。300M 时 German-BPE-512 还领先,1B 时它掉到了后面:omni-vocab 拿下 11.65%,multisyl-512 是 11.88%,syllable-512 是 12.27%,而所有 German-BPE 变体最好也只有 14.34%。语音学先验在更大模型上不但站住了,还反超了数据驱动的 BPE。这个现象本身值得琢磨:小模型时,参数预算紧张,BPE 用更高的压缩率换来更短的序列、更好学;大模型时,学得动更细的目标序列了,音节这种“结构先验”的收益才显现出来。
域外测试大揭秘:方言和自发语音下谁更强 真正的分水岭在域外。这里要先说清楚两个语料的差别,因为后面所有结果的解释都建立在它俩的正交性上。
RVG 1 是跨九个德语方言区的自发语音,同一个词在不同方言里被念成不同样子,但底层词库大体共享,考的是音素层面的鲁棒性;Verbmobil VM1 是标准德语的谈判对话,发音没变,但词法材料全新,考的是词表覆盖。两者都提供平行参考层,这也是为什么论文要区分着报:ORT 层是规范正字法,TR2 层带方言和韵律标注,同一段语音在两套参考答案下会得到不同的分数。
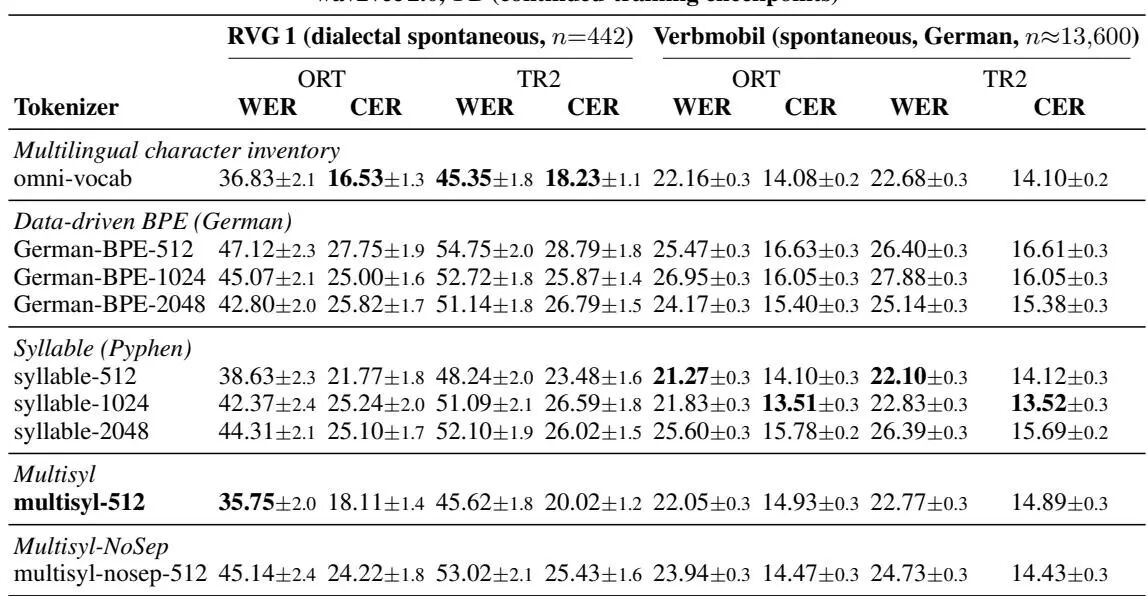
在 RVG 1 的 ORT 层上,multisyl-512-1b 拿到最低 WER 35.75%,排第二的是 omni-vocab-1b 的 36.83%,syllable-512-1b 以 38.63% 排第三。CER 上 omni-vocab 反超,16.53% 对 multisyl-512 的 18.11%。有意思的是换到 TR2 层,两个系统的差距就消失到统计上看不见了(45.62% 对 45.35%)。
在 Verbmobil 上画面更平。ORT 层最低 WER 是 syllable-512-1b 的 21.27%,多音节的 multisyl-512-1b 是 22.05%,omni-vocab-1b 是 22.16%,后两者统计上无法区分;CER 上 syllable-1024 最强,13.51% 对 omni-vocab 的 14.08%。所有 German-BPE 变体和 syllable-2048 全部落在 24.17% 到 26.95% 之间,落后领头羊至少 2 个百分点。TR2 层的排序和 ORT 完全一致,只是整体高出 0.5 到 1 个百分点。
作者对这两个现象给了各自的解释。在方言场景里,每个方言都把规范音节实现得略有差异,音节级的 CTC 目标可能促使编码器去学习那些跨语音变异更稳定的音节对齐表征,而字符级的多语言基线必须为每个字符去协调所有变体发音。这个解释有一处反证:优势只出现在 ORT 层,到了语音更忠实的 TR2 层就统计上消失了,说明这个音节红利是依赖于规范正字法参考的。论文也很克制,明确说要做表征层的诊断实验(比如音节边界的诊断分类器)才能验证,留给未来工作。
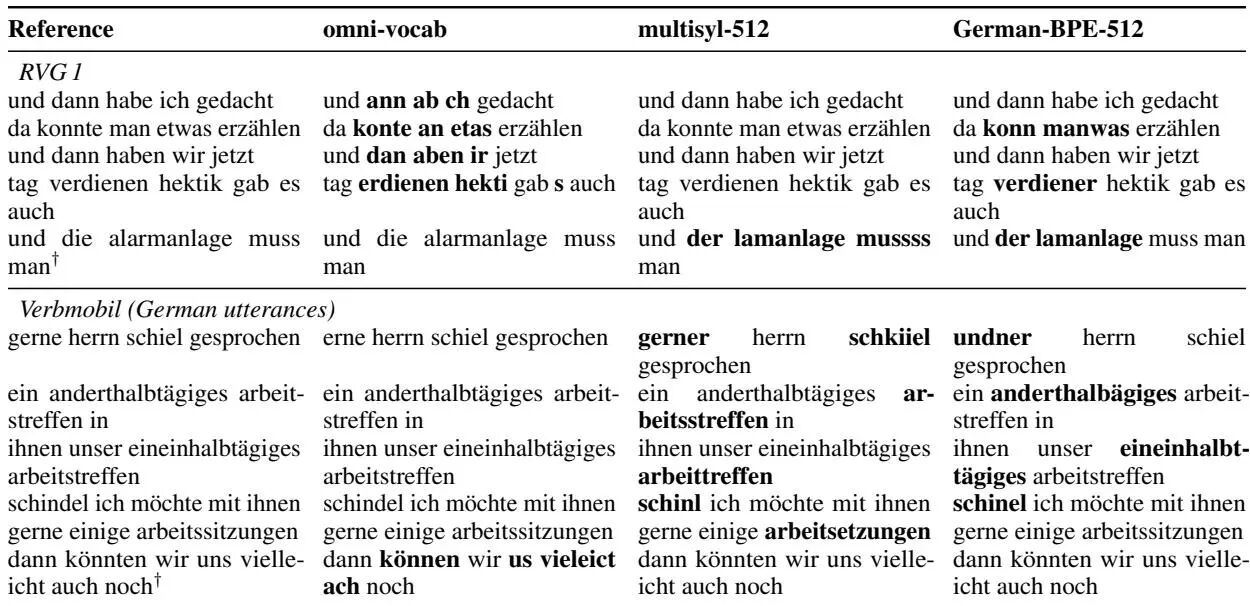
在 Verbmobil 上,位移来自新词法材料而不是语音变异:犹豫词“Em”“naja”,口语化的动词拼写缩短(比如把“müssten”写成“müsten”),还有各种话语助词。字符分词器没有词表外问题,音节或 BPE 词表碰上这些没见过的词形则会级联替换。一个解释(论文自己也强调这与词表类型是混淆的)是更细的词表在整词匹配失败时有更多恢复路径:omni-vocab 在测试数据上平均每个词吐约 6.9 个 token,multisyl-512 只有约 4.5 个。但字符词表也有自己的失败模式——它会把弱化的功能词照字面转写出来,两种错误在总 WER 上大体互相抵消,所以最后是两个系统打平而不是一方碾压。
为了给读者一个绝对尺度,论文还引了两个在数据量上高出两到三个数量级的系统:Whisper-large-v3 在同一测试集上域内 WER 是 11.4%,Parakeet-TDT-v3 是 11.9%,与本文最好的 1B 微调(11.7%)统计上打平;但到了域外,它们领先 5 到 20 个百分点。作者明确说明这组数字只作背景参考,训练数据规模与分词器这个问题本身是正交的。
龙迷三问 这篇论文到底在解决什么问题? 纽伦堡技术大学用40次CTC微调横向对比德语语音识别分词器,发现音节与音素等语音学先验在域内不输BPE,域外小词汇量占优,胜负随词汇量反转。这篇工作最值得看的点是什么? 域内所有语音学信息分词器与BPE和字符基线在WER和CER上无显著差异;域外方言语音上multisyl-512在ORT层达到最低WER 35.75%,音节感知分词在小词汇量下优于BPE;域外自发语音上syllable-512达到最低WER 21.27%;词汇量增大到2048时优势反转。音素混淆分析表明所有分词器的错误模式高度一致,编码器主导错误拓扑。这篇工作的边界或风险在哪里? 优点:系统性强,40个模型覆盖广泛的分词策略和词汇量;跨域评估设计精巧,两个OOD语料分别探测语音和词汇变化轴;统计检验严谨;发现词汇量而非偏移类型决定分词器优势的交互效应具有实践指导意义。缺点:最大模型仅1B参数、961小时训练数据,与工业级系统差距大;音素混淆分析在词级而非原子音素级进行;仅限德语,跨语言泛化未知;未探索LM重打分与分词器的交互。如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~
龙哥点评 论文创新性分数: ★★★☆☆
40 个微调的对照矩阵和“词表规模×分词策略”交互的发现是扎实的贡献,但音节分词本身不是全新概念,跨语言先例已存在,创新更多体现在实验设计与拆解方式上。实验合理度: ★★★★☆
控制变量做得相当干净:同一编码器、同一数据、同一学习率、同一音频预算与步数,连随机种子都锁死。配对自助法与 Bonferroni 校正在 ASR 分词器研究里并不常见,值得肯定。扣的一星在于音节优势卡在显著性边界,结论的强度被作者自己诚实地标注了。学术研究价值: ★★★★☆
它把“分词器到底重不重要”这个问题从经验之争推进到了有量化边界的状态,而且明确给出了负结果(域内无差异)和反转现象,这类结论对后续研究的校准价值往往高于又一个 SOTA。稳定性: ★★★☆☆
效果本身有统计支撑,但增益幅度小、受词表规模强烈调节,且只在特定参考层(ORT)上出现。这不是一个拿来即稳的收益,换语料、换参考规范都可能衰减。适应性以及泛化能力: ★★★☆☆
论文只覆盖德语,音节先验依赖 Knuth–Liang 断词算法对德语的适配度,音素轨依赖 MaryTTS 发音词典。作者另换了一个骨干网络(mHuBERT-147)验证结论一致性,这一点加了分;但换语言、换书写系统是否成立,目前没有证据。硬件需求及成本: ★★★☆☆
训练侧成本极高,40 个完整微调加上 1B 规模继续训练,不是小团队能随手复现的。推理侧则取决于词表与分词粒度:小词表的音素轨配置反而更省,43 个原子的音素字符表就是一个很有性价比的选择。复现难度: ★★★☆☆
方法描述足够细,分词器构造、损失、优化器、批预算都写清楚了,第三方资源(SentencePiece、Pyphen、Phonetisaurus、MaryTTS 词典)也都是公开的。主要门槛是算力:复刻 40 个微调的训练预算,绝大多数实验室扛不住。产品化成熟度: ★★☆☆☆
这篇论文的价值在于提供选型判断依据,而不是交付一个可直接上线的分词器。真要落地,还需要补上语言模型重打分、真实业务音频上的验证,以及分词器与解码器级联后的端到端延迟评估。可能的问题: 全文不含外部语言模型,这与工业部署的常态相去甚远,分词器—语言模型交互可能彻底改变结论;且增益幅度多在 1 个百分点量级、部分卡在显著性边界,说服力有限。
主要参考文献
Christopher Witzl, Tobias Bocklet, Korbinian R
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击 "阅读原文", 查看更多原论文细节哦!

还没有公开留言,欢迎留下你的看法。