← 返回 PaperDaily
大模型与智能体
大语言模型|维也纳工大:给MoE专家路由做「翻译」,准确率涨65%
MoE模型火了好几年,可「专家到底在干嘛」一直没人说清。主流解释是每个专家管一个领域,但真去翻,翻不出来。维也纳工大等提出RouterInterp,用稀疏自编码器给出另一种答案:专家干的是「多份不相关特征的叠加活儿」。这个结论有点反直觉,但证据挺扎实。
龙哥读论文
发布于 2026-10-16 01:12:05
阅读 12
查看原文
原论文信息如下:
MoE路由真的可解释吗?一个被忽视的假说 MoE(Mixture of Experts,混合专家)是大模型扩容的标准动作。稠密(dense)的transformer里,每个token都要过全部参数;而MoE层把原本一个前馈网络FFN(Feed-Forward Network,前馈神经网络)拆成E个平行的专家网络,再用一个路由器(router)为每个token在每个层里挑出top-k个专家来处理。按Shazeer等人2017年、Liu等人2024年的结论,稀疏MoE每次只激活2%–15%的参数,参数量猛涨,推理开销和延迟却几乎不涨。
业内流传最广的解释是专业化:每个专家各自啃下输入分布里的一块,或者只承担某几类计算。本论文把这个解释正式命名为专业化假说(Specialisation Hypothesis)。
专业化假说:稀疏MoE之所以有效,是因为不同专家分别专精于输入数据分布的不同部分或不同类型的计算,让每个输入只需要一小部分参数就能被处理好。
这个解释听起来天经地义,还自带一个大方的好处:如果专家真的按领域分工,那路由决策应该天然是「人话可读」的。某个专家专管医学文本,进去就贡献医学知识和推理;另一个专家管数学推导;还有一个写故事或者翻罗曼语系语言。多好懂。
现实比较打脸。Jiang等人2024、Lewis等人2021、Zoph等人2022等一批工作反复翻专家,想找出清晰可读的专精模式,结果大都不了了之。翻出来的是一堆东一榔头西一棒子的token,很难说清这个专家到底「管什么」。🤨
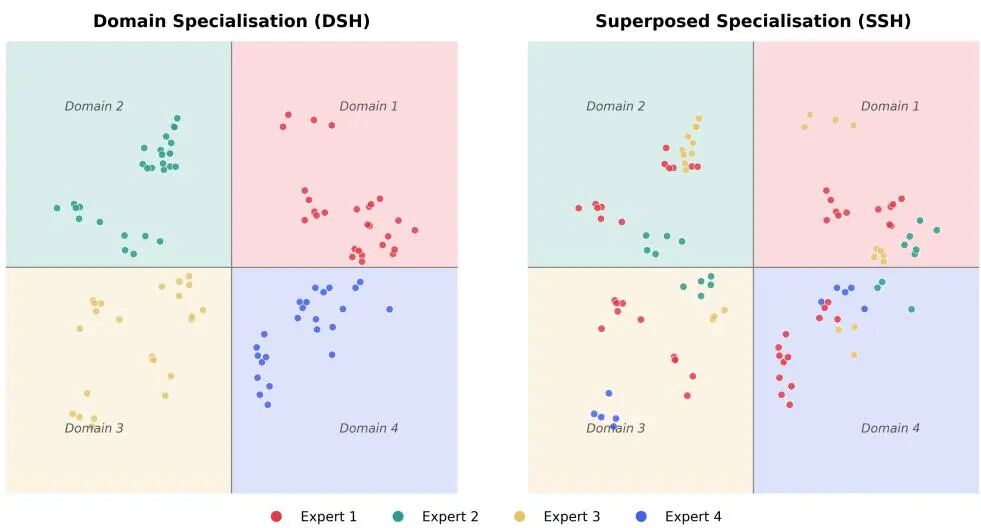
本论文给出的判断是:问题不在方法,而在假设本身。作者把「专业化假说」一分为二,拆成两条互斥的解释。
领域专业化假说(DSH,Domain Specialisation Hypothesis):
叠加专业化假说(SSH,Superposed Specialisation Hypothesis):
为什么会有第二条?看数据粒度就明白了。真实语料里的细粒度类别——具体话题、句法结构、推理模式——数量远远多于任意一个MoE层的专家数。按鸽笼原理(Pigeonhole Principle,也译抽屉原理),多个这样的微领域(micro-domain,指某一领域内部更细粒度的特征类别)必然被塞进同一个专家。既然如此,关键问题就变成:被塞到一起的微领域,是「像的凑一块」(DSH),还是「不像的硬拼」(SSH)。
论文的贡献可以概括成三件事:提出叠加专业化假说(SSH),即专家专精的是一堆语义异质特征的不相交集合,而不是单一连贯领域;给出两条理论论证说明为什么现实中会这样;并且拿出实证——最能预测某个专家激活的稀疏自编码器特征,彼此之间并不属于同一个语义领域。
从单义到叠加:专家到底在学什么 要验证这两条假说,得先找到一种能把「细粒度特征」拎出来的工具。这里绕不开两个基础概念:叠加(superposition)和稀疏自编码器(SAE,Sparse Autoencoder)。
先补两个基础概念
解释语言模型激活值有个老大难:模型要表达的特征数量远多于它拥有的维度数,于是同一个神经元会对好几个互不相关的概念同时响应,这就是多义(polysemantic)神经元。Elhage等人2022年提出的叠加理论,说的就是模型把多个特征「叠」在同一组神经元上表达。SAE的思路是反着来:既然压得太狠,那就先解压。它把激活向量 x ∈ ℝN 映射到一个更宽但稀疏的隐空间 z ∈ ℝF(F > N),理想情况下每个非零的隐单元(latent,也常直接叫作特征)对应一个单义的概念。
本论文采用的是Gao等人2025年的Top-K SAE方案,也就是把 σ 取成 TopK(·, s):每个输入只保留最大的s个激活,其余全部清零,保证隐表示足够稀疏。这个s就是后文反复出现的稀疏度参数。
另一边是MoE本身。一层标准MoE里,路由网络先算出路由logit h(x) = Wr·x,再经softmax得到每个专家的选择概率。
两条假说,两种预测
论文把这件事形式化了一下。假设一层有E个专家,语料里出现了D个微领域。当 D = E,两边预测一致:一个专家对一个微领域。当 D < E,也会出现多个专家共享同一微领域,或者存在从不被路由的冗余专家,同样无法区分。真正有意思的是 D > E 这个现实场景:此时多个微领域必须挤进同一个专家,问题只剩一个——挤进去的是相似的还是不相似的。
DSH的预测是:专家专精可以用单一(单义)概念或领域解释清楚。SSH的预测是:只能用多个(多义)概念或领域来解释。这两句话直接给出了可检验的实验判据。
那为什么现实中SSH更可能成立?论文给了两条论证。
论证一,干扰最小化(Interference Minimisation):
论证二,负载均衡(Load Balancing):
拿数据说话:一个专家到底横跨几个语义簇
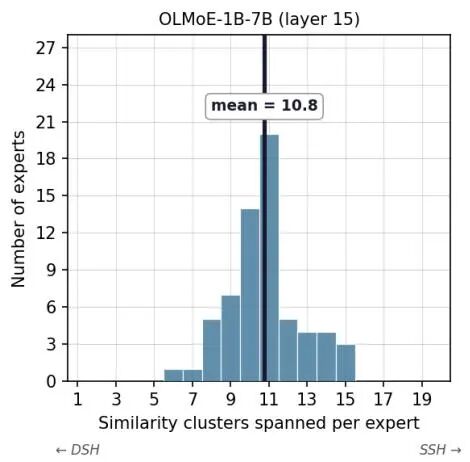
接下来是关键的实证设计。论文给每个专家取最预测其激活的top-n个SAE隐单元,把它们当成「这个专家所接的微领域代理」。然后再对每个隐单元用它的高激活样本生成一段自然语言解释,对这些解释做语义聚类,得到指标 G(Ei)——第i个专家的n个隐单元落在多少个语义上互不相同的簇里。
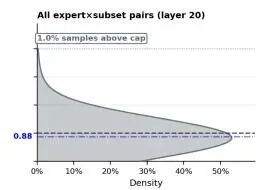
判据非常干脆:DSH预测 G(Ei) = 1,所有隐单元挤进同一个簇;SSH预测 G(Ei) → n,隐单元们各自落在互不相同的簇里。实测结果,OLMoE-1B-7B第15层平均10.8个簇,gpt-oss-20b第20层平均11.3个簇,上限是n = 20。既远高于DSH预言的1,又略低于随机分配的水平——说明专家还保留了一点主题上的相干性,但确实横跨了大量互不相交的微领域。这就是论文判定SSH胜出的主要实证。
论文还补了两个侧面证据:一是每个token保留的SAE特征越少,路由预测的F1越差,说明路由是靠大量特征联合决定的;二是在Pile语料的不同子集上,路由偏好基本贴近语料本身的占比。
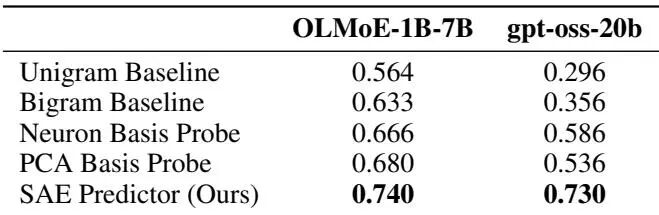
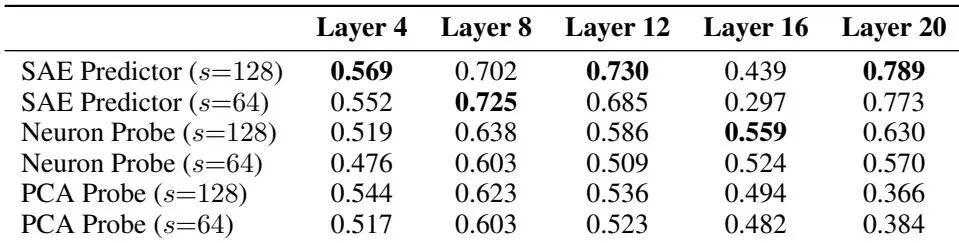
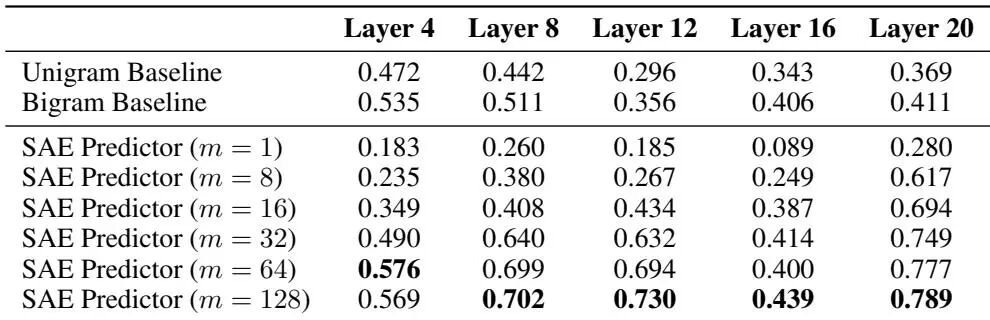
RouterInterp:用SAE特征解码路由决策 在推出方法之前,论文先做了一个前置验证:同样拿来预测路由,SAE隐单元比token共现统计和稀疏线性探针都准得多。在gpt-oss-20b上,路由预测的macro-F1(宏平均F1,即先按每个类别算F1再取平均,在类别不均衡时比普通准确率更有参考价值)达到0.73。
三步流水线:选特征、收样本、写解释
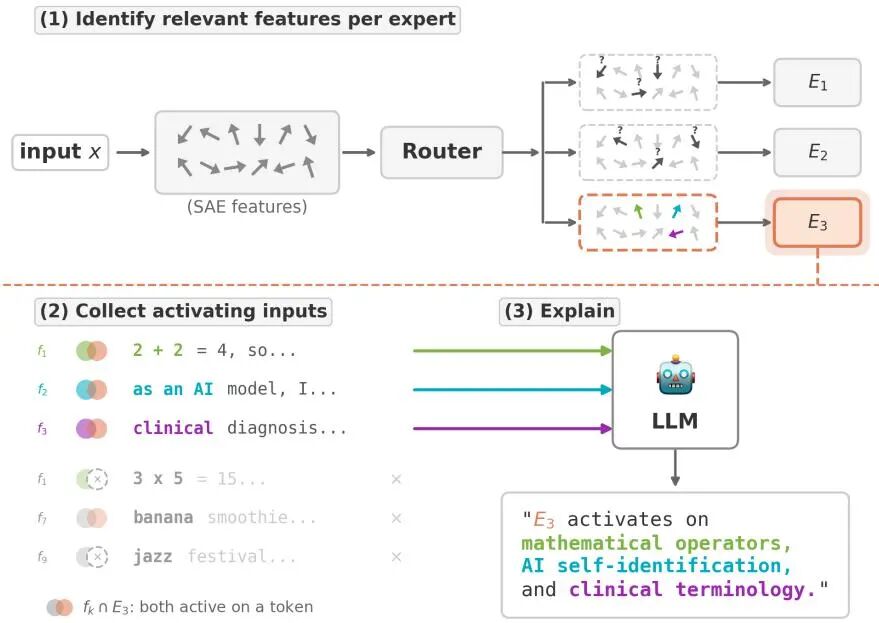
RouterInterp的方法本身可以拆成三步。第一步,为每个专家挑出与它的路由行为最相关的SAE特征。第二步,针对每个被选中的特征,收集「该特征与该专家同时激活」的样本,并且刻意构造成正负对照:正样本是该特征激活、token确实被路由到该专家;负样本是该特征同样激活、但token没被路由到该专家。第三步,把这些按特征分组的正负样本交给语言模型,让它综合成一段自然语言,说明这个专家在什么情况下会被选中。
第一步「选特征」是整个方法的胜负手,这里用的是近似消融的思路:估计某个特征被消掉之后,目标专家被选中的概率变化多少,以此作为该特征的重要度排序。形式化写出来,就是特征f对专家Ei的归因分数 Sif。
论文还给出了一个更简化的相关性版本 ρ(f, Ei),用来衡量特征激活强度与专家被选之间的均值差。
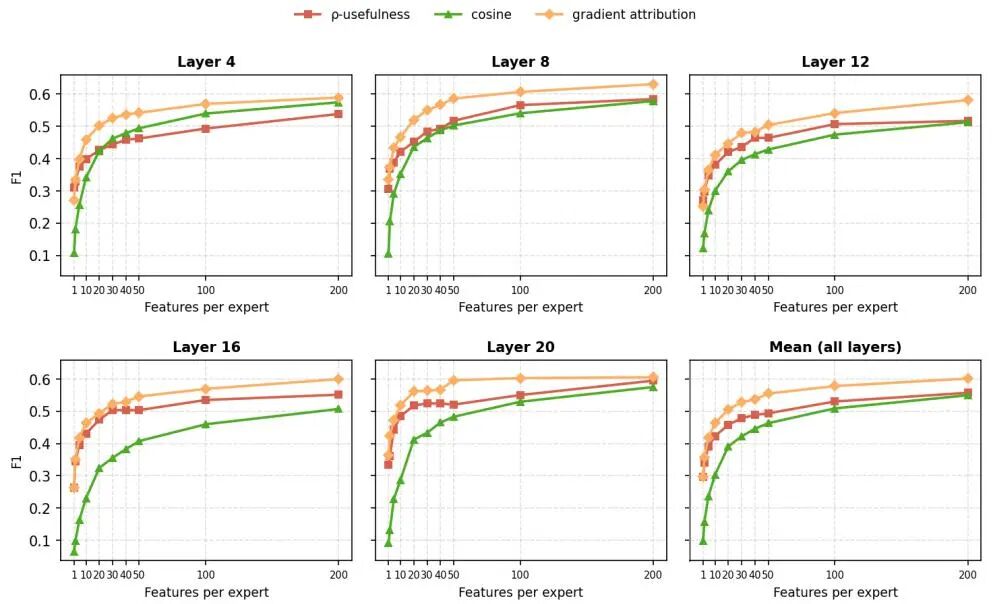
论文比较了若干特征选择策略,结论是基于梯度的归因(gradient-based attribution)最稳,在gpt-oss-20b的五个层、各种特征数量下都最强;而且特征数超过约50个之后,平均F1的提升就明显放缓了。
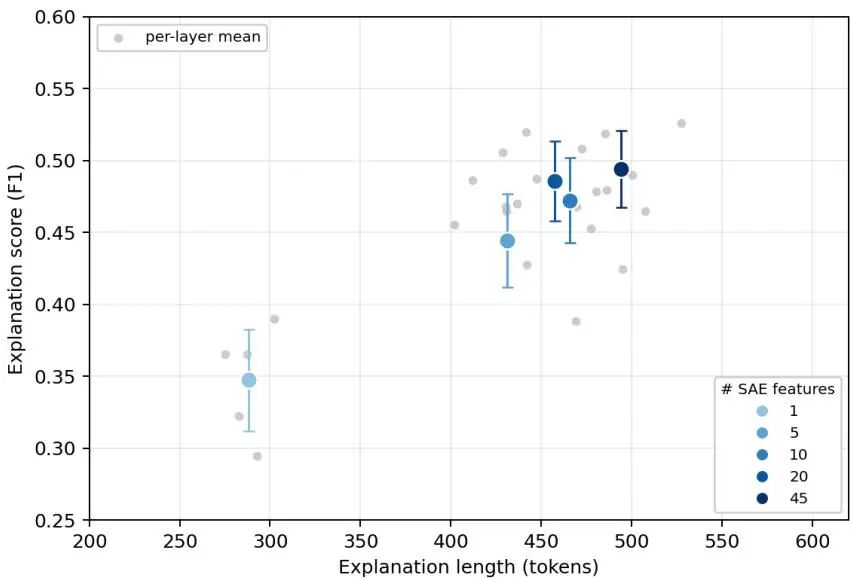
最终配置选了每个专家top-45个特征。这个数字是权衡出来的:随着特征数增加,描述会越来越长,而解释分数的边际收益递减。
顺带说一下SAE基底本身的价值。论文在稀疏度对齐的条件下,把SAE探针与神经元探针、PCA基探针做了比较,在gpt-oss-20b的多数层上,SAE学到的基底承载了更多与路由相关的结构。
还有个与SSH直接呼应的现象:使用的SAE特征越多,路由预测越好。
解释好不好,怎么打分
解释类工作的老问题是:怎么证明这解释不是自说自话。论文借用了Paulo等人2025年的AutoInterp检测式评测:让另一个语言模型担任评分者(scorer),只看解释文本,去判断某个token是否会被路由到该专家。论文为专家级路由设计了对应的评分流程——给评分者一个专家的解释和一段文本窗口,正样本窗口里至少有一个token真的被路由到该专家,负样本窗口则来自该专家从未被选中的窗口,高亮token数量按正样本的高亮数经验分布采样,评分者判断「至少有一个被高亮的token在其上下文中符合解释」。
为了让这套自动评分站得住,论文还做了小规模人工评测来校准评分者:人类与评分模型的一致程度,和人类彼此之间的一致程度相当,因此可以把评分模型当作人类可解释性判断的代理。生成解释用的是Delphi库,解释模型是Claude Sonnet 5,评分模型是GPT-5.6 Luna;每个专家配15个正样本、85个负样本,正样本比例15%大致对齐单个专家实际拿到的token比例(gpt-oss中k=4、E=32,约为12.5%)。
实验验证:叠加专业化假说的全面胜出 数据准备及实验设计
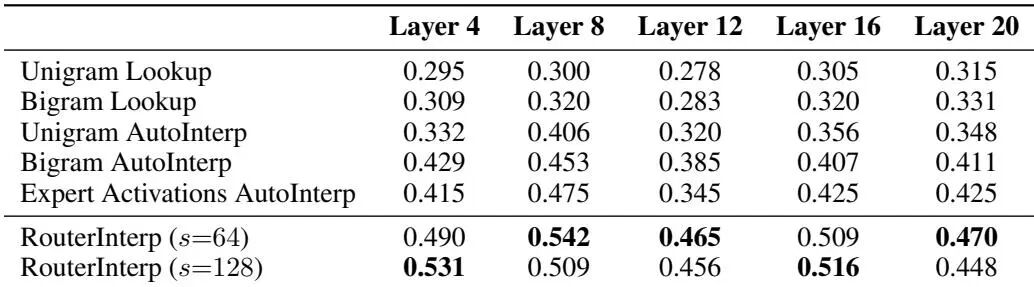
评测覆盖两个MoE架构:OLMoE-1B-7B(Muennighoff等人2025)和gpt-oss-20b(Agarwal等人2025)。训练OLMoE的SAE用OLMoE-mix-0924语料,采集路由分析与解释评分所需的激活则统一用Pile数据集(Gao等人2020)。OLMoE共16层,论文在3、7、11、15层上训练Top-K SAE,每token隐单元稀疏度s=32,特征数32768。gpt-oss共24层,在4、8、12、16、20层上使用已训练好的BatchTopK SAE,特征数131072,稀疏度s取64或128。
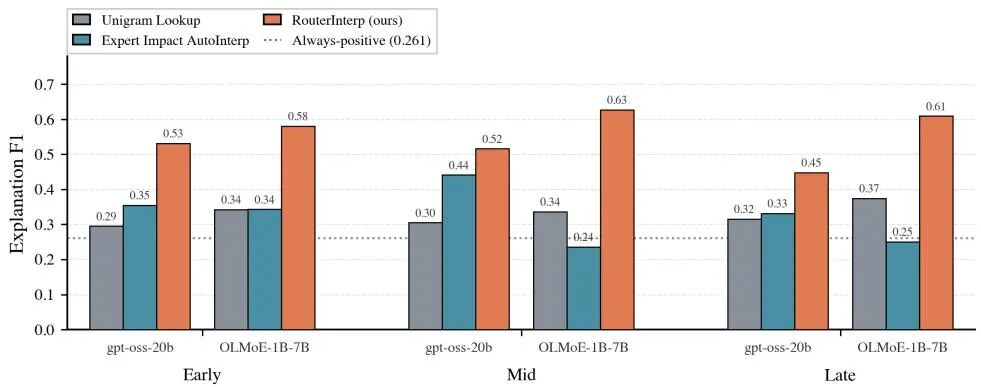
解释生成与评分使用每专家top-45个、由梯度归因选出的特征。评分在每个层的全部专家上进行。对比基线有三类:基于token共现统计的Unigram Lookup(一元词查找);在其上加局部上下文的Bigram Lookup;把token统计交给语言模型总结的Unigram/Bigram AutoInterp;以及Herbst等人2026年的Expert Impact AutoInterp,后者用残差流上的专家影响强度排序激活窗口,再配合Logit Lens(对数透镜,把中间层表示直接投影到词表上看它「想说」哪些词)得到的top词来生成解释。消融实验还包括把n-gram摘要换成完整激活窗口的Expert Activations AutoInterp,用来隔离「给不给整段上下文」这一因素的影响。
实验结果分析
实验设置整体是合理的:两个模型一大一小、架构与训练配方不同,层覆盖了早中晚三段,对比基线既包含传统统计方法,也包含近期的专家级自动解释流水线,还做了逐层报告而不是只报一个平均数。评分环节的自动打分器经过人工一致性校验,正负样本比例也对齐了真实路由比例,避免了「全猜正」就能刷高分的漏洞。
结果为什么能work,论文的解释与SSH自洽:在叠加大前提下,只沿着单一维度挑证据(token频率、激活强度、残差流影响)根本无法覆盖一个专家横跨的多个不相交微领域。结果要么塌缩到该专家最主导的那一种激活模式上,要么写得过于笼统,根本没法刻画路由。消融里的两种失败模式正好对应这两个方向——bigram描述太窄,精确率0.39、召回率0.59;整窗口描述太宽,精确率0.30、召回率0.81;只有把证据按SAE特征分组之后,精确率与召回率才同时改善,达到0.47与0.64。这说明增益来自SAE特征分解,而不是来自解释模型本身。
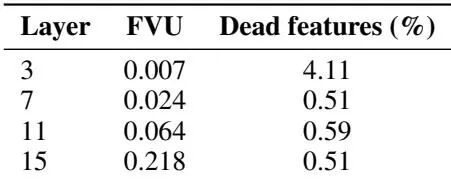
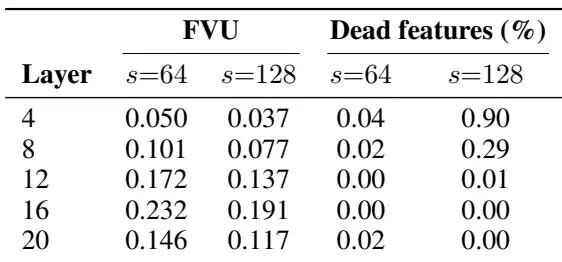
两个模型的差异也讲得比较诚实。RouterInterp在OLMoE-1B-7B上的优势明显更大,各层分数在0.58–0.63之间;论文把这归因于小模型的路由本来更容易刻画,且它的SAE更小、重建更好(32768个隐单元,FVU在0.007–0.218之间),而gpt-oss用的是131072个隐单元。同样的依赖关系在gpt-oss内部也看得到:第16层的SAE重建最差(FVU 0.19–0.23)、路由预测最弱,也是唯一一个同等稀疏度下神经元探针反超SAE的层。
有一点需要说清楚:论文并未给出与Herbst等人2026年的同基准对照。双方绝对分数不可直接比较,因为评测集构造与评分提示都不同——对方的评测集取自最大激活样本、正负比是10比10,评分提示接受在目标token上的粗略拟合;而本文的评分拒绝单纯token重叠,要求上下文中存在具体的激活模式匹配。所以「领先」只在本文自己的评测口径内成立。此外,本文的判断也仅限于PaperDaily已收录论文范围内可核实的证据;除OLMoE与gpt-oss-20b之外,目前没有第三方在相同设置下的复现,结论的适用范围还需谨慎看待。
实验结果
主结果:RouterInterp在gpt-oss-20b上平均F1为0.492(s=128),在OLMoE-1B-7B上为0.602;相比之下Expert Impact AutoInterp分别为0.383和0.305,Unigram Lookup为0.299和0.342。两个模型、每一个层,RouterInterp都赢。相对Unigram Lookup的平均提升约为65%(gpt-oss-20b)和76%(OLMoE-1B-7B),相对Expert Impact AutoInterp约为28%。
人工一致性与概率对齐两项补充实验也值得看。前者说明自动评分器可以当人类判断的代理,后者说明虽然SAE探针只用二分类交叉熵在top-k成员关系上训练,它预测出的概率排序与真实路由概率的排序仍然很 龙迷三问
这篇论文到底在解决什么问题? MoE模型为什么强?主流说法是「专家各管一摊」。维也纳工大等提出RouterInterp,用稀疏自编码器证明专家其实是「多领域特征叠加」,能让语言模型讲清路由逻辑,检测准确率比token统计法高约65%。这篇工作最值得看的点是什么? RouterInterp在gpt-oss-20b上达到0.492平均F1(s=128),在OLMoE-1B-7B上达到0.602,在所有层均优于基线方法。相比Unigram Lookup提升约65%(gpt-oss-20b)和76%(OLMoE-1B-7B),相比Expert Impact AutoInterp提升约28%。这篇工作的边界或风险在哪里? 优点:(1)首次提出并验证了叠加专业化假说,为理解MoE路由提供了新视角;(2)RouterInterp方法在多个模型和层上一致优于基线;(3)方法具有可扩展性,可应用于不同MoE架构;(4)提供了理论论证和实证证据支持SSH。缺点:(1)依赖SAE质量,SAE重建质量差时性能下降;(2)解释长度随特征数线性增长,可能影响可读性;(3)仅在1B-20B参数范围验证;(4)未探索路由路径或路由集合的解释。如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~ 龙哥点评
论文创新性分数: ★★★★☆
提出RouterInterp方法,利用稀疏自编码器(SAE)特征来解释MoE模型中的专家路由决策,通过识别最能预测路由的SAE特征并生成自然语言解释,验证了叠加专业化假说(SSH)。实验合理度: ★★★★☆
宏F1分数(路由预测)、解释分数(F1)、聚类数G(E_i)、FVU(方差未解释比例)学术研究价值: ★★★★☆
提出RouterInterp方法,利用稀疏自编码器(SAE)特征来解释MoE模型中的专家路由决策,通过识别最能预测路由的SAE特征并生成自然语言解释,验证了叠加专业化假说(SSH);更关键的是问题定义是否可复用到同类任务。稳定性: ★★★☆☆
现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。适应性以及泛化能力: ★★★☆☆
现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。硬件需求及成本: ★★★☆☆
OLMoE SAE训练约2小时(单A100 GPU);gpt-oss-20b使用公开预训练SAE。RouterInterp解释生成使用Claude Sonnet 5,评分使用GPT-5.6 Luna。复现难度: ★★★☆☆
现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。产品化成熟度: ★★★☆☆
论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。可能的问题: (1)依赖SAE质量,SAE重建质量差时性能下降;(2)解释长度随特征数线性增长,可能影响可读性;
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击 "阅读原文", 查看更多原论文细节哦!
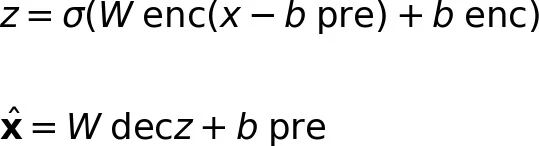
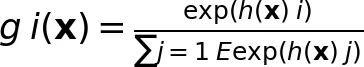
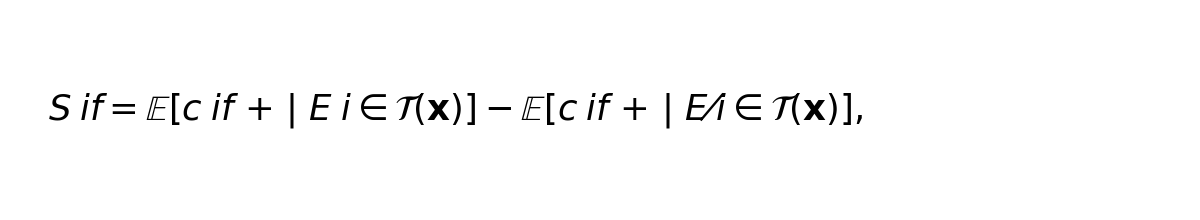
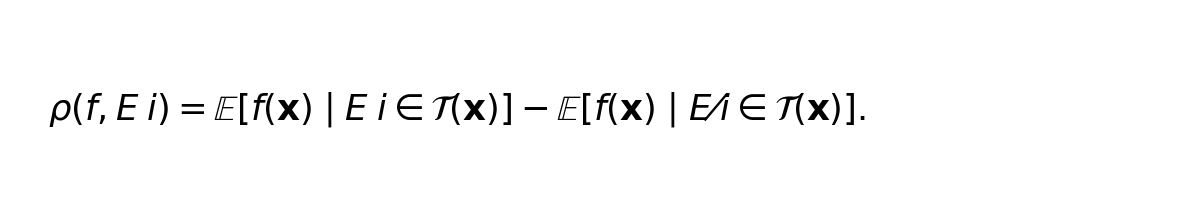

还没有公开留言,欢迎留下你的看法。