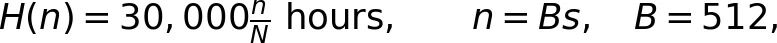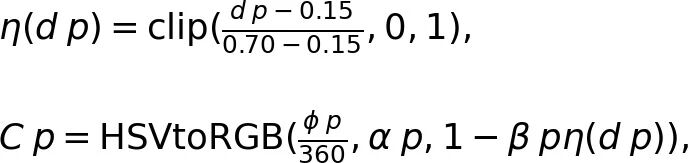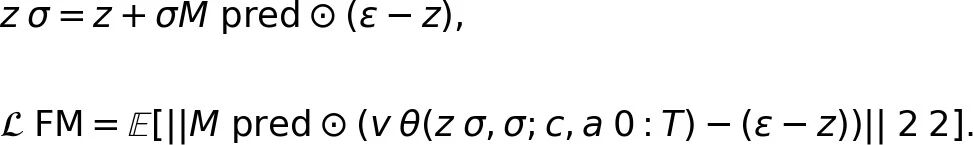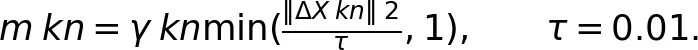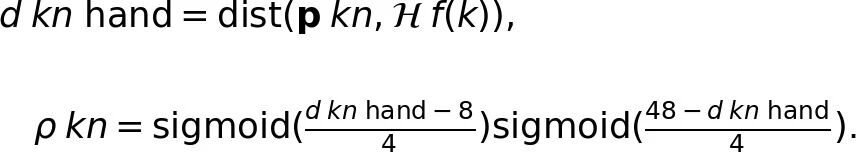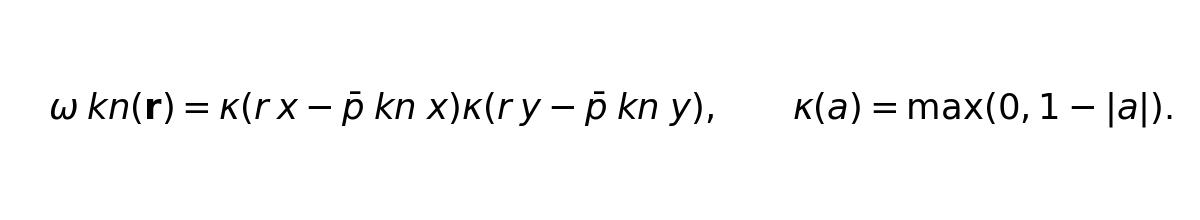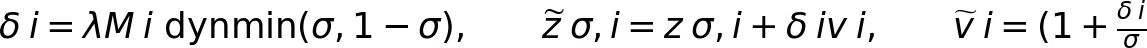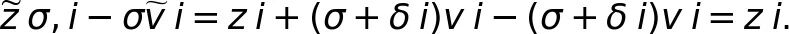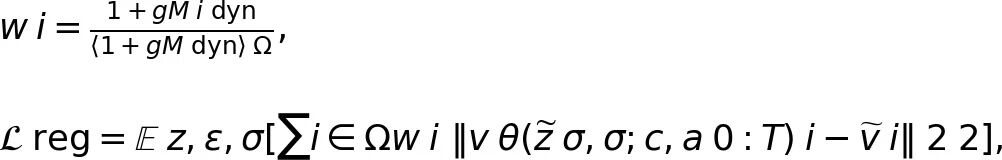← 返回 PaperDaily 视觉与图像

UIUC×丰田研究院:3万小时第一人称视频,世界模型学不会物体交互

一篇给"数据越大越懂世界"这条信仰做压力测试的论文。丰田研究院联合UIUC、CMU、JHU,拿3万小时第一人称人类操作视频训练世界模型,结果有点扎心:智能体的手放在哪学得又快又准,被它折的那张纸却始终折错。骨架条件化之后,300小时就能顶到基线1.5万小时的水平;而物体交互这条曲线,怎么加数据都抬不起来。作者给出的结论比数据本身更值得读——差距出在训练方式,

UIUC×丰田研究院:3万小时第一人称视频,世界模型学不会物体交互
原论文信息如下:
论文标题:
WHAT 30,000 HOURS OF EGO-CENTRIC VIDEO DOES NOT TEACH
发表日期:
2026年10月
发表单位:
伊利诺伊大学厄巴纳-香槟分校、卡内基梅隆大学、约翰霍普金斯大学、丰田研究院
原文链接:
https://arxiv.org/pdf/2610.12464v1.pdf
项目链接:
https://fidelity-gap.github.io/

3万小时第一人称视频竟教不会世界模型物体交互
世界模型规模化的局限
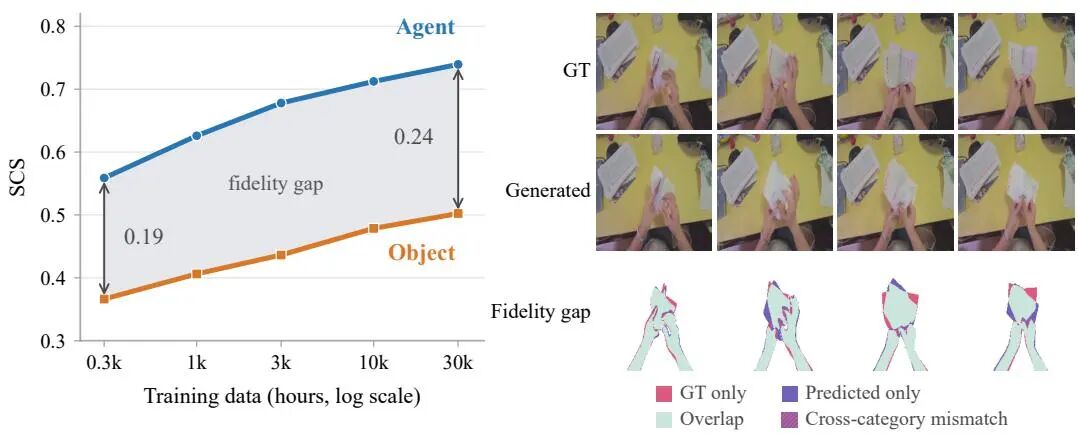
世界模型规模化的局限。左:第一人称数据规模化能换来很高的智能体建模保真度,但智能体动作对世界的影响明显落后。右:单次预测层面的同一种失败——最好的模型几乎把手放在了正确位置,而正在被折的那张纸全程被渲染成错误的形态。
世界模型(World Model)这个概念这两年被动用得很重。通俗讲,它是一个能在"脑子里预演未来"的模型:喂进当前画面和一个动作,它把接下来会发生什么直接生成出来。
在具身智能里,它被期待承担两个角色。一是当模拟器,替代手工搭建的物理环境去大规模训练和评测策略,毕竟真机采数据又贵又慢又危险;二是当规划器,让智能体在推理时把几个候选动作各"想象"一遍,挑结果最好的执行。这两个角色依赖同一种能力:预测被操作的物体,会怎么响应智能体的动作。
而这恰恰是传统物理仿真器的软肋。接触、摩擦、形变这几件事,哪怕把接触参数对着真实数据拟合过,也很难算准。于是自然有人问:能不能不写物理方程,直接从数据里把世界的规律学出来?
沿着这条路,近两年出现了一串围绕第一人称视频(ego-centric video,以佩戴者视角拍摄、记录双手与物体交互的视频)的规模扩张。DreamDojo 先在 4.4 万小时数据上训练、再用少量目标机器人数据后训练,报告了跨多种人形本体的动作可控性;Being-H0.7 把规模推到 20 万小时;EgoScale 用多样的人类数据改善灵巧操作。主流结论很统一:人类视频越多,世界模型越好。
反方意见也存在。LeCun 等人 2022 年提出过一个批评:像素级损失是按像素数量和可预测性来分配模型容量的,而不是按因果相关性。翻成大白话,占画面大头的背景最容易预测,也最容易吃掉容量;而那些小、且经常被手遮住的物体——交互真正发生的地方——反倒被目标函数低估了。这个论断催生了潜空间预测一类方案,但它描述的效应此前没有被直接测量过。
这篇来自伊利诺伊大学厄巴纳-香槟分校、卡内基梅隆大学、约翰霍普金斯大学和丰田研究院的论文,决定不绕弯子:直接测交互保真度,而不是看下游任务指标。理由是后者会把感知、智能体运动、物体动力学和策略行为的误差全揉进一个数字里,坏了哪一环都看不清。
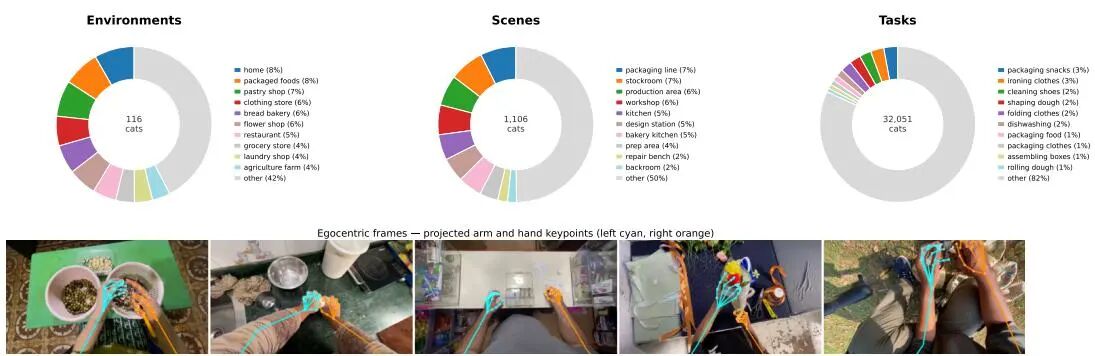
语料由 Mecka 采集:115 万段第一人称片段、合计 3 万小时(30fps 下约 3.24×10⁹ 帧,平均片段 94 秒),每帧都带标定的相机内参、6 自由度相机位姿、每只手 21 个密集 3D 手部关键点、腕部位姿、上半身关键点和一段自由文本活动描述。更关键的是多样性——116 个环境类别(家庭、面包房、花店、农场、修理店都算)、1106 个场景类别、32051 个任务、来自 14019 位参与者,没有任何单一环境类别占比超过 8.3%。对方差这么较真,是为了让后面关于泛化的结论站得住。
数据集总览
数据集总览。上:片段在环境、场景、任务三个维度上的分布(各取最高频的十类,灰色扇形代表长尾聚合)。下:来自四类环境的代表性第一人称帧,叠加了数据集中逐帧的关键点标注。
环境与场景分布
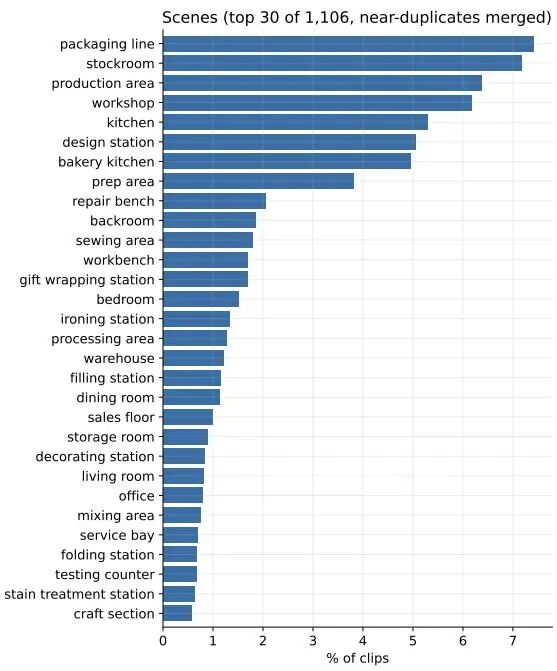
图7:出现频率最高的环境(左,116 类中的前 30)与场景(右,1106 类中的前 30,近似重复项已合并),纵轴为占全部片段的比例。
任务构成
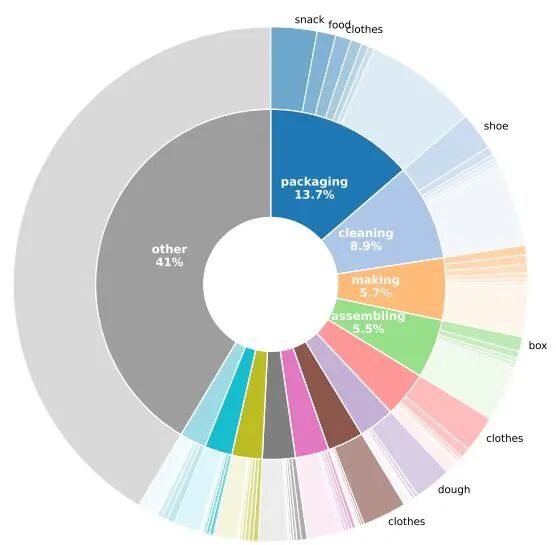
图8:任务构成。每个任务标签由"动作"(内环)和"被操作物体"(外环)组合而成,语料共覆盖 874 种动作与 9397 种物体,构成 32051 个动作–物体任务。少数动作(打包、清洁、制作)很常见,但每个动作都会向外环散开成一大片不同的物体。
模型主骨架是 NVIDIA 的 Cosmos 3 视频扩散世界模型,一共三个变体。Edge 是 4B 模型,其中 2B 的去噪 transformer 自研并从零训练;Nano 和 Super 分别是 16B 和 64B,其 8B 和 32B 的 transformer 改造自同尺寸的 Qwen3-VL(一个视觉语言模型)变体。Edge 在预训练方式上也与另外两个不同,所以涉及它的比较被当作变体比较而非容量趋势;Nano 与 Super 共享初始化、只差规模,二者的对比才真正隔离了容量这个变量。
动作空间被扩展成一个 159 维状态向量,含相机位姿、左右腕部位姿(各由 3D 平移和 6D 旋转构成)、左右手各 20 个手关节位置以及双肩双肘;动作由归一化状态和相邻帧差分构成,各经一个学到的线性编码器映射成一个动作 token,这个 token 在去噪全程保持干净、不被加噪。
训练数据被组织成一条嵌套阶梯:300 小时、1k、3k、10k、30k,每个预算都是同一次渐进训练里的一个检查点。曝光小时数按下面这条式子计算。
数据阶梯曝光小时数定义
数据阶梯的曝光小时数定义:H(n) = 30000·n/N 小时,n = Bs,B = 512。H(n) 表示训练到第 n 步时累计曝光的小时数,N 是常数项,B 为批大小,s 为步数索引。
评测完全走分布外。评测集来自另一次独立采集活动,平台、操作者、场地都不同,没有任何地点或参与者重叠,37% 的环境类别(占评测片段数的四分之一)在训练里从未出现。在此基础上人工筛出 150 段片段,条件是:确实存在非平凡的智能体–物体交互、被操作物体在画面里足够大以便精确分割、上半身与手部关键点标注准确。每段 32 帧、10fps,共 11328 个实例掩码,模型在 17 帧窗口上评测(1 帧观测加 16 帧预测)。掩码由 SAM 2(一个可提示的视频分割与跟踪模型)生成,再人工核验修正。
核心指标叫 SCS(Structural Consistency Score,结构一致性分数,引自 Bagchi 等人 2026 年的工作):把预测视频和真值视频里的关键元素分割并跟踪,算掩码 IoU 的平均值,衡量"给定动作有没有被准确反映在生成的世界里",并分别对"手"(智能体)和"被操作物体"报告。LPIPS(Learned Perceptual Image Patch Similarity,学习感知图像块相似度)作为感知质量对照,用来核对结构保真度的差异不是画质差异造成的。
还需要一个说明:掩码跟踪本身并不完美,就算预测完全正确也拿不到 SCS = 1.0。作者用真值掩码在不同帧重新初始化跟踪器、再测两条轨迹的一致性,估计出可达上限约为智能体 0.93、物体 0.90,在生成视频上数值也接近。两个上限都远高于模型实际得分,所以报告出的差异反映的是模型能力,而不是指标的极限。
先说结论:手学得又快又准,纸始终折错。这个反差就是全文的引线。🤔

智能体建模接近极限但物体动态远远落后

第一个问题很朴素:什么都不动,只加数据能走多远?
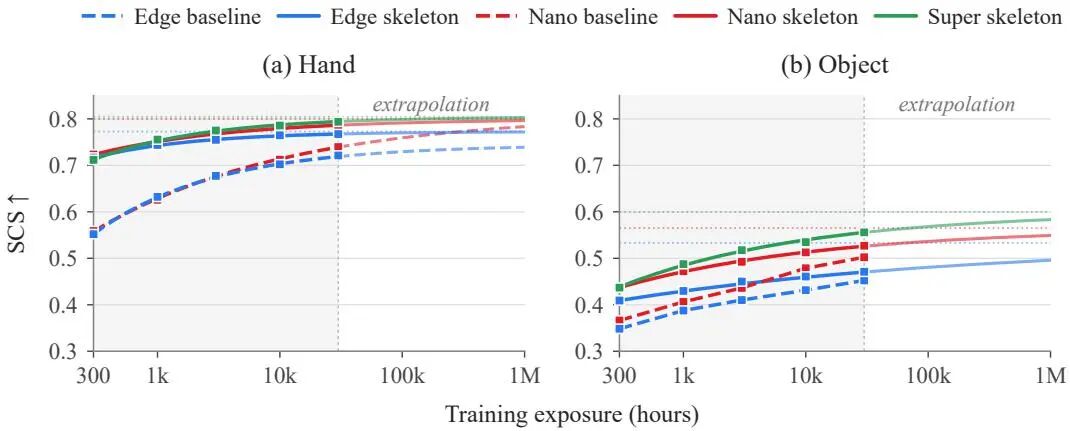
图 4 里的灰色虚线是 Edge 和 Nano 两个变体在纯数据缩放下的表现。两条轴——智能体和被操作物体——都在涨,但差距也在扩大;Nano 的绝对保真度更高、改善也更快,物体上尤其明显(+0.14 对 +0.10)。照字面读,这支持"继续堆数据迟早能补上"的乐观判断。
但两条曲线的形状不一样。智能体保真度在明显饱和:300 到 3k 小时涨了 0.12 SCS,3k 到 30k 只涨了 0.06。作者用缩放定律分析里常见的饱和曲线形式 S∞ − cD−α(引自 Kaplan 等 2020、Hoffmann 等 2022)去拟合,把它的渐近线定在 0.811。物体保真度则看不到可比的减速,一条没有曲率的曲线约束不了渐近线,所以在当前数据范围内,物体上限根本无法确定——这也是作者只把曲线画在观测范围内的原因。
另一条路是加模型规模。把参数量放大 4 倍(Super 变体),对智能体保真度几乎没影响,却把物体上限抬高了 0.034 SCS。这算是给"规模派"一个支持信号。但定量算一下就不乐观了:按每翻两番换 0.034 来算,要补上剩下的 0.205 差距,大约还得再翻两番 6 次,也就是参数量再涨约 4 个数量级,训练算力同比例上升——而这还是假设每次增益不衰减的下界估计。
结论就是:数据量和模型规模这两条能 scale 的轴,都不是补上这个差距的现实路径。
规模化只够到智能体的上限
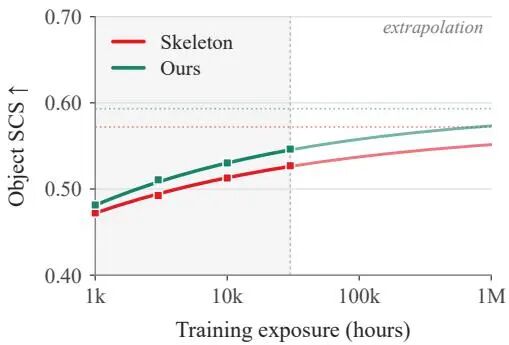
图4:规模化只够到了智能体的上限,够不到物体的。左为智能体 SCS、右为被操作物体 SCS,横轴为训练数据量,实线与虚线分别代表有、无骨架条件化。骨架条件化用少得多的数据就到达了智能体的上限,而物体保真度收敛在远远更低的位置。

骨架条件化揭示物体保真度天花板

既然等物体曲线自己涨上来太慢,作者换了个思路:先把智能体这条轴钉死,好让物体轴被单独、干净地测出来。
用的工具是骨架条件化(skeleton conditioning)。原设定里动作 token 描述的是姿态与关节角坐标系下的运动,模型得自己学会"这套姿态投影到像素上长什么样"。骨架条件化把这步推理直接送给模型:对每一帧,把两只 21 关节的手及其肩–肘–腕链条按相机内参投影到图像平面,一个位于相机坐标系 qt,j 的关节,其像素坐标与深度为 ut,j = (Ktqt,j)1:2 / (Ktqt,j)3,dt,j = (qt,j)3,其中 Kt 为相机内参。
投影会把深度丢掉,所以作者把深度编进颜色:色调(hue)标明这个图元属于哪根手指或哪条肢体,明度(value)随距离变暗,于是骨架同时带上了图像平面位置和三维朝向。
骨架深度着色公式
骨架的深度着色公式:η(dp) 把图元深度 dp 映射到 [0,1] 的归一化明暗因子(工作范围 0.15–0.70 米),φp 是该图元所属手指或肢体的色调,αp、βp 分别控制饱和度与深度明暗的强度,最后经 HSV 转 RGB 得到绘制颜色。
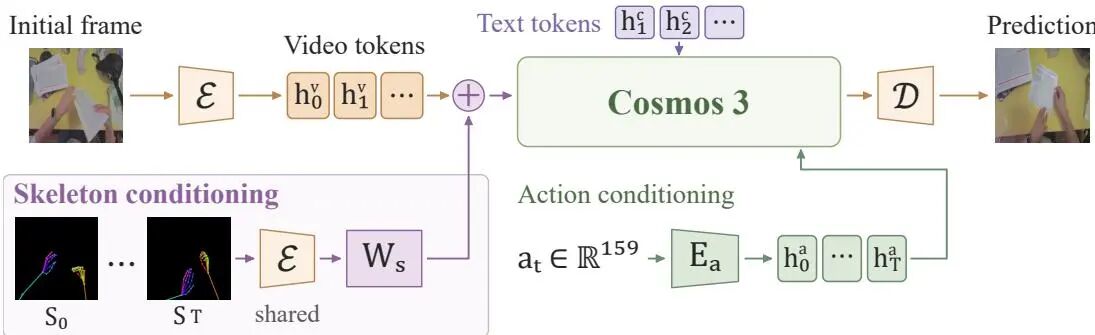
光栅化后的骨架序列 S0:T 用和视频同一个冻结 VAE(Variational Autoencoder,变分自编码器,这里负责把视频压缩成时空潜变量)编码,潜变量按视频网格切成对齐的块,再经一个零初始化的线性投影 Ws 加到对应的视频 token 上,即 h̃i = hiv + his。骨架在训练和推理时都提供,而且是由相机内参推导出来的,正好与视觉 token 网格对齐。
带骨架条件化的 Cosmos 3
图2:带骨架条件化的 Cosmos 3。所示的投影骨架序列 S0:T,由与视频同一个冻结 VAE 编码,其潜变量块经零初始化的 Ws 投影后加到对应的视频嵌入上。骨架由相机内参推导,以便更好地把智能体动作与视觉 token 网格对齐。
训练用 rectified flow matching(直通流匹配,Liu 等 2023 年提出的一类把"从噪声回到干净"建模成直线路径的扩散训练目标),冻结 VLM 和 VAE,只训练扩散分支及其条件模块。
直通流匹配训练目标
训练目标(直通流匹配):zσ = z + σ·Mpred ⊙ (ε − z),损失 LFM 为预测速度场与真值速度场之差的平方期望。其中 z 是干净视频潜变量,ε 是标准高斯噪声,Mpred 是选中未来潜变量的二值掩码,vθ 是模型预测的速度场,c 为文本条件,a0:T 为动作序列;初始观测帧始终保持干净。
结果很干脆。图 4 左轴实线是加了骨架条件化之后的曲线:300 小时的骨架条件化 Nano 就达到了标准条件化要到约 1.5 万小时才达到的智能体保真度,数据量减少约 50 倍;此后两个数量级只再涨 0.06 SCS。关键在于,条件化改变的是"什么时候到达上限",而不是"上限在哪":两种设计最终收敛到相差约 0.01 SCS(0.811 对 0.800),所以继续加第一人称视频对这条轴已经没有实质意义。
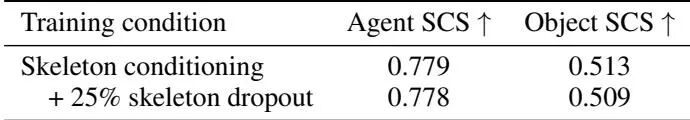
物体那一侧也吃到了好处:Nano 在 300 小时就达到基线 3k 小时的水平,但这个优势沿着阶梯逐渐收窄。这引出一个需要排除的可能——把身体构型直接喂进去,模型会不会省掉了那部分本来可以支撑交互建模的视觉推理?作者为此做了消融:训练时随机丢弃骨架,推理时两个变体都用完整骨架。结果没有找到走捷径的证据。
骨架丢弃消融实验
表5:骨架丢弃消融实验。Cosmos 3 Nano、1 万训练小时;丢弃只在训练时生效,两个变体在评测时都使用完整骨架条件化。结果表明骨架条件化并没有为学习物体交互动力学引入任何捷径。
于是物体曲线基本可以被视为"不受智能体保真度改善干扰"的独立测量。测出来是什么?两个数量级只涨 0.09 SCS,而且和基线不同,它是会减速的:300 到 3k 涨 0.056,3k 到 30k 只涨 0.035。曲线进入饱和区,渐近线因此可识别:0.565,而模型在 3 万小时时已经实现了其中的 93%。按各自可测范围归一化,智能体收敛到其可测区间的 86%,物体只有 63%。真正的问题不是物体动力学涨得慢,而是它涨到的那条线本身远低于智能体。

动态区域监督能否撬动物体交互上限

额外数据不太可能突破这个低上限,那改监督方式能不能?这一节全部使用 Cosmos 3 Nano 变体。
先说一个否定结果。近年有面向交互的监督方案,比如 PhysisForcing(Zhang 等 2026b),它用 2D 点跟踪和单目深度定位"含物理信息"的区域,然后在区域内部训练中间扩散特征去支撑点跟踪(对照 CoTracker3 的参考),并把成对 token 的相似度矩阵对齐到一个冻结的 V-JEPA 2 编码器。作者把这两个目标都重新实现了一遍,在 10k 小时上并没有超过骨架基线。原因不难理解:那套区域定位启发式和跟踪监督都默认相机静止、物体大体不被遮挡,而在第一人称操作里这两个前提都不成立——相机跟着智能体一起动,物体在接触的那一瞬间恰恰被正在操作它的那只手挡住。
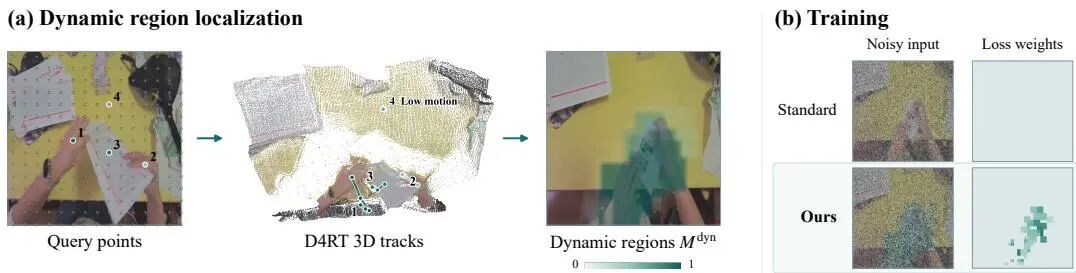
所以作者设计了一个不依赖这两个假设的方案。第一步是定位动态区域:在首帧初始化一个规则网格的查询点,用 D4RT(Zhang 等 2026a)在整段视频里做 3D 跟踪,把每个点的 3D 位移大小、跟踪可靠性,与一个围绕手部投影的软空间先验结合起来,再把分数扩展到相邻的潜单元,得到动态区域图 Mdyn ∈ [0,1]H×W。
动态性打分公式
动态性打分:mkn = γkn·min(‖ΔXkn‖2/τ, 1),τ = 0.01。ΔXkn 是第 n 个查询点的 3D 位移,γkn 是跟踪可靠性,τ 是位移饱和阈值;用 min(·,1) 把超过阈值的位移统一压到 1,避免极少数大位移点主导整张图。
手部邻近先验公式
手部邻近先验:dhandkn 是查询点到手部区域的距离,ρkn 由两个 sigmoid 相乘得到,在 8 像素到 48 像素之间形成一个"靠近手但不贴在手像素上"的环带。这么设计是因为紧贴手的像素可能只是手自己在动,真正需要紧盯的是手周围那圈即将被改变的物体。
邻域核函数
邻域核:ωkn(r) 是一个三角形核函数,把单个点的得分柔和地铺开到周围的潜单元,κ(a) = max(0, 1 − |a|),避免出现孤立的硬点。
动态区域图合成公式
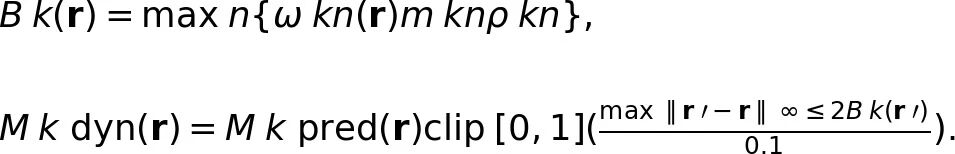
动态区域图合成:先对同一位置的所有查询点取最大得分 Bk(r),再在 ∞-范数半径 2 的邻域内做一次扩张取最大,除以 0.1 后截断到 [0,1];乘上 Mpred 保证只有被预测的潜位置参与计算。
第二步是把这些区域上的监督挪个方向,核心手法是在区域内抬高噪声水平。直觉是:如果某处噪声很低、上下文又干净,模型去噪时基本可以靠"把邻居像素抄过来"把目标满足掉,学不到动力学;噪声一高就抄不了了,只能靠上下文和动态规律去推。
动态噪声调度公式
动态噪声调度:λ ∈ [0,1] 控制额外噪声强度,δi 由动态区域图 Mdyn 加权;模型看到的潜变量被推到 z̃σ,同时配对的目标 ṽ 同步调整——有效噪声从 σ 抬到 σ+δ,但模型的噪声水平输入仍然是 σ。
监督一致性推导
关键的一致性:调整之后,监督指向的仍然是同一个干净潜变量 zi,只是到达它的路径变陡了。所以这既不是换目标,也不是额外加正则,本质就是把"抄近路"这个捷径堵掉。
在同样的区域里,作者还顺手加了一点损失重加权。
区域重加权损失
区域重加权损失:wi 中 g 控制重加权强度,分母取 Ω 上的平均做归一化,保证总权重不变、只是重新分配;Ω 为被预测的潜位置集合,Lreg 就是加权后的训练损失。
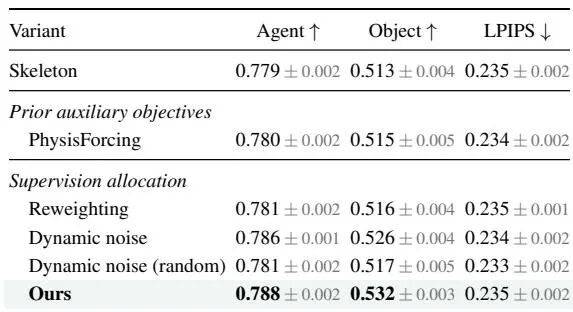
效果如何?10k 小时、五个随机种子的消融结果如下。
区域监督消融实验
表1:1 万小时预算下的区域监督消融实验。同时使用动态噪声调度与损失重加权时物体保真度最高,且没有牺牲感知质量;数值为五个随机种子的均值 ± 标准差,越高越好。
读表要点:单独重加权基本没用(物体 SCS 0.516 对骨架基线 0.513);抬高噪声有用(0.526);把 Mdyn 换成同等面积但随机放置的区域,增益几乎全没了(0.517),说明好处来自"在哪里改"而不是"扰动本身";两者合起来最好(0.532),LPIPS 全程没动(0.235),说明没有牺牲感知质量,智能体 SCS 也从 0.779 抬到了 0.788。
动态区域监督示意
图12:动态区域监督。(a) D4RT 在三维中对查询点做跟踪,从而把场景运动与相机运动分开;把 3D 运动、跟踪可靠性和手部周围的软空间先验结合起来,就得到动态区域图 Mdyn。(b) 动态区域监督在选定区域内同时执行动态噪声调度与损失重加权。
需要提醒的是:这是论文测过的唯一一个能抬高物体保真度收敛水平的干预,幅度也确实有限——它把天花板往上推了一点,但没有把物体和智能体之间的差距抹平。

从人类视频到人形机器人的迁移验证

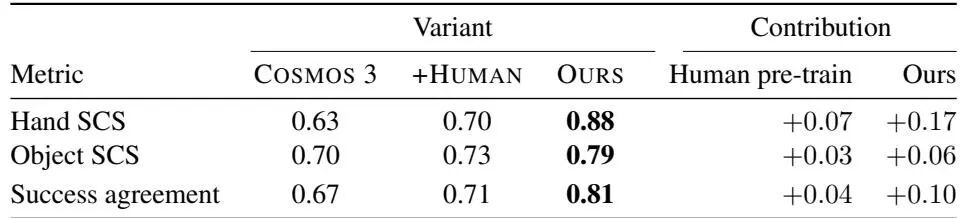
最后一个问题是:这些结论只在第一人称人类视频里成立,还是能落到下游的人形机器人操作上?作者做了一次三段式对照:原始 Cosmos 3、加上人类数据预训练(+HUMAN)、再加上动态区域监督(本文方法)。
向人形机器人操作的迁移
表2:向人形机器人操作的迁移。左侧为在人形基准上的 SCS,以及与仿真器渲染结果在策略 rollout 成功与否上的判断一致率;右侧两列为相邻变体之间的贡献差值。数值越高越好。
手部 SCS 从 0.63 到 0.70 再到 0.88,物体 SCS 从 0.70 到 0.73 再到 0.79。按相邻变体做差分,人类预训练贡献 +0.07 和 +0.03,本文方法贡献 +0.17 和 +0.06。也就是说,在这个下游场景里,训练设计的贡献超过了单纯加大第一人称预训练;但同一张表也把短板摆在明面上——物体那一侧的提升依旧明显小于手部,人形机器人与世界的交互建模仍然是瓶颈。
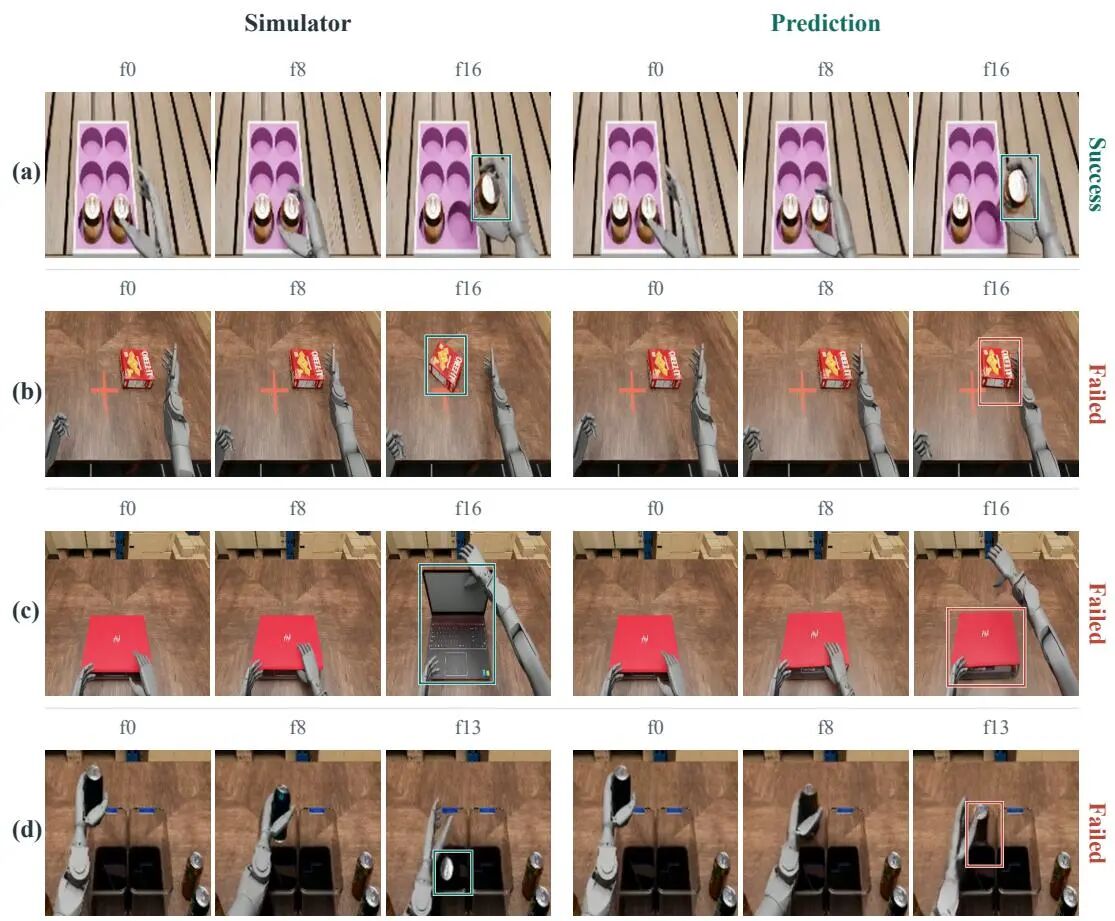
具体失败长什么样?图 10 给了一个成功的 rollout 和三种典型的物体交互出错:仿真器里盒子被推动并转向,世界模型里它待在原地不动;仿真器里笔记本电脑被打开,世界模型的预测里它一直合着;仿真器里易拉罐掉进了桶里,世界模型的预测里它卡在桶沿附近下不去。
人形机器人 rollout 案例
图10:一次成功的人形机器人 rollout 和三种物体交互失败案例。每行是一个例子,左侧为仿真器画面、右侧为世界模型的对应预测。(a) 两者都在所示窗口内把罐子卸下;(b) 仿真器里盒子转动了,世界模型里它待在原地;(c) 仿真器里笔记本电脑被打开,世界模型预测它一直合着;(d) 仿真器里罐子落进桶里,世界模型预测它卡在桶沿附近。成功标签表示世界模型的预测是否与仿真器的物体响应吻合。

世界模型训练方式比数据量更重要

把结论收拢成三条。第一,智能体保真度和"智能体动作对世界的影响"这两条轴在规模下的行为完全不同:前者早早饱和,而且用条件化来提升比用数据便宜得多(约 50 倍的数据量差距);后者收敛得远低于它。第二,动态区域监督是本文测过的唯一一个能把物体保真度收敛水平抬高的干预,但差距依然显著。第三,这些结论能迁移到下游人形场景,在那里训练设计的贡献大于单纯的人类数据预训练,不过物体交互仍是瓶颈。
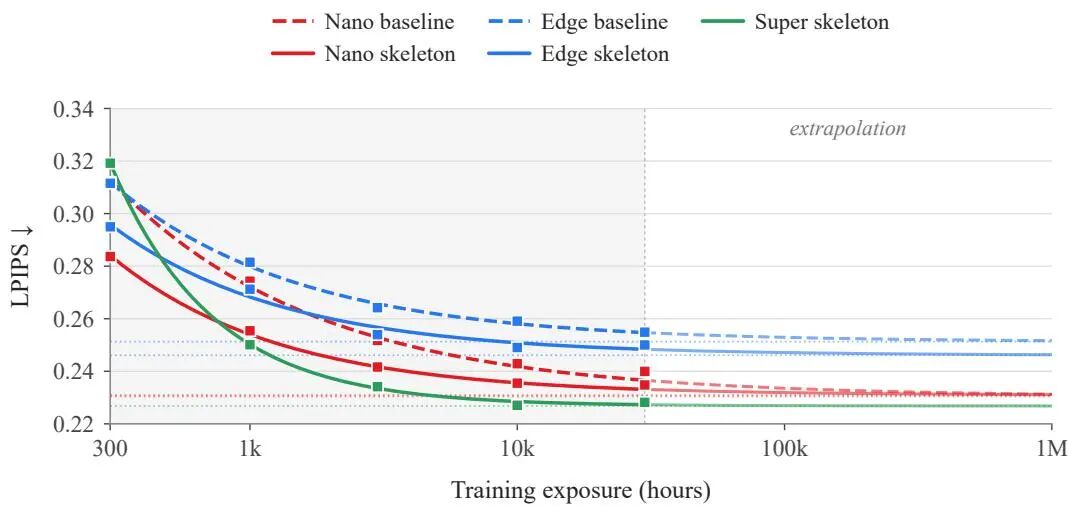
为什么不靠堆数据和堆参数?前面算过,物体要补上剩余 0.205 的差距,按每 4 倍参数换 0.034 的速率得再翻两番约 6 次,也就是参数量再涨约 4 个数量级;数据那侧更没谱,纯数据缩放下物体曲线根本没进入饱和区,连上限在哪都估不出来。顺带还有一个发现:LPIPS 沿整条数据阶梯也基本不动,也就是说,继续加大第一人称数据,连感知质量的提升空间都不大了。
感知质量随数据规模变化
图11:数据缩放阶梯上的感知质量。纵轴为 LPIPS(越低越好),横轴为训练曝光量。继续扩大第一人称数据规模,看来也不太可能改善模型预测的感知质量。
更高的物体保真度上限
图5:更高的物体保真度上限。沿整条数据阶梯看,加了动态区域监督的物体保真度在每个预算上都超过骨架基线,并收敛到更高的极限(该截图上半部分即为表1的消融结果)。
对工程和产品来说,这条结论对"先攒数据、再下游微调"的常见套路是个提醒。如果任务的关键恰恰是接触、摩擦、形变这类交互动力学,第一人称视频预训练的边际收益可能远低于预期,同样算力投在监督分配上——把容量从场景外观往被操作物体的动态上挪——回报可能更高。反过来,如果任务对"手放在哪、动作轨迹是否合理"这类智能体侧保真度更敏感,骨架条件化这种便宜手段应该优先上。
边界也要说清楚。本文评测的是从第一人称人类操作视频训练出来的通用视频世界模型,评测集是 150 段片段的分布外基准;SCS 是掩码层面的结构一致性,并不等于物理正确。动态区域监督的增益只在 10k 小时预算、Nano 变体上做过消融,换成更大模型或更小数据是否同样成立,论文没有全覆盖;而且动态区域图的构造依赖手部投影先验,对"手不参与"的交互是否有效,也还有待验证。

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?世界模型真能靠堆数据学会物理吗?本文用3万小时第一人称人类操作视频训练Cosmos 3,发现智能体动作保真度早早饱和,被操作物体的动态却远远落后;骨架条件化只需300小时就能顶到基线1.5万小时的水平。
这篇工作最值得看的点是什么?智能体保真度在3k小时后趋于饱和(渐近线0.811),骨架条件化使300小时达到基线15k小时的水平(约50倍数据效率提升)。物体保真度收敛至0.565,仅为智能体可测量范围的63%。动态区域监督将物体保真度从0.527提升至0.546(30k小时),渐近线提高但仍有巨大差距。模型规模扩大4倍仅提升物体保真度0.034 SCS。人类实验中人形机器人手部SCS从0.63提升至0.88,物体SCS从0.70提升至0.79。
这篇工作的边界或风险在哪里?优点:(1)首次在大规模第一人称视频上系统测量交互保真度的缩放行为,揭示智能体与物体保真度的根本性差异;(2)骨架条件化设计巧妙,既提升智能体保真度又作为隔离工具揭示物体保真度上限;(3)动态区域监督不依赖静态相机和无遮挡假设,适用于第一人称场景;(4)分布外评估基准严格,指标上限估计严谨;(5)结论可迁移至人形机器人场景。缺点:(1)数据阶梯耦合数据量和优化预算,无法完全解耦两者贡献;(2)物体保真度提升有限,距离可用水平仍有巨大差距;(3)仅研究生成式世界模型,未探索潜在预测模型;(4)评估集规模有限(150个片段),泛化性结论受限;(5)Super变体仅报告骨架条件化结果,缺少完整对比。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

在大规模第一人称人类操作视频上训练Cosmos 3视频世界模型,通过骨架条件化和以物体为中心的自适应噪声调度,分别将智能体保真度与物体交互保真度解耦测量,揭示数据规模扩展无法有效提升物体交互建模能力。

实验合理度:★★★★☆

SCS(Structural Consistency Score,结构一致性分数),分别对智能体和操作物体计算;LPIPS作为感知质量对照指标;人类评估中额外使用成功率一致性(Success Agreement)。

学术研究价值:★★★★☆

在大规模第一人称人类操作视频上训练Cosmos 3视频世界模型,通过骨架条件化和以物体为中心的自适应噪声调度,分别将智能体保真度与物体交互保真度解耦测量,揭示数据规模扩展无法有效提升物体交互建模能力;更关键的是问题定义是否可复用到同类任务。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

未明确报告FLOPs。训练使用全局batch size 512,17帧512×512分辨率视频,10fps。最大模型Super为64B参数,训练成本极高。

复现难度:★★★☆☆

现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:现有材料尚未充分覆盖分布外泛化、部署成本、长期稳定性和失败案例。


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球