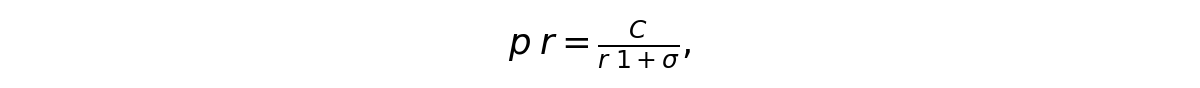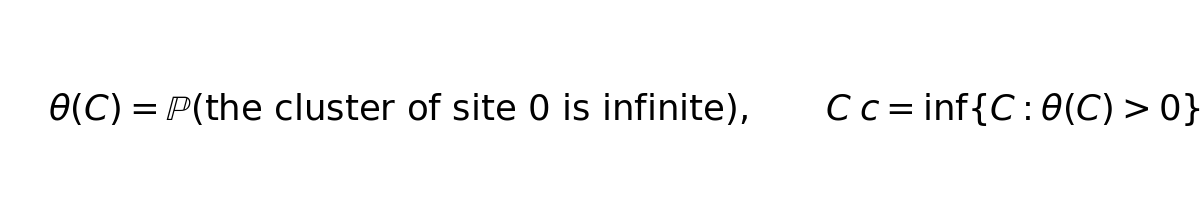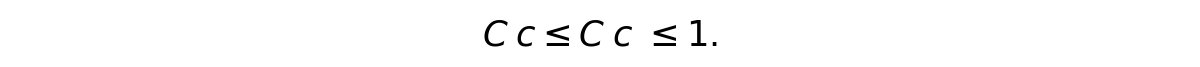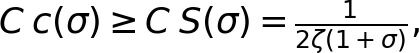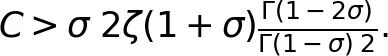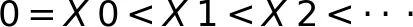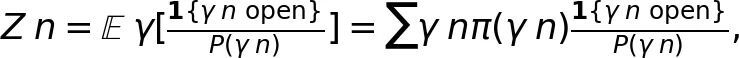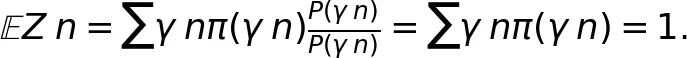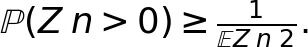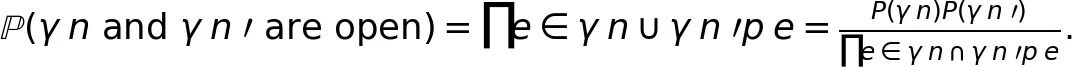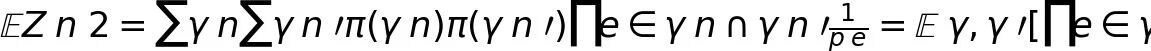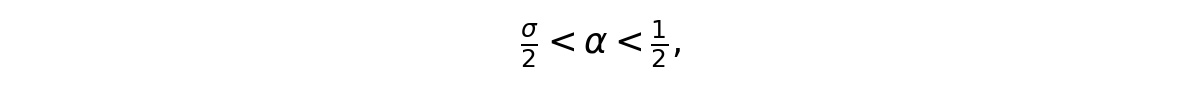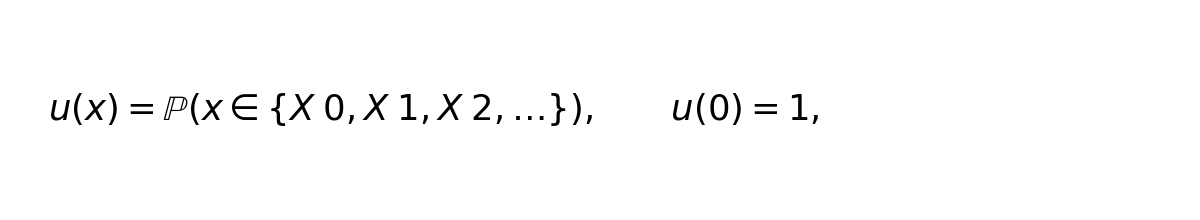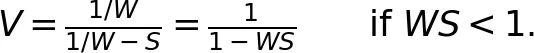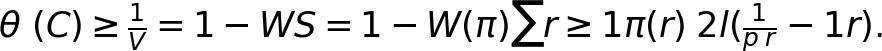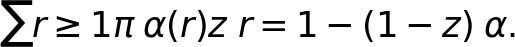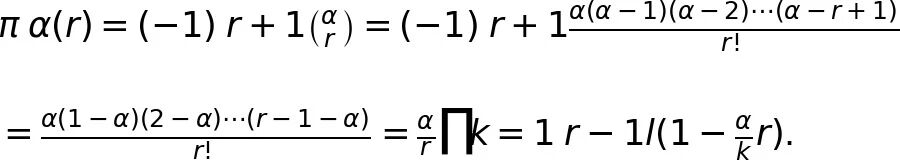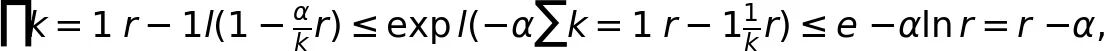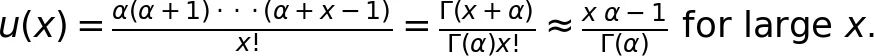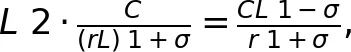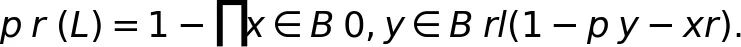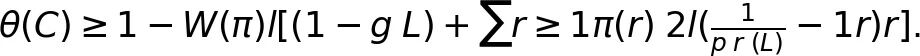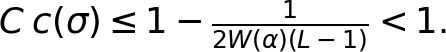← 返回 PaperDaily 大模型与智能体

以色列开放大学:渗流阈值上界首次显式给出,σ→0时约等于σ

先把场景搭起来。想象一条无限长的直线,整数位置 0、1、2、3……上各坐着一个站点。在一维「键渗流」(bond percolation)模型里,任意两个站点之间都可能连一根「键」,每根键独立地决定自己是开还是关。

以色列开放大学:渗流阈值上界首次显式给出,σ→0时约等于σ


原论文信息如下:
论文标题:
Explicit upper bounds on the threshold of one-dimensional long-range percolation
发表日期:
2026年10月
发表单位:
Department of Natural Sciences, The Open University of Israel, Ra’anana, Israel
原文链接:
https://arxiv.org/pdf/2610.11872v1.pdf

一维长程渗流:阈值之谜与显式上界

先把场景搭起来。想象一条无限长的直线,整数位置 0、1、2、3……上各坐着一个站点。在一维「键渗流」(bond percolation)模型里,任意两个站点之间都可能连一根「键」,每根键独立地决定自己是开还是关。键开了,两端就算连通;一堆互相连通的站点组成一个「连通簇」(cluster)。问题只有一个:这条线上,会不会出现一个无限大的连通簇?
如果键只能连接相邻的两个站点,那答案相当无趣:一维链不存在非平凡的相变。除非最近邻之间的连接概率恰好等于 1,否则永远不存在无限簇。这和只有短程相互作用的一维伊辛模型只在零温下有序,本质上是同一件事。
长程(long-range,简称 LR)键把这个局面彻底改写了。设距离为 r 的两个站点之间,键为开的概率是:
一维长程渗流的键概率定义
公式 1:键概率 pr 的定义。r 为两站点的距离,C 是控制连接强度的参数(0<C≤1),σ 是幂律衰减指数(0<σ<1)。距离越远,连接概率越小,但只按幂律衰减,比指数衰减慢得多。
参数 σ 把模型切成三段。σ>1 时,长程键不足以撑起无限簇,除非最近邻以概率 1 相连;0<σ<1 时才存在非平凡相变,临界值满足 0<Cc(σ)<1,这是 Newman 和 Schulman 用多尺度重整化论证证明的;σ=1 是边缘情形,在这个具体模型里对任意 C<1 都没有无限簇。
形式化一点,记 θ(C) 为「站点 0 所在连通簇无限大」的概率,那么临界值 Cc 就是让这个概率首次大于零的 C:
渗流概率与临界值的定义
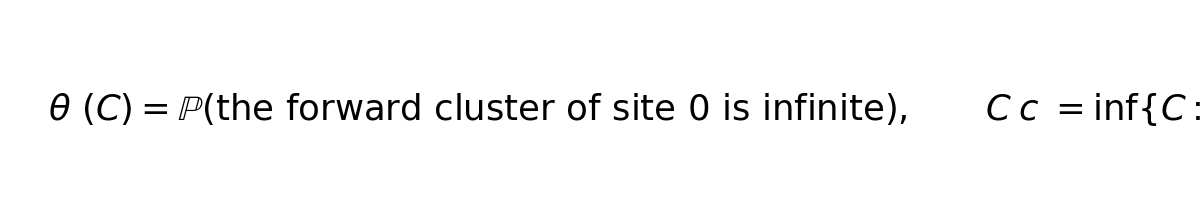
公式 2:渗流概率 θ(C) 与临界值 Cc 的定义。本文还考虑「有向渗流」(oriented percolation):只允许从左往右走的单调路径,不允许回头,对应的前向簇概率与有向阈值记作:
有向渗流的概率与阈值定义
公式 3:有向渗流的定义。单调路径本身也是路径,所以前向簇一定包含在普通连通簇里,θ→≤θ,由此得到一条非常关键的夹逼链:
有向阈值与无向阈值的关系
公式 4:有向阈值是无向阈值的上界。最后那个「≤1」是因为 C=1 时所有最近邻都连上了。这条不等式也解释了本文的证明策略:只要证出有向渗流的上界,无向模型的上界就自动到手,属于买一送一。
那 Cc(σ) 到底等于多少?抱歉,没人知道精确值。已有的结果只有两头:一头是 Schulman 通过和 Bethe 格点比较给出的下界,另一头是数值估计。下界长这样:
Schulman下界
公式 5:Schulman 给出的无向渗流阈值下界,其中 ζ 是黎曼 zeta 函数。本文在证明前还用一阶矩重新推导了一遍,无向模型的下界是 1/[2ζ(1+σ)],有向模型的下界是 1/ζ(1+σ):
无向与有向的一阶矩下界
公式 6:命题 1 给出的两个一阶矩下界。右边那一项 1/[Cζ(1+σ)] 其实还有更深的含义,后面讲有向渗流时再展开。
数值这边,Rego 等人发现阈值随 σ→0 线性消失,Grassberger 研究了等价的流行病传播过程,Gori 等人则给出了高精度的蒙特卡洛阈值,并观察到 σ 很小时数值结果会向 Schulman 的下界靠拢。但有个尴尬的事实:Newman 和 Schulman 证明的 Cc<1 是存在性的,没给出任何具体数字。据本文作者说,公开文献里此前没有任何关于 Cc(σ) 的显式上界。注意「显式」两个字,它意味着一个可以直接代入 σ 算出来的公式,而不是「存在某个小于 1 的数」这种话。
这事不只是数学游戏。长程渗流可以描述「带免疫的传播过程」:感染按幂律分布跨越距离传播,Cc 就是流行病阈值;它也标记了一类网络的转折点,越过它以后,带长程连边的网络虽然仍有无限簇,但簇内路径长度只随距离的对数增长;同时它还是分形网络、相互依赖网络等更复杂长程网络的参考值。
本文给出的结果可以概括成四条。第一,对任意步长分布 π,只要它满足 W(π)<∞,就得到渗流概率的一个下界(定理 2)。第二,选一组具体的重尾步长,得到闭式上界 CU(σ),它在 σ 很小时约为 σ+O(σ²),并且当 σ<0.667 时小于 1(推论 4)。第三,同样的界对有向渗流成立,而且渐近最优:σ→0 时 Cc→ζ(1+σ)→1,σ=0.1 时上下界只差 0.5%。第四,把站点换成块做粗粒化,可以得到对所有 σ<1 都成立的显式上界 Cc<1(定理 5 与推论 6)。
给一个能直接上手的例子。当 0<σ<1/2 时,只要 C 超过下面这个数,就保证存在无限簇:
一个显式可用的上界
公式 7:一个粗略但可用的上界。σ=0.2 时右边等于 0.246,而优化后的界是 0.185。作为对照,同一个 σ 下 Schulman 下界只保证 C>0.089 才可能有无限簇,蒙特卡洛数值阈值是 0.093。也就是说,真实阈值被夹在 0.089 和 0.185 之间。

二阶矩方法遇上重尾分布:如何计算共享键的代价
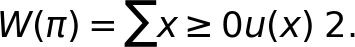
本文使用的工具叫「二阶矩方法」(second-moment method),思路非常朴素:不去直接构造无限簇,而是随机撒一条路径,证明它以正概率整条都是开的。关键在于这条随机路径的步长分布 π 是我们自己选的,跟模型里的键概率 pr 完全是两回事,π 必须归一化求和为 1,pr 则不是。说白了,这条路径是证明工具,不是模型属性。
先定义一条随机单调路径,起点为 0,每一步的步长独立同分布:
随机单调路径的定义
公式 8:随机单调路径的定义,站点严格递增。接下来定义一个加权计数变量 Zn,它把每条打开的 n 步路径按照 π(γn)/P(γn) 加权求和,其中 P(γn) 是该路径上所有键同时为开的概率:
加权计数变量Zn
公式 9:加权计数变量 Zn。注意它对随机路径取了期望,键的随机性仍然保留,所以 Zn 依旧是一个随机变量。它有两个性质。第一,关于键求期望恰好等于 1:
Zn的期望为1
公式 10:Zn 的期望恒为 1。第二,只要 Zn>0,说明至少有一条 n 步的单调路径是开的,而每一步长度至少为 1,所以前向簇里至少有一个距离 0 不小于 n 的站点。于是问题变成:Zn 大于零的概率有多大?用柯西—施瓦茨不等式,任意非负随机变量满足:
二阶矩不等式
公式 11:二阶矩不等式。因为 E Zn=1,所以 P(Zn>0)≥1/E Zn²。剩下的全部工作就是给二阶矩找一个不依赖 n 的上界。
把 Zn² 展开成对两条路径 γn、γn′ 的双重求和,再对键求期望。两条路径同时为开,等价于它们并集里的每根键都为开;而并集里一根键只出现一次,共享的键会被重复扣除:
两条路径同时为开的概率
公式 12:两条路径同时为开的概率,分母上正是共享键的乘积。代入后分母被约掉,二阶矩变成一个漂亮的期望形式:
二阶矩等于共享键成本的期望
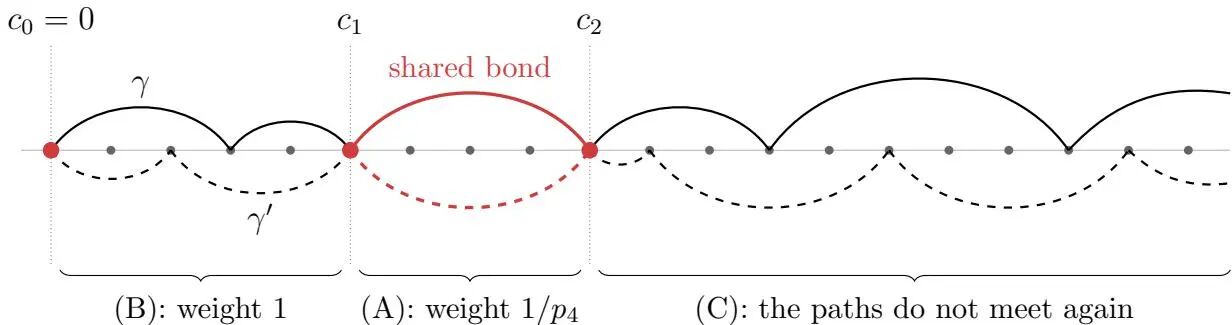
公式 13:二阶矩等于两条独立随机路径「共享键代价」乘积的期望。这就是整篇论文的心脏。一对没有任何共同键的路径贡献 1;而每共享一根长度为 r 的键,这对路径的贡献就乘上 1/pr。本文把多出来的部分 1/pr−1 称作共享键的代价,因为只有它才是真正拉高二阶矩、削弱界的东西。
两条独立单调路径与共同站点
图 1:两条独立的单调路径,实线 γ 画在格子上方,虚线 γ′ 画在下方。它们的共同站点是 c0=0、c1=5、c2=9。从 c0 到 c1 两条路径用的是不同的键;从 c1 到 c2 两条路径走了同一个长度为 4 的跳跃,于是共享了这根键;过了 c2 之后它们再没相遇。这个例子里共享键的乘积恰好等于 1/p4。
一维空间里有个天然麻烦:如果步长分布有有限的均值,两条独立的单调路径都会访问正比例的站点,于是必然无限次相遇,二阶矩直接发散,方法失效。唯一的出路是让步长分布重尾:步长恰好为 r 的概率按 r−1−α 衰减,且 α<1/2。这种情况下两条路径的共同站点数是有限的,这是更新理论里的标准结论。
但重尾不能重过头。步长越长,共享键的代价越大,代价的期望有限要求 α>σ/2。两个要求合在一起,把 α 逼进一条窄缝:
步长指数α必须落在的窗口
公式 14:步长指数 α 必须满足的窗口条件。左边的 α>σ/2 保证共享键代价的期望有限,右边的 α<1/2 保证两条路径只相遇有限次。这个窗口非空,当且仅当 σ<1,也就是恰好等于模型存在相变的参数范围。σ→1 时窗口收缩到单点 α=1/2,此时两个求和同时发散,界也就退化成平凡结果。这个巧合是整个方法能跑通的根本原因,也是这篇论文读起来最舒服的地方。
接下来引入两个量。第一个是「更新序列」(renewal sequence)u(x),表示随机路径访问站点 x 的概率:
更新序列u(x)
公式 15:更新序列 u(x) 的定义,起点 u(0)=1。第二个量 W(π) 是 u(x) 平方的求和。两条独立路径同时访问站点 x 的概率正好是 u(x)²,所以 W(π) 就是两条独立无穷路径共享站点数的期望值:
共享站点数的期望W
公式 16:W(π) 的定义。站点 0 一定被两条路径共享,所以 W≥1。在每一个共同站点上,两条路径各自重新开始,和之前的经历无关,这个「无记忆」性质让二阶矩变成一个可以精确求和的几何级数。令 S=Σπ(r)²(1/pr−1) 表示每个共同站点上的平均代价,则:
几何级数求和结果
公式 17:二阶矩的上界 V=1/(1−WS),条件是 WS<1。取倒数就得到渗流概率的下界,也就是本文的定理 2:
定理2的最终形式
公式 18:定理 2。θ→(C)≥1−W(π)Σπ(r)²(1/pr−1)。只要右边为正,就存在无限簇,于是 Cc≤Cc→≤C。这个式子只包含两样东西:步长分布 π,以及两条路径共享站点数的期望 W。对合适的 π 来说,两者都有闭式表达,这正是后面能算出显式上界的原因。用一句话概括这个机制:共同站点越多、共享键越贵,界就越弱;而 W 与 S 的乘积恰恰是「共同站点数」乘上「每个共同站点的平均代价」。

Sibuya步长与更新理论:闭式上界的推导
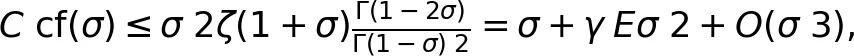
定理 2 还是个「条件式」结果,要变成能查表的数字,得挑一个具体的步长分布,而且它的更新序列和 W 都得能手算出来。本文选的是 Sibuya 分布,记为 πα,它的生成函数是:
Sibuya分布的生成函数
公式 19:Sibuya 分布的生成函数。把这个式子展开,能得到一个颇具美感的显式表达式:
Sibuya分布的显式形式
公式 20:Sibuya 分布的概率质量函数。这个分布有意思的地方是它取值范围是全体正整数,且缺失了 0 这个点,正好对应「步长至少为 1」的物理约束。它的尾部是幂律的,并且有一个干净的尾界:
Sibuya分布的尾界
公式 21:πα(r)≤αr−1−α。这个不等式在后续把无穷求和放缩成 zeta 函数时派上了大用场。再看它的更新序列,能满足递推关系 u(x)=Σπ(r)u(x−r),用生成函数求解后得到:
Sibuya步长的更新序列
公式 22:Sibuya 步长的更新序列 u(x)=Γ(x+α)/(Γ(α)x!),在 x 很大时约等于 xα−1/Γ(α)。这里的 Γ 是伽马函数,可以理解成阶乘在实数上的推广。有了 u(x) 的显式形式,W 和 Σπα(r)² 都能用超几何级数求和公式算出来:
更新序列的渐近形式
把上面这些结果代回定理 2,就得到本文的核心结论——推论 4,一个只跟 σ 有关、完全闭式的上界:
推论4给出的上界CU
公式 23:推论 4。CU(σ) 是在窗口 σ/2<α<1/2 内对 α 取最小值的结果。分子是 Σπα(r)²r1+σ,本质上就是共享键的期望代价;分母是 1/W 加 Σπα(r)²,也就是共同站点的成本与共享键的成本之和。再用尾界把分子放大成 α²ζ(1+2α−σ),就得到更保守但更漂亮的闭式:
闭式上界的渐近展开
公式 24:闭式上界 Ccf 在 σ<1/2 时的简单形式,以及它在 σ→0 时的展开 σ+γEσ²+O(σ³),其中 γE≈0.577 是欧拉常数。把这条上界和 Schulman 的下界一起看,就得到 σ 很小时的夹逼结果,Cc/σ 被牢牢压在一个区间里。这个结论之所以重要,是因为它把一个此前只有数值猜测的渐近标度关系,第一次变成了严格定理。

有向渗流:渐近最优的阈值估计

因为本文用的随机路径本身就是单调的,所有结果对有向渗流同样成立;再结合公式 4 的夹逼链,有向的上界立刻变成无向的上界。有向模型还有一个额外好处:它的界渐近是紧的。σ→0 时有向阈值满足 Cc→ζ(1+σ)→1,数值上 σ=0.05 时上下界之比是 1.0006,σ=0.1 时是 1.005,σ=0.2 时是 1.035。这个精度已经不像上界,更像半个答案。
为什么有向模型这么乖?论文给了一个很直观的解释。一个站点向右平均有 Cζ(1+σ) 根开键。如果不同路径到达的站点彼此不重合,就像一棵树那样,前向簇就等价于一个分支过程,每个站点平均有 Cζ(1+σ) 个后代。分支过程能永久存活,当且仅当平均后代数超过 1,也就是 C>1/ζ(1+σ)。这正是平均场意义下的阈值。命题 1 说明真实阈值不会比它更低,而推论 4 说明 σ 很小时它只高一点点。换句话说,小 σ 下的有向相变是平均场式的,路径之间的重合此时是可以忽略的高阶效应。

粗粒化与块方法:对所有 σ<1 的显式上界

推论 4 只有在结果小于 1 时才有用,而这个条件只在 σ<0.667 时满足。原因是共享键的代价 1/pr−1=r1+σ/C−1 至少是 1/C−1,还会随着 r 迅速膨胀,σ 越大膨胀越凶。到了 σ→1,界就毫无悬念地退化成平凡结果。
降低成本的办法是把站点打包成「块」。用 L 个连续站点组成一个块,考虑相隔 r 个块(以块为单位)的两个块,它们之间有 L² 对站点,每对站点的距离大约是 rL,于是两块之间的平均键数约为:
两块之间的平均键数
公式 25:两个块之间的平均键数。和两个单站点之间的 C/r1+σ 相比,多了 L1−σ 倍。块之间的连接概率自然地由块间所有站点对的键共同决定:
块间连接概率
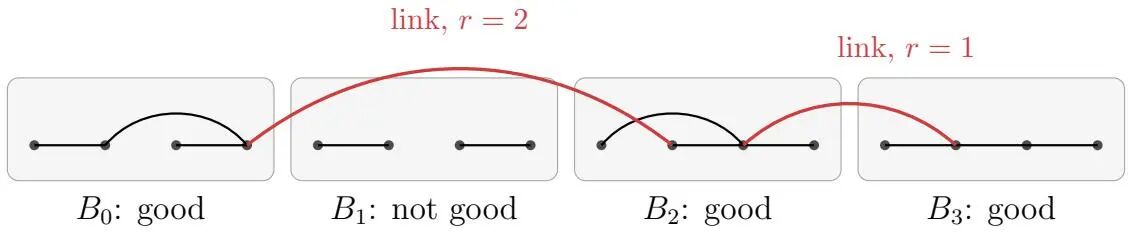
公式 26:块间连接概率 pr(L)。好处当然不是白拿的:块间的连接只有在每个块「内部连通」时才有意义。本文把块内任意两个站点都能通过块内路径连通的块称为「好块」,其概率记为 gL。于是定理 2 长出一个新项:
定理5的块版本界
公式 27:定理 5。此时随机路径变成一条「块路径」,求和项是共享块间连边的平均代价,而新增的 1−gL 就是「块必须内部连通」的成本。L=1 时 g1=1,定理 5 退化为定理 2。取 L 为满足 L1−σ≥4W(α)α²ζ(1+2α−σ) 的最小整数,就得到对所有 σ<1 都成立的显式上界:
推论6的显式上界
公式 28:推论 6。Cc(σ)≤1−1/[2W(α)(L−1)],严格小于 1。Cc<1 这件事本身早已知晓,推论 6 的价值在于它是显式的,能把具体数字算出来。作者自己也很坦白:这个界离紧差得远,真正好用的数值要靠直接代入定理 5 的表达式去优化。
L=4时的块与块间连接示意
图 2:L=4 个站点的块。黑色线表示块内的开键。块 B0、B2、B3 是「好块」,内部任意两个站点都能连通;块 B1 不是好块,它内部裂成了两对。红色线是块与块之间的开键:B0 与 B2 相连(块单位距离 r=2),B2 与 B3 相连。这三个好块构成一条开块路径,它们的全部站点属于同一个连通簇。

数值比较与讨论:上界与蒙特卡洛阈值的差距

先说实验设置这一侧。这篇论文属于纯解析的理论工作,没有数据集、没有训练流程,全部结论都是定理与推论,数值部分只是把闭式表达式代进去求最小值并与已有蒙特卡洛结果对拍。对拍对象是 Gori 等人发表的高精度阈值表,其误差棒比图中符号还小。这种「定理 vs 高精度数值」的验证方式在概率论里是标准的,可信度取决于推导是否自洽,以及数值是否复现得了。
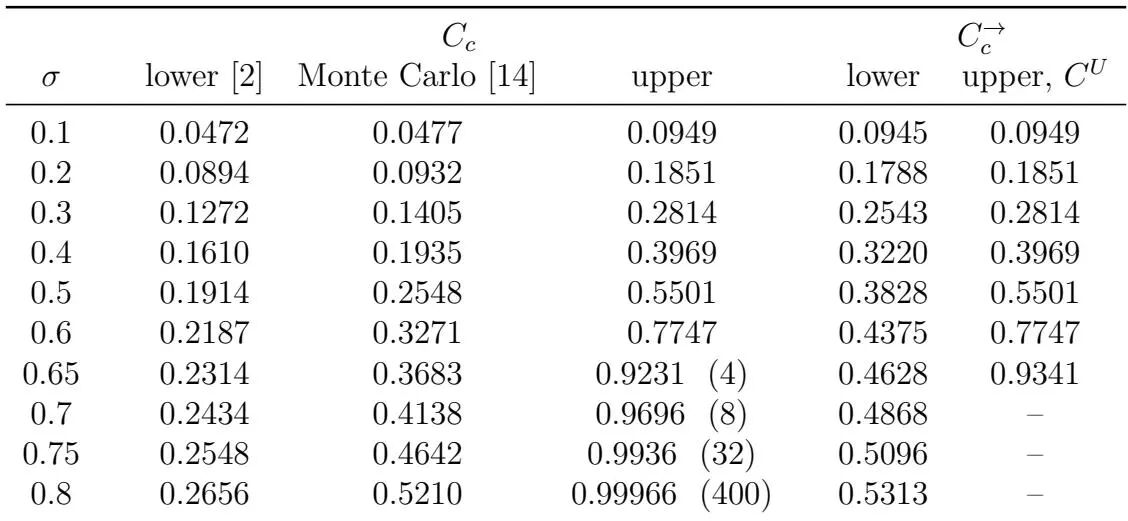
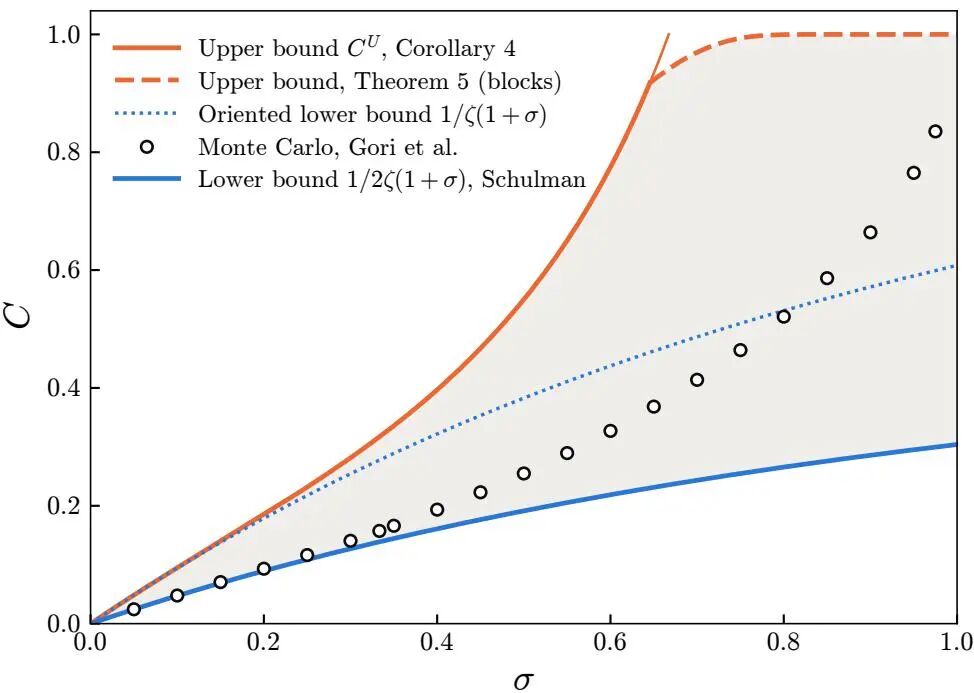
结果层面,有向模型的两个界在小 σ 时贴得很紧,上文已经给过比值。无向模型的上有界在小 σ 时大约是高精度数值的两倍,而且随 σ 增大越来越松,这一点在表 1 中一目了然。
阈值上下界与蒙特卡洛值的对照表
表 1:长程渗流阈值 Cc 与有向阈值 Cc→ 的各路结果对照。左侧四列是无向模型:Schulman 下界、Gori 等人的蒙特卡洛值、本文上界;右侧两列是有向模型:一阶矩下界与本文上界 CU。σ≤0.6 时上界取推论 4 的 CU,σ≥0.65 时取定理 5 的块方法结果,括号里是所用块尺寸 L。短横线表示 CU>1,也就是该 σ 下这一路界已经失效。
各阈值随sigma变化的曲线对比
图 3:阈值随 σ 变化的曲线。粗蓝线是 Schulman 给出的无向下界;圆圈是 Gori 等人的蒙特卡洛阈值,误差棒小于符号本身;橙线是本文给出的上界,实线为推论 4 的 CU,虚线为定理 5 的块方法结果(σ>0.645 时虚线更优)。虚线在所有 σ<1 时都低于 1,但 σ>0.8 之后它离 1 只差一个线宽。真实阈值 Cc 落在阴影区域内。点状蓝线是有向阈值下界 1/ζ(1+σ),有向上界就是橙线 CU,它在 σ≈0.667 处达到 C=1。也就是说,有向阈值被夹在点状蓝线和橙线之间。
还有几个数字值得记一下。闭式上界 Ccf 比优化后的 CU 更弱:σ=0.1、0.2、0.3、0.4、0.5 时分别等于 0.106、0.228、0.377、0.578、0.871,σ≥0.54 时直接超过 1。粗粒化方法在 σ 较大时需要用很夸张的块尺寸才有效,比如 σ=0.8 时要取 L=400,界才压到 0.99966。这说明块方法的价值在于「证明 Cc<1 对所有 σ<1 成立」,而不在于给出好用的数值。
至于无向模型上界与真实阈值在小 σ 时的两倍差距,论文在最后一节做了讨论。一个不可忽视的线索是:无向模型的一阶矩下界本身就比有向的一半还小(1/[2ζ] 对 1/ζ),因为不加方向限制后,计数路径时可以往左也可以往右,项数多了一倍。这显然不能直接解释上界的差距,但它提醒我们,两倍的缝隙在这个模型里出现得并不偶然。

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?一维长程渗流提出四十余年,临界阈值始终只有下界和数值估计。本文用重尾随机路径配合二阶矩方法首次给出显式上界,σ较小时上界低于1,有向渗流的阈值在σ趋近0时约等于σ,粗粒化后又覆盖全部σ小于1的情形。
这篇工作最值得看的点是什么?论文提出的上界 $C^U(\sigma)$ 在 $\sigma<0.667$ 时低于 1,给出了非平凡的显式上界;对于有向渗流,上界与下界在 $\sigma=0.1$ 时仅差 0.5%,且证明了有向阈值渐近为 $C_c^{\to}\zeta(1+\sigma)\to 1$;粗粒化方法给出了对所有 $\sigma<1$ 的显式上界 $C_c<1$。
这篇工作的边界或风险在哪里?优点:首次给出了一维长程渗流阈值的显式上界,方法优雅,利用更新理论精确计算了二阶矩中的共享键代价,结果具有闭式表达,且对有向渗流渐近最优。缺点:上界在 $\sigma$ 较大时接近平凡上界 1,对于无向模型,上界约为下界的两倍,未能闭合这一差距;方法依赖于单调路径,无法直接推广到无向情形。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

将二阶矩方法应用于一族步长服从重尾(Sibuya)分布的随机单调路径,利用更新理论精确计算两条独立路径的公共站点数与共享键代价,从而得到一维长程渗流阈值 $C_c(\sigma)$ 的显式上界。

实验合理度:★★★☆☆

现有材料未完整覆盖数据划分、基线公平性和统计显著性,因此按中性评价处理。

学术研究价值:★★★★☆

将二阶矩方法应用于一族步长服从重尾(Sibuya)分布的随机单调路径,利用更新理论精确计算两条独立路径的公共站点数与共享键代价,从而得到一维长程渗流阈值 $C_c(\sigma)$ 的显式上界;更关键的是问题定义是否可复用到同类任务。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

现有材料缺少完整训练资源、参数量、显存和推理时延信息,成本暂按中性评价。

复现难度:★★★☆☆

https://github.com/guy531/long_range_upper_bound

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:上界在 $\sigma$ 较大时接近平凡上界 1,对于无向模型,上界约为下界的两倍,未能闭合这一差距;方法依赖于单调路径,无法直接推广到无向情形。

主要参考文献

Guy Amit. Explicit upper bounds on the threshold of one-dimensional long-range percolation. arXiv:2610.11872. https://arxiv.org/pdf/2610.11872v1.pdf
[1] Zhang, Pu, Li. 一维长程渗流模型的提出(长程键渗流的最早模型之一)。
[2] L. S. Schulman. Long range percolation in one dimension. 给出下界 Cc≥1/[2ζ(1+σ)]。
[4] C. M. Newman, L. S. Schulman. One-dimensional 1/|i−j|s percolation models: the existence of a transition for s≤2. 用多尺度重整化证明 0<σ<1 时存在非平凡相变。
[10] 关于 σ<1/3 时平均场行为的严格证明。
[12] H. H. A. Rego 等. 蒙特卡洛研究,发现阈值随 σ→0 线性消失。
[13] P. Grassberger. 研究等价的流行病传播过程。
[14] G. Gori 等. 高精度确定 Cc(σ),本文数值对照与表 1 的数据来源。
[20] 二阶矩方法;[21] 开路径的加权计数;[22] Cox, Durrett 在多维渗流中的应用;[23] Lyons 在一般树上的应用;[24] Benjamini, Pemantle, Peres 在 Z³ 上的应用;[25] Bäumler 在无界长键模型上的应用。
[29] 更新序列与更新理论;[30] M. Sibuya. 广义截断负二项分布的研究,Sibuya 分布的出处。

*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球