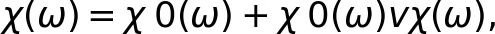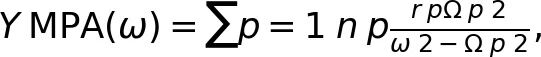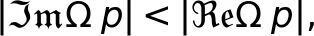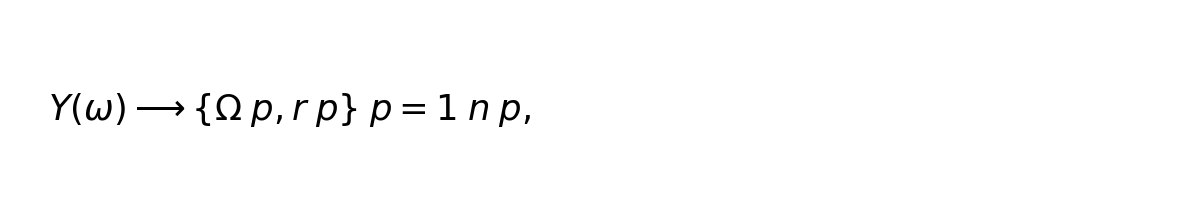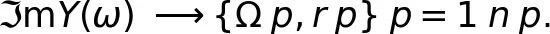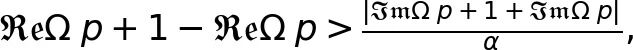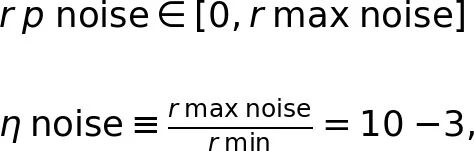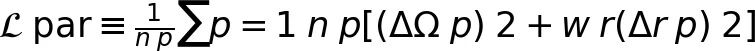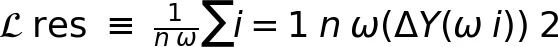← 返回 PaperDaily 大模型与智能体

奥斯陆大学:不靠材料数据库,CNN单次前向反演介电谱极点

介电谱里藏着等离激元的能量位置和展宽,但传统做法要靠非线性拟合一点点抠,初始化选不好还容易翻车。这篇论文换了个思路:用纯解析公式生成合成谱,让一个约百万参数的卷积网络把反演任务一次性学会,单次前向直接吐出极点参数,全程不碰材料数据库。它到底能不能迁移到真实第一性原理谱和实验谱?边界又在哪里?值得花时间看一眼。

奥斯陆大学:不靠材料数据库,CNN单次前向反演介电谱极点
原论文信息如下:
论文标题:
Predicting plasmonic pole representations of complex dielectric spectra using convolutional neural networks
发表日期:
2026年10月
发表单位:
挪威奥斯陆大学材料科学与纳米技术中心(Centre for Materials Science and Nanotechnology, University of Oslo)
原文链接:
https://arxiv.org/pdf/2610.11698v1.pdf

介电谱反演难题:从非线性拟合到神经网络直推
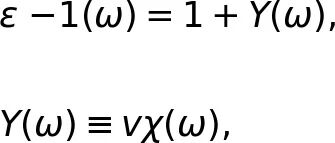
先得说清楚这篇论文在跟什么较劲。材料被电磁场照一下,内部电子会响应、会屏蔽、会集体晃动,这套行为被一个频率相关的复函数记录在案,也就是介电函数 ε(ω)。它的倒数 ε⁻¹(ω) 直接描述动态屏蔽过程,是理解电子集体激发(比如等离激元)的关键入口。等离激元(plasmon)可以粗略理解为电子气的集体振荡被量子化之后的产物,在金属、半导体、低维材料里都很常见。
逆介电函数定义
公式1:逆介电函数的分解式。ε⁻¹(ω) = 1 + Y(ω),其中 Y(ω) ≡ vχ(ω)。v 表示库仑相互作用,χ(ω) 是相互作用密度响应函数,Y(ω) 就是其中真正随频率变化的那部分,也是本文建模的对象。
在复频率平面上,这些集体激发会以极点的形式出现:极点的实部给出激发能量,虚部给出这个激发的展宽(可以理解为寿命相关的量),而残差(谱权重)则说明这个激发在整体响应里占多大分量。把这组极点参数抠出来,相当于给一条谱线做了一次物理上可解释的参数化,往后算 GW 近似(一种用于计算准粒子能带的多体方法)、求解 Bethe-Salpeter 方程(Bethe-Salpeter equation,BSE,用于描述电子-空穴对的激发),或者解读吸收谱、非弹性 X 射线散射谱、电子能量损失谱(electron-energy-loss spectroscopy,EELS),都可以直接拿来用。
问题在于,从一条已经算好或者测好的谱,反过来推极点参数,是个典型的反问题。传统做法是非线性拟合:先猜一组初始参数,再迭代优化。这条路能走通,但毛病不少——计算量大,而且对初始化极其敏感,拟合区间的选择、极点数目的设定稍有不同,结果就可能飘。要处理成百上千条谱,还要做到自动化、高通量,这套流程很容易变成瓶颈。
v2-74ba8bc1c6c52a48ea1c3c5c67685ca3_hd.jpg
这篇来自挪威奥斯陆大学材料科学与纳米技术中心的论文,换了个思路:既然反演难在非线性拟合,那就让神经网络把映射关系直接学下来。训练完成之后,网络对一条新谱只需要一次前向传播,就能吐出对应的极点参数,不再逐条迭代。方向本身不算天马行空,但作者在训练数据的选择上做了一个有意思的决定——完全不用真实材料数据,后面细说。

多极Padé表示:用极点参数刻画等离激元

要把反演讲清楚,先得知道目标长什么样。多体微扰理论(many-body perturbation theory,MBPT)里,相互作用响应可以从一个 Dyson 方程出发,把完整响应和不可约极化率联系起来。在随机相位近似(random-phase approximation,RPA)层面,不可约极化率用独立粒子极化率替代,剩下的 Dyson 方程就负责描述库仑屏蔽过程。
RPA Dyson方程
公式2:RPA 层面的密度响应方程。χ(ω) = χ₀(ω) + χ₀(ω)vχ(ω),其中 χ₀(ω) 是独立粒子极化率,第二项承担库仑屏蔽的贡献。本文用作参照的第一性原理谱就是在这一层面计算的,但要注意,合成训练数据完全由解析表达式生成,与具体采用哪一级多体理论无关。
第一性原理算出来的响应函数里,本来包含大量单粒子激发的贡献,这些贡献通过 Dyson 方程彼此耦合,共同堆出等离激元这类结构。尽管底子这么复杂,Y(ω) 的频率依赖往往仍然可以用一组数量不多的集体激发来紧凑描述,这就是多极帕德近似(multipole-Padé approximant,MPA)的用武之地:用有限个复极点和对应的谱权重,把整条响应表达出来。
论文采用时间有序(time-ordered)形式,把 MPA 写成一组极点项之和。这里的 n_p 是多极贡献的数目,Ω_p 是复极点参数,r_p 是对应的权重。
MPA表示
公式3:多极帕德表示。Y_MPA(ω) = Σ (r_p Ω_p²) / (ω² − Ω_p²),求和从 p = 1 到 n_p。n_p 是极点数目,Ω_p 是复极点,r_p 是谱权重。
物理约束是这套表示的灵魂。约定实部为正、虚部为负,用正实部的极点来标记;对时间有序响应,极点虚部满足 Im Ω_p < 0;同时要求极点离实频率轴比离虚频率轴更近,也就是虚部的绝对值小于实部绝对值。这样,实部决定激发能量,虚部决定展宽,权重则约束为实数且为正。这些约束不是装饰,它们直接决定了后面网络输出该怎么参数化。
极点约束
公式4:极点虚部的约束条件 |Im Ω_p| < |Re Ω_p|,保证极点待在实频率轴附近,避免出现物理上不合理的极窄或者发散行为。
从这里就能看出作者的两层考虑。第一层,MPA 提供了紧凑且物理可解释的表示;第二层,极点位置的确定是非线性的、相对困难的,而一旦极点固定,权重可以通过线性问题快速求出。这个结构差异后来直接影响了两处设计——损失函数的权重分配,以及网络输出的参数化方式。

合成数据训练策略:不依赖材料数据库的泛化之路

反演问题有两个版本。第一种用完整的复响应 Y(ω) 作为输入;第二种只用它的虚部 Im Y(ω)。两者的目标都是同一组极点参数。完整复数的版本信息最全,精度略高;只用虚部的版本则更贴近实验现实——很多实验手段直接测到的就是虚部。因为 MPA 参数本身定义了完整的复响应,从 Im Y(ω) 反推出参数之后,实际上也顺带得到了实部,不必再大动干戈地做 Kramers-Kronig 变换。
全复数反演
公式5:基于完整复响应的反演。输入 Y(ω),输出一组极点参数 {Ω_p, r_p},p = 1 到 n_p。
虚部反演
公式6:基于虚部响应的反演。输入 Im Y(ω),输出同一组极点参数。这条路线直接对应那些只能测到虚部的实验场景。
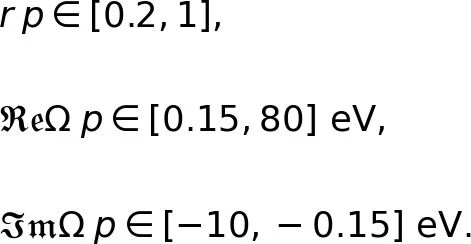
接下来是最关键的决定:训练数据怎么来。论文没有去收集某个材料数据库里的一堆谱,而是直接拿 MPA 解析表达式生成合成谱。具体来说,极点数目 n_p 从 1 一路取到 5,每个 n_p 生成 20000 条谱;每条谱在 100 eV 的区间里均匀取 1000 个频率点。极点参数在给定的范围内随机采样:权重 r_p 在 0.2 到 1 之间,极点实部在 0.15 到 80 eV 之间,虚部在 −10 到 −0.15 eV 之间。
采样范围
公式7:极点参数的采样范围。权重的下限排除了谱权重趋近于零、几乎无法识别的极点;实部的下限排除了激发能量趋近于零的极点;虚部绝对值的下限则避免出现任意尖锐的极点,因为那种情况下的反演条件数很差、数值上不好处理。
对含多个极点的谱,作者还加了一条类似瑞利判据的限制:相邻极点的实部间隔,必须大于两者展宽之和除以一个系数 α(这里取 1)。通俗点说,就是别让两个激发挤得太近、宽得糊在一起,否则谱上根本分不出谁是谁。这条约束保证了合成集合里每条谱和它的极点参数之间有一一对应、可辨识的关系。
可分辨性判据
公式8:相邻极点之间的可分辨性条件。极点实部之差要大于两者虚部之和除以 α,防止训练集中出现能量间隔相对展宽过小、彼此无法区分的极点对。
为了测试反演的鲁棒性,作者又在干净集合的基础上做了一个含噪声版本:额外塞进 200 个随机采样的 MPA 贡献,它们的极点铺满整个 100 eV 区间,但残差都很小,最大噪声残差相对最小物理残差的比值被固定在 10⁻³。这些额外极点不进入目标参数,只作为对输入谱的受控扰动。干净集和含噪集各训一套模型,就能把“弱谱扰动”这一因素单独拎出来评估。
噪声极点定义
公式9:噪声集的定义。噪声残差在 0 到上限之间取值,而噪声残差上限与最小物理残差的比值 η_noise 恒为 10⁻³,对应最大噪声残差约为 2×10⁻⁴,确保扰动足够弱但仍可感知。
最后,数据按 80% 训练、20% 验证划分,每个 n_p 各自划分,干净集和含噪集用同一套划分方式。验证集不参与参数优化,只用来在训练过程中盯住模型表现。到这里,数据侧的设计就闭环了:既不依赖任何真实材料的相关性,又能覆盖从单极点到五极点的全部复杂度。

CNN架构与物理约束:单次前向推断极点参数

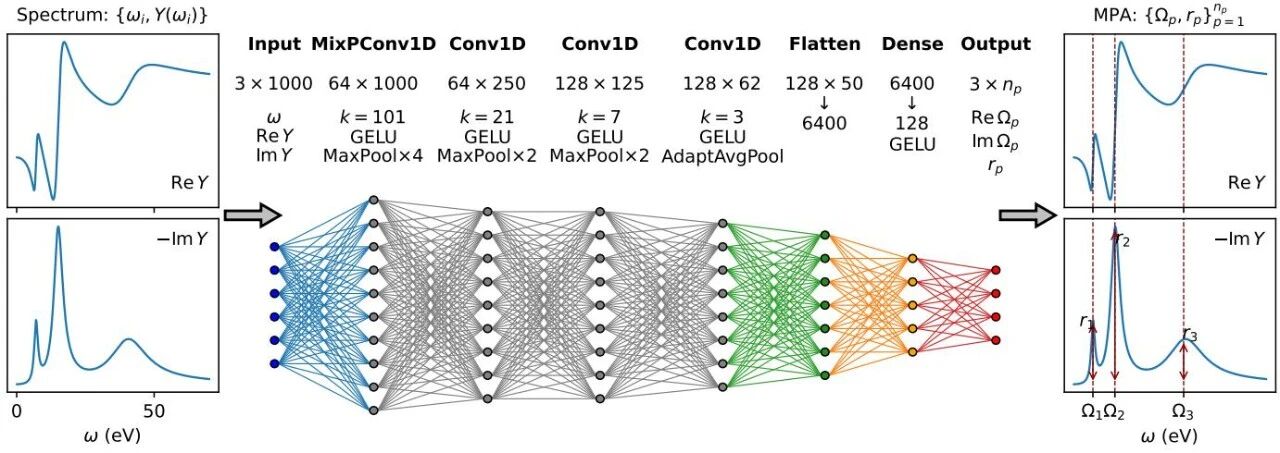
模型本身并不复杂,用的是一个一维卷积神经网络(convolutional neural network,CNN)加一个全连接回归头。输入按通道组织,一个通道是频率网格,另外的通道是 Y(ω) 可用的分量,具体是哪几个分量由前面选定的反演版本决定。卷积层逐级提取谱特征,每个卷积层后面接高斯误差线性单元(Gaussian Error Linear Unit,GELU)激活,前三次卷积之后还接了最大池化来压缩频率轴的维度。
卷积核尺寸的设计是有讲究的:第一层用 101 这样的大核,抓的是宽泛的谱结构;后面三层依次用 21、7、3 这样逐渐变小的核,抓的是更精细的谱细节。之后一个自适应平均池化把特征压到固定尺寸 128×50,展平,送进一个 128 神经元的全连接层,再加一层线性层,输出 3n_p 个量,正好对应每个极点的实部、虚部和残差三项。
CNN架构示意图
图1:用于推断介电谱多极帕德表示的卷积神经网络架构示意图。输入为频率网格以及介电响应的实部和虚部 {ω_i, Re Y(ω_i), Im Y(ω_i)},采样于 n_ω = 1000 个频点。卷积部分包含四层一维卷积,卷积核尺寸分别为 k = 101、21、7、3,前三次卷积后接 GELU 激活和最大池化;自适应平均池化把特征压缩到 128×50,展平后经过一个 128 神经元的全连接层和 GELU 激活,最后由线性层输出 3n_p 个 MPA 参数 {Re Ω_p, Im Ω_p, r_p}。左侧谱线为输入响应,右侧为根据预测参数重建的响应,上下两栏分别为实部与虚部。
整个网络大约 100 万个可训练参数,单精度存储约 4 MB。作者坦言,这个规模是为了在精度和计算成本之间取一个实用平衡,不是什么理论上限——想提升表达能力,把卷积滤波器数量或者全连接神经元数量加大就行;想支持更多极点,也只需要相应加大最后输出层的维度。
训练目标把两件事捏在一起:预测参数准不准,以及用这些参数能不能把输入谱重建回来。前者是参数损失,后者是响应重建损失,两者加权求和得到总损失。权重的设置颇有心机:残差项权重给到 5,重建项权重给到 1,也就是更看重极点本身。原因前面提过——极点位置是非线性确定的,比较难;而极点一旦定下来,残差只是线性问题,容易得到。这种加权等于把优化压力更多地压在更难的那半边。
参数损失
公式10:参数损失 L_par,逐项计算极点参数误差的平方和,其中 ΔΩ_p 是极点预测值与真实值之差的平方,Δr_p 是残差之差,w_r 用来调节残差项的相对权重。
重建损失
公式11:响应重建损失 L_res,衡量用预测参数重建出来的响应与真实响应之间的差异,在 n_ω 个频点上取平均。
总损失
公式12:总损失 L_tot = L_par + w_Y · L_res,w_Y 控制两项的平衡。本文取 w_r = 5、w_Y = 1,意味着参数(尤其是极点)比残差和重建更受重视。
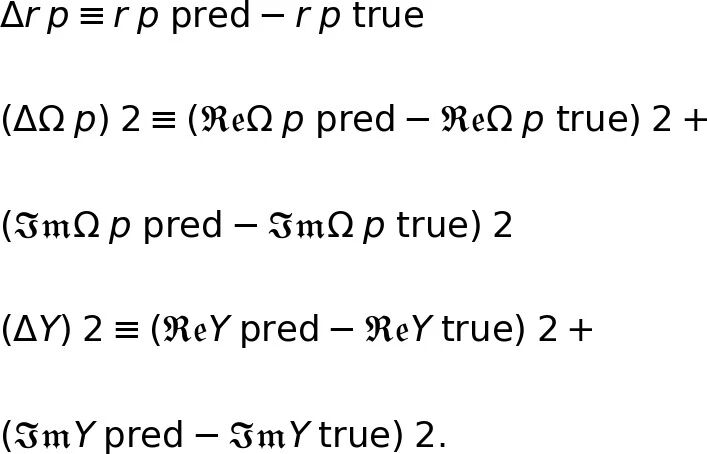
误差定义
公式13:各项误差的具体定义。Δr_p 是残差预测值与真实值之差;ΔΩ_p 的平方是极点实部和虚部误差平方之和;ΔY 的平方是响应实部和虚部误差平方之和。
训练最多跑 300 个 epoch。在这个范围内,训练损失和验证损失都下降了好几个数量级并逐渐趋于饱和,两条损失始终贴得很近,说明网络已经训到了继续优化收益甚微的阶段,同时还没有滑入过拟合。物理约束不是事后补的,而是直接编进输出参数化里,这样网络吐出来的参数天然就在合理区域,不需要额外再筛。

从第一性原理到实验光谱:跨材料验证与局限分析


实验结果分析
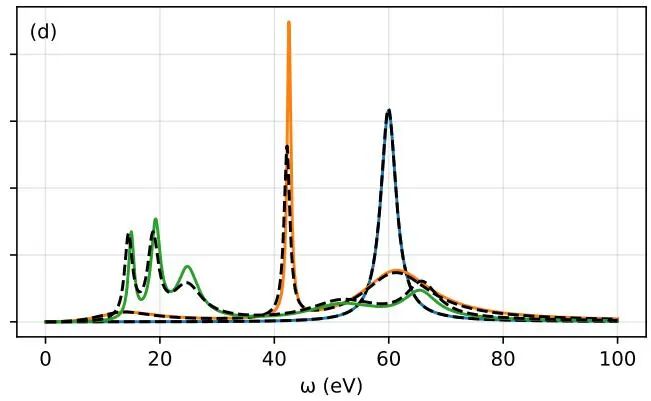
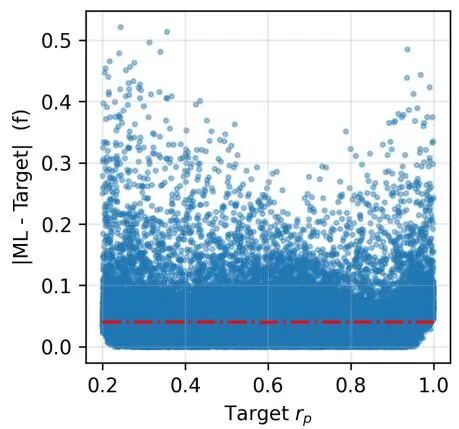
先看合成谱上的自洽验证。论文展示了 n_p 为 1、3、5 时的代表性谱线,把干净谱、含噪声谱、以及由预测参数重建的谱摆在一起对比。重建谱和目标谱之间的贴合程度相当高,说明网络确实学到了从谱到极点参数的紧凑映射。值得一提的是,含噪声训练出来的模型在重建上更贴一些,这个细节在后面的第一性原理谱上还会再出现。之后作者把 n_p = 2 这一带谱叠加的最简情况单独拎出来细看:预测参数与目标参数几乎落在恒等线上,绝对误差整体很小,说明位置、展宽、残差三项都能被稳定恢复。
干净含噪与重建谱
图2:由 3 至 5 个极点生成的干净谱、含噪声谱与机器学习重建谱示例。上下两行分别为实部和虚部;左列(a、c)对比干净谱与其含噪声版本,右列(b、d)对比干净谱与噪声训练模型的重建结果。实线为干净谱,黑色虚线为机器学习重建,不同颜色对应不同极点数目 n_p。
n_p=2 参数对比
图3:n_p = 2 的全部样本中目标与机器学习预测的多极帕德参数对比。上方(a-c)分别为 Re Ω_p、Im Ω_p、r_p 的预测值随目标值变化,红色虚线为恒等关系;下方(d-f)为对应的绝对误差,水平点划线表示平均误差。
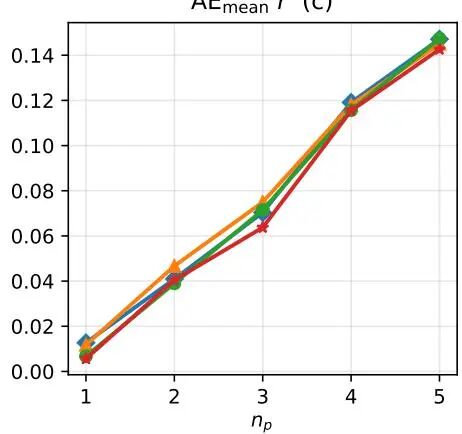
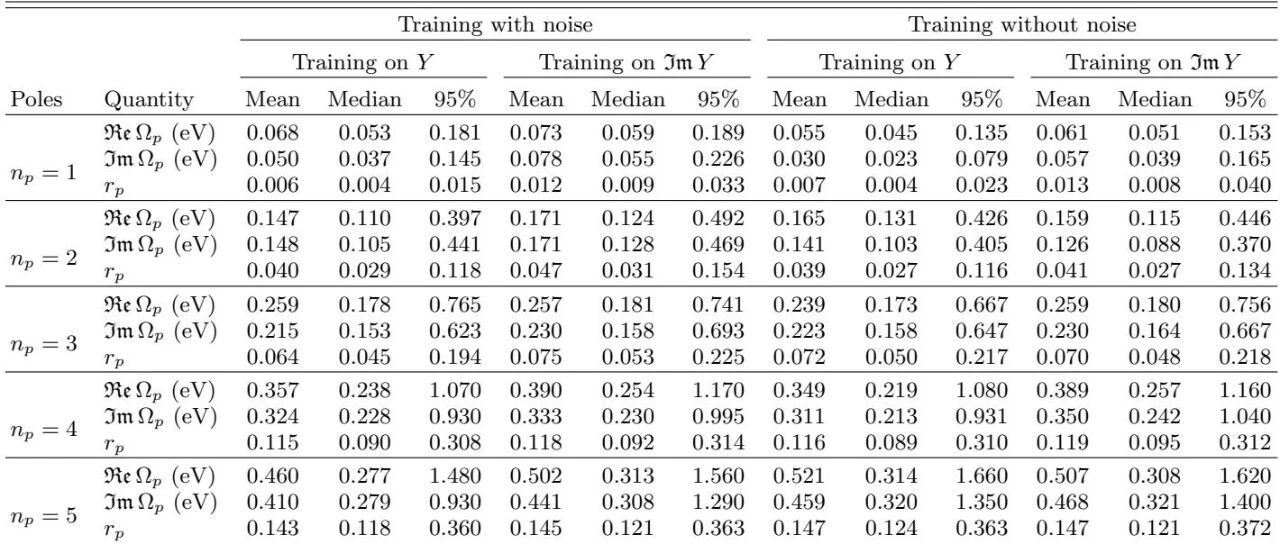
再看误差随谱复杂度的变化,这部分是理解方法边界的核心。四个模型表现出的趋势一致:不管用全复数还是只用虚部、不管含噪还是干净,三个参数的误差都随极点数目 n_p 单调上升。这个现象不难理解——极点越多、重叠越多,单独分辨并归属每个极点的贡献就越难。作者也指出,这种尺度关系暗示网络容量可以跟着谱复杂度走,比如极点多了就把模型做大一点,但在本文覆盖的 n_p 范围内,现有架构精度已经够用,所以没有额外折腾。
这里还有一个容易被忽略但很重要的观察:参数误差变大,并不等于重建响应误差也按同样比例变大。多个极点叠加时,各自被残差加权,一个谱权重很小、位置或展宽估得不太准的极点,对总响应的贡献本来就很弱;反过来,起主导作用的极点决定了大部分谱形,通常恢复得也更准。所以评估反演质量时,参数误差要和响应重建误差一起看,单看前者容易低估整体效果。
四个模型之间,含噪与不含噪的差别其实不大,和 n_p 增大带来的误差增长比起来是小头。略微系统性的一个差别是:用全复数 Y(ω) 训练的模型,参数误差普遍低于只用 Im Y(ω) 的模型,说明实部确实提供了互补信息。但只用虚部的模型表现也很接近,这就很关键了——它意味着推断极点参数所需的大部分信息,本来就藏在虚部里。对实验场景来说,这几乎是把门直接打开了,因为很多实验直接可测的就是虚部。
误差随极点数目变化
图4:四个机器学习模型的平均绝对误差 AE_mean 随极点数目 n_p 的变化,分别对应 Re Ω_p(a)、Im Ω_p(b)和 r_p(c)。四个模型分别用全复数响应 Y(ω) 与仅虚部 Im Y(ω) 训练,且各自分为含噪声与不含噪声两组。
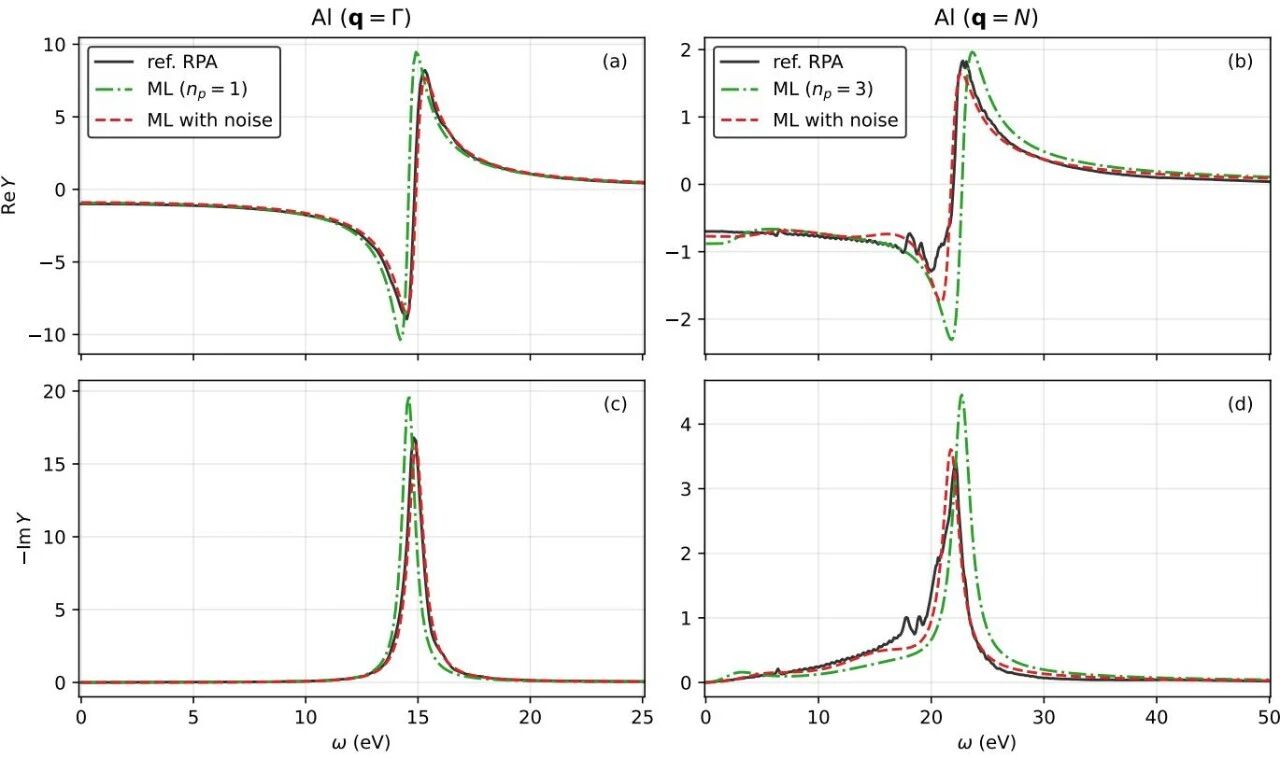
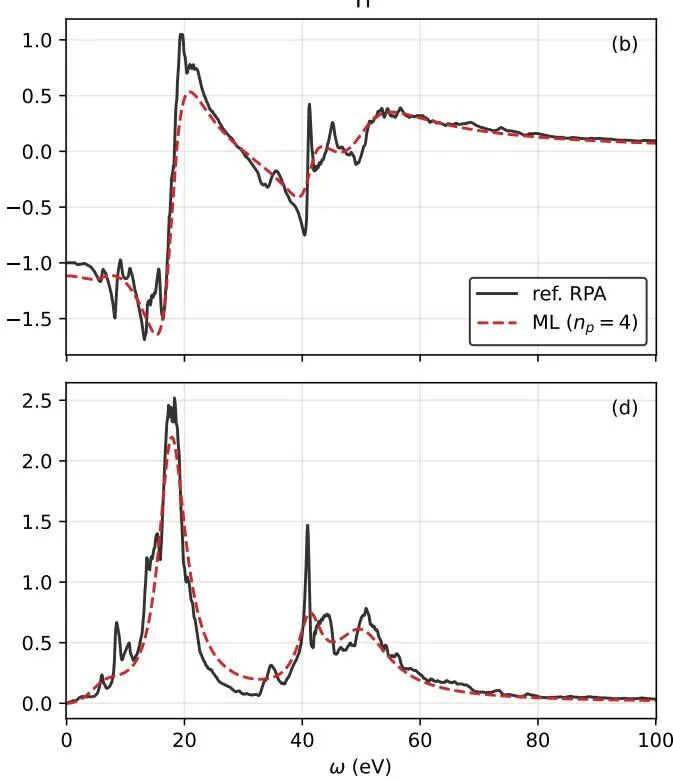
接下来是最有说服力的部分:从合成谱迁移到第一性原理谱。论文拿体相铝(Al)在两个动量转移下的 RPA 谱做了测试。q = Γ 对应光学极限 q = 0,主要谱结构用 n_p = 1 就能抓住;q = N 对应布里渊区边界点,需要用 n_p = 3。两种情况下,CNN 重建都紧贴 RPA 响应,实部和虚部的主特征都跟得上,而且含噪训练的模型重建更准,和合成验证里的表现一致。这条结果的价值在于:这些第一性原理谱完全不在训练集合里,网络却能把从合成 MPA 响应学到的反演映射迁移过来。
Al的RPA谱
图5:CNN 模型应用于体相铝(Al)在两个动量转移 q 下的 RPA 介电谱。上下两行分别为 Y(ω) 的实部(a、b)和虚部(c、d);q = Γ(a、c)对应光学极限 q = 0,q = N(b、d)对应布里渊区边界点 N。RPA 谱与由含噪声/不含噪声训练的 CNN 预测参数重建的响应放在一起对比,q = Γ 使用 n_p = 1,q = N 使用 n_p = 3。
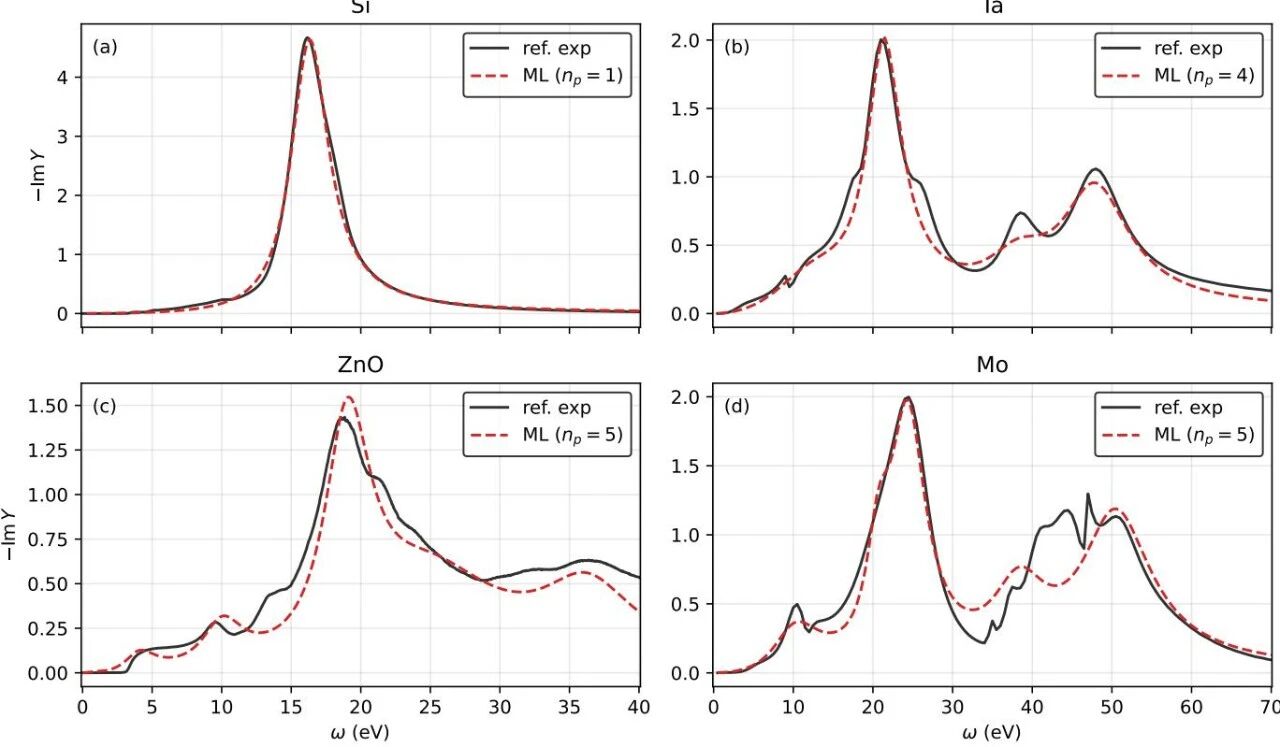
钙(Ca)和钛(Ti)的光学极限谱进一步扩展了材料覆盖面,Ca 用 n_p = 3,Ti 用 n_p = 4,重建同样贴合。真正让人眼前一亮的是实验谱:硅(Si)、氧化锌(ZnO)、钽(Ta)和钼(Mo)都是真实测量数据,作者用表现最好的模型去反演,Si 用 n_p = 1,Ta 用 n_p = 4,ZnO 和 Mo 用 n_p = 5。对一批在训练里从未出现过的实验响应,网络仍然能给出合理且紧凑的极点表示,这就把方法的实用性从“算得动”推到了“测得准”的门槛上。
Ca和Ti的RPA谱
图6:CNN 模型应用于体相钙(Ca)和钛(Ti)在光学极限 q = 0 下的 RPA 介电谱。上下两行分别为 Y(ω) 的实部(a、b)和虚部(c、d),Ca 对应(a、c),Ti 对应(b、d)。每个材料都将 RPA 谱与表现最好的 CNN 模型预测参数重建的响应比较,Ca 使用 n_p = 3,Ti 使用 n_p = 4。
实验介电谱
图7:CNN 模型应用于体相硅(Si)、氧化锌(ZnO)、钽(Ta)和钼(Mo)的实验介电谱。图中展示 Im Y(ω),Si(a)、Ta(b)、ZnO(c)、Mo(d)。实验谱与表现最好的 CNN 模型预测参数重建的响应比较,Si 使用 n_p = 1,Ta 使用 n_p = 4,ZnO 和 Mo 使用 n_p = 5。
把结果摆平了看,这份工作的长处和短处都挺清楚。长处是链路完整:从合成数据、到第一性原理谱、再到两类实验谱,一路走通,而且极点数目可以按谱的复杂度手动匹配。短处在于,极点数目本身还得人来定,论文没有给出自动选择 n_p 的机制;实验谱上做的主要是重建响应的视觉对照,没有给出系统性的定量误差指标,也没有和传统非线性拟合做同一批谱上的速度、精度硬碰硬对比。评估公平性上,四个模型共用同一套训练/验证划分,这一点没问题,但缺少与经典拟合方法的并排基准,说服力就打了一点折扣。

实验结果

下面这张表把四个模型在所有 n_p 下的误差汇总到了一起,是前面分析的主要数据来源。可以看到三个参数的平均绝对误差、中位数绝对误差和 95% 绝对误差都随 n_p 增大,n_p = 1 时 Re Ω_p 的平均误差在 0.055 到 0.073 eV 区间,到 n_p = 5 时升至 0.46 到 0.52 eV 左右;权重 r_p 因为被归一化在较小范围内,误差数值本身不大,但同样随复杂度上升。
MPA参数误差汇总表
表1:四个机器学习模型在所有极点数目 n_p 下获得的 MPA 参数误差汇总,报告平均绝对误差、中位数绝对误差和 95% 绝对误差。

未来展望:扩展合成集合与自适应极点数目

论文没有把话说满。就方法本身而言,还有几块拼图可以往上加。合成集合目前覆盖 n_p 从 1 到 5,每类 20000 条,频率区间 100 eV、1000 个点。扩展到更多极点、更宽的频率范围、以及不同级别的多体近似产生的响应,是顺理成章的方向,因为训练数据本来就是解析生成的,扩集合的成本很低。
更值得关注的是极点数目自适应。现在不同谱要手动指定 n_p,这在实际高通量流程里是个不大不小的负担。一个自然的想法是让网络自己判断该用几个极点,或者输出带有不确定度的极点集合,再由下游任务例如 GW、BSE 去筛选。作者也提到,网络容量可以随谱复杂度调整,这意味着未来模型可能不是固定尺寸,而是按需求长的。
从这个角度看,这篇论文的定位更像是一个高效的谱参数化前端工具,而不是终点。它把反演从逐条非线性拟合变成了单次前向,代价是把从谱到参数的映射固化进了权重。适合谁用?适合需要批量处理介电谱、光学谱、EELS 谱,又希望得到物理可解释参数的团队。什么时候不适合?当谱的极点结构远比五极复杂、或者需要极致的单条拟合精度时,传统拟合仍然有它的位置。

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?针对介电谱反演等离激元极点这一任务,奥斯陆大学用纯解析多极Padé表达式生成合成谱训练卷积神经网络,单次前向即可输出极点能量、展宽与谱重,并在第一性原理与实验谱上验证泛化能力。
这篇工作最值得看的点是什么?CNN模型在合成验证集上能准确恢复MPA参数,参数误差随极点数目增加而单调增大但响应重建仍保持较高精度。在第一性原理光谱上,Al(q=Γ, n_p=1; q=N, n_p=3)、Ca(n_p=3)、Ti(n_p=4)均实现了高精度重建。在实验光谱上,Si(n_p=1)、Ta(n_p=4)、Mo(n_p=5)、ZnO(n_p=5)的主要光谱结构均被成功重建,但ZnO的谱起始、Ta的肩部结构等未被完全解析。
这篇工作的边界或风险在哪里?优点:1)训练完全基于合成数据,无需材料特异性数据集,泛化能力强;2)单次前向推断即可提取极点参数,避免了传统非线性拟合的迭代过程和初始化敏感性;3)物理约束显式嵌入输出参数化中,保证结果的物理合理性;4)模型紧凑(约100万参数,约4MB),推理成本低;5)可扩展性强,增加极点数目仅需扩展输出层维度。缺点:1)缺乏与传统非线性拟合方法的定量对比(精度和速度);2)合成训练集未包含谱起始、肩部结构等特征,导致对ZnO等复杂实验谱的解析不完整;3)仅在一维光谱上验证,未考虑动量分辨的二维光谱;4)噪声模型为受控的弱MPA贡献,与实际实验噪声有差异;5)极点数目n_p需要预先指定,未实现自适应确定。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

利用在随机参数生成的多极Padé解析表达式合成光谱上训练的卷积神经网络,直接单次前向推断介电谱背后的等离激元极点参数(极点位置、展宽和谱权重),从而避免传统非线性拟合对初始化和拟合选择的敏感性。

实验合理度:★★★★☆

MPA参数的平均绝对误差、中位数绝对误差、95%绝对误差;响应重建的视觉对比

学术研究价值:★★★★☆

利用在随机参数生成的多极Padé解析表达式合成光谱上训练的卷积神经网络,直接单次前向推断介电谱背后的等离激元极点参数(极点位置、展宽和谱权重),从而避免传统非线性拟合对初始化和拟合选择的敏感性;更关键的是问题定义是否可复用到同类任务。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

约100万可训练参数,单精度浮点表示约4MB模型权重,单次前向推断即可完成极点参数提取

复现难度:★★★☆☆

现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:现有材料尚未充分覆盖分布外泛化、部署成本、长期稳定性和失败案例。


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球