原论文信息如下:
电池健康预测新范式:当语义遇上时序
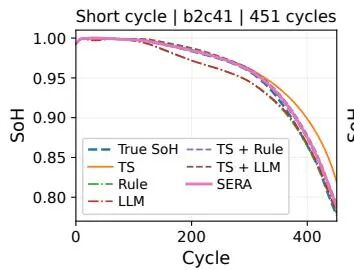
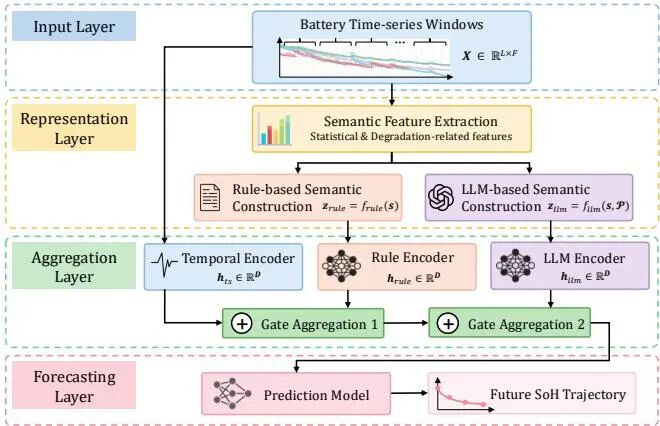
Sera框架全解析:规则+LLM双语义如何引导SoH预测
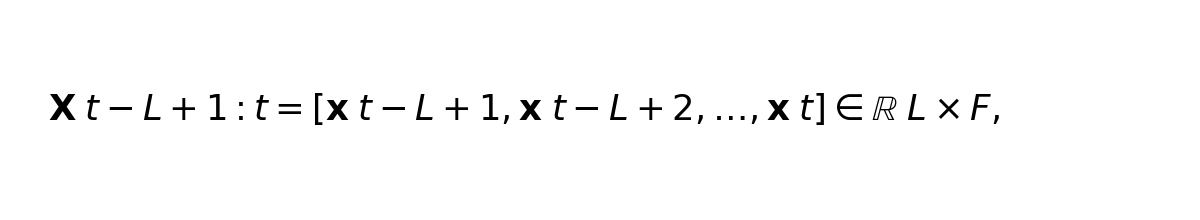
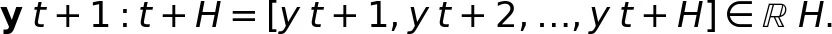
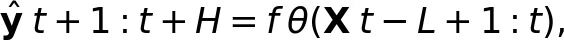
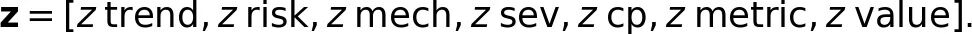
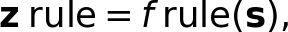
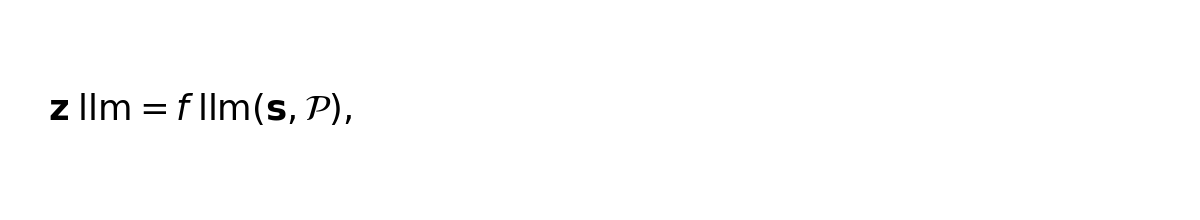
门控聚合机制:三路表示如何自适应融合
时序分支:用 PatchTST 打底
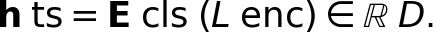
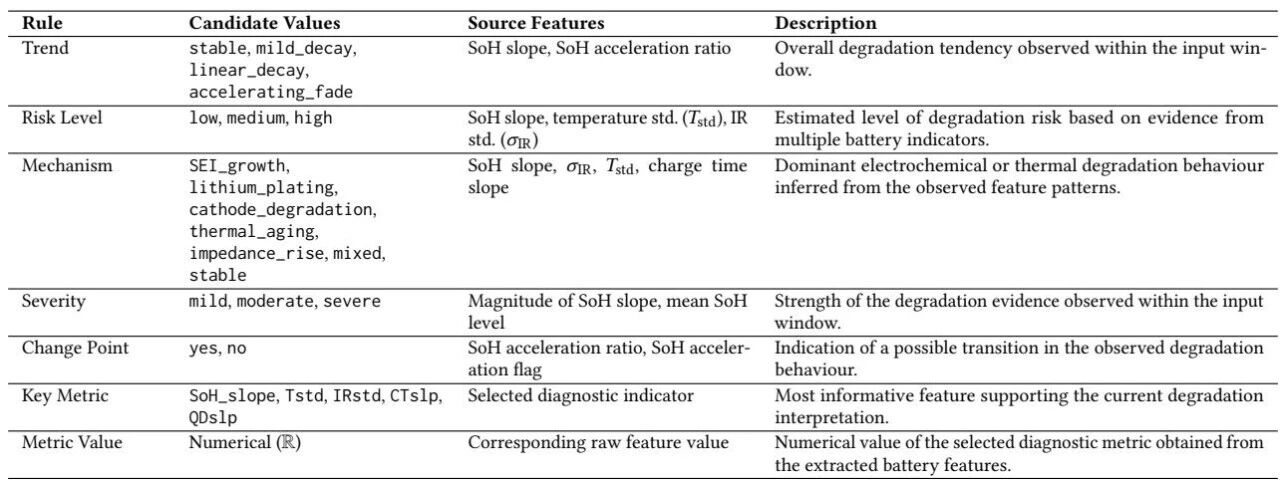
语义分支:两套独立编码器
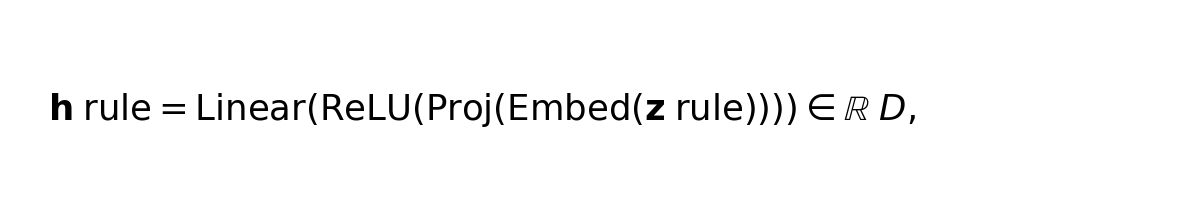
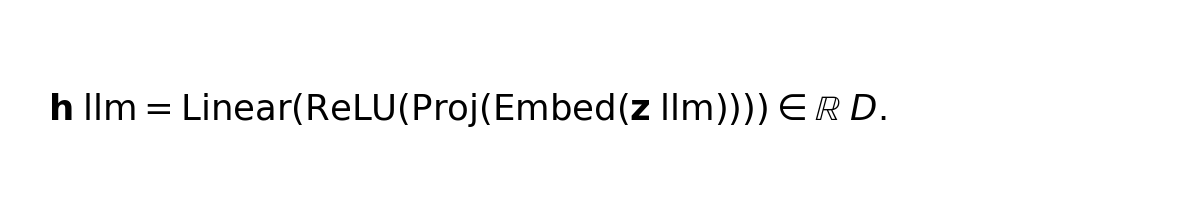
自适应门控:让模型自己决定听谁的

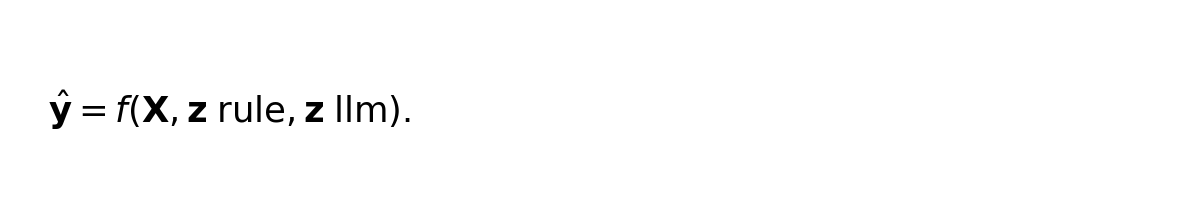
预测头与损失设计
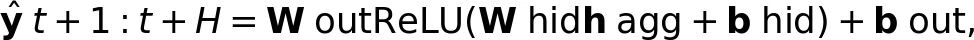
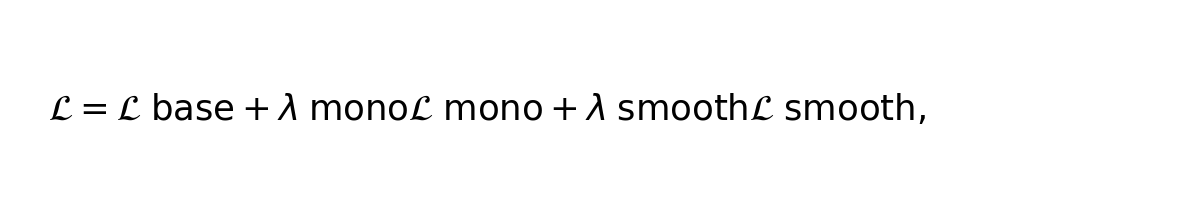
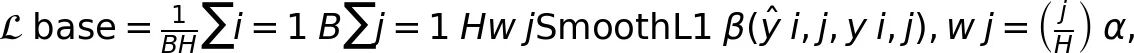
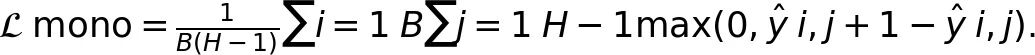
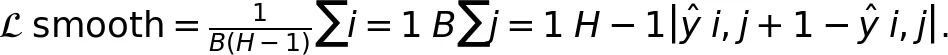
实验验证:37.3%误差降低与泛化能力提升
数据准备及实验设计
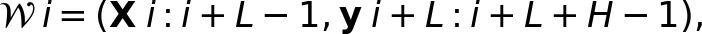
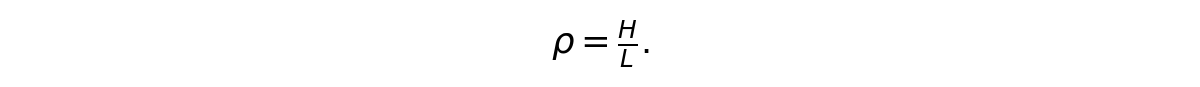
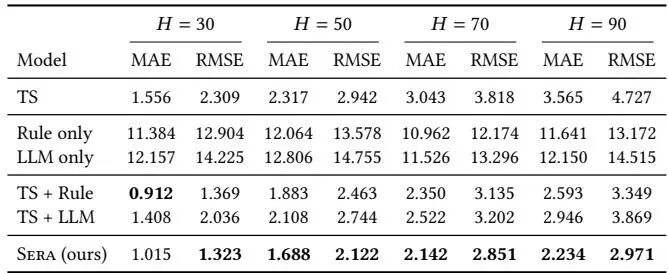
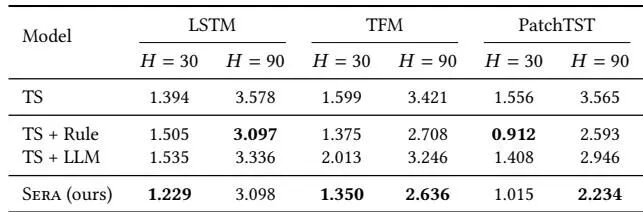
实验结果分析
实验结果
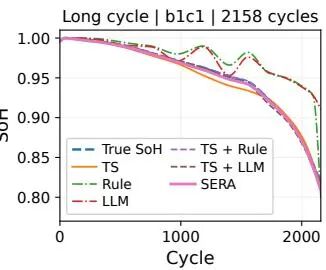
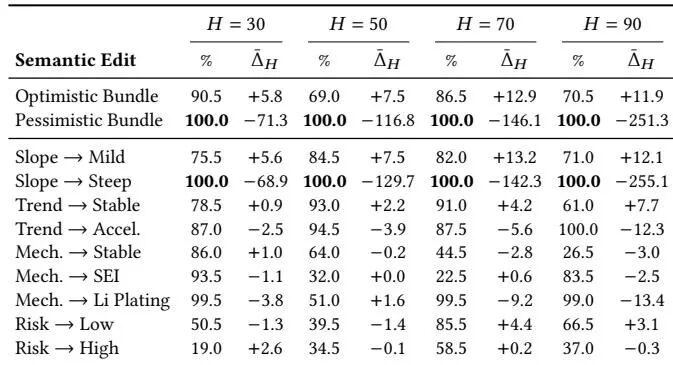
反事实分析:语义干预如何让预测可解释

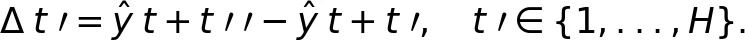
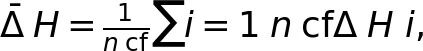
总结与展望:语义表示在电池管理中的未来
龙迷三问
龙哥点评
论文创新性分数:★★★★☆
提出Sera框架,将电池领域知识驱动的规则语义与LLM语义表示同时间序列表示通过门控聚合自适应融合,用于电池健康状态预测,原因是纯数值时序模型无法显式表达高层退化特征。实验合理度:★★★★☆
MAE(平均绝对误差)、RMSE(均方根误差)学术研究价值:★★★★☆
提出Sera框架,将电池领域知识驱动的规则语义与LLM语义表示同时间序列表示通过门控聚合自适应融合,用于电池健康状态预测,原因是纯数值时序模型无法显式表达高层退化特征;更关键的是问题定义是否可复用到同类任务。稳定性:★★★☆☆
现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。适应性以及泛化能力:★★★☆☆
现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。硬件需求及成本:★★★☆☆
使用单张NVIDIA RTX 4090 GPU训练,具体FLOPs未报告复现难度:★★★☆☆
现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。产品化成熟度:★★★☆☆
论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。可能的问题:语义规则设计依赖领域专家知识,LLM语义生成存在不确定性,短horizon下LLM语义可能引入噪声,缺少与现有SOTA电池预测方法的对比,语义表示仅覆盖7个规则维度可能不够全面。
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!

还没有公开留言,欢迎留下你的看法。