← 返回 PaperDaily 大模型与智能体

2.5亿次人肉查号:公众凭什么怀疑你是机器人?

凌晨一点,你刷到一条推文:语法完美、情绪饱满、主页挂着三个外链和一份加密货币白皮书,而且它已经连续发了十四个小时。你盯着屏幕两秒,脑子里冒出一句话:这账号是不是机器人?

2.5亿次人肉查号:公众凭什么怀疑你是机器人?
原论文信息如下:
论文标题:
When Does the Public Become Suspicious of Bots? Demand-Side Evidence from Botometer Query Logs
发表日期:
2026年09月
发表单位:
Observatory on Social Media, Indiana University, Bloomington, USA; University of Edinburgh, Edinburgh, UK
原文链接:
https://arxiv.org/pdf/2609.20661v1.pdf

当你在Twitter上怀疑一个账号是机器人时,你并不孤单

凌晨一点,你刷到一条推文:语法完美、情绪饱满、主页挂着三个外链和一份加密货币白皮书,而且它已经连续发了十四个小时。你盯着屏幕两秒,脑子里冒出一句话:这账号是不是机器人?紧接着,你做了一个几乎无害的动作——把它的用户名丢进一个检测工具里查一查。
这个动作看上去很私密,过去也被默认不留痕迹。印第安纳大学(Indiana University)社交媒体观察站(Observatory on Social Media)的 Tugrulcan Elmas 却发现,它其实留下了海量的痕迹,而这些痕迹拼起来,是一张公众对自动化账号的集体心理地图。
论文标题是《When Does the Public Become Suspicious of Bots? Demand-Side Evidence from Botometer Query Logs》,直译过来是《公众什么时候开始怀疑机器人?来自 Botometer 查询日志的需求侧证据》,目前挂在 arXiv 上,编号 2609.20661,署名单位为印第安纳大学布卢明顿分校社交媒体观察站与爱丁堡大学。
先讲两个必须先理清的概念。机器人研究一直分两条腿走路:一条是供给侧(supply side),研究机器人长什么样、怎么批量注册、怎么检测;另一条是需求侧(demand side),研究公众怎么感知、怎么怀疑、怎么反应。过去十年,供给侧论文铺天盖地,需求侧几乎是空白,原因很朴素:怀疑是一种私密心理状态,很少有人会把它写下来。
这篇论文的核心主张是:怀疑虽然私密,但会变成动作——去查它。而查询会被服务器记录下来。全文围绕三个问题展开:公众查的都是些什么账号(RQ1)?怀疑什么时候会变成集体行为(RQ2)?怀疑之后又会发生什么(RQ3)?

Botometer查询日志:一百万次怀疑行为背后的数据密码

Botometer 是印第安纳大学从2014年起持续运行的公开免费服务:输入一个 Twitter/X 账号,它会抓取该账号最近的推文、互动网络和时间作息,抽出上千个特征,再交给一个监督式集成分类器打分。分数在0到1之间,越高越像自动化账号。它有两个版本,一个是只看英文内容特征的英文分,另一个是去掉语言相关特征的通用分(universal score),可以跨语言使用。官方并没有规定唯一的“机器人线”,但业内习惯把0.2以下看作比较像人、0.8以上看作比较像机器人,本文也沿用这两个阈值。
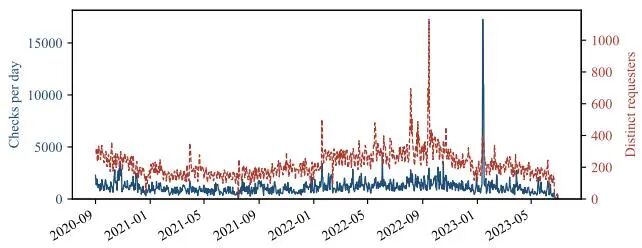
数据是这项工作最值钱的地方。作者拿到的是 Botometer 网页端和 API 的服务器查询日志,时间跨度是2020年9月1日到2023年6月30日,一共 250,838,846 次查询,涉及 99,225,402 个唯一账号。这段时间刚好覆盖了几件大事:2020年美国大选、2021年1月6日国会山事件,以及2022年马斯克从提出收购推特到交易完成的全过程。查询量在2023年1月创下79,621次的单月纪录,随后随着推特收紧 API 访问一路下滑,7月初归零;作者把2023年6月30日定为分析窗口的终点。
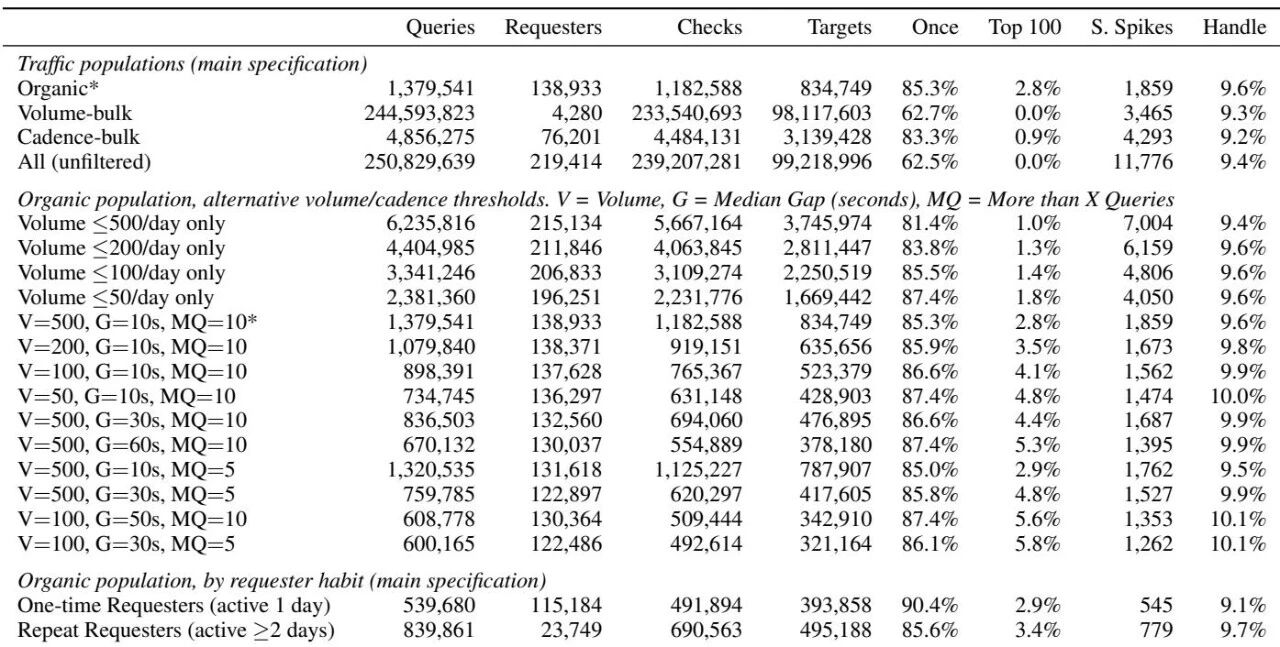
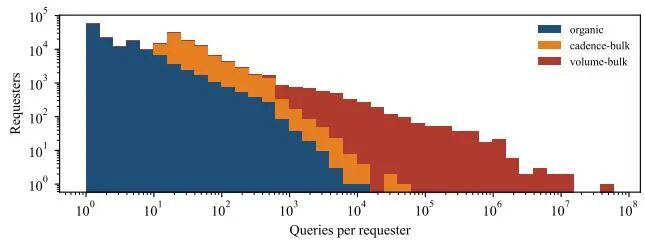
但日志里混着两拨完全不同的人:一拨是跑脚本批量扫账号的研究者和开发者,一拨是自己刷到可疑账号顺手查一下的普通人,只有后者才代表“公众怀疑”。于是作者设了两道闸门。第一道看数量:某个请求者只要有一天查询超过500次,就被判定为批量用户并整体剔除——这类请求者只有4,280个(总请求者219,414个),却带走了97.5%的查询量。第二道看节奏:剩下的请求者里,如果查询次数超过10次、且相邻两次查询的中位间隔小于10秒(这个速度人类根本来不及看结果页),同样剔除,这一步又删掉76,201个请求者,占剩余查询量的77.9%。两道闸门还互相验证:90%被数量闸门拦下的请求者,也会被节奏闸门抓到。
图2:按过滤类别统计的每位请求者查询次数分布(双对数坐标)
图2:按过滤类别统计的每位请求者查询次数分布(双对数坐标),曲线尾巴上那些“一天几千次”的正是脚本流量,清洗后剩下的才是零散的人类注意力。
清洗之后剩下 1,379,541 次查询,来自 138,933 个请求者。其中82.9%的人只在一天出现过,只有1.1%活跃十天以上;但回来的那17.1%贡献了58.4%的查询。这个分布很像真实的、零散的人类注意力,而不是少数漏网的脚本。作者最后以一次 check 为单位——同一个请求者、同一个目标账号、同一天只算一次。这样又去掉了14.3%的查询,最终得到 1,182,588 次检查,覆盖 834,749 个目标账号。注意,这只占原始日志账号库的0.8%。
为了知道“被查的账号”和“一般账号”到底差在哪,作者引入两份对照。第一份是 Internet Archive 的 Twitter Stream Grab,也就是公开推流的约1%采样,共32亿条推文,提供语言、注册时间和活跃记录;第二份是从中抽出的1,940万个背景账号。另外还有一份反馈日志:用户查完之后可以给账号贴标签为 bot、human 或 cyborg,共5,710条(bot 1,285、cyborg 897、human 3,528)。这里的 cyborg 指人机混合账号,有人运营但大量行为自动化,这个概念后面会反复出现。
图1:Botometer 每日查询量(实线)与每日独立请求者数(虚线)
图1:Botometer 每日查询量(实线)与每日独立请求者数(虚线),2023年1月见顶后随 API 收紧迅速塌陷。
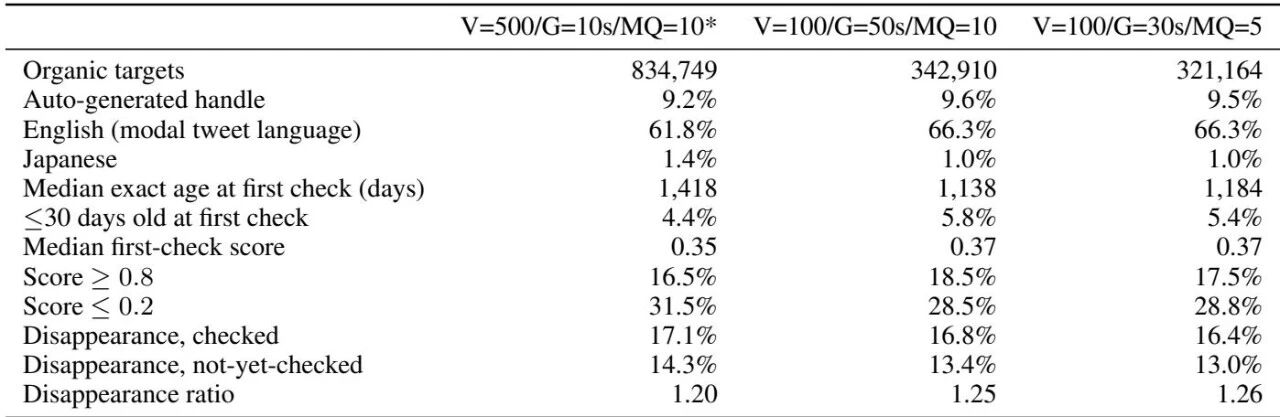
表4:三种流量切法下的关键统计量
表4:三种流量切法下的关键统计量,包括主设定下的批量/节奏过滤分层、14组替代阈值下的自然流量人群,以及按请求者习惯划分的自然流量。带星号的是论文主设定。可以看到“只被查一次的目标占比”“自动生成用户名比例”等指标在不同阈值下都很稳。

谁在被怀疑?政治、加密货币和推广账号的集体画像

第一个反直觉的结论是分散程度。85.3%被查账号这辈子只被查过一次;被查最多的100个账号只吃掉全部检查量的2.8%,前1000个加起来7.2%,前10000个也只有15.6%。公众的怀疑不是围着几个大V打转,而是极其零散地洒在整个平台上。
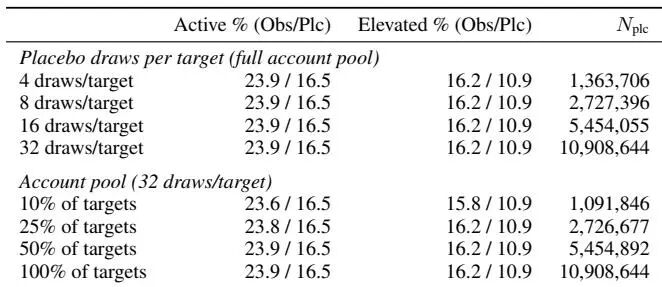
第二个反直觉的地方是时机。作者设计了一个安慰剂对照:把“第一次被查那天”的活跃度,和同一个账号随机抽的24个“普通日子”比较,抽的时候避开被查日前后14天,防止事件本身污染基线。结果是,被查当天账号在1%流样本里有过活跃的比例是23.9%,普通日子只有16.5%;活跃度相对自身30天基线翻倍的比例是16.2%对10.9%。这种抬升不是一闪而过:第二天还有22.5%活跃、14.7%翻倍,一周后仍有21.0%和13.3%,都高于基线。说明怀疑通常是被账号“刚刚做了什么”触发的,而且落在持续活跃期里,而不是对某个瞬间的应激反应。
表6:爆发时机的安慰剂稳健性检验
表6:爆发时机的安慰剂稳健性检验。每格是“实际/安慰剂”的一对比例,上半部分换不同的抽样次数,下半部分换不同的账号池规模,结论都稳。
画像部分更有意思:被查账号更老、更活跃、也更有存在感。粉丝数中位数591,背景账号只有154;平均粉丝数差距更大(41,208对1,992);认证率4.6%对0.35%;首次被查时账号中位年龄1,418天,背景是728天,注册时间中位数比背景早了约20个月;30天以内的新号只占4.4%,反而低于背景的9.2%。发推也更勤,终身推文中位数6,461条对3,993条。被查两次以上的账号,粉丝和推文量又明显再上一截(粉丝中位2,608对495)。所以公众怀疑的对象,是“普通用户里比较显眼的那一头”,而不是新生小号或顶级名人——百万粉以上账号只占目标的0.66%。
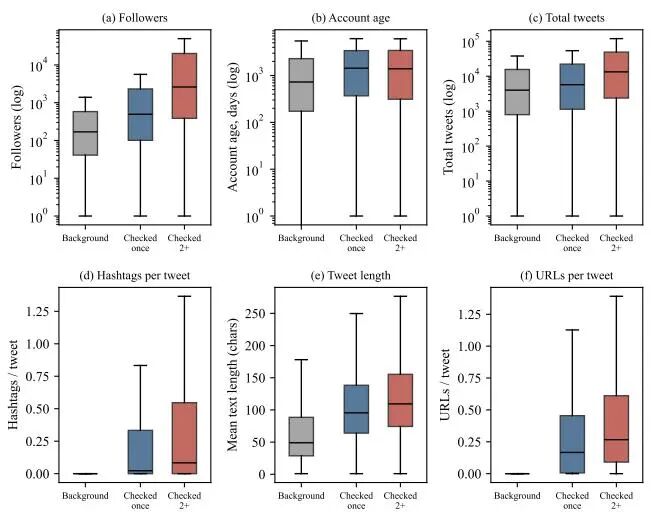
图3:背景人群与被查账号的对比(拆分为被查一次与被查两次以上)
图3:背景人群与被查账号的对比(拆分为被查一次与被查两次以上)。背景组在部分面板里是一条贴零的平线,因为87.9%的背景账号从不使用话题标签、75.3%从不带链接。
一个特别值得说的点是默认用户名。推特自动生成的“名字加一长串数字”(比如 John95197683)是大众心里最典型的机器人形象,被查账号里有9.6%带这种用户名,而背景账号是8.8%,按推文加权是7.7%——几乎一样。也就是说,公众并不是靠这个最刻板的线索去查账号的。
语言上的偏向更明显:被查账号61.8%以英语为主,背景只有33.7%;推流里第二大语言日语占背景的18.6%,在被查账号里只占1.4%。用 Botometer 查机器人,基本是一件英语圈的事。
内容层面作者做了三阶段测量:先用带信息先验狄利克雷分布的加权对数几率(weighted log-odds,Monroe, Colaresi, and Quinn 2008)给每个词算区分度,挑出被查账号和背景账号各自最独特的250个词或标签;再用 Claude Sonnet 5 做开放编码归类;最后按类别计算富集比,也就是“该类词出现在被查账号中的比例”除以“出现在背景账号中的比例”。
富集比 R_c 的计算公式
富集比公式:R_c = (n_c^chk / N^chk) / (n_c^bg / N^bg)。其中 n_c^chk 是包含该类别任一词的被查账号数量,N^chk 是被查账号总数,n_c^bg 与 N^bg 是背景账号的对应数值;衡量词或标签类别的两个分母分别取全体账号(针对标签类)或英语账号(针对词类)。比值大于1意味着这类内容在被查账号中更常见,小于1则相反。
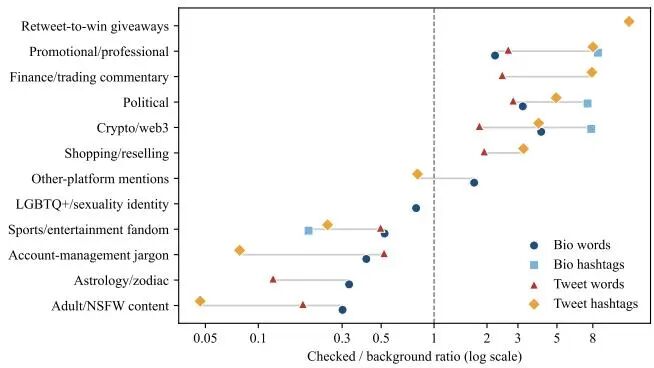
结果是:政治、加密与 Web3、推广与职业宣传、金融交易、购物转卖、转发抽奖这六类,在测到的每一种内容类型里都被富集,倍数在1.8到12.9之间;而粉丝圈与娱乐、占星、账号管理黑话(比如 dni,全称 do not interact,意为“请勿互动”;pfp,全称 profile picture,意为头像;acc,全称 account,意为账号)、成人内容则被系统性耗尽,倍数在0.05到0.52之间。唯一翻转的是“提及其他平台”:在个人简介里被富集1.7倍,典型是“加我 Telegram 频道”这类自我推广;在推文标签里却被耗尽0.8倍,典型是 Instagram 自动同步到推特时自动带上的话题标签。
图4:同一批类别在四种内容类型上的被查对背景富集比
图4:同一批类别在四种内容类型(简介词、简介标签、推文词、推文标签)上的被查对背景富集比,横轴方向在不同内容类型间高度一致。
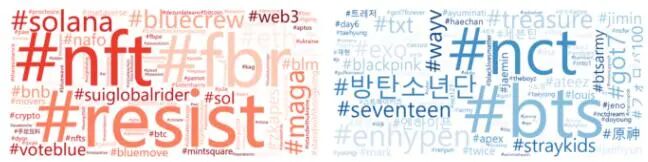
图5:被查账号(左)与背景推流(右)的简介话题标签对比
图5:被查账号(左)与背景推流(右)的简介话题标签对比,面积代表加权对数几率的绝对值。一侧是 #nft、#resist、#fbr、#maga,另一侧是 #bts、#nct、#enhypen 等韩流集群,两边几乎不重叠。
推文结构上,被查账号更像一块广告牌:带链接比例29.4%对21.4%,带话题标签15.4%对7.6%(整整两倍),提及其他用户65.9%对53.0%,转推反而更少(39.9%对44.5%)。而且这个差距是渐变的:从不带标签到被查一次再到被查两次以上,每条推文的话题标签中位数从0.00升到0.02再升到0.08,推文长度中位数从49个字符升到96再到109,链接数从0.00升到0.17再到0.27。
表5:主设定与两组替代阈值下的推流富集结果
表5:主设定(带星号)与两组替代阈值下,被查账号相对推流背景的富集结果;参考基线是自动用户名8.8%、英语33.7%、中位年龄728天、30天以内新号占9.2%。
这里有个必须点出来的反差:粉丝圈账号其实是平台上数量最多、发帖最重复、最匿名的群体,也最接近大众对机器人的想象,但恰恰是被查最少的之一。作者给了三种解释。一是公众怀疑的是“账号在鼓吹什么”(推广、政治站队、加密),而不是“行为看起来多自动”。二是有人会说粉丝圈不被查,是因为大家已经默认它们是机器人、懒得验证——但默认用户名这条最字面的线索并没有压低被查率,所以这个解释站不住。三是过滤泡效应:韩流粉丝圈面向全球受众,而查机器人本身是英语圈行为,英语用户可能根本刷不到那些内容。

马斯克与机器人争议:公众怀疑如何从个体焦虑变成集体行动

个体怀疑是零散的,那它什么时候会突然聚集?作者定义了一次集体怀疑峰值(suspicion spike):同一个账号在同一天被至少 k 个不同请求者查过。主设定取 k=5,同时用 k=3到12 全部复算,结论不变。整个记录期内一共出现1,859次峰值。
峰值曲线和平台史高度重合。2021年多数月份只有3到34次,2021年10月起跳到61次,2022年大多月份在41到150之间,然后随着 API 关闭一起消失。整体查询量和峰值数量确实相关(r=0.77,n=34个月),但远远不成比例:峰值月均值从前13个月的21次跃升到之后的75次,约3.6倍,而同期整体查询量几乎没动(30,723对37,270)。也就是说,集体怀疑有自己的节奏,不是整体查询量涨水船高带出来的。
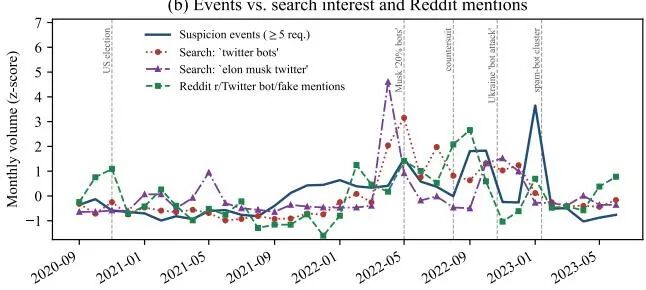
图6:月度集体怀疑峰值与整体查询量、外部搜索兴趣、Reddit 提及率的对照
图6:(a)月度怀疑峰值(左轴)与整体查询量(右轴),两者只是松散同步(r=0.77),虚线标注了马斯克相关事件、2022年10月22-23日乌克兰相关集群,以及2023年1月12-15日的垃圾账号集群。(b)峰值与“twitter bots”和“elon musk twitter”的谷歌搜索兴趣、以及 r/Twitter 板块中 bot/fake 提及占比的对照。峰值与机器人相关搜索的相关性(r=0.48)明显高于与马斯克泛新闻搜索的相关性(r=0.15),后者在2022年5月冲得极高,峰值却只是温和上升。
整份记录里最大的一次集体峰值,是马斯克本人。2022年8月5日,有217个不同请求者查他的账号,第二天还有161个——那正是他围绕推特“机器人比例”发起反诉、霸占头条的那一周。更早的一次同量级高峰出现在2022年5月,也就是他说“推特上20%是机器人”之后。全记录中,801个账号至少触发过一次峰值,77.7%只有一次,18.4%有两到五次,4%超过五次;马斯克账号以133次成为极端离群值。
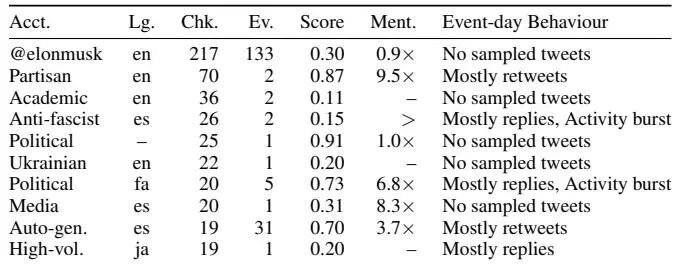
表1:集体怀疑峰值最大的十个账号
表1:集体怀疑峰值最大的十个账号。Chk. 是单个最大峰值日当天的独立请求者数(排序依据);Ev. 是该账号累计触发的峰值次数;Score 是首次被查时的 bot 分;Ment. 是峰值日相对自身30天基线的提及率(“-”表示从未在样本中被提及,“>”表示只在峰值日被提及)。除了马斯克这类名人,名单里还有三种语言的政治账号、一个西班牙语媒体频道、一位学术界人士、一个高产的日语账号,以及一个只有几十个粉丝的个人账号——目标相当异质。
awesome and shock.JPEG
值得单独讲的是2022年10月22-23日那个集群:目标集中在乌克兰语和俄语政治账号上,包括总统顾问 Mykhailo Podolyak。时间点很巧——10月3日马斯克在推特上发起“乌克兰-俄罗斯和平方案”投票,方案遭到包括 Podolyak 在内的强烈反对,后者反过来提出了要求乌克兰恢复被占领土的方案;随着投票结果对他不利,马斯克把结果归因于“机器人攻击”。同一套说法,把怀疑的聚光灯引向了这一圈账号。
2023年1月12-15日则是另一种形态:212个目标账号,每个只被5到15个请求者查,用户名绝大多数是“名字+数字”的自动生成格式,内容指向垃圾信息和加密推广。这更像一次分散的、同时发生的“集体狩猎”,而不是某个明星账号被围观。
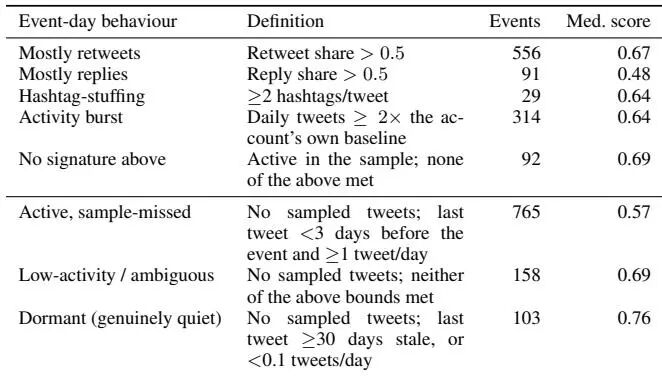
表2:峰值目标在峰值当天的行为特征
表2:峰值目标在峰值当天的行为特征。每一次峰值按证据支持的最具体类别归类:目标推文出现在1%样本里时直接做内容分类,没有出现时则用被查时刻的活跃水平推断类别;Med. score 是目标首次被查时的 bot 分中位数。
作者还找了两个外部注意力代理来交叉验证。除了图6里的谷歌趋势,还有 Reddit 的 r/Twitter 板块:19万条帖子和69万条评论里,包含 bot/fake 的帖子占比与峰值的相关性只有0.26,而且不显著。合起来看,公众的机器人怀疑跟“机器人”这个具体议题走得更近,而不是简单跟随马斯克新闻热度。
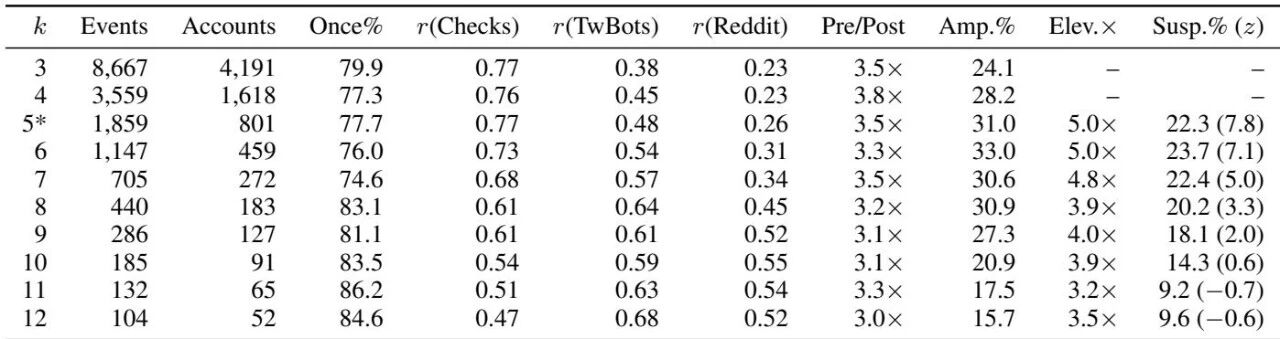
表7:k 取3到12时 RQ2/RQ3 关键统计量的重算结果
表7:k 取3到12时 RQ2/RQ3 关键统计量的重算结果,主设定 k=5 带星号。“Pre/Post”是2021年10月之后的月均峰值与之前13个月之比,“Amp.%”是以转推为主的峰值日占比,“Elev.”是峰值日的登录级提及率提升倍数,“Susp.%”是截至2026年8月的封禁率(括号内为相对5,000账号基线的z值)。删号与停用率在各 k 下都不显著,说明主文那个零结果很稳。

被怀疑之后:账号消失、封禁与沉默的连锁反应

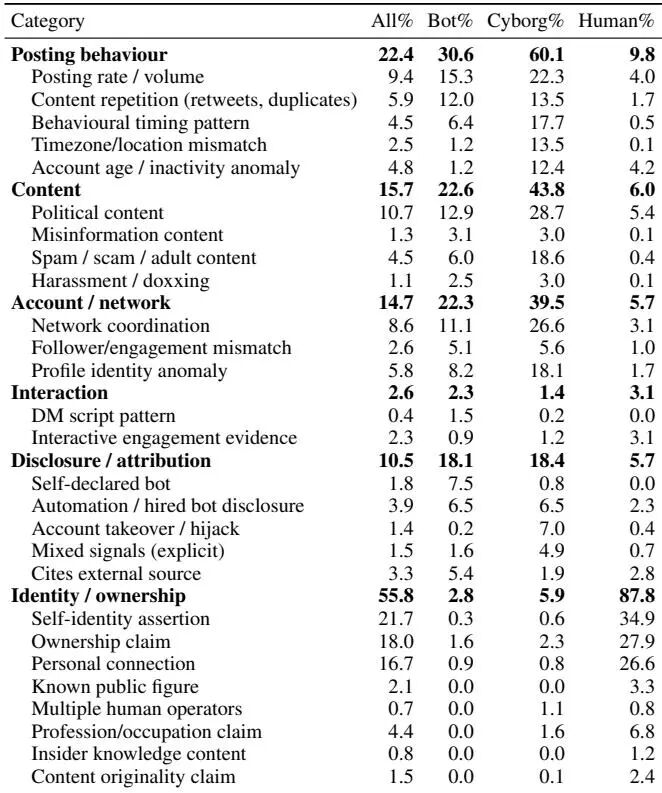
第三个问题是怀疑的后果。先看反馈日志:在5,710条标注里,被标为人类的账号,用户给的理由大多是第一人称身份声明,比如“我是真人”“这是我本人账号”;而被标为机器人或人机混合的账号,理由更多是基于证据的论证——发帖频率异常、政治内容密集、跨账号协同。
表3:按主题与标签划分的反馈理由类别
表3:按主题与标签划分的反馈理由类别,属于多标签统计,同一列百分比不必加总为100。“All”一列先把所有标签的文本合并后再计算占比。
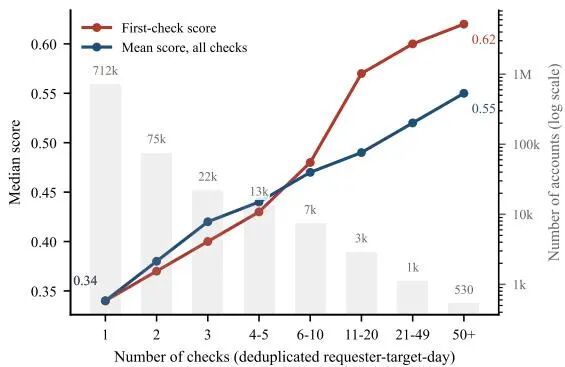
再看行为数据。被查次数越多的账号,首次检查时的平均 bot 分越高,说明被多人独立怀疑的账号,客观上更可能真的是自动化账号——这算是给“群众的眼睛”投了一票。
图7:按被查次数统计的首次检查时间中位数与平均 bot 分
图7:按被查次数统计的首次检查时间中位数(左轴)与平均 bot 分(左轴另一组),柱形为样本量(右轴)。被查次数越多,平均分越高。
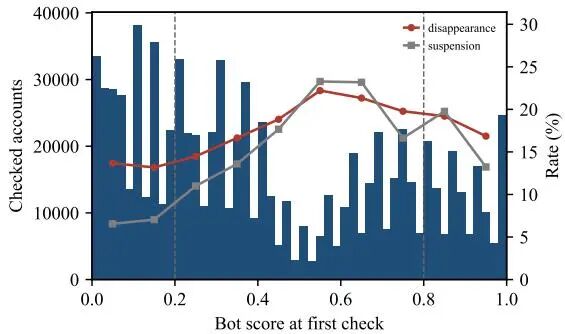
首个 bot 分与后续命运的关系更直接。分数越高,账号从1%流样本里“消失”的比例以及之后被封禁的比例都在上升;0.2和0.8这两条习惯阈值把曲线自然分成了三段。需要提醒的是,消失不等于封禁,也可能是停更、删号、改名或者转为私密账号。
图8:按首次检查 bot 分分箱的流中消失率与封禁率
图8:首次检查时的 bot 分分布。折线给出各分数箱对应的流中消失率与封禁率,虚线标出习惯使用的0.2(更像人)与0.8(更像机器人)两条阈值。
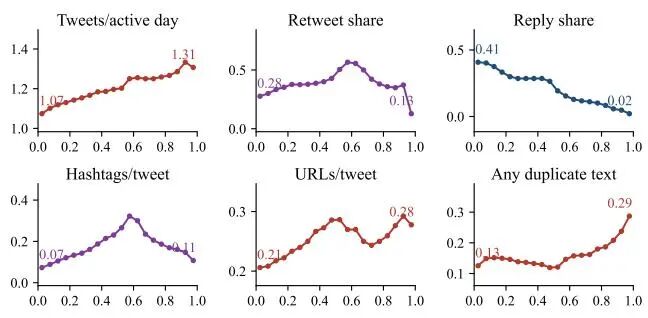
论文还按0.05的宽度对分数分箱,看各箱账号在流中的行为中位数,并用颜色标出整体形状是单调上升、单调下降,还是中间鼓起或凹陷。这说明 bot 分不是简单的“好坏人”标签,而是对应着一整套可观察的行为差异。
图9:按首次检查 bot 分0.05宽度分箱的账号流中行为中位数
图9:按首次检查 bot 分0.05宽度分箱的账号流中行为中位数。颜色标识每个面板的整体形状:红色为端到端上升,蓝色为端到端下降,紫色为中间高于或低于两端。
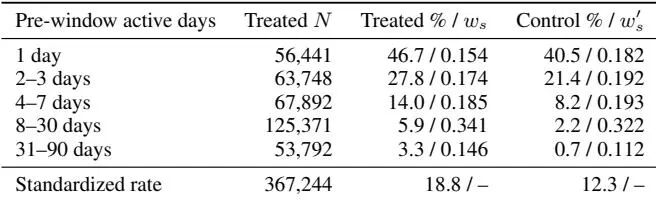
最容易被误读的结论是“被查之后账号更容易消失”。作者做了分层处理:先按被查前的活跃水平分桶,再做交叉标准化。如果不分层,处理组和对照组的活跃度分布本来就不同,会夸大效应;分层标准化之后差距有所收敛,但仍高于对照组。这种谨慎,是这篇论文比较让人放心的地方。
表8:账号消失率按前置活跃水平分层的结果
表8:账号消失率按前置活跃水平分层的结果。每个单元格是“率/权重”的一对数值,底部一行为按对照组权重(处理列)与按处理组权重(对照列)交叉标准化后的率,用来剥离活跃度分布差异带来的干扰。

从需求侧看机器人检测:公众怀疑能否成为平台治理的新信号

把整篇论文合起来看,它想说的是:怀疑不是噪音,而是一种分布式的、大众化的平台审计(platform auditing)。被集体怀疑的账号,客观上 bot 分更高、更容易被封禁,说明这种“民间审计”确实在追踪有意义的自动化信号。更进一步,公开审计工具的查询日志本身就是一份“公众注意力与不信任”的实时清单——过去平台治理依赖内部指标和第三方审计,这份日志提供的是第三种视角:用户自己在查什么。
但边界也要讲清。第一,查询日志只记录“有人查过”,记录不了动机:可能是怀疑,也可能是好奇、研究,甚至是准备举报前的取证。第二,1%流样本按发帖量采样,会过度代表活跃账号,所以所有对比都是相对量的对比,而不是绝对比例的估计。第三,结论基本适用于英语圈的 Twitter/X,而且数据在2023年6月因 API 收紧而中断——这也提醒我们,这类研究的观察窗口本身就很脆弱。第四,论文衡量的是集体怀疑与客观信号的关联,不是个体判断的准确率。人多的地方,判断更靠谱;一个人盯着屏幕时的判断,依然相当不可靠。

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?印第安纳大学分析近2.5亿次Botometer查询日志与32亿条推文,首次从需求侧刻画公众的机器人怀疑:被查账号更老更活跃,马斯克是最大靶子,集体怀疑后账号更易封禁。
这篇工作最值得看的点是什么?论文通过大规模日志分析发现,公众怀疑行为高度分散,85.3%的被查账号仅被查一次;被查账号比背景人群更年长、粉丝更多、发帖更频繁,且以英语政治、加密货币、推广类内容为主;集体怀疑峰值与平台危机事件高度同步,最大峰值出现在2022年马斯克与Twitter的机器人争议期间;被查账号后续从推文流中消失的比例显著高于尚未被查的对照账号(17.1% vs 14.3%),集体怀疑目标账号的封禁率也显著更高(22.3% vs 12.9%)。
这篇工作的边界或风险在哪里?优点在于首次从需求侧大规模观测公众机器人怀疑行为,利用查询日志这一独特数据源捕捉了私人认知状态的行为痕迹,数据规模大(超百万次查询、32亿条推文背景流),分析维度全面(时间动态、账号特征、内容标记、集体峰值、后续结果),且对批量流量过滤做了充分的鲁棒性检验。缺点在于查询日志仅能反映使用Botometer的用户群体的怀疑行为,存在选择性偏差;1%推文流采样偏向高活跃账号,导致部分协变量估计有偏;无法区分账号消失是封禁还是自然沉默;反馈日志为自选择样本,代表性有限;观察窗口截止于2023年6月,无法覆盖后续平台变化。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

将Botometer这一公开机器人检测服务的服务器端查询日志视为公众怀疑行为的直接行为痕迹,通过体量阈值与节奏阈值两阶段过滤程序化批量流量,保留有机查询,并以同期1%公共推文流作为背景对照,从需求侧大规模刻画公众对机器人账号的怀疑行为。

实验合理度:★★★☆☆

现有材料未完整覆盖数据划分、基线公平性和统计显著性,因此按中性评价处理。

学术研究价值:★★★★☆

将Botometer这一公开机器人检测服务的服务器端查询日志视为公众怀疑行为的直接行为痕迹,通过体量阈值与节奏阈值两阶段过滤程序化批量流量,保留有机查询,并以同期1%公共推文流作为背景对照,从需求侧大。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

现有材料缺少完整训练资源、参数量、显存和推理时延信息,成本暂按中性评价。

复现难度:★★★☆☆

https://github.com/tugrulz/bot-suspicion-reproduction

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:查询日志仅能反映使用Botometer的用户群体的怀疑行为,存在选择性偏差;

主要参考文献

Elmas, T. When Does the Public Become Suspicious of Bots? Demand-Side Evidence from Botometer Query Logs. arXiv:2609.20661. https://arxiv.org/pdf/2609.20661v1.pdf
Davis, C. A., Varol, O., Ferrara, E., Flammini, A., Menczer, F. BotOrNot: A System to Evaluate Social Bots. 2016.
Yang, K.-C., Ferrara, E., Menczer, F. Botometer 101: Social Bot Practicum for General Audience. 2022.
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球