← 返回 PaperDaily
视觉与图像
图像恢复|印度理工25万张石刻字符数据集:让阿育王铭文自动翻译成英文
让AI去读两千多年前刻在石头上的字,听起来像考古队的活儿,可印度理工学院甘地讷格尔分校真把它做成了流水线:图像增强、字符识别、转写、翻译一步不落,还顺手开源了25.38万张字符图和2224对双语语料。方法不花哨,但“没数据”这个老大难被正面解决了,值得一看。
龙哥读论文
发布于 2026-10-18 01:22:03
阅读 10
查看原文
原论文信息如下:
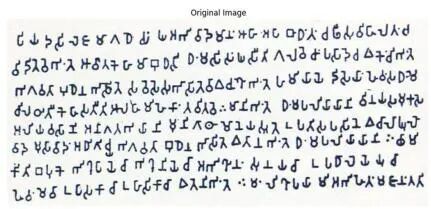
当AI遇上2500年前的石头:阿育王铭文能自动翻译了? 公元前3世纪,孔雀王朝的阿育王把敕令刻在岩石和石柱上,分布在今天印度、尼泊尔、巴基斯坦、阿富汗一带。这批铭文用婆罗米文记录普拉克里特语,是印度次大陆现存最早的书写遗存之一,也是研究当时政治、宗教与语言的硬材料。
听上去像是考古队该操心的事,可它偏偏撞上了计算机视觉最头疼的几个条件。石头在野外躺了两千多年,要面对风化剥落、表面破损、光照不均、阴影、苔藓和生物附着、背景杂乱;婆罗米字符又会因为地域、年代、刻工风格不同而长得五花八门,没有一套统一的字形标准;更要命的是,能拿来训练的标注数据几乎为零。
所以现成的文字识别系统直接搬上去会怎样?论文给的态度挺直白:由于缺乏标准化字形、又缺少铭文专用数据,把现有光学字符识别系统直接套用是无效的。这句话是整个工作的出发点——不是模型不够强,是数据根本不够用。
OCR(Optical Character Recognition,光学字符识别):
NMT(Neural Machine Translation,神经机器翻译):
转写(Transliteration):
婆罗米文(Brahmi)与普拉克里特语(Prakrit):
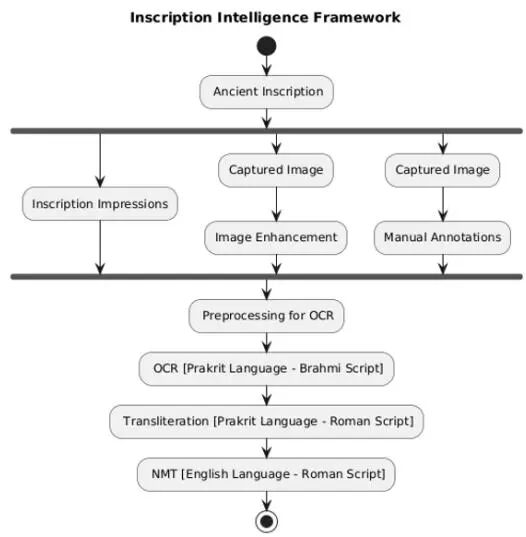
论文来自印度理工学院甘地讷格尔分校(Indian Institute of Technology Gandhinagar),作者是 Jaidev Sanjay Khalane、Akbar Ali、V. N. Prabhakar、Shanmuganathan Raman 四位。他们做的事可以概括成一句话:从一块拍得并不干净的石头照片出发,一路走到英语译文,中间不靠人肉翻译。整条链路包含图像增强、光学字符识别、转写、神经机器翻译四段,并且顺手放出了两个数据集——一个用来做婆罗米字符识别,一个用来做普拉克里特语到英语的翻译。
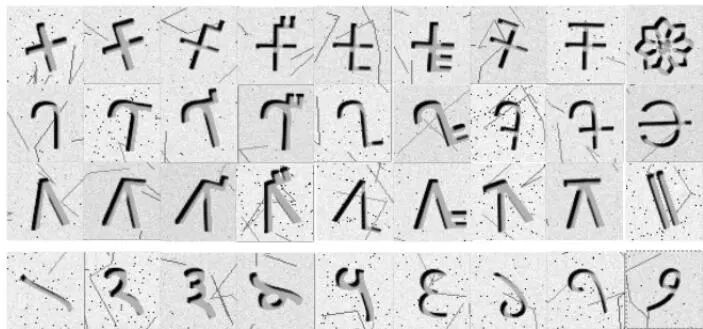
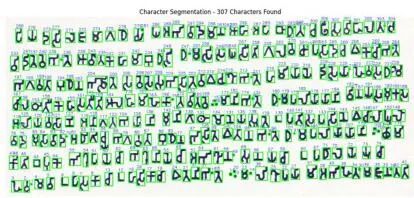
这批字符长什么样,看一眼图1就有数:字口深浅不一、边缘毛糙、背景带石头颗粒感,有几个样本还叠着裂缝。这就是研究者要训练模型去认的东西。
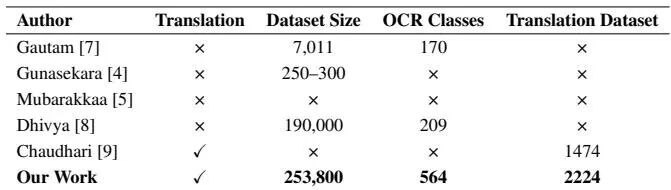
为了说明自己补上了哪块空缺,论文把此前关于婆罗米文的数据集拉了一张对比表。表1里的几行数字说明了一件事:过去的研究要么只做字符识别、不做翻译,要么只有翻译语料、没有图像数据,能同时覆盖"从图像到译文"的完整链路此前基本是空白。
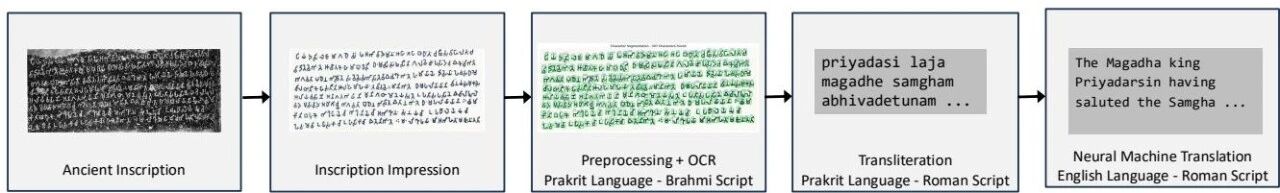
从石头到英文:四步流水线拆解 先看全局。整条链路接收的输入可以是铭文的实拍照片,也可以是拓片印象,输出是英文译文。中间的四个环节分别负责:把脏图洗干净、把字切出来认出来、把婆罗米字母换成罗马字母、把普拉克里特语译成英语。论文给出的整体流程如图4。
按论文的定位,这属于典型的深度学习实验类工作,先把主干信息汇总成一张表,方便对照后面的细节。
*表格超出部分左右可以滑动
Table 1: Comparison of OCR and translation capabilities for Brahmi-based datasets.
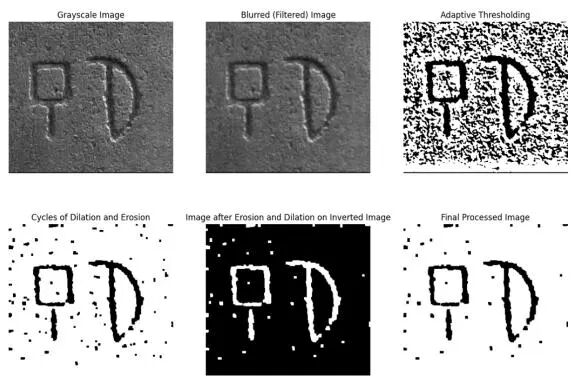
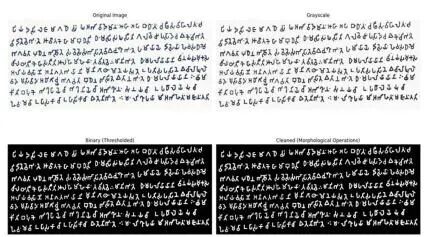
第一环完全没用深度学习,走的是一套经典图像处理的组合拳,顺序是:原图先转灰度,再用高斯滤波去噪,接着做直方图自适应阈值二值化把前景和背景分开,然后对二值图和它的反相图分别做若干轮膨胀与腐蚀的形态学操作,最后把结果反转,得到一张干净、适合后续识别的增强图。
论文把每一步的中间结果都画出来了,图2可以直观看到增强过程里图像是怎么一步步变干净的。
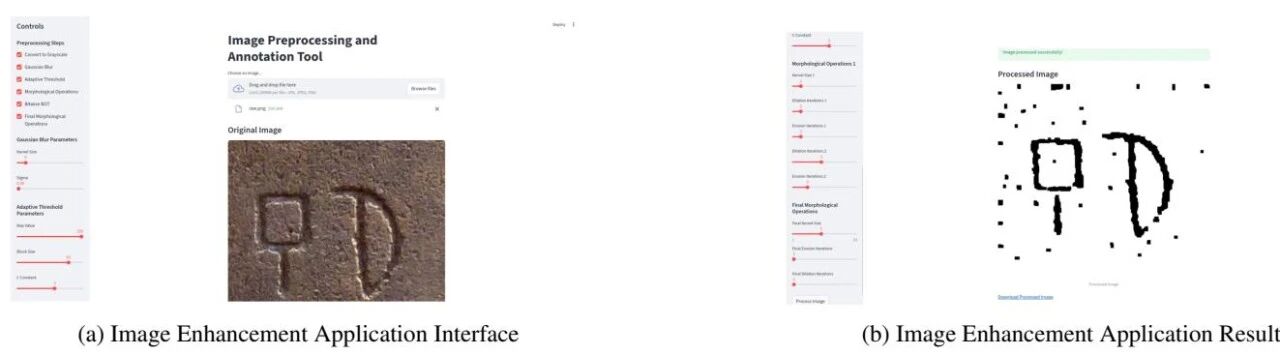
为了让这套流程能实际操作,研究者做了两个工具。一个是基于 Streamlit 的图像预处理与标注应用,核大小、阈值这些参数都做成可调的,每个操作可以自由排序、调节强度,增强结果在界面里立即刷新。另一个是图像标注工具,当自动增强效果不理想、刻痕没被充分抓出来的时候,用户可以自己上传图片、选笔刷大小、直接在图上描字,描完导出,交给后面的流程用。图7展示了增强应用的界面与输出,图8展示了标注流程。
石头上的字认不全怎么办,这一手人工兜底其实很务实。学术方法里很少这么干,但真实文物现场就是这么不确定,给用户留一个手动介入的口子,比强行宣称算法全自动更诚实。
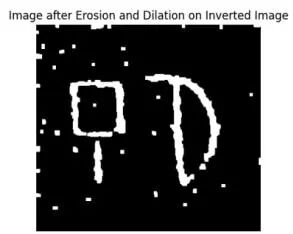
增强后的图还不能直接喂给网络,得先做OCR预处理:统一转灰度,二值化,再用膨胀腐蚀把毛刺清理掉,然后做轮廓分析找出可能是字的小区域。轮廓会按尺寸和长宽比过滤一遍,形状太奇怪、面积太小的直接丢掉,剩下的裁剪成字符块,缩放到卷积网络要求的输入尺寸,送进分类器。识别完成的字符会按坐标和间距重新排序,拼成词,再拼成句子。整个预处理链路的中间结果见图6。
那么训练数据从哪来?让考古学家手工标二十多万个字不现实,论文选择合成。流程是:用支持 Unicode 的 NotoSansBrahmi 字体把洁净字符渲染到 64×64 像素画布上并居中;再生成石质背景,像素值采样在 220 到 240 之间并叠加高斯噪声,模拟岩石的颗粒质感;随后加入麻点缺陷和随机裂缝,模拟侵蚀和结构损伤。凿刻感则靠形态学笔画变化来做——用最小值滤波和最大值滤波随机腐蚀或膨胀笔画,模拟刻刀压力不均;再把字符掩膜做空间偏移形成斜角,配合轻微高斯模糊表现雕刻深度与长期风化。为了增加多样性,每个样本还会在正负20度之间随机旋转,并加入椒盐噪声。最后把凿刻字符掩膜与石头背景混合,让纹理在字口内部依然可见。最终产出 253,800 张图、564 个字符类。
识别出来的字符还是婆罗米文,而翻译模型用的平行语料是罗马字母写的。中间必须架一座桥:论文先用婆罗米文到天城文的直接映射做中转,再按 ISO 转写方案换成罗马字母。这一步是确定性的字符映射,不含任何模型,好处是不引入新的误差,坏处是一旦OCR认错字,错误会被原样搬运到下一步,没有任何回旋余地。
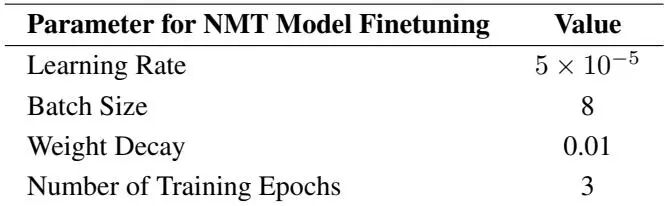
翻译这一环没有从零训练模型——2,224 对语料也撑不起从零训练。论文的做法是挑三个已经见过印度语言的预训练模型做微调,全部在 Google Colab 的 T4 显卡上跑,学习率 5×10⁻⁵,批大小 8,权重衰减 0.01,只训练 3 个 epoch。
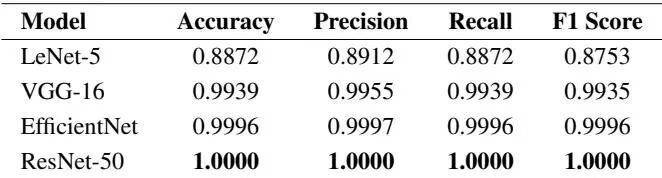
564类婆罗米字符识别:ResNet-50为何能100%准确? OCR这一环比较了四个卷积网络,各有各的定位。LeNet-5 是最轻的基线,两个卷积层加池化再串全连接,参数少、跑得快,用来回答"这事到底需不需要深网络";VGG-16 式模型把十三个卷积层拆成五组、每组两到三层,后面接三个全连接层,走的是"堆深度换特征"的老路子;ResNet-50 基于残差学习框架,用跳跃连接缓解深层网络的退化问题,是这一组的容量担当;EfficientNet 则靠复合缩放在精度和计算量之间找平衡。
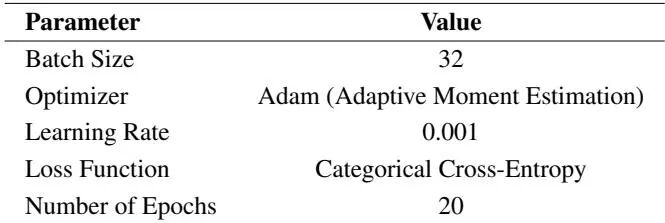
训练设置很朴素:输入是 64×64 的灰度图,输出层 564 个神经元对应 564 个字符类,批大小 32,Adam 优化器,学习率 0.001,交叉熵损失,只跑 20 个 epoch,而且用 Intel i5 第12代 CPU、16GB 内存就跑完了。这一点值得注意——意味着这套实验几乎是本科机房级别就能复现的配置。
结果层面有两件事要分开看。第一件是模型之间的相对关系:轻量基线明显落后,说明564类婆罗米字符的区分对模型容量有真实要求,浅层特征不够用;而一旦把深度堆上去,剩下三个模型的准确率都挤在99%以上,彼此差距极小。第二件是这个"满准确率"到底意味着什么。
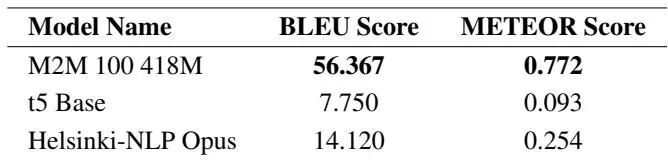
Prakrit到英语:哪个Transformer模型最能打? 翻译这一环选了三个已经在印度语言上见过世面的预训练模型。Facebook M2M-100(418M 参数)主打"任意100种语言之间直接互译",本身覆盖多种印度语言,本文挑的是马拉地语到英语这一支来适配普拉克里特语;Google T5-Base 是 2.2 亿参数的文本到文本 transformer,用的是印地语到英语的预训练版本;Helsinki-NLP 的 OPUS 模型同样基于印地语到英语预训练,选它的理由是印地语、马拉地语和普拉克里特语在语言谱系上相近。
两个评价指标也有必要交代。BLEU 基于n元词组精确率,算的是机器译文和参考译文在词串层面的重合程度,分值越高说明用词和语序越接近参考,是机器翻译领域最常用的自动化指标;METEOR 在BLEU基础上加入了同义词和词形变化匹配,被认为和对人工判断的相关性更好。两者配合看,能避免单一指标的偏颇。
从趋势看,三个模型之间的差距非常大,不是零点几分的你追我赶,而是断层式的领先与落后。多语言预训练背景更厚、直接用马拉地语变体适配的那个模型优势最明显;只用印地语变体、参数规模最小的T5-Base排在末尾。这说明在这类极低资源古代语言上,"预训练时见过多少相近语言"比"模型多大"更关键。
不过乐观情绪要再收一收。整个平行语料只有2,224对句子,按95%训练、5%测试切分,测试集大约只有一百来句,指标本身的波动区间就不小。更值得注意的是语料的来源:它取自 Hultzsch 编的《Corpus Inscriptionum Indicarum》第一卷,先人工把文本截成图片、用 Tesseract 做罗马字母识别、再人工核对,最后靠同义词替换做数据增强。训练句子和测试句子来自同一批文献、同一套增强流程,词面重叠的概率不低。所以这个高分更像是"模型确实学会了这批文献的表达方式",还不能直接等价于"能翻译任意阿育王铭文"。
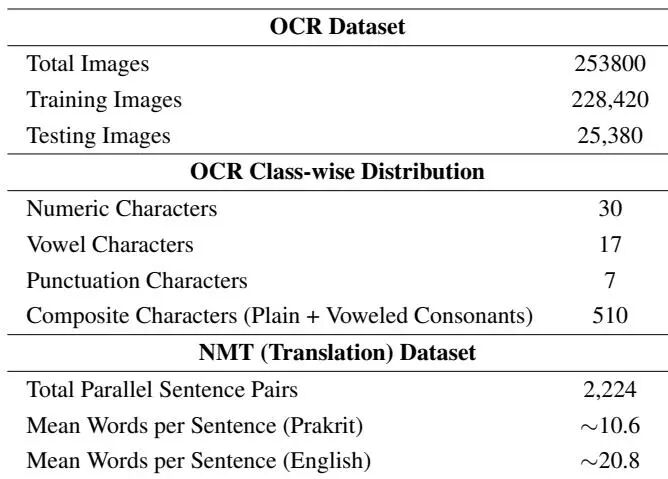
数据集与工具全开源:数字金石学的第一步 这篇论文最有分量的产出其实是数据,而不是模型。InscriptionOCR 数据集共 253,800 张字符图,覆盖 564 个字符类,其中数字字符 30 类、元音字符 17 类、标点字符 7 类、复合字符(纯辅音加带元音符号的辅音)510 类;训练集 228,420 张,测试集 25,380 张。整个数据集约 650MB,格式为 png,按训练与测试分目录,每个字符一个子文件夹,文件夹名就是该字符,这种组织方式拿来就能直接开跑。
翻译侧的数据是 2,224 对普拉克里特语—英语平行句对,两种语言都用罗马字母表示,以 csv 形式给出,第一列是普拉克里特语,第二列是英文译文。普拉克里特语句子平均约 10.6 个词,英文平均约 20.8 个词——英文差不多是原文的两倍长,这也符合英语表达更依赖虚词和从句的特点。
使用许可需要特别留意:数据集采用署名—非商业性使用 4.0 国际协议发布。也就是说,做研究、写论文、跑benchmark没问题,但要拿去做商业产品,得另外谈授权。这一点对打算直接接入产品的团队是个明确约束。
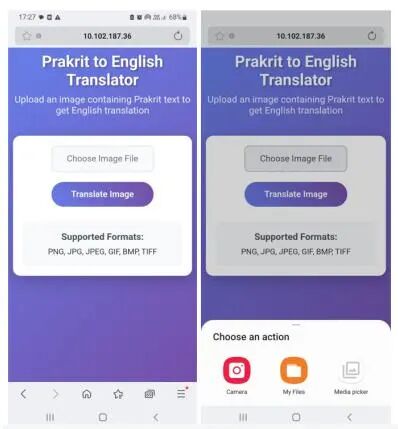
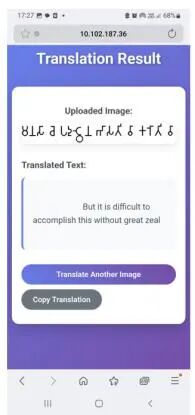
工具方面一共三件。图像增强与标注用 Streamlit 做,参数可视可调,效果实时可见;标注工具支持上传图片、选择笔刷大小、直接在图上描绘文字,标注结果可下载;最后一环是把 OCR、转写、NMT 串起来的 Flask 网页应用,用户上传增强后的铭文图就能拿到英文翻译。由于计算密集的操作放在服务器端执行,手机浏览器也能直接用,论文正是用手机端界面演示了完整流程。
论文还用一张图集中展示了方法的表现情况,把原始铭文、增强结果与识别输出放在一起对照,方便直观判断流水线在什么条件下灵、什么条件下不灵。
写在最后:AI考古的机遇与挑战 这篇工作的最大价值是把一个历史难题从"没法做"变成"可以开始做"。低资源古代文字研究长期卡在数据上,没有公开、可复现、可公平比较的数据集,任何模型都没法验证。现在有了 25 万张字符图和 2,224 对双语语料,至少基准是立起来了。
挑战同样清楚。第一是合成到真实的落差:训练数据由一套可参数化的模拟器生成,真实风化的统计规律更复杂、更不可控,域偏移有多大,论文没有量化。第二是评估闭环不完整:模型在真实铭文上的端到端翻译质量缺乏定量验证,目前更多是流程演示。第三是误差传播:增强、切字、识别、转写、翻译五道关卡串行,任何一环出错都会被后面的环节当作正确输入继续走下去,而链条中没有任何纠错或置信度回退机制。第四是语料规模仍然偏小,五位数的句对才能让翻译模型真正稳下来。
对做低资源任务的人来说,这套组合拳值得记下来:用可参数化的合成数据把冷启动问题顶过去,用经典图像处理压低前处理成本,用已在大语系上预训练过的模型做微调而不是从零训练,最后配一个人工兜底工具承认算法的边界。这不是最惊艳的技术路线,但在数据稀缺的领域,往往是能跑通的那条。
还有一个更远的想象空间:如果这条链路能被压缩到手机端离线运行,考古队在野外现场就能边拍边读,不用等回国再处理。论文选择了服务器端计算来保证手机可用,这是一个务实的折中,但离"随手一拍就出译文"的体验还有距离。
龙迷三问 这篇论文到底在解决什么问题? 印度理工学院甘地讷格尔分校提出端到端框架,把阿育王婆罗米石刻图像一路处理成英文:图像增强、CNN字符识别、转写加神经机器翻译,并开源25.38万张字符数据集与2224对Prakrit-English双语语料。这篇工作最值得看的点是什么? ResNet-50在OCR任务上达到100%测试准确率,EfficientNet达到99.96%,VGG-16达到99.39%,LeNet-5仅88.72%。NMT任务中M2M-100 418M取得最佳BLEU 56.367和METEOR 0.772,显著优于Helsinki-NLP OPUS(BLEU 14.120)和T5-Base(BLEU 7.750)。这篇工作的边界或风险在哪里? 优点:(1) 提出了首个端到端的古代铭文理解框架,涵盖图像增强到翻译的完整流程;(2) 构建了目前最大的婆罗米文字OCR数据集(253,800张图像,564类)和Prakrit-English平行语料库(2,224句对);(3) 开发了用户友好的图像增强和标注工具及Web应用,具有实际应用价值。缺点:(1) OCR模型仅在合成数据上训练和测试,未在真实铭文图像上验证,100%准确率缺乏说服力;(2) NMT数据集规模小,数据增强方式可能引入噪声;(3) 缺乏消融实验,无法评估各模块贡献;(4) 端到端评估缺失,未报告从原始图像到最终翻译的端到端性能;(5) 合成数据生成过程虽然精细,但与真实古代铭文的域差距未量化。如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~
龙哥点评 论文创新性分数: ★★★★☆
提出一个端到端AI框架,将图像增强、基于CNN的婆罗米文字OCR、转写和基于Transformer的神经机器翻译(NMT)串联起来,实现从低质量石刻铭文图像到英文译文的完整流程,并构建了大规模合成OCR数据集和Prakrit-English。实验合理度: ★★★★☆
OCR:准确率(Accuracy)、精确率(Precision)、召回率(Recall)、F1分数;NMT:BLEU、METEOR学术研究价值: ★★★★☆
提出一个端到端AI框架,将图像增强、基于CNN的婆罗米文字OCR、转写和基于Transformer的神经机器翻译(NMT)串联起来,实现从低质量石刻铭文图像到英文译文的完整流程,并构建了大规模合成OC。稳定性: ★★★☆☆
现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。适应性以及泛化能力: ★★★☆☆
现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。硬件需求及成本: ★★★☆☆
未明确报告FLOPs。OCR训练在16GB Intel i5 (12th Gen) CPU上进行,NMT微调在Google Colab的T4 GPU上进行。复现难度: ★★★☆☆
现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。产品化成熟度: ★★★☆☆
论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。可能的问题: 现有材料尚未充分覆盖分布外泛化、部署成本、长期稳定性和失败案例。
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击 "阅读原文", 查看更多原论文细节哦!

还没有公开留言,欢迎留下你的看法。