← 返回 PaperDaily
大模型与智能体
墨西哥国立理工学院:Qwen3-14B弃答实测,答得更多、错得更少
先讲一个大家都踩过的坑。你问一个模型某个偏门的事实问题,比如某本小众小说里配角的全名,或者某个 1998 年的会议在哪座城市举办,模型张口就来,语气笃定、句式工整、标点齐全——一查,全是编的。
龙哥读论文
发布于 2026-10-18 01:22:03
阅读 9
查看原文
原论文信息如下:
先讲一个大家都踩过的坑。你问一个模型某个偏门的事实问题,比如某本小众小说里配角的全名,或者某个 1998 年的会议在哪座城市举办,模型张口就来,语气笃定、句式工整、标点齐全——一查,全是编的。这不是模型偷懒,而是它的训练目标里压根没有「承认自己不会」这一项。
学术界把这类问题统称为幻觉(hallucination)。Huang 等人在相关综述里把它拆成两类:一类是事实性错误 忠实性错误
这个问题其实不新。早在 1970 年,Chow 就把「答还是拒答」形式化成选择性预测
但现实是,工程上大家几乎只盯两个数字:答对多少、答错多少。很少有人把「该不该答」当成一个可以单独训练的决策变量。这恰恰是落地时最要命的环节——用户不会因为你答对了 95% 就原谅那 5% 编造出来的数字,尤其是当这个数字出现在医疗、金融、法律场景里的时候。
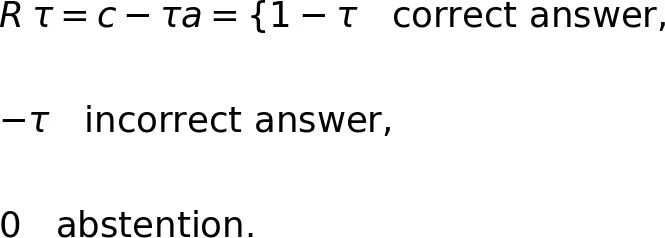
本论文把这个决策拆成了三条可测量的指标:效用、覆盖率和选择性风险。效用是平均得分,越高越好;覆盖率是「有多少问题被真正回答了」的比例;选择性风险则是「在被回答的那些问题里,错的比例」。三者关系可以用下面这组定义写清楚。
用一个具体数字感受一下。当阈值 τ 取 0.85 时,答对拿 0.15 分,答错扣 0.85 分,弃答拿 0 分。也就是说,弃答是一个「保底选项」,不赚不亏;只有当模型认为自己答对的概率超过 0.85 时,张嘴才是划算的。这个设定把「不确定性」变成了一个可以算账的东西,而不是靠感觉判断。
还有一个容易被忽略的恒等关系:在固定阈值下,效用等于覆盖率乘以(1 减去选择性风险再减去阈值)。这意味着,想让效用为正,被回答的那部分问题,正确率必须高于阈值本身。这就把「多答」和「答准」这两个目标,硬生生绑在了同一根绳子上。
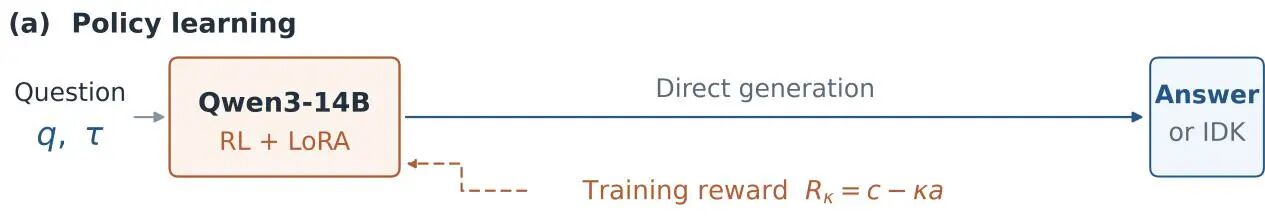
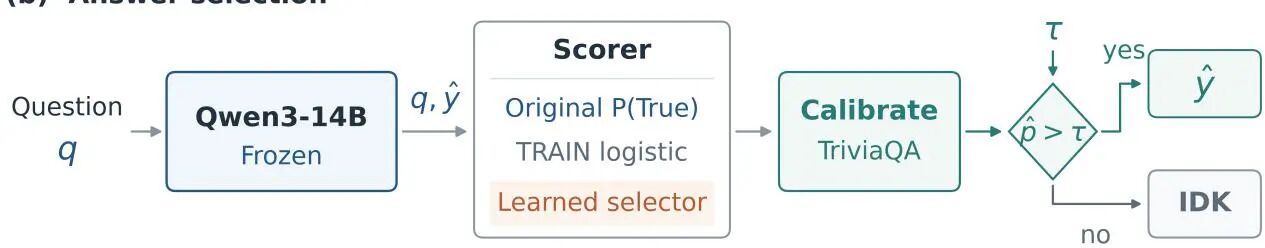
两条路线对决:训练模型自己弃答 vs 另训一个答案选择器 面对「该不该答」,本论文给出了两条截然不同的技术路线,并且把它们放在同一套评分规则下正面对撞。第一条是改生成策略,让模型自己学会在回答和弃答之间做选择;第二条是生成模型一根手指都不动,另训一个打分器来判断「这个答案值不值得放行」。
路线一:策略学习。 路线二:答案选择器。 两条路线背后共用同一个评分规则,这个规则同时承担「训练奖励」和「评估标准」两个角色,是本论文实验设计里最值得注意的一点。
在答案选择器这条线上,本论文准备了三种打分方式。最便宜的是原始模型自带的 P(True) 分数——把问题和候选答案一起喂回模型,让它判断这个答案对不对,这个思路来自 Kadavath 等人的工作。具体做法是取打分提示词后「True」和「False」两个 token 的下一个位置 logit 之差,再经过 sigmoid 映射成概率。
第二个是学习到的选择器(learned selector):用同一批问题,让生成器产出 1 个贪心答案加 3 个采样答案,凑出 8000 条训练样本,再训一个独立的 LoRA 适配器,只根据问题和候选答案判断是否精确匹配,损失函数是二元交叉熵。第三个是控制组,本论文称之为 TRAIN logistic——把选择器能拿到的训练标签,直接喂给一个作用在原始分数上的逻辑回归,看看到底是「分数本身变好了」还是「标签在起作用」。
这个控制组的设计相当讲究。它拿到的标签和选择器一样多,但它的输入只是原始 logit 差这么一个标量,两次仿射变换复合之后还是一次仿射变换,本质上没法学出新的问题—答案特征。它匹配的是「可用标签」,不是模型容量。
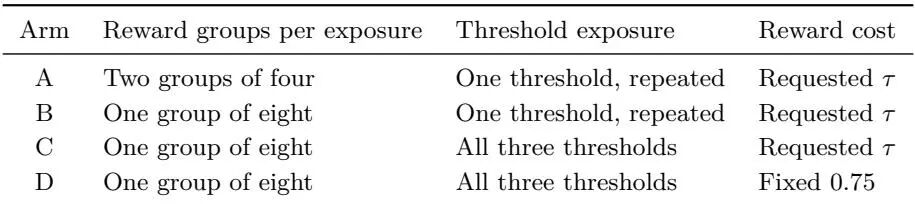
策略学习这一侧的实验架次更细,一共四组、十二次训练,用一张表格把变量拆得明明白白。
A 组把每个问题的一次采样拆成两组各四个响应,奖励基线用组内其它响应做留一法估计;B、C、D 组则把八个响应放在一起算基线。A 与 B 的差别只在于基线怎么算,总生成量完全一致。C 组和 D 组都会让每个问题在三个训练阈值下各练一遍,区别在于 D 组的奖励里永远只用 0.75 这个均值,不管提示词里写的是哪个阈值。这个设计想回答的问题是:模型到底有没有「读懂」请求里的阈值,还是只是被奖励函数牵着走。
为什么奖励设计会让模型宁愿瞎猜也不弃答 这是全文最容易被跳过、但实际上最值钱的一段。假设一个评分规则只奖励答对,答错和弃答拿一样的分数,会发生什么?答案很简单:模型会疯狂输出。因为猜一把至少有概率得分,而弃答恒定 0 分,从期望上看,答题永远不亏。这套激励结构下,模型没有理由闭嘴,它就是个话痨。
一旦给错误加上惩罚,整个账本就翻了。设模型答对的概率为 p。答题的期望得分是 p 乘上(1 − τ)再加上(1 − p)乘上负 τ,化简之后就是 p − τ。而弃答恒为 0。两者一比,只要 p 大于 τ,答题就更划算;只要 p 小于 τ,闭嘴才划算。那条分界线,正好就是阈值本身。
所以 τ 这个符号在本文里有双重身份:在评估端它是「错误的价格」,把不同风险偏好折算成一个标量;在训练端它是一条鼓励模型自我怀疑的信号线。τ 从 0.6 涨到 0.9,等于把答错的罚款从 0.6 提到 0.9,模型必须越来越有把握才敢开口。
但这里有个必须说清楚的边界:这个规则只提供激励,它并不保证模型真的知道自己的成功率。模型优化的是「拿高分的动作模式」,不是「对自身认知状态的准确内省」。这两件事之间差着一整个校准(calibration)问题。
顺带一提,本论文在阈值上是刻意做隔离的:策略训练只见过 0.60、0.75、0.90 三个值,而主测试用的是 0.65 和 0.85,这两个值在训练里一次都没出现过。这个设计直接堵死了「模型是不是把训练阈值背下来了」这条退路,也让后面「提示词里的阈值能否影响弃答行为」这个观察更有说服力。
TriviaQA上覆盖率与错误率双赢,NQ上却翻车 训练池是 2000 道 TriviaQA 问题,另有各自 500 道的开发集和校准集。测试集是另外 2000 道 TriviaQA 验证问题和 500 道 NQ-Open Original Dev 问题。测试题通过固定哈希挑选,并且排除了早期研究分区和示例里用过的题目编号与归一化文本。这里原文也老老实实承认了一件事:这些题在新的研究范围内是新的,但并不能证明预训练阶段没见过,污染问题没有被排除。
硬件是一张 NVIDIA GB10,约 128GB 统一内存。训练前的一次计时检查把强化学习的题目规模从 1008 道统一砍到 504 道,每次强化学习跑 252 次更新、共生成 12096 个响应;选择器则使用完整的 2000 道训练池、跑 500 次更新,学习率 10⁻⁵。三组随机种子是 17、29、43,取每个种子的最终检查点,没有任何配方、种子或检查点是按测试结果挑出来的。
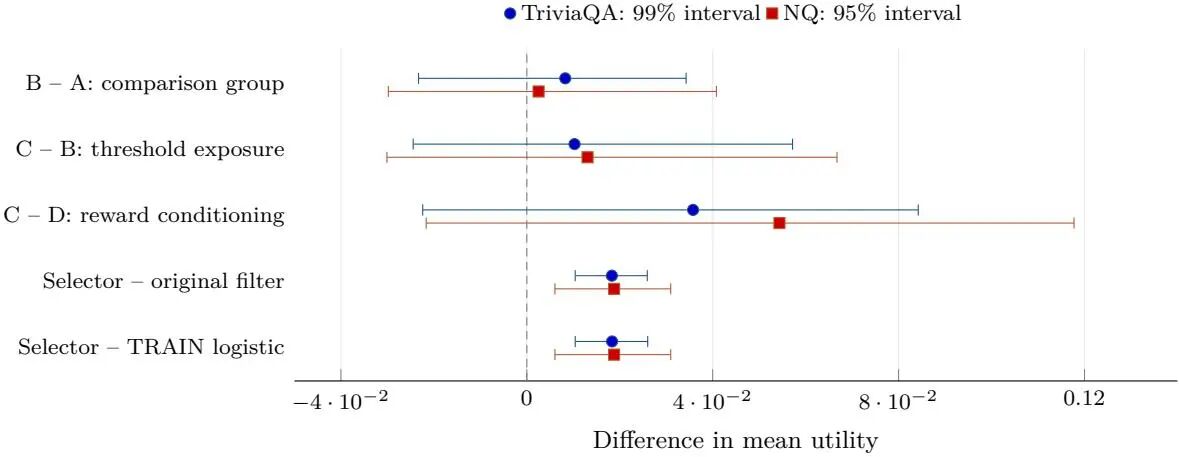
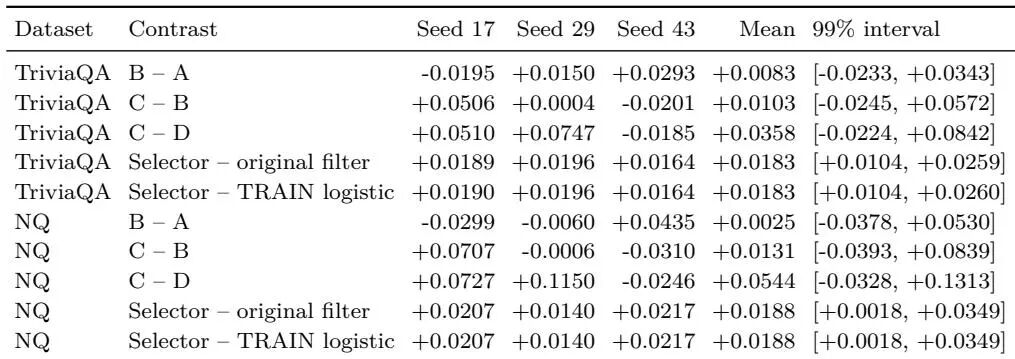
统计方法值得单独提一句。因为有五个预先指定的 TriviaQA 对比,本论文用了配对自助法(bootstrap)做 10000 次重采样,同时重采样问题索引和三个训练种子索引,再用 Bonferroni 校正把 99% 的区间覆盖到名义 95% 的整个对比族上。NQ 上的对比只作为描述性结果给出普通 95% 区间。所有区间都以共享的训练候选池和已拟合的校准器为条件,原文也直言:三个种子对训练波动的刻画能力有限。
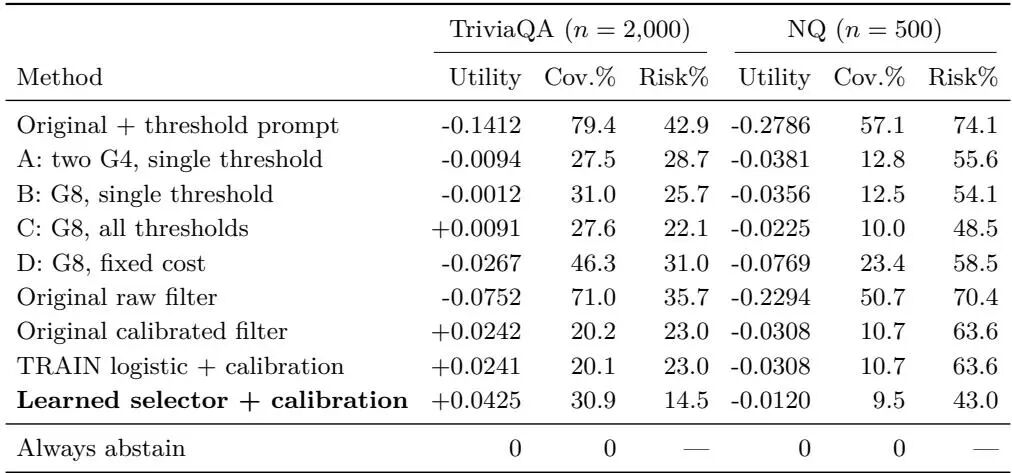
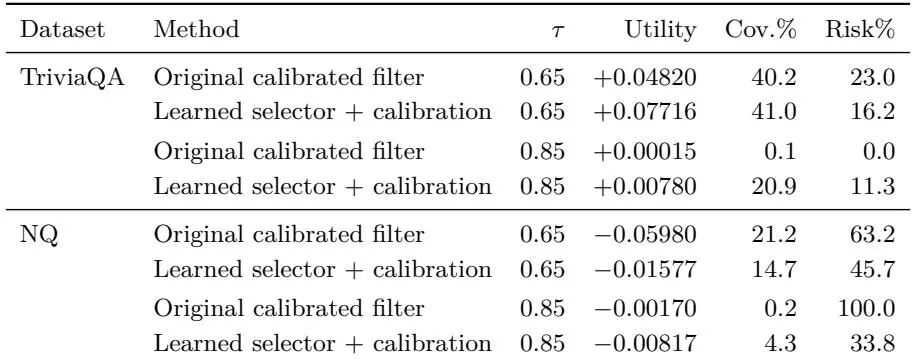
先看这张表里最亮的一行。学习到的选择器加上校准之后,TriviaQA 平均效用达到 0.0425。作为对照,原始模型的校准置信度过滤器只有 0.0242,完全弃答是 0。配对改进量是 0.01830,99% 自助区间是 [0.01041, 0.02593],而且三个种子上改进方向都是正的。更妙的是,同一个控制组 TRAIN logistic 加校准之后只有 0.0241,跟基线基本齐平——同样的训练标签喂进去,却没吃掉选择器的红利。
覆盖率这边的变化很容易被忽略。原始校准过滤器只回答了 20.2% 的问题,换成选择器之后是 30.9%,大致相当于每 100 道题从 20 道答到 31 道。与此同时,被评分答案里的汇总错误率从 23.0% 压到 14.5%。答得更多、错得更少
翻到 NQ 那三列,气氛就变了。选择器把平均效用从原始过滤器的一 −0.03075 提到了一 −0.01197,差值 0.01878,描述性 95% 区间是 [0.00605, 0.03097],方向上是改善的。但问题在于:一 0.01197 仍然是负数,而完全弃答的效用电是 0
把阈值拆开看,能看得更清楚。在 0.85 这个更严格的门槛上,原始校准过滤器在整个 TriviaQA 测试集上只放行了两个答案,而且两个都对;选择器在同样的门檻下依然放行了一批答案,其中大多数是对的。覆盖率提升的主要来源就在这里。NQ 的 0.85 门槛下,两个逻辑回归过滤器一个答案都不放,而选择器还是放了一些出来,只是这些答案的效用是负的。
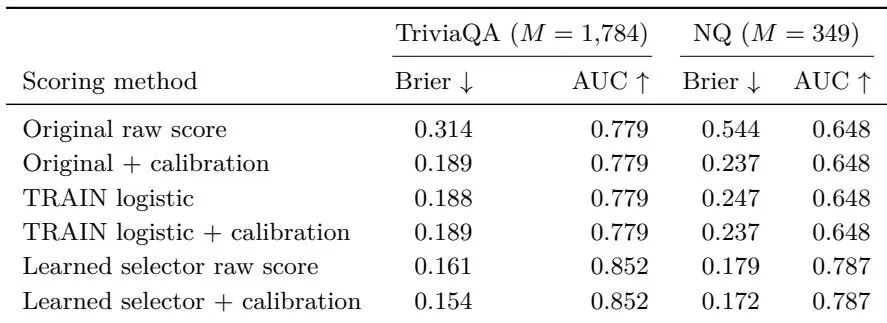
除了最终的决策效用,本论文还单独看了打分信号本身的质量。在 1784 个有效且非弃答的 TriviaQA 候选上,选择器的 ROC AUC 从原始分数的 0.779 提升到三个种子平均的 0.852;校准前的布里尔分数从 0.314 降到 0.161,校准后分别变为 0.189 和 0.154。NQ 的 349 个候选上,AUC 从 0.648 升到 0.787,校准后的布里尔分数从 0.237 降到 0.172。需要提醒的是,布里尔分数同时反映校准度和区分度,所以它的下降不能单独归功于「校准变好了」。
强化学习那一边的结果,老实说没有惊喜。TriviaQA 上三个对比的平均效用差都是正的:把奖励比较组从四个扩到八个是 0.00827(B 减 A),让每个问题在三个阈值下都练一遍是 0.01027(C 减 B),让奖励与请求阈值挂钩是 0.03578(C 减 D)。但三个校正区间全部包含零,而且在不同种子上的方向会翻面。以 C 减 D 为例,99% 区间是 [−0.02240, 0.08424],这个宽度比效应本身还大。原文的措辞很克制:这些结果既不能确认改进,也不能证明被比较的方法等价。
不过里面藏着一个挺有意思的观察。把请求阈值从 0.65 提到 0.85,C 组的 TriviaQA 覆盖率下降了 2.03 个百分点,固定成本控制组 D 下降了 2.23 个百分点。D 组的训练奖励里根本不含阈值,它只认 0.75,可它的行为依然跟着提示词里的阈值走。这说明提示词里的阈值本身就能影响弃答行为
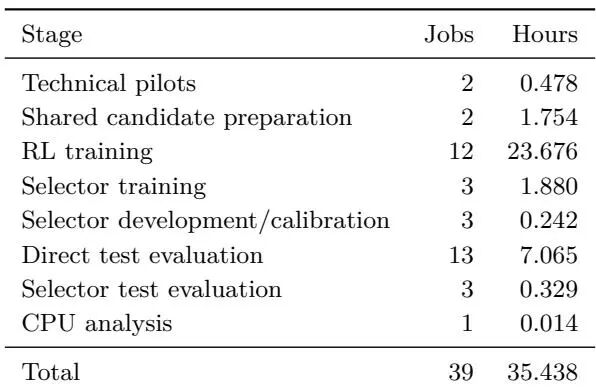
本论文还把算账的功夫做得很足。全部实验累计 35.44 小时的串行任务时间,包含试跑、模型加载、候选准备、训练、评估和 CPU 分析;其中十二次强化学习占 23.68 小时,三次选择器训练只占 1.88 小时。原文特意声明,这些是实验任务的耗时账,不是 GPU 利用率也不是部署延迟的测量,而且两种训练流程的预算并不相同。这句话很清醒:选择器训练只用了强化学习大约十二分之一的时间,就拿到了更明确的收益
TriviaQA 上选择器为什么能赢?本论文给出的解释是:它是一个专门为「判断答案对不对」这个任务训练的模型,能从问题和候选答案的文本里抽出原始标量分数看不到的特征。控制组实验正好支撑了这一点——同样的训练标签,作用在一个固定标量上,收益几乎归零。这说明红利来自特征学习,不是标签本身。
NQ 上为什么翻车?两个原因叠在一起。一是校准器在 TriviaQA 上拟合,直接搬到 NQ 使用,不再重新拟合,域偏移带来的偏差无处消解;二是在高阈值区间,能放行的答案数量太少,单条答案的正确与否就直接决定整体效用的正负,统计上的嗓声被放大到极致。原文自己也指出了这一点:0.85 阈值下原始过滤器只放行一个错误答案,就足以让它看起来比选择器好。
强化学习为什么不显著?可以列出几条现实约束。第一,训练预算被统一砍到 504 道题,训练分布本身就窄;第二,奖励信号来自采样组内的相对比较,方差天然偏大,只剩三个种子根本拉不开信噪比;第三,策略学习的优化目标是一整段生成行为,而弃答决策只是其中一个非常稀疏的动作,梯度传播的效率远不如一个专门做二分类的打分器。三条叠加,区间宽到吞掉效应量也就不奇怪了。
还有一个值得玩味的反差:选择器在 NQ 上的打分质量其实明显更好,AUC 从 0.648 升到 0.787,布里尔分数也从 0.237 降到 0.172。分数更好,决策却仍然为负。这说明「分数排得准」和「在指定阈值下赚钱」是两件不同的事情
校准迁移与精确匹配评分:结论的边界在哪里 先把「校准」这个词说清楚。校准问的是一件很朴素的事:模型说「我有 80% 把握」的时候,实际情况里是不是真的约有 80% 是对的。如果模型总是说 95% 但实际只有 60% 对,那就是过度自信。本论文采用的是把单个标量分数映射成概率的做法,用的是与 Platt 标定(Platt scaling,又称 sigmoid 拟合)一脉相承的逻辑回归。
本论文在这里做了一个很重要的概念切分:学一个更有信息量的分数、把这个分数校准、再施加放行阈值,是三件不同的事
校准的迁移策略偏保守:全部在 TriviaQA 上学习,原封不动搬到 NQ,不重新拟合。好处是干净,坏处是把域偏移的成本全部暴露出来。这也正是 NQ 结果偏负的重要原因。原文还诚实地指出,这属于经验型逻辑校准,不像保形弃答(conformal abstention)那样在可交换性假设下能提供有限样本保证;而且保形方法控制的是边际错误率,跟「被放行的答案里的条件错误率」并不是同一个量,两者不能混着说。
接下来是全文最容易被一带而过、但实际上最能体现研究诚实度的一段:自动评分的复核。评估用的是归一化精确匹配(Exact Match,简称 EM),候选答案必须与参考别名严格对得上才算对,空输出或截断输出计为错误。问题在于,Katalloo 等人的工作早就说明,词法层面的评分会误杀语义上正确的回答——比如模型答「纽约市」而参考答案里只列了「纽约」。
本论文抽了 150 个响应单元做复核,来自 144 道题,其中 100 个是过滤器共享的候选、50 个是强化学习响应,每个数据集各 75 个单元。抽样按自动标签和过滤器决策模式分层。结果是这样的:104 个正确、19 个错误、24 个弃答、3 个不明确。而在被精确匹配判为错误的那些里,有 40 个在语义上其实是对的
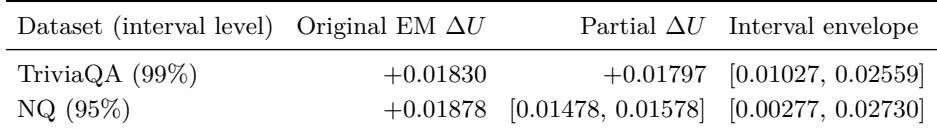
把复核标签套到同一批单元上,TriviaQA 上的效用差从 +0.01830 微调到 +0.01797,区间包络是 [0.01027, 0.02559],主结论没有被推翻。NQ 上的效用差则在 [0.01478, 0.01578] 这个窄带里浮动,符号没有变化——即使把误伤的答案还回去,NQ 的整体效用仍然是负的
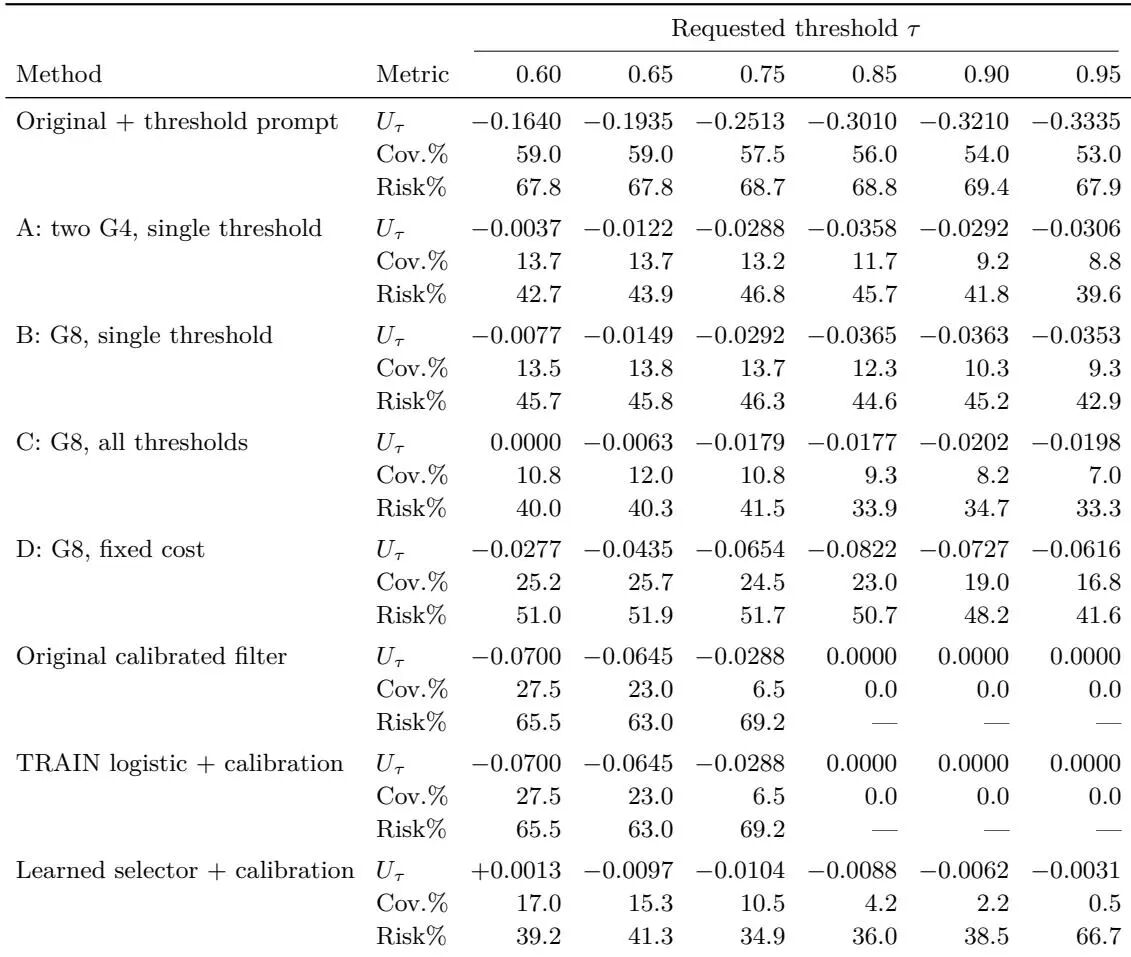
本论文还在同样的 200 道固定问题上,把所有六个阈值跑了一遍做诊断面板,包括训练时见过的 0.60、0.75、0.90,以及没见过的 0.65、0.85、0.95。
把所有边界条件收拢一下:结论建立在 Qwen3-14B 这一个模型、TriviaQA 与 NQ-Open 两个数据集、三个训练种子、两个主要阈值和一张 GB10 显卡的预算之内。迁移是不重新拟合的硬迁移。评分以词法精确匹配为主,配一次部分人工复核作为敏感性检查。原文的结论措辞很准确:这些结果支持「在这个设定下学习去选择答案」,但不支持「跨数据集可靠弃答已经解决」。
从这篇论文能学到什么:选择性预测的实验设计套路 这篇论文的实验分数不一定最高,但它的实验设计是那种可以抄作业的水平。把它拆开看,至少能拎出几条可复用的套路。
第一,把训练阈值和测试阈值刻意隔开。
第二,给对比方法共享同一批候选答案。
第三,为每一种「可能的解释」配一个控制组。
第四,预先指定对比数量并做多重比较校正。
龙迷三问
这篇论文到底在解决什么问题? 大模型不确定时该不该弃答?论文用 Qwen3-14B 对比两条路线:强化学习直接训模型弃答,或另训一个答案选择器。这篇工作最值得看的点是什么? 在TriviaQA上,学习到的选择器把平均覆盖率从原始校准过滤器的20.2%提升到30.9%,已评分答案的合并错误率从23.0%降到14.5%,平均效用从0.02418升到0.04248,配对提升0.01830,99%区间[0.01041, 0.02593],且每个种子都为正;相对TRAIN logistic的效用差为0.01834,99%区间[0.01041, 0.02602]。置信分数质量也更好:TriviaQA上AUC从0.这篇工作的边界或风险在哪里? 优点是问题设定清晰、评测规则统一且成本敏感,两条路线在同一批候选答案上公平对比,留出阈值与跨数据集迁移设计严谨,TRAIN logistic对照与部分人工复核提升了结论可信度,代码与配置公开可复现。缺点是RL干预与选择器的训练预算不匹配,无法直接比较两种机制的上限;RL只有三个种子且区间宽,结论不可判定;选择器依赖在TriviaQA上拟合的校准,迁移到NQ后虽排序更好却无法带来正效用,说明校准迁移是瓶颈;评测以精确匹配为主,会误判语义正确的回答,人工复核仅覆盖150个单元且为单人AI辅助,无法估计整体评分误差;未与TruthRL、I-CALM等已有弃答方法在同一设置下直接对比。如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~ 龙哥点评
论文创新性分数: ★★★★☆
在Qwen3-14B上系统对比两条实现选择性回答的路线——用强化学习训练生成模型自身学会回答或弃答(四种受控RL变体),以及冻结生成器、另训一个LoRA答案选择器对候选答案打分并做逻辑斯蒂校准后按阈值释放,从而在统一效用函数下判断哪种干预更。实验合理度: ★★★★☆
效用U_τ(式1的成本敏感得分)、覆盖率Coverage、选择性风险Selective Risk、ROC AUC、二元Brier分数;学术研究价值: ★★★★☆
在Qwen3-14B上系统对比两条实现选择性回答的路线——用强化学习训练生成模型自身学会回答或弃答(四种受控RL变体),以及冻结生成器、另训一个LoRA答案选择器对候选答案打分并做逻辑斯蒂校准后按阈值。稳定性: ★★★☆☆
现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。适应性以及泛化能力: ★★★☆☆
现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。硬件需求及成本: ★★★☆☆
全部实验串行任务时间35.44小时,其中12次RL训练23.68小时,3次选择器训练1.88小时,共享候选准备1.75小时,直接测试评测7.07小时;RL每次更新使用2个问题、48个响应,共252次更新、12096个生成响应;复现难度: ★★★☆☆
https://github.com/jrterven/Can-LLMs-learn-to-abstain产品化成熟度: ★★★☆☆
论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。可能的问题: 设定清晰、评测规则统一且成本敏感,两条路线在同一批候选答案上公平对比,留出阈值与跨数据集迁移设计严谨,TRAIN logistic对照与部分人工复核提升了结论可信度,代码与配置公开可复现。缺点是RL干预与选择器的训练预算不匹配,无法直接比较两种机制的上限;RL只有三个种子且区间宽,结论不可判定;
*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击 "阅读原文", 查看更多原论文细节哦!


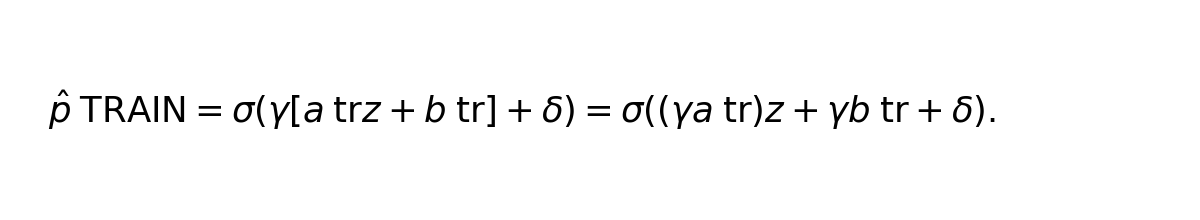
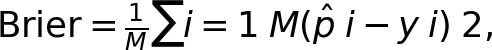

还没有公开留言,欢迎留下你的看法。