← 返回 PaperDaily 大模型与智能体

Nimbus BCI 平台验证:六条脑电解码流水线与手写脚本 0.00 点差异

一个可视化平台宣称自己算出来的数字和手写脚本一样,这话到底该不该信?Nimbus BCI 给出的答案是:六条经典脑电解码流水线,三个公开数据集,两种评估协议,平台引擎与独立手写实现各跑一遍,逐被试比准确率。确定性流水线全部 0.00 点一致,深度模型的差异落在训练种子噪声里。软件平台自己做验证研究,这事本身就少见,值得看一眼它的验证设计和边界。

Nimbus BCI 平台验证:六条脑电解码流水线与手写脚本 0.00 点差异
原论文信息如下:
论文标题:
Nimbus Studio reproduces reference BCI decoding pipelines: a validation study on public benchmarks across protocols and paradigms
发表日期:
2026年10月
发表单位:
Nimbus BCI
原文链接:
https://arxiv.org/pdf/2610.13894v1.pdf
项目链接:
https://studio.nimbusbci.com/
先说一个场景。你打开一个脑机接口实验平台,拖拖拽拽搭好一条解码流水线,点运行,屏幕上跳出一个准确率:61.15%。数字挺好看,问题是——它可信吗?
如果同样的数据、同样的滤波、同样的分类器,换成你自己写一段 Python 脚本跑,也是 61.15%,那没事。可如果跑出来是 58%,这个平台的数字就有问题了。
这不是吹毛求疵。脑机接口(Brain–Computer Interface,BCI)研究圈子里有个公开的秘密:绝大多数论文报告的解码准确率,本质上是几个 Python 库的组合拳——MNE-Python 管信号处理,scikit-learn 管经典机器学习,MOABB(Mother of All BCI Benchmarks,BCI 基准测试工具箱)管数据集和评估协议,braindecode 管深度学习模型,pyriemann 管黎曼几何方法。这些库各管一段,然后用一份手写脚本串起来。
可视化流水线平台想解决的是另一类问题:可复现性、协议共享、降低新人门槛。你不写代码,拖个图就能跑实验。但随之而来的是一个躲不掉的信任问题——平台画的这张图,算出来的东西和等价脚本算出来的东西,到底是不是同一个东西?

BCI平台的数字到底能不能信?一场"双盲"验证实验

Nimbus Studio 这篇论文要回答的就是上面那个问题。它做了一件在同类软件里不算常见的事情:不自己证明自己,而是做一场等价性验证。论文署名单位是 Nimbus BCI,作者 Sergey Musienko,2026 年 10 月挂上 arXiv。
文章标题里那个"双盲"其实要打个引号。它并不是严格意义上的双盲实验,核心做法是:每一条流水线写两遍。一遍在 Nimbus Studio 里搭成节点图,由平台的生产执行引擎运行;另一遍完全不碰平台代码,直接用 MNE-Python、scikit-learn、pyriemann、braindecode 这些库手写一份独立参考实现。两边保持相同的超参数、相同的数据文件、相同的随机种子,逐被试比较测试准确率。
这个设计的关键在于参考实现的独立性。软件平台通常用回归测试保证质量,但回归测试是平台作者自己写的,等于自己出题自己考。这篇论文试图站到用户位置上,用外部标准回答"这个数字能不能信"。
论文里给了一个类比:这种验证模式,跟消费级脑电硬件进入研究领域之前所做的一致性验证是同一套逻辑。硬件得先证明自己测出来的脑电波形和实验室级设备一致,软件得先证明自己算出来的解码结果和标准脚本一致。

六条经典解码流水线的前世今生

要理解这场验证,得先认识被验证的六条流水线。它们不是随便挑的,基本覆盖了脑电解码领域最主流的经典方法,也横跨两个不同的实验范式。
第一个范式是运动想象。受试者不做实际动作,只在脑子里想象左手或右手运动,大脑运动皮层的 μ 节律和 β 节律会出现事件相关去同步,解码器就从这种脑电变化里判断"他想的是哪只手"。
CSP+LDA 是运动想象里最经典的组合。CSP 全称 Common Spatial Pattern,中文叫共空间模式,作用是把多通道脑电投影到一组空间滤波器上,让两类信号的方差差异最大化。投影完取对数方差当特征,喂给 LDA(Linear Discriminant Analysis,线性判别分析)做分类。这条流水线老得可以进博物馆,但到今天依然是运动想象基准测试的常客。论文里用了 8 个 CSP 分量,不做特征缩放。
Riemannian MDM 走的是另一条路。它不投影特征,而是把每个试次的脑电协方差矩阵当成黎曼流形上的一个点,分类时计算测试样本到各类别中心点的黎曼距离,谁近算谁。MDM 是 Minimum Distance to Mean 的缩写,中文可以叫"最小距离均值",出自 Congedo 等人 2017 年那篇黎曼几何综述。协方差估计用 Ledoit–Wolf 方法。
Tangent space + LR 可以理解为黎曼方法的一个变体。它同样从协方差矩阵出发,但先把矩阵投影到切空间(tangent space)——粗略理解就是把弯曲的黎曼流形局部拉平——得到欧氏空间向量,再用多项式逻辑回归分类。协方差估计用 OAS 收缩。这条流水线比较特别:在 Nimbus Studio 这边,它不是平台内置节点,而是通过用户自定义代码节点跑起来的。
第二个范式是 P300。这是事件相关电位里研究得最透彻的成分之一,受试者看到罕见目标刺激时,大约 300 毫秒后会出现一个正向波峰。经典应用是拼写器:字符矩阵快速闪烁,受试者盯着想输入的那个字符,系统通过 P300 判断目标。
xDAWN+LDA 是 P300 解码的代表性方法。xDAWN 是一种空间滤波算法,名字来自 Rivet 等人 2009 年 IEEE TBME 的论文,目标是在估计目标响应的同时最大化信噪比。论文里用 MNE 的实现,每个事件类型取 2 个分量,后接 scikit-learn 的 LDA。
最后两条是深度学习方法。ShallowConvNet 来自 Schirrmeister 等人 2017 年的工作,在 braindecode 里的类名叫 ShallowFBCSPNet,思路是把 FBCSP 这种经典方法的操作显式地表达成卷积层,深度很浅但针对脑电信号特性做过专门设计。EEGNet 来自 Lawhern 等人 2018 年的论文,是一个更紧凑的卷积网络,用深度可分离卷积把参数量压下来,在多个脑电解码任务上表现都不错。
论文里 ShallowConvNet 用 30 个训练轮次、批大小 64、Adam 优化器、学习率 10−3,20% 分层验证留出加最优检查点选择;EEGNet 用平台默认配置,F1=8、D=2、dropout 0.25、时间卷积核长度约为采样率的一半。两条深度流水线只在 BNCI-2014-001 上跑,论文解释是受 CPU 预算限制。
数据方面用了三个公开基准。BNCI-2014-001 是运动想象数据集,22 通道、250 Hz、4 类、9 名被试、每人 576 个试次。BNCI-2014-004 也是运动想象,但只有 3 通道、2 类、9 名被试,通道数少得多,是更轻量的设置。BNCI-2014-009 是 P300 拼写器数据集,来自 EPFL,16 通道、256 Hz、目标/非目标二分类、3 个 session、10 名被试、每人 1728 个 epoch。
预处理统一:运动想象流水线走 4 阶巴特沃斯 8–30 Hz 零相位带通滤波,P300 流水线走 1–30 Hz,两边都通过 MNE-Python 的公开滤波接口实现。
评估协议有两种。第一种是会话留出,训练集用标记为 train 的 session,测试集用标记为 test 的 session,这个划分来自数据包元数据,两边应用完全一致,最终报告每个被试的测试准确率。第二种是留一被试交叉验证,简称 LOSO(Leave-One-Subject-Out),把数据集里所有被试的数据汇成一个队列,每次留出一个被试做测试,其余被试做训练,这样每个试次都是由从没见过该被试数据的模型来打分。
LOSO 这边值得多说一句:在 Nimbus 侧,它是通过平台的评估计划节点跑的,也就是部署产品里实际使用的分组交叉验证驱动;在参考侧,它是一个普通的逐被试循环。两边算的是同一件事,但组织方式完全不同。

当平台遇上手写脚本:0.00个百分点的完美对齐

先说确定性流水线的结果,就是 CSP+LDA、Riemannian MDM、切线空间加逻辑回归这三条——它们不含随机初始化,理论上就应该完全可复现。
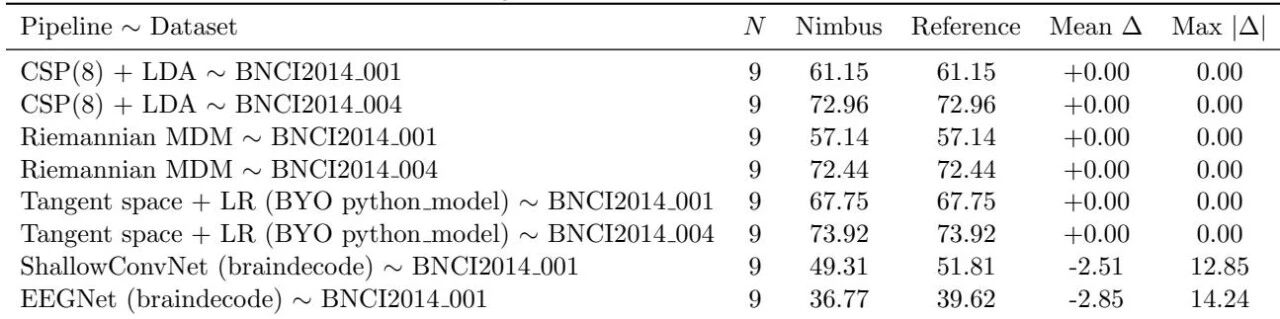
会话留出协议下,CSP+LDA、MDM 和切线空间流水线在 BNCI-2014-001 和 BNCI-2014-004 的每一个被试上都与参考实现一致到 0.00 个百分点。论文特别强调了一个数字:54 次被试运行,54 次全部命中。
Table 1 Session-holdout parity
表 1:会话留出协议下的测试准确率(%)对比。N 为被试数,Nimbus 与 Reference 两列分别是平台和独立参考实现的准确率,∆ = Nimbus − Reference,单位为百分点。上面六行是确定性流水线,全部 0.00;下面两行是深度模型,差异落在种子噪声里。
这个数字说明的东西比表面看起来要多。平台上的节点连线——带通滤波、空间滤波、解码器、指标计算——实际执行的算子和参考脚本里一步步调用的算子,达到了数值精度级别的一致。不是"差不多",不是"误差在可接受范围",而是直接相等。
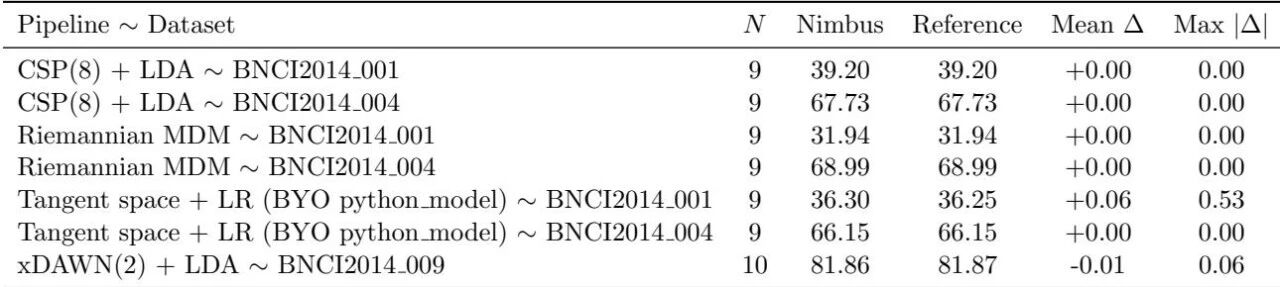
分组交叉验证的结果同样干脆。CSP+LDA 和 MDM 在留一被试协议下,36 个运动想象折全部 0.00 个百分点一致。这意味着平台那套评估计划驱动的分组交叉验证编排逻辑,和手写的逐被试循环,跑出来的是同一个结果。
Table 2 Grouped LOSO parity
表 2:分组交叉验证(留一被试)下的汇总折外准确率(%)。折 i 表示第 i 个被留出的被试。注意最后一行 P300 的 xDAWN+LDA,汇总差 0.01 个百分点,最差折 0.06 个百分点——折算下来是 1728 个试次里差一个试次。
这里有一个技术细节值得展开。输入数据是逐比特一致的,逐折特征的相对误差在 10−11 量级——两个实现在数值上基本相同。那 0.06 个百分点是从哪来的?论文的解释是浮点舍入,而且被 xDAWN 内部的特征值分解放大了。xDAWN 要对协方差矩阵做特征值分解来求空间滤波器,这类操作对输入最后几位小数值天生敏感。所以这 0.01 到 0.06 的差异不是实现逻辑不同,而是浮点运算的固有特性。
论文还做了一个合理性检查。把所有结果和 MOABB 在这几个数据集上 CrossSubject 评估下报告的数值范围对一下:CSP 在 001/004 上分别是 39.2% 和 67.7%,MDM 是 31.9% 和 69.0%,P300 是 81.9%。这些数都落在 MOABB 公布的范围里。论文明确强调,这只是一个合理性区间检查,不能直接和排行榜数字比——因为划分方式和超参数调优策略都不一样。

深度模型的"薛定谔精度":种子噪声比实现差异还大

确定性流水线能精确对齐是预期之内的,真正需要小心处理的是深度模型。
ShallowConvNet 和 EEGNet 训练过程包含随机初始化、随机打乱、dropout 采样,即使同一份代码跑两遍,结果也不会完全相同。所以拿"Nimbus 侧跑一次"和"参考侧跑一次"直接比,本身就是个不公平的比较——差异里既有实现差异,也有随机性带来的噪声。
论文的处理方式是先把噪声本身量化出来,具体做法是在每一侧单独用不同随机种子重跑,看它自己跟自己的差距有多大。
ShallowConvNet 的结果是这样:Nimbus 对参考实现的平均绝对差是 3.59 个百分点,最大差 12.85 个百分点。而 Nimbus 自己换种子重跑,平均会动 4.36 个百分点;参考实现自己换种子重跑,平均会动 4.13 个百分点。注意看这个对比——跨实现的差异比同一实现内部的种子噪声还小。而且把两边的多次运行均值摆在一起看,它们是相互交错的:Nimbus 是 49.3 和 47.9,参考是 51.8 和 48.5,没有哪一边系统性地高出一截。
EEGNet 一开始给了个反面教材。论文最初只跑了两个种子,那时候 Nimbus 看起来比参考实现稳定得多,表观波动只有 2.16 个百分点,同时呈现出一个似乎系统性的差距。这个发现如果停下来不往下查,很可能会得出"平台实现有系统偏差"的结论。但研究者补跑了第三个种子,两个现象一起消失了。
三个种子下的完整数据是:跨实现平均绝对差 4.94 个百分点,最大差 14.24 个百分点;Nimbus 侧自己换种子的平均波动是 4.35 个百分点,最大 21.88 个百分点;参考侧平均波动 4.48 个百分点,最大 12.85 个百分点。两边多次运行的均值再次交错:Nimbus 是 36.8、37.4、40.0,参考是 39.6、39.4。
mmexport1760710364748.jpg
论文在这里的自我批评很直接:对一个训练到接近随机水平的模型来说,只跑一次重训来估计波动性,这个估计本身就是有噪声的。两种子版本让 Nimbus 看起来比它实际更稳定,还暗示了一个不存在的系统性差距,第三个种子把这两点都推翻了。所以论文最终以三种子的结果为准。
这个细节在同类验证研究里值得单独拎出来说。EEGNet 在 BNCI-2014-001 上准确率只有 36% 到 40%,4 类任务的随机水平是 25%,所以模型确实学到了一点东西,但离可靠还很远。在这个区间里,单次运行的波动非常容易被误读成方法差异。

BYO代码节点:用户自定义方法也能精确复现

平台花力气验证自己内置节点算得对,逻辑上说得通。但一个可视化平台真正的价值,很大程度上在于能不能让用户把自己写的方法接进去——否则研究做到一半,发现需要的方法平台没有,整个工具链就断掉了。
Nimbus Studio 提供的扩展接口叫 python model node,论文里简称 BYO(Bring Your Own,自带代码)。用户提供符合 fit/predict 契约的 Python 类,平台在隔离的 worker 进程里执行它。
问题是:走这条扩展路径跑出来的结果,还能不能和手写脚本一致?
论文拿切线空间加逻辑回归这条流水线做了测试——特意不走内置节点,而是走 BYO 通道。会话留出协议下,它在所有被试上与手写参考实现精确一致,0.00 个百分点。分组交叉验证协议下,BNCI-2014-004 上完全一致,BNCI-2014-001 上汇总差 0.06 个百分点,最差的折差 0.53 个百分点。
这 0.06 的残差论文也做了归因,而且归因方式比较扎实:它落在流水线自身的数值噪声底线上。原因是平台在滤波环节使用 float32,而参考实现保持在 float64。论文做了一个控制实验——把滤波后数据按照这个精度差异引入的舍入误差(大约 10−12 V 量级)扰动一下,然后让参考实现自己重跑。结果参考实现自己的结果移动了 0.02 到 0.04 个百分点(汇总),单个折最多移动 0.35 个百分点。换句话说,0.06 这个差异量级完全落在噪声范围内,不是 BYO 通道带来的额外误差。
论文的结论是:用户自定义方法继承了平台的数据契约和指标契约,没有付出数值精度上的代价。

从验证研究到研究采纳:BCI软件信任的必经之路

把结果汇总一下:三个基准数据集、六条流水线、两种评估协议、加上一条扩展接口路径。所有确定性流水线最大差异 0.00 个百分点,深度训练落在种子波动范围之内。
论文对局限性的交代也算清楚,值得逐条说。
BIDS(Brain Imaging Data Structure,脑影像数据结构标准)导出的保真度、流式推理、云沙盒这几块平台功能,这次验证没有覆盖,仍然依赖平台自己的测试套件。这个边界划得合理——一次研究不可能验证所有表面,但边界必须说明白,否则读者容易把"已验证的部分"误推成"整个平台都被验证过了"。
论文里的准确率数值不能直接和 MOABB 排行榜对比。原因是划分方式不同,而且超参数是按平台的节点默认值匹配的,不是调优过的。论文只把已发表数值当作合理性区间使用。这一点很重要,因为 BCI 领域的准确率数字高度依赖评估协议,跨论文比较准确率本身就是个常见陷阱。
深度模型的等价性是在随机训练波动范围内成立的,不是逐比特精确。这个限定也必须带上。
最后一条自我批评挺诚实:参考实现虽然不依赖平台代码,但它是平台作者写的。作者自己写参考实现、再拿它验证自己的平台,独立性天然打了折扣。论文的应对方式是把 harness、数据、逐次运行结果文件、表格生成脚本全部随论文提供,让其他人可以重跑和扩展,并且明确说外部复现是自然的下一步。
可复现性方面,论文给的信息比较具体:所有确定性矩阵在笔记本 CPU 上几分钟跑完,包含两个深度架构的完整实验大约两小时。Nimbus 侧独立运行,不需要服务器、数据库或 GPU。
论文的落点是一句判断:平台算出来的 BCI 结果,可以当作脚本算出来的结果对待——这是把平台用在已发表研究里的前提条件。这句话说得比较克制,它主张的是数值等价性,不是方法优越性,也不主张平台适合所有场景。对这种类型的验证研究来说,这个尺度算是拿捏得住了。

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?脑机接口实验平台 Nimbus Studio 发布对齐验证:六条标准解码流水线在三个公开数据集、两种评估协议下,平台执行引擎与手写参考实现的准确率完全一致,确定性流水线最大差异 0.00 点,深度模型差异落在种子训练噪声内。
这篇工作最值得看的点是什么?所有确定性流水线(CSP+LDA、MDM、Tangent space+LR)在会话留出协议下与参考实现完全一致(0.00个百分点差异,54/54被试运行)。分组交叉验证下CSP+LDA和MDM完全一致(36折全部0.00),BYO切线空间流水线在BNCI-2014-004上完全一致,在BNCI-2014-001上池化差异0.06个百分点。P300流水线池化差异0.01个百分点。
这篇工作的边界或风险在哪里?优点在于验证设计严谨,采用独立参考实现进行外部验证,覆盖多种流水线、协议和范式,结果报告详尽且包含数值噪声底限分析,代码和数据可复现。缺点在于参考实现由平台作者编写而非完全独立第三方,深度模型仅在一个数据集上验证,未与MOABB排行榜直接对比,BIDS导出和流式推理等平台功能未验证。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

通过在Nimbus Studio可视化流水线平台与基于MNE-Python、scikit-learn、pyriemann和braindecode手写参考实现之间进行逐被试精度对比,在匹配超参数、数据和随机种子的条件下验证平台执行引擎的科学正。

实验合理度:★★★★☆

测试准确率(%)、Cohen's κ、置换显著性、每类报告

学术研究价值:★★★★☆

通过在Nimbus Studio可视化流水线平台与基于MNE-Python、scikit-learn、pyriemann和braindecode手写参考实现之间进行逐被试精度对比,在匹配超参数、数据和。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

确定性流水线矩阵在笔记本CPU上数分钟完成,包含两种深度架构的完整实验约两小时

复现难度:★★★☆☆

现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:参考实现由平台作者编写而非完全独立第三方,深度模型仅在一个数据集上验证,未与MOABB排行榜直接对比,BIDS导出和流式推理等平台功能未验证。

主要参考文献

[1] A. Gramfort et al. MNE software for processing MEG and EEG data. NeuroImage, 86:446–460, 2014.
[2] F. Pedregosa et al. Scikit-learn: Machine learning in Python. JMLR, 12:2825–2830, 2011.
[3] S. Barachant et al. MOABB: trustworthy algorithm benchmarking for BCIs. Journal of Neural Engineering, 16(6):066011, 2019.
[4] R. T. Schirrmeister et al. Deep learning with convolutional networks for EEG decoding and visualization. Human Brain Mapping, 38(11):5391–5420, 2017.
[5] V. J. Lawhern et al. EEGNet: a compact convolutional neural network for EEG-based brain–computer interfaces. Journal of Neural Engineering, 15(5):056013, 2018.
[6] B. Rivet, A. Souloumiac, V. Attina, G. Gibert. xDAWN algorithm to enhance evoked potentials: application to brain–computer interface. IEEE Transactions on Biomedical Engineering, 56(8):2035–2043, 2009.
[7] M. Congedo, A. Barachant, R. Bhatia. Riemannian geometry for EEG-based brain-computer interfaces; a primer and a review. Brain-Computer Interfaces, 4(3):155–174, 2017.
[8] E. R. Krigolson et al. Choosing tools: validation of a low-cost EEG system for research. Frontiers in Neuroscience, 15:625941, 2021.
原论文链接:https://arxiv.org/pdf/2610.13894v1.pdf
平台地址:https://studio.nimbusbci.com/
end
搭平台容易,证明平台算的数和手写脚本一模一样,很难 😏
CSP、MDM、xDAWN、EEGNet 挨个对齐,0.00 点差异这件事,值不值得信,进来聊。
欢迎加入龙哥读论文粉丝群,扫描下方二维码或者添加龙哥助手微信号加群:kangjinlonghelper。一定要备注:研究方向+地点+学校/公司+昵称(如 脑机接口+上海+清华+龙哥),根据格式备注,可更快被通过且邀请进群。
『龙哥读论文』微信群目前包含:图像处理、大模型及智能体、自动驾驶及机器人、AI医疗及AI金融5个群
wechat_helper dianzan

*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。