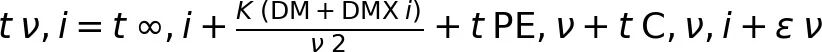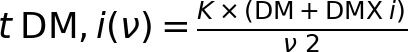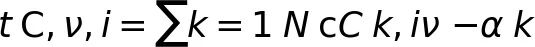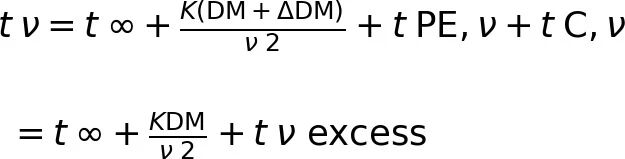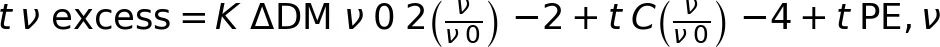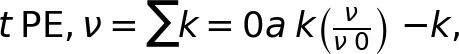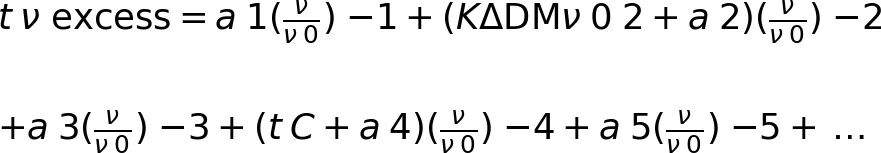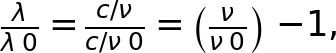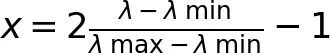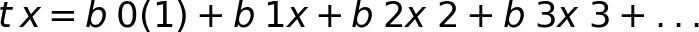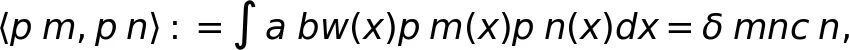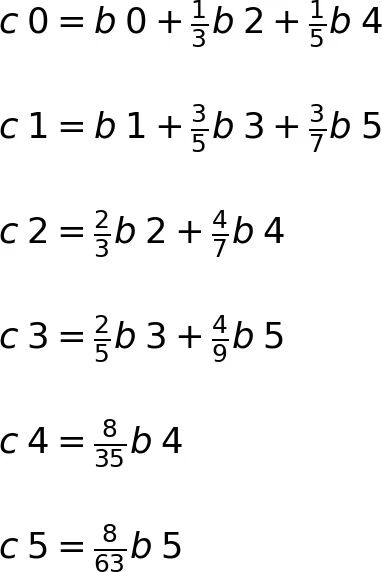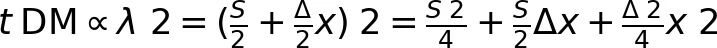
← 返回 PaperDaily 大模型与智能体

NANOGrav新模型:脉冲星轮廓演化误差最高降85%

纳赫兹引力波是热门话题,而脉冲星定时里的「色效应」建模是个难题。这篇来自NANOGrav合作组的工作看似简单却很关键:用勒让德正交基替代对数多项式,在11颗毫秒脉冲星和模拟数据上,PE误差最多降低85%,拟合色散偏差从0.013压到0.0002 pc/cm³。专治前人模型的数值病,值得一读。

NANOGrav新模型:脉冲星轮廓演化误差最高降85%

paperdaily_reaction_gif


原论文信息如下:
论文标题:
The NANOGrav 15 yr Dataset: Modified Functional Forms for Profile-Evolution Time Delays in Pulsar Timing Models
发表日期:
2026年10月
发表单位:
NANOGrav合作组(北美纳赫兹引力波天文台),第一作者单位:荷兰射电天文研究所 ASTRON
原文链接:
https://arxiv.org/pdf/2610.10431v1.pdf
开源代码链接:
https://github.com/sophiasosafiscella/LIFD_PINT
开源数据集链接:
https://zenodo.org/records/16051178

脉冲星定时中的轮廓演化难题:FD模型为何频频"翻车"

脉冲星是快速自转的中子星,会像宇宙灯塔一样,以极高的规律性向外发射射电脉冲。其中毫秒脉冲星(Millisecond Pulsar,简称MSP)自转周期只有几毫秒,稳定性好到可以把脉冲到达时间(Time of Arrival,简称TOA)测到亚微秒量级。正是靠着这种稳定性,天文学家把几十颗毫秒脉冲星组成了脉冲星定时阵列(Pulsar Timing Array,简称PTA),当成散布在银河系里的"引力波天线"。
当纳赫兹频段的引力波扫过地球时,它会让不同方向脉冲星的到达时间出现极其微弱的整体性偏移。2023年前后,NANOGrav(North American Nanohertz Observatory for Gravitational Waves,北美纳赫兹引力波天文台)等几个合作组陆续报告了与纳赫兹引力波背景一致的信号,让这一领域成为天体物理当下的热点。而想要抓住纳秒级的偏移,前提是把所有会扰动TOA的效应都算清楚。
这些扰动里有一大类是"色效应":不同频率的信号,到达时间被延迟的程度不一样。最常见的是色散——射电脉冲穿过星际介质(Interstellar Medium,简称ISM)里的电离气体时,低频信号被拖得更慢。另一类来自脉冲星自身:同一位"灯塔"发出的脉冲,形状会随观测频率变化,低频时轮廓更宽、更散,高频时更窄更尖。这个现象叫轮廓演化(Profile Evolution,简称PE),一般认为源自脉冲星磁层中不同频率的辐射在不同高度产生,也就是常说的半径-频率映射(radius-to-frequency mapping,简称RFM)。
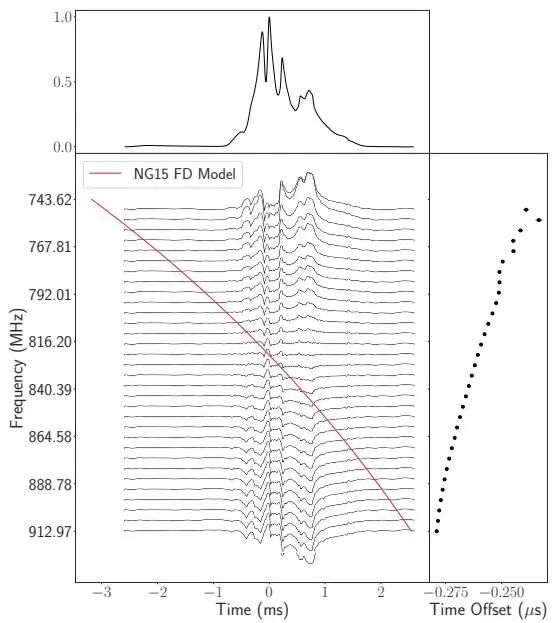
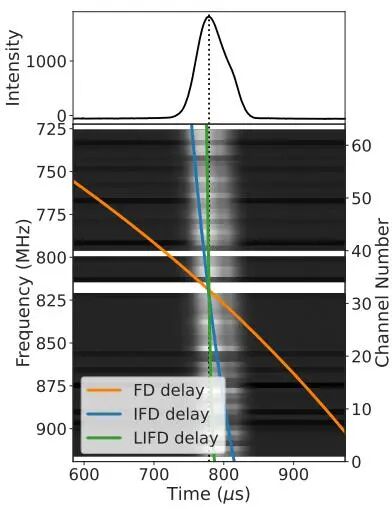
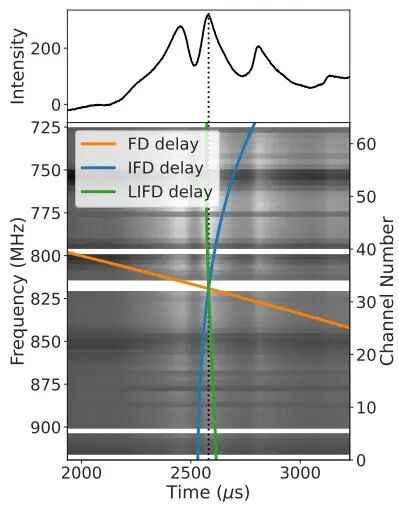
(a) J1024−0719 with the 820 MHz receiver.
图1(a):PSR J1024−0719 在820 MHz接收机上的脉冲轮廓随频率的演化。
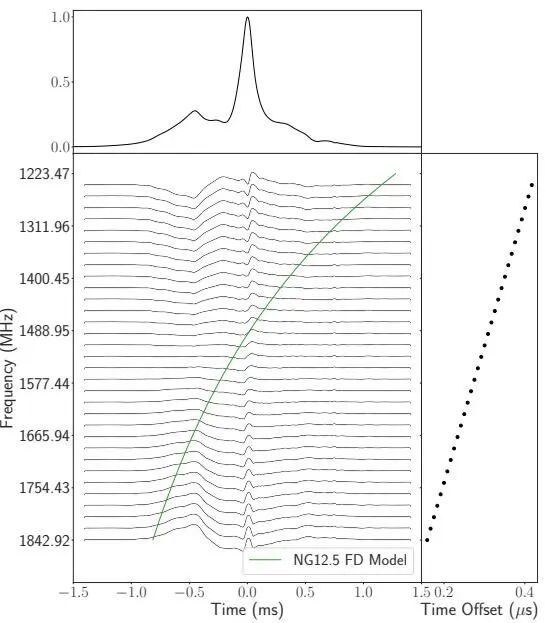
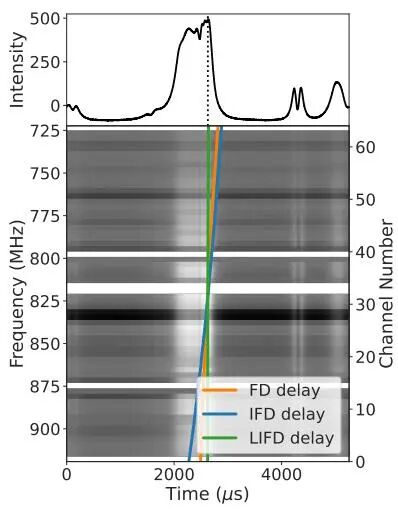
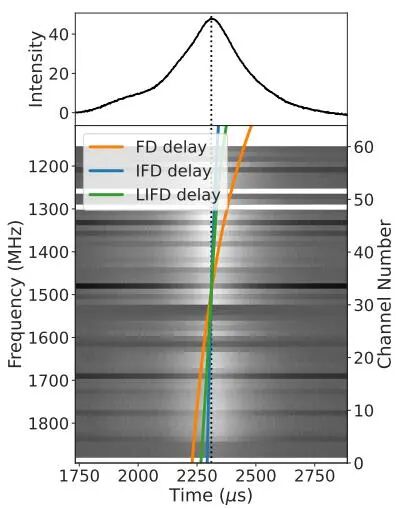
(b) J1918−0642 with the L-band receiver. Figure 1.
图1(b):PSR J1918−0642 在L波段接收机上的脉冲轮廓演化。是不同频率下经过色散改正、并扣掉频段中部轮廓之后的脉冲形状,红线与绿线分别是NANOGrav 15年与12.5年数据集中FD模型预测的PE延迟;右下角是不同频率轮廓与脉冲模板互相关后得到的TOA;上方是频率平均后的脉冲轮廓。
从9年数据集开始,NANOGrav处理PE的方式是用一个频率相关的对数多项式(Frequency-Dependent,简称FD)去拟合PE带来的时间延迟,系数记作FDk,通常取2到5项。这些系数不预先给定,而是在TOA生成之后,作为自由参数再丢进定时模型里做最小二乘拟合。
本文做的事情,就是把这套用了十几年的FD模型拉出来"体检"。结果发现它的体检报告相当难看:FD拟合出来的延迟曲线,和实际观测到的轮廓演化幅度对不上,而且在9年、11年、12.5年、15年这四套数据集之间,同一颗脉冲星的FD曲线竟然会大幅变化,甚至凹凸翻转。
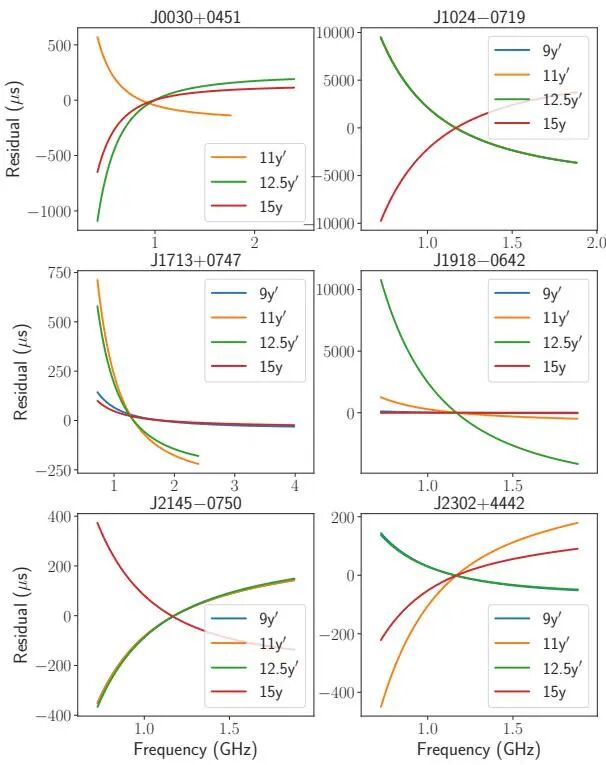
Figure 2. PE timing delays as a function of frequency according to the FD models
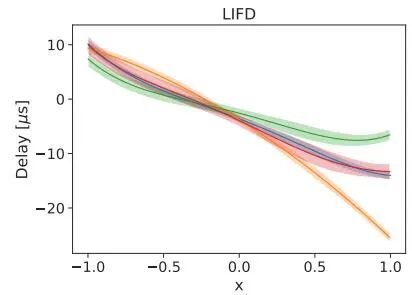
按照NANOGrav 9年、11年、12.5年和15年四套数据集报告的FD模型,PE时间延迟随频率的变化曲线。由于各数据集采用的名义色散量(Dispersion Measure,简称DM)不同,9年、11年和12.5年的曲线被平移了相应修正项。可以看到,某些毫秒脉冲星的延迟曲线幅度超过了它自身的自转周期,并且在不同数据集之间凹凸翻转——这与PE应有的行为并不一致。
举个具体的例子:12.5年数据集中,PSR J1918−0642 的FD模型预测延迟超过12.5毫秒,而这颗脉冲星的自转周期才7.65毫秒——也就是说,模型给出的"轮廓演化延迟"比它完整转一圈还长。这种量级显然不可能是真实的PE。
原因不复杂:FD系数是靠全局最小二乘拟合出来的,而色散、散射、折射这些同样带有频率依赖的效应,同样在TOA里留下痕迹。它们的函数形式和PE的并不正交,拟合时会互相"串门",功率彼此渗透。结果是FD系数被污染,既高估了PE的幅度,又在不同数据集之间飘忽不定,物理可解释性大打折扣。
🤨 说白了,这是一个"账本记混"的问题:明明有好几笔支出,却被记在同一栏里,等到年底对账,谁多花了谁少花了,全成了糊涂账。

从对数多项式到正交基:IFD与LIFD模型的数学原理
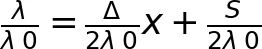
要理解新方法,得先看清旧的色效应账本长什么样。脉冲星在频率ν、观测历元i上收到的总色延迟,可以写成下面这个模型。
公式:总色延迟模型
公式:tν,i = t∞,i + K(DM+DMXi)/ν² + tPE,ν + tC,ν,i + εν。从左到右依次是:无穷频率下的到达时间、色散延迟、轮廓演化延迟、其他非PE非DM的色效应、测量误差。
其中色散那一项,可以单独写成下面这个形式。
公式:色散延迟
公式:tDM,i(ν) = K×(DM + DMXi)/ν²。其中K为色散常数(约等于4.149 ms·GHz²·pc⁻¹·cm³),DM是色散量,物理含义是视线方向上自由电子密度的积分,DMXi是第i个观测历元上的色散量偏移,ν是观测频率。可以看到,色散延迟天然按 ν-2 衰减。
而散射、折射这些额外色效应,论文用一个幂律和来统一表示。
公式:其他色效应
公式:tC,ν,i = Σk=1..Nc Ck,i·ν-αk。αk是谱指数,Ck,i是对应的功率谱幅度,Nc是这类效应的数量。
接下来是全文最关键的一步推导。假设定时模型里用的DM值和真实值差了一个ΔDM,那么扣掉名义色散项之后,剩下的"过剩延迟"可以写成下面这样。
公式:过剩延迟
公式:tν = t∞ + K(DM+ΔDM)/ν² + tPE,ν + tC,ν,并可整理为 tν = t∞ + K·DM/ν² + tνexcess。这里的"过剩延迟",就是色散模型没能吃掉的所有频率相关成分之和。
如果把折射和散射统一近似为 ν-4 的标度,那么过剩延迟可以拆分如下。取参考频率ν₀ = 1 GHz,主要是为了数值稳定性,也贴近实际观测频段。
公式:过剩延迟拆分
公式:tνexcess = K·ΔDM·ν₀²·(ν/ν₀)-2 + tC·(ν/ν₀)-4 + tPE,ν。也就是说,色散残差藏在 ν-2 里,散射/折射藏在 ν-4 里,而PE则另有自己的形状。
论文提出的第一种新表述叫IFD,中文可以理解为"单项式展开":把PE的延迟写成反频率的幂级数。
公式:PE单项式展开
公式:tPE,ν = Σk=0.. ak·(ν/ν₀)-k。系数ak带时间量纲,幂指数取整数。
把上式代回过剩延迟,就得到下面这个展开式,它把"混账"的问题暴露得一清二楚。
公式:过剩延迟的单项式展开
公式:tνexcess = a₁(ν/ν₀)-1 + (K·ΔDM·ν₀² + a₂)(ν/ν₀)-2 + a₃(ν/ν₀)-3 + (tC + a₄)(ν/ν₀)-4 + a₅(ν/ν₀)-5 + …。可以看到,ΔDM只出现在 ν-2 项里,和PE的a₂绑在了一起;散射/折射只出现在 ν-4 项里,和PE的a₄绑在了一起。
论文据此定义了两个"被污染的系数":a₂′ ≡ K·DM·ν₀² + a₂ 是被PE污染后的DM估计;a₄′ ≡ tC + a₄ 是被PE污染后的散射/折射估计。这就是FD模型系统性偏差的根源——只要基函数不正交,账目就会串。
第二种表述换了坐标系。论文放弃频率ν,改用波长λ,因为有 λ/λ₀ = (ν/ν₀)-1,参考频率ν₀ = 1 GHz对应波长λ₀ = 1 ns。
公式:频率与波长的换算
公式:λ/λ₀ = (c/ν)/(c/ν₀) = (ν/ν₀)-1。换到波长空间之后,PE的延迟就变成波长的普通多项式而不是反频率的幂级数,这为引入正交多项式铺好了路。
接下来把波长归一化到 [-1, 1] 区间,方便直接使用标准的勒让德多项式。
公式:归一化波长变量
公式:x = 2(λ - λmin)/(λmax - λmin) - 1。λmin与λmax分别对应观测频段的最高频和最低频。再用 S = λmin + λmax、Δ = λmax - λmin 两个记号表示中心与宽度,就有下面的线性关系。
公式:波长与归一化变量关系
公式:λ/λ₀ = [Δ/(2λ₀)]·x + S/(2λ₀)。这意味着波长空间里的任何多项式,都是归一化变量x的普通多项式。
于是PE延迟在x空间里可以写成最朴素的幂级数形式。
公式:PE的x幂级数
公式:tx = b₀ + b₁x + b₂x² + b₃x³ + …。到这里还是"单项式基",和IFD是一回事,只是变量从ν换成了x。真正关键的一步,是把它换成勒让德多项式基。

勒让德多项式的威力:如何让PE与色散效应"各归其位"
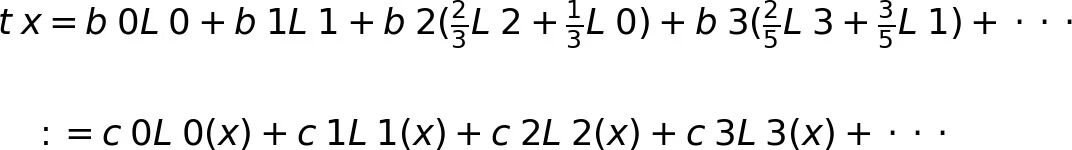
先说清楚勒让德多项式(Legendre polynomial)凭什么好用。它满足一条正交性条件:在区间 [-1, 1] 上、权重函数恒为1时,任意两个不同阶的勒让德多项式乘起来再积分,结果都是零。
公式:勒让德多项式正交性
公式:〈pm, pn〉 := ∫ab w(x)pm(x)pn(x)dx = δmncn。当 m ≠ n 时右端为零,只有同阶才留下一个常数。正交意味着:不同阶的基函数各自守着自己的"地盘",一阶项的信息不会被三阶项偷偷吃掉。
把上面的 x 幂级数重写成勒让德基,形式如下。
公式:勒让德基展开
公式:tx 可以按 b0L0 + b1L1 + b2(2L2/3 + L0/3) + b3(2L3/5 + 3L1/5) + … 展开,并整理为 c0L0(x) + c1L1(x) + c2L2(x) + c3L3(x) + …。两种基之间的系数存在一一对应。
两套系数之间的转换关系如下,每一项的推导都是一次多项式展开与同类项合并。
公式:系数转换关系
公式:c0 = b0 + b2/3 + b4/5;c1 = b1 + 3b3/5 + 3b5/7;c2 = 2b2/3 + 4b4/7;c3 = 2b3/5 + 4b5/9;c4 = 8b4/35;c5 = 8b5/63。可以看出,奇偶阶之间泾渭分明,这正是正交基的"分工"特性。
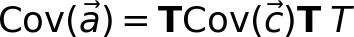
由于基变换是线性的,参数的协方差矩阵也可以按同样的线性变换传递过去,不会引入额外假设。
公式:协方差变换
公式:Cov(a⃗) = T·Cov(c⃗)·TT。T为基变换矩阵,a⃗是单项式系数矢量,c⃗是勒让德系数矢量。这一步保证了两种模型在统计上可以公平比较。
那么关键问题来了:色散延迟在勒让德基里长什么样?由于色散正比于波长的平方,把 λ 用 x 代进去,得到下面这个展开。
公式:色散在波长空间展开
公式:tDM ∝ λ² = (S/2 + Δx/2)² = S²/4 + (SΔ/2)x + (Δ²/4)x²。也就是说,色散在x的多项式里只占常数项、一次项和二次项三块地。再把它投影到勒让德基上,只会落在 L0、L1、L2 三个模式上。
这就是全篇最精巧的一点:色散有它确定的地盘,而PE的高阶延迟会被正交基"推到"更高的阶数上,两者不再抢同一块区域。相比之下,FD用的是对数频率的幂级数,和 ν-2 的色散天然不正交,功率必然互相渗漏。
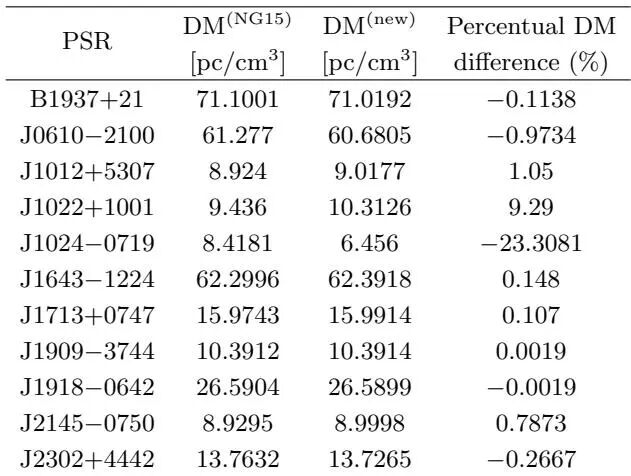
论文在NANOGrav 15年数据集中挑选了11颗脉冲星来做实测,这11颗星的色散量情况如下表。
Table 1. NG15 pulsars used to test PE models.
表1:用于测试PE模型的NG15脉冲星。DM(NG15)是已发表的色散量,DM(new)是论文采用第3.2节算法重新得到的结果,最后一列给出两者的相对差异百分比,即 (DM(new) - DM(NG15))/DM(NG15)×100。可以看出,不同脉冲星上重新拟合的DM与旧值存在可察觉的系统性差异,提示旧流程里的PE与色散确实存在耦合。
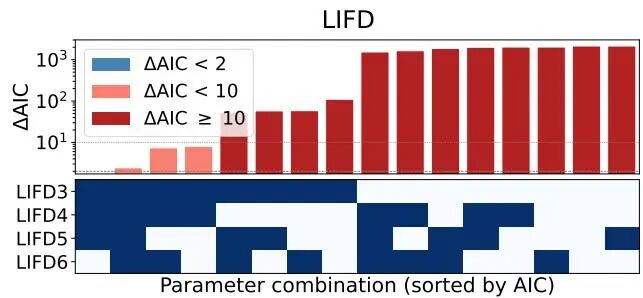
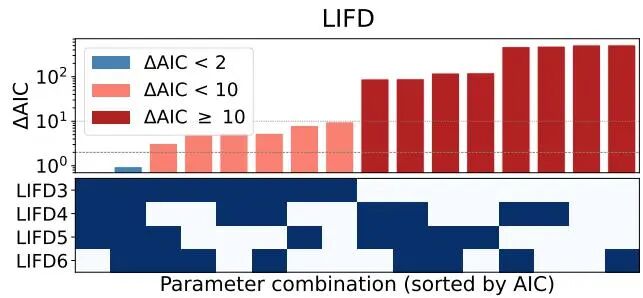
选多少阶项合适?论文用赤池信息量准则(Akaike Information Criterion,简称AIC)来比较不同参数组合下的IFD与LIFD模型。
(a) PSR J1643−1224
图3(a):PSR J1643−1224 的AIC模型选择结果。
(b) PSR J2145−0750 Figure 3.
图3(b):PSR J2145−0750 的AIC模型选择结果。上半部分柱状图给出每种IFD/LIFD参数组合的 ΔAIC = AIC - AICmin,按优劣从左到右排序,两条虚线分别是 ΔAIC < 2(支持度相当)和 ΔAIC > 10(强烈不推荐)的传统阈值;下半部分是与之对齐的二值热图,行是自由参数,列是模型组合,填色表示该参数被保留,空白表示被剔除。
从模型选择的结果看,LIFD往往能用更少的参数达到更好的拟合优度,这正说明它的基函数"表达能力"更高效——同样的物理信息,用更少的项就装得下。

模拟数据验证:LIFD模型如何将PE误差降低85%

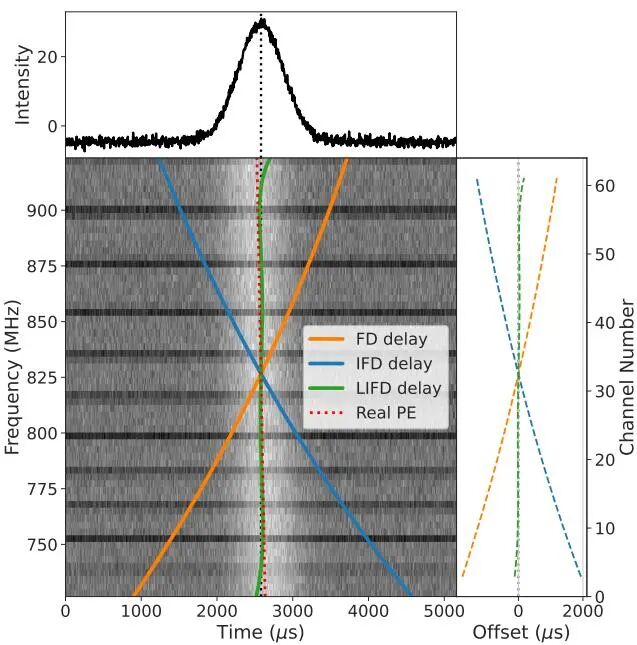
实测数据只能看到结果,看不到答案。要判断谁更准,必须有"标准答案"——这正是模拟数据的价值所在。论文的做法是:把已知形状的PE延迟和DM延迟注入到模拟TOA里,然后用FD、IFD、LIFD三套模型去拟合,看看谁能还原出注入的真值。
Figure 8. Bottom left: intensity of the (de-dispersed) pulse profile ...
图8:模拟数据上的PE拟合对比。左下是注入PE和DM延迟后、信噪比最高的那次模拟观测中,去色散后的脉冲轮廓强度在频率和自转相位上的分布;彩色曲线是FD、IFD、LIFD各自拟合出的PE延迟,红色虚线是真实注入的PE延迟;上方是时间与频率平均后的轮廓;右侧给出各模型拟合曲线与注入曲线之间的偏差随频率的变化。三套模型里,LIFD的曲线最贴近注入值。
量化下来,勒让德基模型的预测延迟更接近真实的轮廓演化,相对FD而言,残差偏移最多被压低了85%。这个"85%"是全文最抓眼球的数字,也是评审和读者最容易记住的一条硬指标。
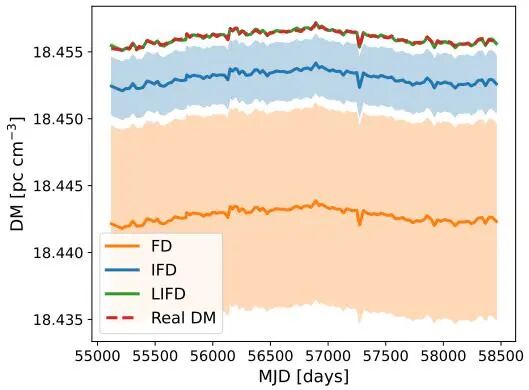
(a) Profile evolution and dispersion
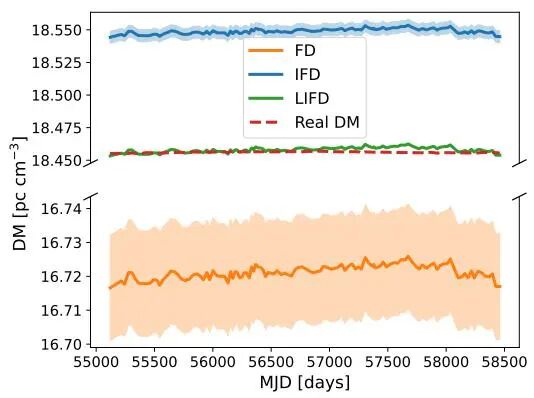
图10(a):在同时注入PE与DM延迟的模拟TOA上,三种PE模型各自恢复出的DM时间序列。
(b) Dispersion and no profile evolution. Figure 10.
图10(b):只注入DM延迟、不含轮廓演化时的对照结果。橙色、蓝色、绿色分别是FD、IFD、LIFD模型拟合出的DM时间序列,红色是真实注入的DM序列。三套模型给出的时间趋势都差不多,但只有LIFD恢复出的DM序列与注入值在量级上真正一致。
最能说明问题的是另一个数字:在模拟数据上,FD类模型把注入的DM值高估了0.013 pc cm⁻³,而LIFD只高出0.0002 pc cm⁻³。两者相差接近两个数量级。色散量本身是脉冲星测距、星际介质研究和引力波搜索的基础参数,这种量级上的偏差足以影响下游物理结论。
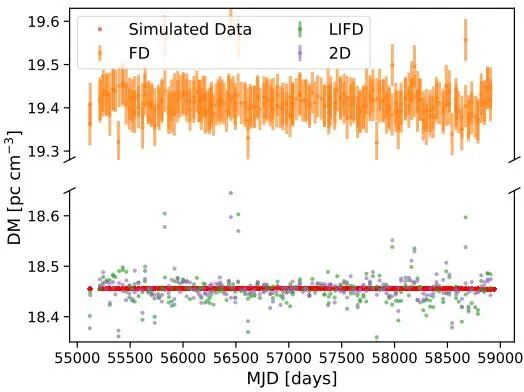
论文还把LIFD与频率分辨的脉冲模板(即二维模板"pulse portrait",脉冲肖像)做了对比。下面的图11展示了用离散二维模板(不做PE修正)与用一维模板配合FD或LIFD定时模型时的DM恢复精度。
(b) Simulated observations Figure 11.
图11:用PSR B1937+21实测数据(左)和模拟观测(右)恢复出的DM时间序列。三种做法分别是:用离散二维模板生成TOA、定时模型完全不修正PE(蓝点);用一维模板生成TOA、定时模型用FD修正PE(绿点);用一维模板生成TOA、定时模型用LIFD修正PE(橙点)。模拟数据里还画出了真实注入的DM序列(红点)。LIFD与二维模板给出的DM时间序列误差棒最小,且与注入值一致。
📌 这里值得多说一句:LIFD的优势并不是"拟合得更花哨",而是能把PE从DM里真正剥出来。二维模板之所以表现好,是因为它从根本上绕开了"谁来解释频率依赖"这个问题;而LIFD是在一维模板的框架内,靠正交基实现了接近的效果。对已有的NANOGrav流程而言,后者的改动成本要小得多。

跨数据集稳定性对比:FD、IFD、LIFD谁更靠谱

模拟数据解决了"准不准",实测数据还要回答"稳不稳"。论文把同一颗脉冲星在NG9、NG11、NG12、NG15四套数据集上分别拟合,再看不同数据集给出的PE延迟曲线是否自洽。由于这四套数据集并非彼此独立(早期数据集本身就是后期数据集的子集),真正来自脉冲星本身的轮廓变化在四套数据里应当是连续且相关的,不该出现大幅跳跃或翻转。
Figure 7. Comparison of FD, IFD, and LIFD delay curves across NANOGrav datasets.
图7:FD、IFD、LIFD三套模型在NANOGrav不同数据集之间的延迟曲线对比。每个子图中的曲线分别是使用NG15(蓝)、NG12(橙)、NG11(绿)、NG9(红)数据集TOA拟合出的PE延迟。阴影区域是通过对系数做1000次正态采样、再结合完整参数协方差矩阵得到的1σ置信区间。可以看到,FD的延迟曲线在不同数据集之间会凹凸翻转,IFD在长波长端误差偏大,两者都会给出不符合物理直觉的PE延迟;LIFD则基本抑制了这些毛病。
(a) B1937+21
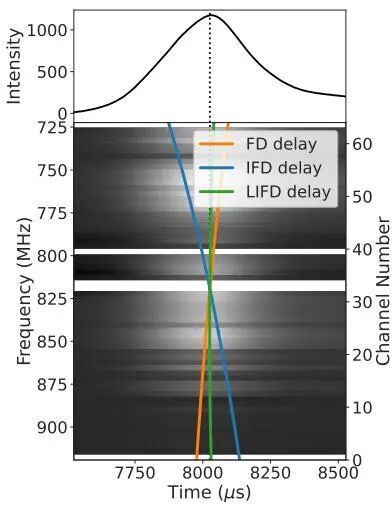
图4(a):PSR B1937+21 的轮廓强度随频率与自转相位的分布,以及FD(橙)、IFD(绿)、LIFD(蓝)三套模型拟合出的PE延迟曲线。
(b) J1012+5307
图4(b):PSR J1012+5307 的同类对比。
(c) J1022+1001
图4(c):PSR J1022+1001 的同类对比。
(d) J1024−0719
图4(d):PSR J1024−0719 的同类对比。
(e) J1643−1224
图4(e):PSR J1643−1224 的同类对比。
(f) J2145−0750 Figure 4.
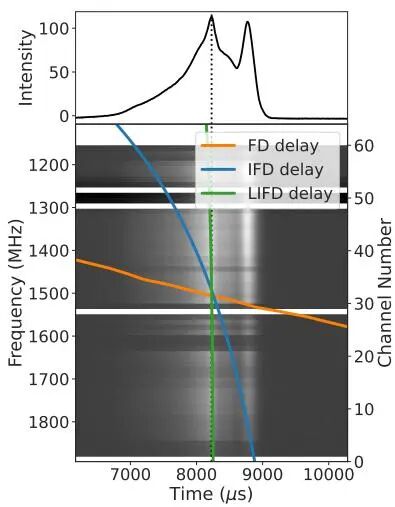
图4(f):PSR J2145−0750 的同类对比。图4整体给出的结论是:FD模型容易给出跨越频率范围过大的延迟曲线,明显高估了轮廓在频率上的"扫过"程度;而LIFD的延迟曲线在所有毫秒脉冲星上都更贴合真实轮廓的移动轨迹。每张子图的上方还给出了对应的频率积分轮廓。
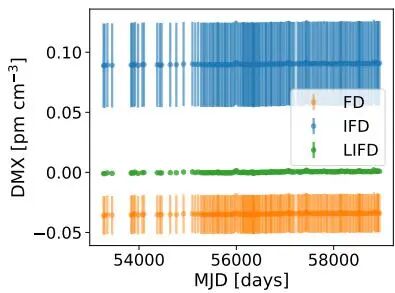
如果PE被高估,那么被"抢走"功率的另一方就是DM。论文对比了用三种PE模型拟合时,DMX修正项随时间的变化。
(f) J2145−0750 Figure 5.
图5:色散模型对不同PE模型的响应。每颗脉冲星给出DMX修正随时间窗中心的变化,DMX参数分别来自用FD(橙)、IFD(蓝)、LIFD(绿)模型处理PE后的定时拟合。三者的DM时间趋势一致,但FD和IFD会恢复出幅度更大、不确定度也更大的DMX修正,LIFD则明显更收敛。
(f) J2145−0750 Figure 6.
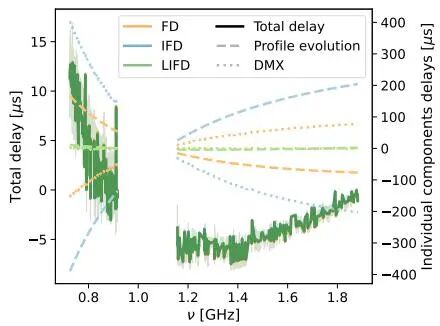
图6:延迟的分解情况。三种颜色对应FD(橙)、IFD(蓝)、LIFD(绿)模型,虚线是各TOA频率上的PE延迟历元平均,点线是各历元与频率上的DM延迟历元平均,实线是两者的总色延迟,阴影为总延迟的标准差。注意看:三种模型算出的总色延迟是一致的,差别在于把总延迟拆成PE和DM这两半时,FD/IFD给单个效应分配的幅度明显

龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?脉冲星轮廓演化长期靠对数多项式(FD)建模,容易把色散等效应吸进来,延迟曲线忽大忽小。本文提出单幂次(IFD)与勒让德(LIFD)两种新表达,在NANOGrav 15年数据与模拟数据上验证:LIFD最贴合真实轮廓演化,模拟误差最多
这篇工作最值得看的点是什么?LIFD模型在大多数脉冲星上预测的PE延迟曲线更接近观测到的脉冲轮廓,相比FD模型在模拟数据上将PE误差降低了85%;LIFD模型恢复的DM时间序列与注入值一致(平均误差0.0002 pc/cm³),而FD模型存在0.013 pc/cm³的系统偏移;LIFD模型在不同数据集间表现出更好的稳定性和更小的参数不确定性。
这篇工作的边界或风险在哪里?优点:LIFD模型使用正交基函数,有效减少了PE参数之间的协方差,能更准确地分离PE与色散效应;在不同数据集间表现出更好的稳定性;在模拟数据上能更准确地恢复注入的DM和PE延迟。缺点:LIFD模型仍不能完全消除PE与色散效应之间的简并性;在低演化脉冲星上改进效果有限;假设了弱散射机制和特定散射谱指数,在强散射情形下可能失效;勒让德多项式仅在平坦权重下严格正交,实际定时拟合中权重并非完全平坦。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

本文提出了两种新的脉冲轮廓演化(PE)数学建模方法——单项式展开(IFD)和勒让德多项式展开(LIFD),通过使用正交基函数来最小化PE与其他色散效应(如星际色散)在定时拟合中的协方差,从而更准确地分离和约束各色散效应的贡献。

实验合理度:★★★★☆

定时残差、AIC(赤池信息准则)、DMX误差、PE延迟曲线与观测轮廓的吻合度、DM时间序列恢复精度

学术研究价值:★★★★☆

本文提出了两种新的脉冲轮廓演化(PE)数学建模方法——单项式展开(IFD)和勒让德多项式展开(LIFD),通过使用正交基函数来最小化PE与其他色散效应(如星际色散)在定时拟合中的协方差,从而更准确地分。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

现有材料缺少完整训练资源、参数量、显存和推理时延信息,成本暂按中性评价。

复现难度:★★★☆☆

现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:LIFD模型仍不能完全消除PE与色散效应之间的简并性;在低演化脉冲星上改进效果有限;假设了弱散射机制和特定散射谱指数,在强散射情形下可能失效;


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球