论文标题:
Cheap and Powerful Tests for Supervised Subspaces: Per-Component Inference for PLS
发表日期:
2026年09月
发表单位:
Society for Open Science (Stowarzyszenie na Rzecz Otwartej Nauki), Centre for Brain Research, Jagiellonian University; IDEAS Research Institute
原文链接: https://arxiv.org/pdf/2609.36307v1.pdf
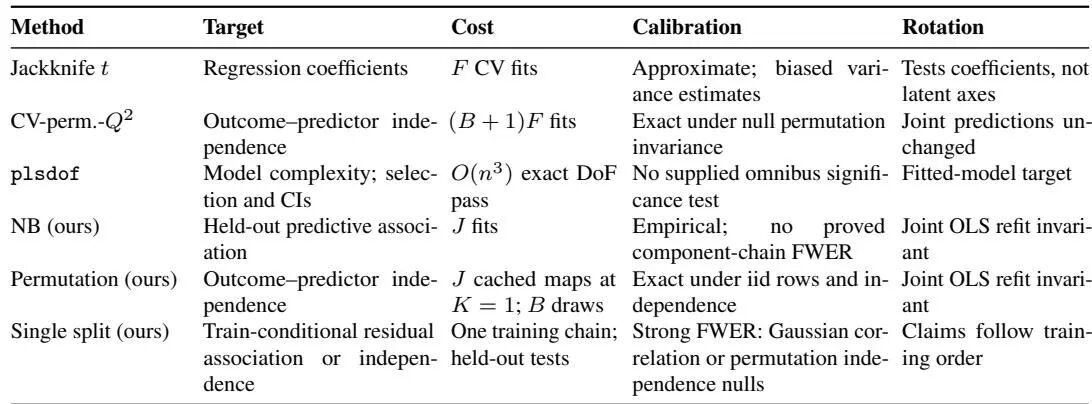
PLS回归推断的困境:为什么你的p值不可信偏最小二乘回归(PLS)是一种处理高维数据的经典方法,广泛应用于化学计量学、神经科学和自然语言处理等领域。它通过从高维自变量矩阵中提取少数方向来预测结果,避免了普通最小二乘法的奇异问题。尽管方法应用广泛,推断却一直存在问题。现有工具无法同时做到校准和便宜,常常只能满足部分条件。刀切 t 检验有偏,交叉验证置换 Q² 校准但昂贵,scikit-learn 的 PLSRegression没有检验功能,偏最小二乘结构方程模型(PLS-SEM)退到 bootstrap 置信区间。plsdof工具提供模型选择用的自由度数和置信区间,但未验证其显著性检验水平。表1:论文梳理的六种推断流程横向对比。成本一栏里 F 是交叉验证折数,J 是重复划分次数,B 是置换次数。最后一列讲的是「对固定拟合子空间做重基底」时各方法的表现,注意没有任何一种方法能给单个 varimax 轴提供显著性。自然语言处理和脑成像等场景需要对每个命名轴单独检验,但 PLS 成分只在正交旋转下可识别,换基底后轴的名字会改变。因此「这个轴显著」需明确在重基底操作下的表现。这篇论文不是简单应用 PLS,而是填补统计学工具的缺口,解决了存在二十年的问题。
把推断变成一次留出重拟合:NB检验的核心机制
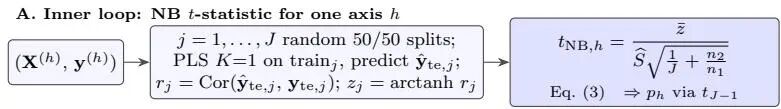
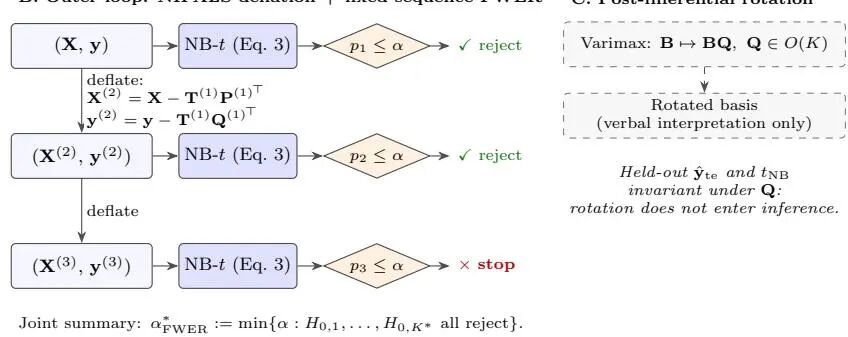
PLS1的首个方向是让Xw与y的样本协方差最大。这个优化不需迭代数值求解,正比于Xᵀy。公式1:w 是让 Xw 与 y 的样本协方差最大的单位向量。等号右侧说明它并无显式解,而是正比于 Xᵀy,也就是说首方向就是「与 y 协方差最大」的方向。当 K 大于 1 时,PLS 用 NIPALS 反复做去膨胀,得到有序序列 w₁ 到 w_K。这 K 个方向张成的空间是 XᵀX 与 Xᵀy 生成的 Krylov 子空间。公式2:w₁ 到 w_K 张成的空间等于 XᵀX 与 Xᵀy 生成的 K 阶 Krylov 子空间 𝒦_K。注意这是一个「张成」陈述,因此任何可逆的重基底变换都不会破坏它。作者的核心洞察是推断不必对着 PLS 的成分做,只需对着留出预测做。流程包括随机抽 J 个划分、在训练半上拟合 PLS、记录相关系数、做 Fisher 变换、聚合成 t 统计量。公式3:NB 校正重采样 t 统计量。分母里的校正项近似重叠训练折所制造依赖的校正项;在零假设下,这个统计量参考自由度 J−1 的 t 分布。这个 t 参考是渐近的,论文给了一条规则:样本量 n ≥ 25,列标准化后 X 的稳定秩至少为 3 时,用渐近版;否则用精确检验。稳定秩很关键,因为插值只在「J 个划分估计恰好是那个相关性下的 J 个独立重复」时才精确。在本质单方向的 X 上,K = 1 的 PLS1 只会返回 ±v,符号由训练半决定,相关性掉到 ρ₀ 以下,t_NB 的零分布比 t_{J−1} 更窄、尾部更重,结果偏保守或膨胀。被标记的设计用精确的 NB 置换检验。划分与数据独立抽取后固定住;每个划分在训练半拟合 K = 1 的 PLS,重拟合 OLS,对留出相关做 Fisher 变换,跨划分取平均得 z̄;然后做 B 次独立均匀置换,最后算出 p̄。在「y 与 x 独立」且样本行独立同分布的前提下,给定 X 和固定划分之后,y 的分布在这些置换下是不变的。得到的检验不需要高斯假设,也不需要大样本近似。成本设计很漂亮。划分固定且 K = 1 时,每个划分上的留出得分是训练结果的一个固定线性映射,一次置换只改变输入向量,B 次抽样塌缩成每个划分两次矩阵乘法,完全不用重新拟合。有效性规则把人送去用精确检验的设计,恰好是精确几乎免费的设计。精确性只覆盖联合那一步。逐成分的claim应该改用附录里的单划分变体。图A:留出重拟合与 NB 统计量的流程示意。核心思想是「先划分、再拟合、只看留出预测」,推断的全部信息都来自那些留出预测值。图1:论文的推断流水线。(A) 逐轴 NB t 统计量:J 个随机 50/50 划分喂入 Fisher-z 聚合,配以校正后的重采样方差。(B) 在 NIPALS 去膨胀后的成对数据 (X⁽ʰ⁾, y⁽ʰ⁾) 上做固定序列 FWER 控制,h = 1 到 K*,遇到第一次不拒绝即停;联合摘要 α*_FWER 是所有前置零假设都拒绝的最小水平。(C) varimax 只在推断完成之后作用于载荷,留出预测与 t_NB 对任意正交矩阵 Q 都不变。
旋转不变性:varimax轴能继承什么、不能继承什么
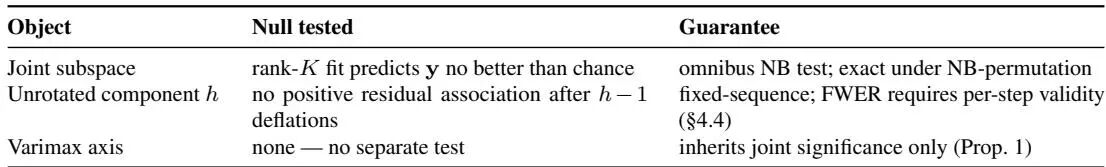
前面说了 PLS 成分只在正交旋转下可识别,那旋转到底动不动推断?论文用命题 1 给出结论:把正交矩阵 Q 在所有划分上固定住,对任意划分 j,在旋转后的得分上做 OLS 重拟合,系数满足下面的关系。公式4:旋转后 OLS 重拟合系数的关系。结论是旋转后的系数等于 Qᵀ 乘以原系数。公式5:留出预测在旋转下逐点相等。旋转后的预测值等于旋转前的预测值。这意味着任何只通过留出预测来依赖划分的检验统计量,包括公式3里的 t_NB,都在 Q 下不变。分析者可以放心地把基底转到一个单词可读的版本,而不扰动推断结果。但一个 varimax 轴继承的是整个联合子空间的显著性,别的什么都没有。旋转后的轴上跑固定序列是不被许可的,因为序列定义在 NIPALS 提取顺序上,旋转会改变顺序。表2:旋转前后各自能检验什么。联合子空间检验「秩 K 拟合是否比随机更强」,在 NB 置换下精确;未旋转的第 h 个成分检验「去膨胀后是否还有正残差关联」,靠固定序列控制 FWER;而 varimax 轴本身没有任何单独的零假设,它只继承联合显著性。顺带说清楚这里 varimax 的具体用法:它是 Kaiser 归一化的方差极大旋转,作者旋转的是载荷矩阵 L = E_{V_tgt} W,而不是权重矩阵 W、也不是文档得分矩阵,旋转目标可以是完整词表,也可以是一份精心挑选的内容词清单。旋转只是在 Krylov 子空间内部换一个基底,让主监督载荷集中到一个稀疏、可描述的 Dim-1 上,于是 K 大于 1 的那些校准轴读起来就像是主轴上的「命名微调」。联合的 R²_full 是旋转不变的,而单轴 R² 如果报告,是在未旋转的 NIPALS 得分上算的。
逐成分检验:固定序列如何控制FWER
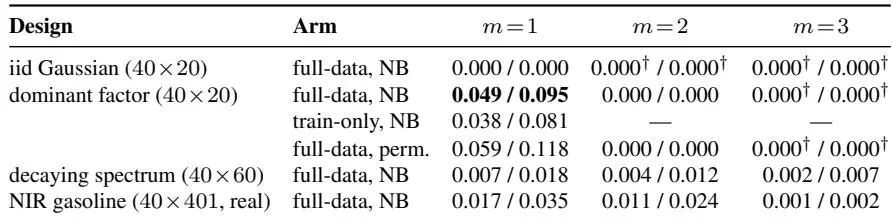
联合显著只能回答「整体有没有信号」,回答不了「第几个成分开始是纯噪声」。逐成分检验就建立在前面的 NIPALS 去膨胀上:对第 h 个轴(h = 2 到 K),先用前 h−1 个全数据 NIPALS 成分把 (X, y) 去膨胀成 (X⁽ʰ⁾, y⁽ʰ⁾),然后在这个对上按 K = 1 套用公式3;联合检验就是 h = 1 在全数据上的那一档。接下来这一步是控制假阳性的关键。检验按 NIPALS 提取顺序依次做 H₀,₁、H₀,₂、……,在水平 α 下,遇到第一次不拒绝就停;提取顺序不会根据检验结果调整。按固定序列的序贯拒绝原理,只要每一步的 NB 检验对有序族里每个真零假设都是 level-α 有效的(即所谓边界性质),那么无论更早的零假设是真是假,强族错误率(Family-Wise Error Rate,简称 FWER)控制都成立。道理很直白:任何一次错误拒绝都必须先拒绝第一个真零假设,所以检验之间根本不需要独立性假设。第 1 步顺带就是 y ⊥ x 的联合检验,这一步单独看不需要任何多重比较校正。但论文写得比较诚实:对重复划分版本的 NB,边界性质是经验评估的,不是形式证明的。附录 A.14 给出的有限样本保证,针对的是「单个独立划分 + train-only 去膨胀 + 高斯相关检验」这个变体。在那个变体里,拒绝第 h 步意味着成分 h 与前 h−1 个成分没解释掉的部分正相关,因此以足够小的正权重把它加进去会降低总体平方误差;概率至少 1−α,没有保留的成分在这个意义上是噪声。需要提醒的是,这里的成分是在训练半上拟合出来的,增益是相对更早的拟合成分而言的,并不是发现了一个全新的 y 方向。而这个证明并不覆盖 J 划分 NB 聚合的校准性,所以对 NB 而言,这个解读属于经验支持,而非定理。至于联合摘要 α*_FWER,定义也很干净:当 K* 由 CV-R² 上的 1-SE 规则(或 BIC)固定下来,α*_FWER 就是让前 K* 个零假设全部拒绝的最小名义水平,数值上等于这些步骤 p 值里的最大值。把一个本来有效的序列截断在 K*,不会抬高 FWER;但要强调,它并不能补上 NB 逐步有效性这个尚缺的环节。最能说明「序列回答的问题和选择回答的问题不是同一个」的,是 Warriner 效价(valence)数据上的例子。split-half 交叉验证 R² 曲线在 K = 2 之后基本平坦(0.601、0.619、0.625),追求简约的选择器会在那里停下;而 NB 对第 3 个成分的拒绝在 p ≈ 10⁻²⁴,第 4 个成分 p ≈ 10⁻¹¹;附录里被证明的单划分变体,在一个预先指定的划分上跑一次,把它检验的五个成分全部保留。也就是说,那些「多出来的」成分确实在做预测工作,只是它们的增益不足以让交叉验证曲线明显抬头。表4:在 m 个植入信号轴之后,序列继续拒绝到第 m+1 步的概率,n = 40,J = 50,植入总 R² = 0.5 分布在 m 个信号轴上,每格 5000 次重复,α = .05/.10。full-data 指每个步骤都在全部样本上去膨胀,train-only 指每个划分只用训练半去膨胀。要注意第 m+1 步未必是一个真正的条件零假设,所以这张表是诊断而不是 FWER 的直接估计。
实验验证:从合成几何到跨语言词嵌入
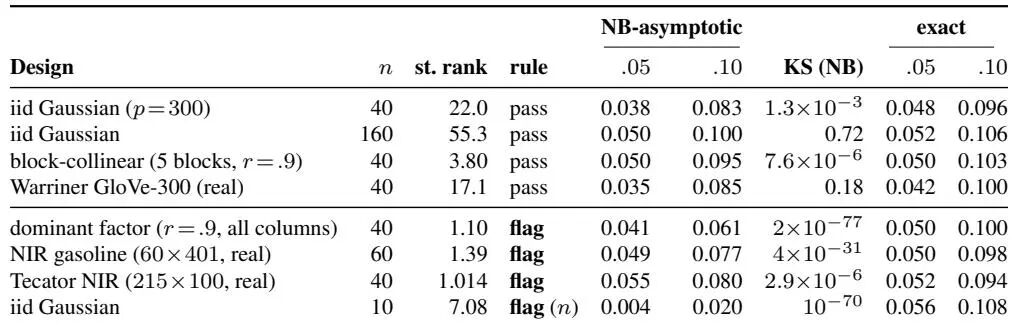
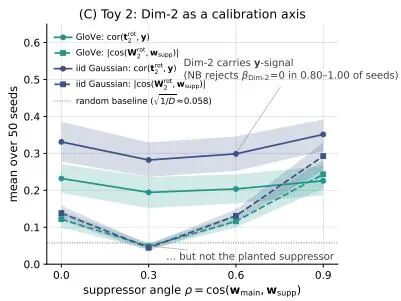
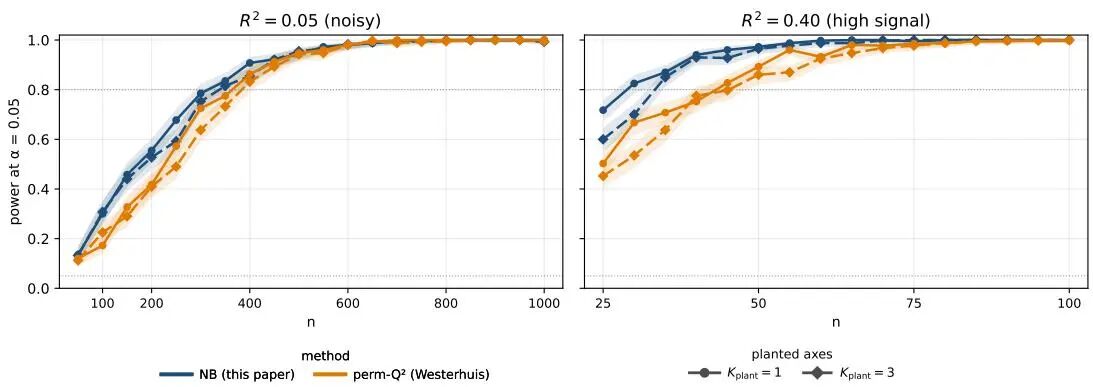
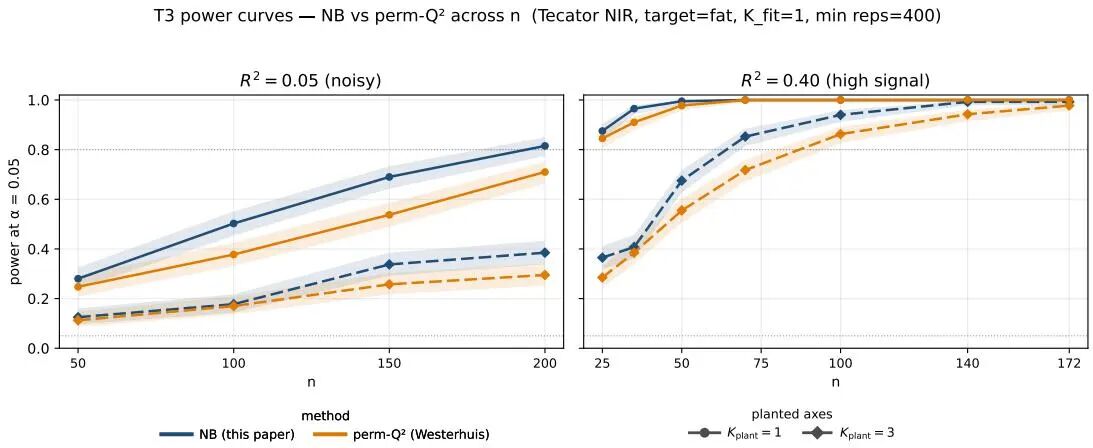
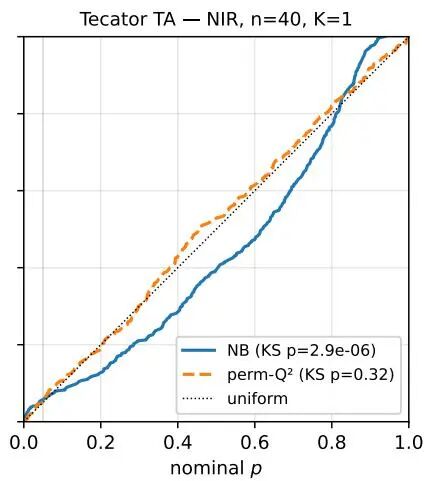
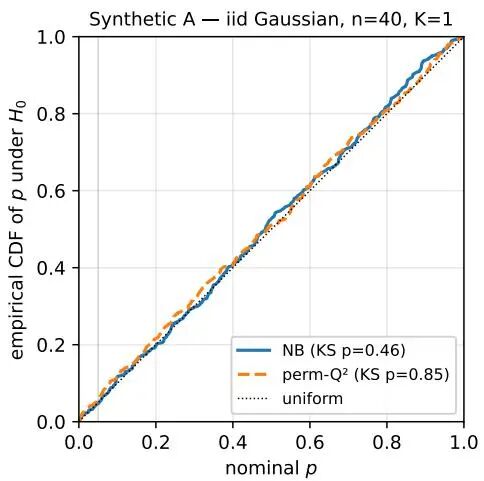
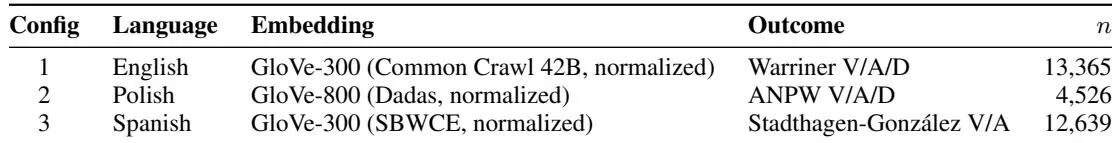
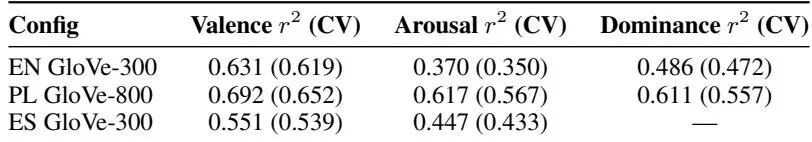
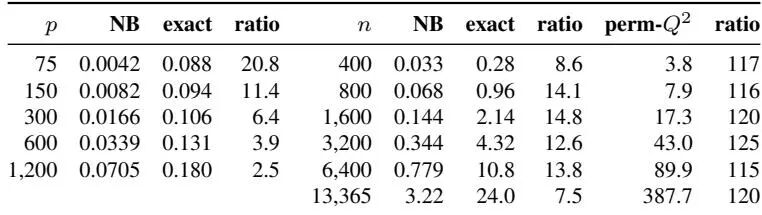
实验设计包括合成数据和真实数据。合成部分有 Toy 1 到 Toy 5,真实数据包括近红外化学计量学设计和文本配置。推断性主要在英文 Warriner GloVe-300 和两个近红外设计上做出,波兰语与西班牙语用于跨语言演示。有效性规则实验设计包括样本量从 10 到 320的25个零假设格子,覆盖不同几何。判断标准是「经验拒绝率是否偏离名义水平」。Tecator 被标记因为它本质上是个秩一设计,稳定秩只有 1.014,第一主成分承载了 98.6% 的方差,n = 40 时渐近零分布已经明显漂移。功效对比显示 NB 在每个样本量上都不弱于交叉验证置换 Q²,且成本上更便宜。机制实验说明 Krylov 饱和和校准轴的指纹现象。更高的成分确实在做预测工作,即使没有恢复新的 y 方向。跨语言配置中,支配度维度的最大缝隙出现在波兰语上,样本内 r² 是 0.611,交叉验证 R² 是 0.557。每个格子的 α*_FWER 都小于 .001。PaperDaily 收录范围内的同类工作,多是「换模块、换任务、报提升」的实验型论文,与本文这种推断工具类论文不在同一比较轴上。表3:有效性规则在八个零假设格子上的表现。stable rank 指列标准化设计的稳定秩;规则是 n < 25 或稳定秩 < 3 就标记(flag)。Level 是 H₀ 下 α = .05 / .10 的经验拒绝率,KS 是 NB 渐近零假设 p 值对均匀分布的 KS 检验 p 值。除 Warriner(2000 次)与 Tecator(渐近 400 次、精确 2000 次)外,每格 5000 次重复。可以看到精确检验在每个格子都守住了水平。图2:有监督 PLS 向 OLS 的 Krylov 饱和,以及校准轴指纹。(A) 在植入方向数为 3 时,逐轴主余弦随植入 R² 的变化。(B) 累积的 β̂_PLS(K) 与岭稳定化后的 β̂_OLS 对比,K 从 1 到 10。(C) Toy 2:K = 2 时植入一个与主预测变量成 ρ 角的抑制变量,varimax 旋转后的 Dim-2 恢复不出该抑制变量(虚线,接近随机基线),却仍然携带留出的 y 信号(实线),在 GloVe 与独立同分布几何上表现一致。图3:在合成 Warriner 几何上的经验功效随样本量变化,α = .05。蓝色为 NB,橙色为置换 Q²,实线对应植入方向数 1,虚线对应 3;左图 R² = 0.05,右图 R² = 0.40。NB 在所有样本量上都不落后,在噪声区间优势最明显。图4:Tecator 近红外数据上的经验功效随样本量变化,风格与图3一致。R² = 0.05 那条曲线在 n = 200 时仍低于 80% 就进入平台,NB 与置换 Q² 都是如此;这个天花板由植入信号本身的信息量决定(故意设置的弱效应),不是化学计量学设计造成的——两个检验追的是同一个天花板,这正是这个对比想说明的事。图5:H₀ 下 NB 与置换 Q² 的 p 值 PP 图。左图为合成数据 A(独立同分布高斯,n = 40,K = 1),右图为 Tecator(近红外,n = 40,K = 1),每格 400 次重复。对角线是均匀 H₀ 参考,灰色竖线标出 α = .05 的拒绝阈值。NB 渐近版在合成数据上贴着对角线,在 Tecator 上明显偏离(KS p 约 10⁻⁶);置换 Q² 在两处都贴着对角线。图D:Tecator 零分布的诊断补充图,进一步说明渐近版在近满秩设计上的漂移形态。Table 1: Inference procedures reviewed in §1.2. Costs describe the tested fit or component: F CV folds, J repeated splits, B permutations. Rotation entries concern rebasing a fixed fitted span; none supplies significance for an individual varimax axis.表5:三套「语言 × 词嵌入」配置。配置1用 Warriner 的效价/唤醒度/支配度,配置2用波兰语对应的 ANPW 常模,配置3用 Stadthagen-González 的效价/唤醒度常模(该常模没有支配度维度)。所有拟合都用 K = 3 加载荷矩阵上的 varimax。表6:三套配置的聚合拟合,K = 3,载荷上做 varimax。每个评分维度下第一个数字是全数据拟合的样本内 r²,括号里是 K = 3 时的 split-half 交叉验证 R²(J = 50 个划分的均值)。最大缝隙出现在波兰语的支配度上,样本内 0.611,交叉验证 0.557。每个格子的 α*_FWER 都小于 .001。表27:每次检验的墙钟耗时(秒)。左边是 n = 200 时的维度 p 扫描(合成数据池),右边是 p = 300 的 Warriner GloVe-300 阶梯,置换 Q² 作为第四种方法一起列出。比值都是相对 NB 渐近版而言的,可以看到 p 越大,精确检验相对渐近版越便宜。
import plskit

model = plskit.pls1_fit(X, y, k=1)

sig = plskit.pls1_confirmatory_test(
    X, y, k=1,
    test_method='split_exact',
    seed=42
)
Python 用户直接 pip install plskit,Rust 用户 cargo add plskit,R 和 Julia 包装器目前还没正式发布,需要从源码构建。许可证是 GPL-3.0-or-later。有意思的是这个项目的 star 数只有 2——典型的「论文附带的好东西没人知道」。凡是做过 PLS 又要写显著性的人,大概都能理解这种心情:工具终于有了,但知道的人还太少。
龙迷三问
下面是龙哥对于大家可能的一些问题的解答:这篇论文到底在解决什么问题?PLS回归在高维数据里用得极广,可推断要么有偏、要么贵到离谱、要么干脆没有。本工作把监督子空间推断归约为一次留出OLS重拟合,给出渐近NB检验与精确置换检验,并附有效性前置检查;成本约为交叉验证置换Q²的百分之一,功率反而更高。这篇工作最值得看的点是什么?NB检验在所有n和信噪比条件下功效均不低于perm-Q²,且计算成本仅为后者的1/115到1/125;精确置换检验在所有零假设单元中均保持水平(0.042-0.057 at α=.05);在Warriner valence数据上NB检验拒绝第3成分(p≈10^-24)和第4成分(p≈10^-11),而CV-R²曲线在K=2后平坦这篇工作的边界或风险在哪里?优点:(1)将PLS推断归约为留出OLS重拟合,统一了PLS、监督PCA和线性探针的推断框架;(2)提供了渐近和精确两种检验,成本远低于perm-Q²;(3)证明了留出预测的正交旋转不变性,使varimax旋转不破坏推断有效性;(4)提供了逐成分的固定序列FWER控制;(5)发布了Rust核心的多语言库。缺点:(1)NB渐近检验的有效性条件(n≥25且稳定秩≥3)是经验性的,仅在一个设计族上设定;(2)重复划分NB的边界性质未被正式证明;(3)旋转解释仅适用于文本嵌入等可读特征,对光谱波长等不可读特征不适用;(4)NB校正仅适用于PLS1,不适用于监督PCA和ridge探针;如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~
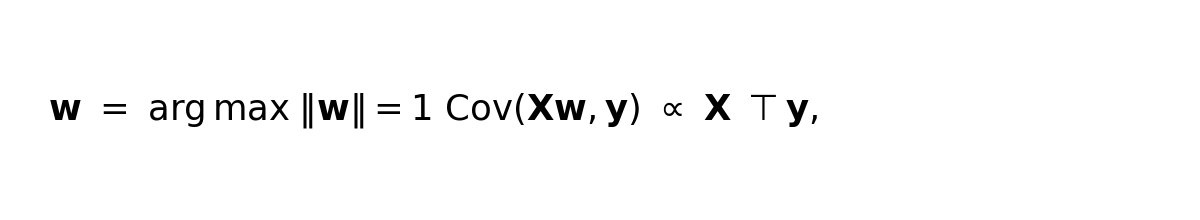
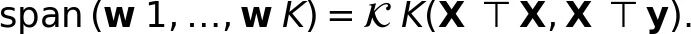

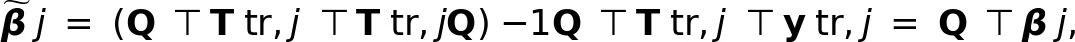


还没有公开留言,欢迎留下你的看法。