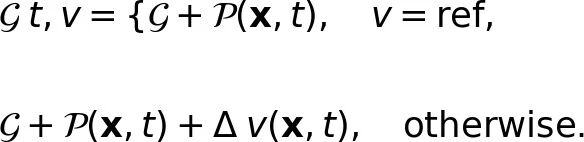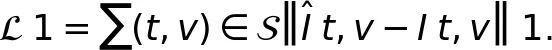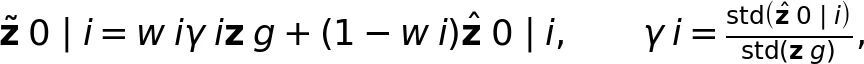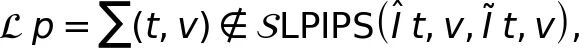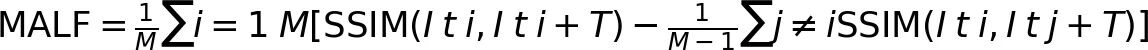← 返回 PaperDaily 视觉与图像

3D世界模型造出的场景都是"死"的?OuroWorld一键把它们复活

3D世界模型能把一张照片变成可走进去的场景,可这些世界是冻住的:叶子不摇,雾不飘,灯不闪。OuroWorld不用画任何掩膜,让视觉语言模型自己判断什么该动、怎么动,再用傅里叶形变场把首尾严丝合缝地接上。39个场景上全面超越四路基线,30人盲测偏好率70.8%—99%,值得一看它怎么在"互相打架"的脏监督里学出一个干净的4D场景。

3D世界模型造出的场景都是"死"的?OuroWorld一键把它们复活
原论文信息如下:
论文标题:
OuroWorld: Bringing Any 3D World Alive as Diverse, Endlessly Looping 3D Cinemagraphs
发表日期:
2026年10月9日
发表单位:
阳明交通大学、Alaya Lab
原文链接:
https://arxiv.org/pdf/2610.12461v1.pdf
项目链接:
https://ouroworld.userwei.com
先说一个很多人都体验过的场景。你花了不少算力跑出一个3D世界模型,得到一个可以自由转视角的3D场景,画面精致得像电影概念图。转了两圈,新鲜感过去之后,一种奇怪的乏味感浮上来:这个世界的时钟被按了暂停键。树叶不摇,雾不飘,水面平得像一块玻璃,灯光连闪都不闪一下。
这不是某一个模型的问题,而是当前3D世界模型的共性。HY-World 2.0、Marble、Lyra 2.0这类模型能生成照片级、可自由探索的场景,但它们本质上生成的是“某一瞬间”的世界快照。阳明交通大学与Alaya Lab的这篇OuroWorld,要解决的正是这件事:把一个冻住的静态3D高斯场景,变成一段会呼吸、而且永远不会“卡带”的动态影像。

从视频生成到4DGS:三阶段管线如何实现无缝循环
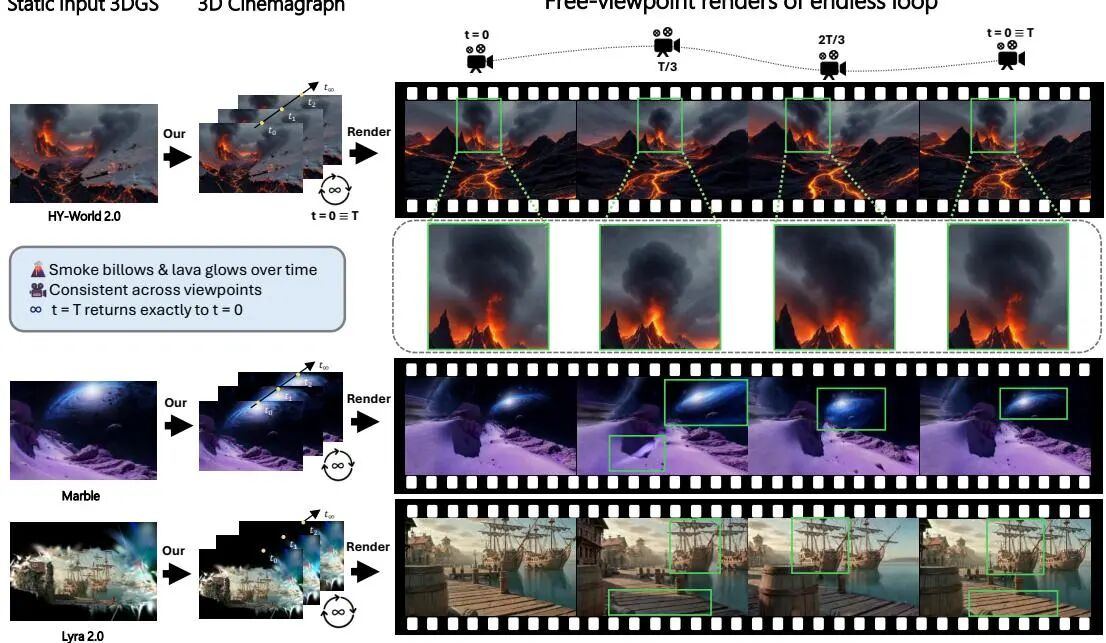
Figure 1 OuroWorld brings static 3D worlds alive
OuroWorld把静态3D世界变活。左:给定来自任意来源的静态3DGS场景,例如3D世界模型HY-World 2.0、Marble、Lyra 2.0的输出,OuroWorld把它转成一段3D动态影像,即具有生动多样运动、可无缝无限循环的动态场景。右:沿移动相机渲染的自由视角画面,绿框标出动态明显的区域——火山口冒烟、星系散落星尘、船只随水面上下浮动。运动在不同视角之间保持一致,且t=T时刻的场景回到t=0,循环无缝。
v2-74ba8bc1c6c52a48ea1c3c5c67685ca3_hd.jpg
这里要先解释一个词:3D动态影像,英文是3D cinemagraph。在2D语境里,cinemagraph是一种“半动图”:一张照片中只有一小块区域在动,比如飘起的头发、升腾的烟雾、闪烁的霓虹灯,而且这段运动循环播放,首尾接得严丝合缝,看起来像永远不会结束。搬到3D里,目标就变成:场景可以自由改变观看视角,同时其中的动态要循环、要连贯,还要在每个视角下都对得上。
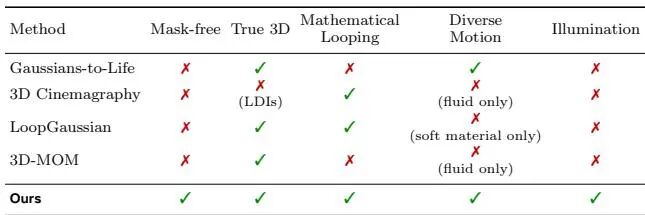
听起来只是“2D变3D”,难度其实完全不是一个量级。2D半动图只需要在一个平面上玩像素;3D场景要求生成的内容在所有视角下都自洽,否则一转到侧面就会看到一团糊掉的鬼影。已有的3D动态影像方法基本绕不开两个限制。一是需要人工或网络提供运动掩膜,也就是告诉算法“这块要动、那块别动”;二是依赖欧拉流(Eulerian flow,一种在固定空间网格上描述流体运动的表示),这类表示天生擅长水、烟、雾这种类流体的形变,遇到布料整体飘动、刚体位移、光照变化就力不从心。
Table 1 Capability comparison
能力对比。Mask-free表示不需要用户提供2D/3D运动掩膜;True 3D表示支持自由视角渲染,而不是伪3D;Mathematical Looping表示4D输出在数学上保证循环;Diverse Motion表示不局限于单一运动类型;Illumination表示支持时变光照。OuroWorld是唯一同时满足这五项的方法。
这五项能力其实在描述同一件事:能不能真的把任意一个3D世界变成任意形式的动态影像,而且不需要人工插手。欧拉流方法做不了光照变化,原因是它们本质上只搬运颜色和位置,没有为“亮度随时间改变”留出通道;掩膜依赖则意味着用户必须先看一遍场景、想清楚要动哪里,自动化程度被卡在人身上。
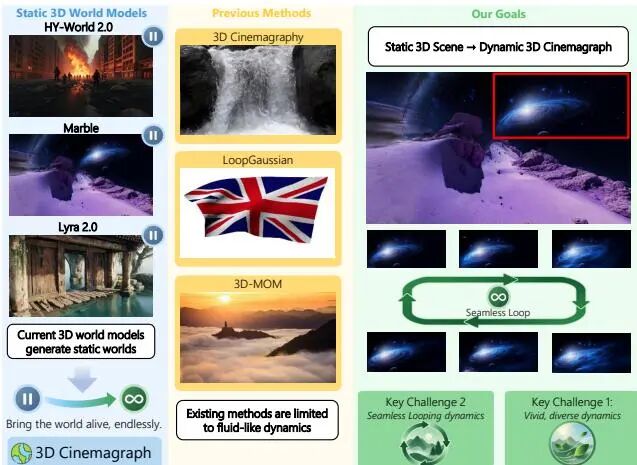
Figure 2 Motivation
动机。左:3D世界模型生成的是冻结的世界,3D动态影像让它们活起来。中:已有的3D动态影像方法依赖欧拉流,只能做类流体的运动。右:本文要把任意静态3D场景变成3D动态影像,需要满足两点——无缝循环,以及生动多样的动态。
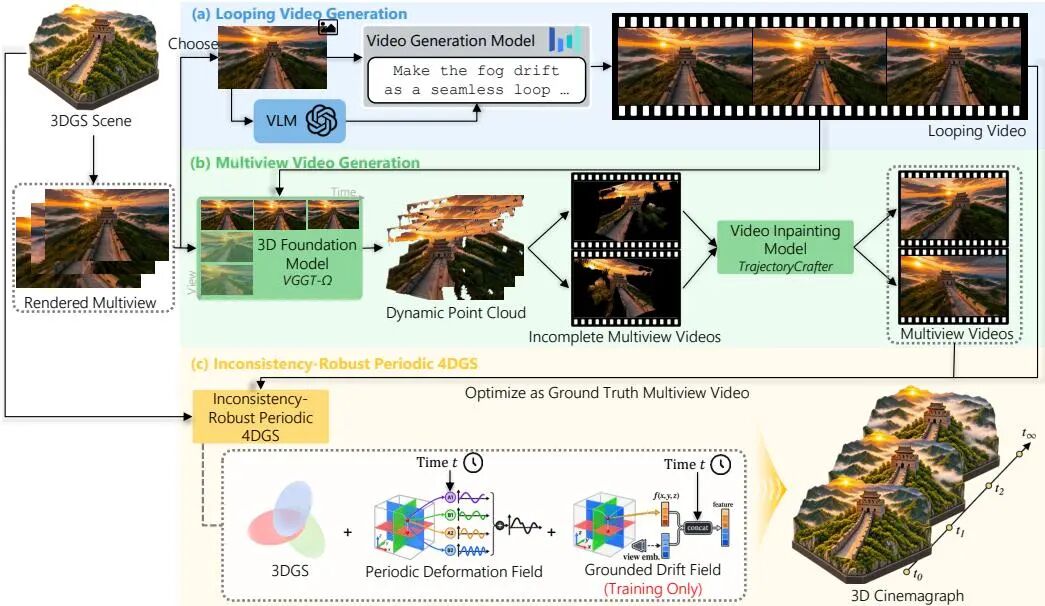
OuroWorld的整体流程可以概括成三步:先借助视觉语言模型生成一条近似循环的视频,再把这条视频抬升成多视角视频,最后用这些并不完全干净的监督信号去拟合一个4D场景。
Figure 3 Overview of OuroWorld
OuroWorld总览。(a)循环视频生成:VLM从输入3DGS渲染出的参考视角中选择视角、推断合理的场景动态,并提示视频生成模型合成一条近似循环的参考视频。(b)多视角视频生成:3D基础模型VGGT-Ω把参考视频抬升为动态点云,静态多视角渲染用于改善深度估计;点云从N个环绕视角渲染成带去遮挡空洞的不完整视频,再由视频修复模型TrajectoryCrafter补全为多视角视频。(c)抗不一致的周期4DGS:3D动态影像被表示为规范3DGS加上傅里叶参数化的周期形变场(构造上即循环),锚定漂移场在训练时吸收生成视频的跨视角不一致,推理时被丢弃。

第一步:让视觉语言模型决定什么该动、怎么动

第一步的输入很简单:从输入3DGS里渲染出的一张参考视角图像。论文用一个视觉语言模型(Visual Language Model,简称VLM)来充当“导演”。VLM会看着这张图判断什么该动、怎么动:有火山口就该冒烟,有海面就该起波,有银河就该有星尘飘散。判断完之后,它写出一段描述自然循环运动的提示词,交给视频生成模型去执行。
执行者是Seedance 2.0,它生成一段10秒的参考视频。关键在条件设置:参考图像同时作为这段视频的第一帧和最后一帧。这是个很朴素但很有效的技巧,首尾同图,生成出来的视频天然就是“近似”循环的。VLM还要再筛一遍,把运动不自然的结果挑掉。这一模块本身不挑食,任何能生成近似循环视频的可控视频生成器都能替换进来,换句话说,这一阶段的性能上限基本由手上的视频生成模型决定。

第二步:一条视频怎么变成二十路视角

单条视频只有一个观看方向,而一个4D场景需要在各个方向上都说得通。所以第二步要把这条参考视频扩展成多视角视频。
具体做法是:把参考视频和输入3DGS的多视角静态渲染一起送进3D基础模型VGGT-Ω,估计出参考视频逐帧的动态点云。注意静态渲染在这里不提供动态,它的作用是帮助模型把深度估计得更准。得到动态点云之后,在水平方向±20°范围内均匀采样N=20个视角,把点云渲染成20段视频。
这20段视频此时是残缺的:视角一转,原本被前景挡住的区域会露出来,而点云在那些位置是空的,于是形成一个个空洞,学术上叫去遮挡空洞(disocclusion hole)。补洞的任务交给视频修复模型TrajectoryCrafter,它以参考视频为条件,把每个视角的空洞补上,最终得到20路多视角视频。

第三步:用“互相打架”的监督训出一个干净的4D场景

第三步是整篇论文最有嚼头的地方。先说监督信号有多脏:这20路视频是分别生成的,彼此之间并不一致。同一片水面,视角1生成的可能是细密涟漪,视角2生成的可能是大浪;同一个灯泡,视角1在闪,视角3可能毫无变化。更麻烦的是,它们还可能与输入的静态3DGS几何对不上。
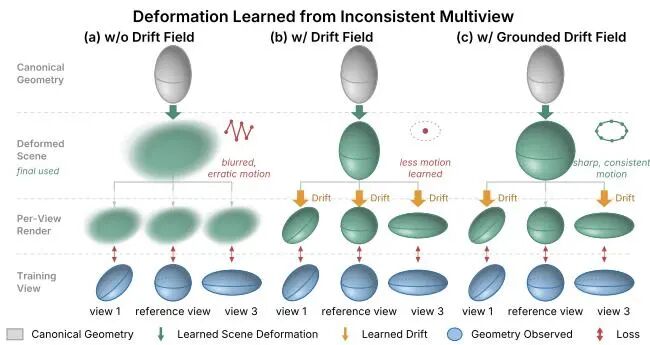
如果把这样的多视角视频直接拿来拟合一个动态3D高斯(4D Gaussian Splatting,简称4DGS),结果会很典型:形变场被迫在不同视角的冲突观测之间取平均,最终得到一个既模糊又抖动的场景。论文原话是blurring the scene and producing erratic motion,也就是模糊加上运动错乱。
OuroWorld的应对是三个组件:一个规范3D高斯𝒢,负责场景的静态骨架;一个周期形变场𝒫,负责真正的动态;一个锚定漂移场Δ,负责吸收监督里的噪声。后两个是核心,下一节展开。

周期形变场+锚定漂移场:两大核心机制解析


周期形变场:把“循环”写进表示结构里
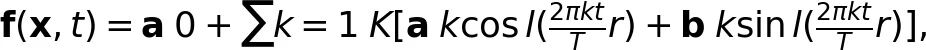
要让动态循环,最直接的想法是“生成的时候尽量首尾一致,拟合的时候再加个约束”。这条路的问题是不保证:约束是软的,优化跑歪了,接缝处就会出现可见的跳变。OuroWorld走的是另一条路,把周期性直接写进表示结构,让循环成为构造性质,而不是优化目标。
Eq 1 Fourier-series time-dependent feature
公式1:周期形变场的时间特征。a₀是常数项,aₖ和bₖ是第k阶余弦、正弦分量的系数,T是循环周期,K是时间带宽(可容纳的频率分量个数)。由于f(x, t+T) = f(x, t),形变场本身严格是T周期的。
公式看着有点唬人,拆开就三件事。第一,每个高斯点的规范位置x先去查询一个三平面(triplane)特征,得到一个向量F(x),它被切成若干系数:常数项a₀,以及各阶余弦、正弦系数aₖ、bₖ。第二,把这些系数按时间做加权求和,就得到随位置和时间变化的特征f(x,t)。第三,一个小型多层感知机把这个特征解码成四类属性偏移:位置偏移、旋转偏移、缩放偏移、颜色偏移,于是每个高斯点都能随时间移动、变形、变色。
关键性质只有一句话:正弦余弦在时间上加一个周期T之后取值完全不变,所以f(x, t+T)恒等于f(x, t)。这意味着无论优化收敛到什么程度、哪怕中途被打断,最终场景在数学上都严格是T周期的,首尾一定对得上。
顺带说一句,之前也有工作用傅里叶基做动态表示,但它们看中的是拟合能力,用一组频率基去拟合复杂的时序变化;本文用到的是它的周期性。这个区别挺重要:一个是为了拟合得更像,一个是为了保证结构上不出错。

锚定漂移场:把不一致赶进一个“用完就丢”的通道

循环解决了,还剩跨视角不一致。论文的思路是把每个视角相对参考视角的偏差单独建一个模型来吸收,称为漂移场Δ。它和周期形变场共用三平面加多层感知机的结构,输入包括空间特征、时间嵌入和一个视角嵌入,输出同样是位置、旋转、缩放、颜色四类偏移。
训练时为视角v渲染时就把Δ_v加上去,让损失函数把视角特有的不一致归因到Δ_v身上,而不是污染共享的场景。推理时,Δ被整个丢掉,只渲染𝒢+𝒫(x,t),于是留下来的动态基本不含跨视角不一致。
但这里有个陷阱,论文专门做了实验说明:如果每个视角(包括参考视角)都加漂移,模型会偷懒。因为Δ和𝒫都依赖时间,更灵活的、随视角而变的Δ会把大部分动态都解释掉,而它在推理时又被丢弃,结果是最终场景动得很少。论文的解法叫“锚定”——参考视角不加漂移。
Eq 2 Grounded rendering
公式2:锚定渲染。当视角v是参考视角(ref)时,只渲染规范场景加周期形变场𝒢+𝒫(x,t);其他视角才额外加上视角相关的漂移Δ_v(x,t)。这条分岔迫使𝒫独自复现参考视角的动态,而Δ只吸收每个视角相对参考视角的残差。
这条分岔看着技术,逻辑其实很朴素:参考视角的动态是视频生成模型直接给出的,是整个监督里最可靠的一份。既然它最可靠,就不允许用漂移去“解释”它,逼着周期形变场把这份动态独自学下来。其他视角的漂移,只负责收拾它们相对参考视角的那点残差。
Figure 4 Learning deformation from inconsistent multi-view videos
图4:从不一致的多视角视频中学习形变。各行依次为规范几何、推理时的形变场景、训练时各视角渲染、以及生成的训练视角。(a)无漂移场:冲突视角被平均,造成模糊与运动错乱。(b)有漂移场但无锚定:每个视角上的漂移吸收了过多动态,而它在推理时被丢弃,导致运动量减少。(c)锚定漂移场(本文):参考视角没有漂移,形变场必须自己复现参考动态,得到清晰且运动一致的场景。

场景-视角一致性优化:干净监督用L1,脏监督用扩散重绘

最后一个机制解决的是“生成内容和输入3DGS对不上”的问题。论文把监督信号分成两类,分别用不同方式处理。
第一类是高度一致的图像,包括参考视频本身,以及输入3DGS在t=0时刻的多视角渲染。这些内容的几何和外观基本可信,直接用L1损失监督,做法借鉴自Free4D。
Eq 3 L1 loss on consistent supervision
公式3:一致性监督的L1损失。Î是渲染结果,I是对应的监督图像,求和遍历所有高度一致的(时间t,视角v)样本集合𝒮。
第二类是其余生成帧,它们可能和输入场景对不上。对这类内容,论文不打“硬”监督,而是先把渲染结果加噪、再用图像扩散模型(Stable Diffusion v1.5)在对应生成帧的引导下去噪,得到一张重绘图,然后用LPIPS感知损失去对齐渲染结果和这张重绘图。
Eq 4 Diffusion-based image refinement
公式4:基于扩散模型的重绘。z̃是重绘后的潜变量,z^g是引导用的生成帧潜变量,ẑ是渲染结果对应的潜变量,γ是按标准差做的尺度对齐系数,w是混合权重。这一步的作用是把质量参差的生成帧“洗”成一张更干净、更容易对齐的目标图。
Eq 5 LPIPS loss on generated frames
公式5:生成帧上的LPIPS感知损失。求和遍历集合𝒮之外的(时间t,视角v)样本,Î是渲染结果,Ĩ是扩散重绘后的目标图。总目标是两项损失的加权和。直觉上,这相当于对脏监督先做一次“美化”,再用感知损失去拉近,而不是硬拿L1去拟合不可靠的内容,把生成过程的不一致烙进场景里。

无真值评估框架:如何衡量3D动态影像的质量

评估是这篇论文另一个值得说的地方。这个任务没有真值:你不可能给一个“从静态3DGS生成出来的动态世界”准备一段标准答案视频。而已有的3D动态影像工作,评估数据基本局限在流体数据集或者物体级合成场景上,拿到室内、风景、建筑、风格化场景上就不好使。论文因此提出了一套无真值评估框架,按“一个好的3D动态影像应该具备什么性质”来设计指标,共四个维度。

生动度:不看它像不像,看它动没动

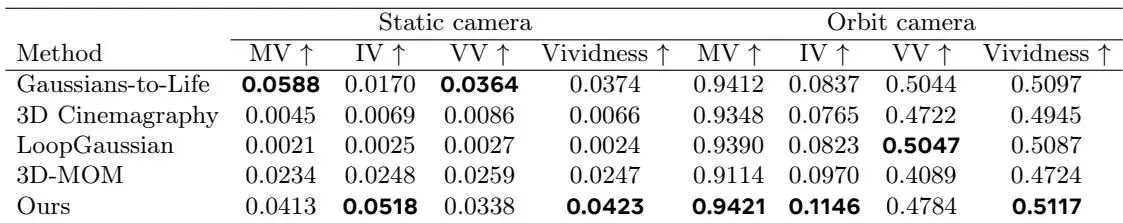
生动度(Vividness Degree)衡量画面里的动态有多丰富,计算方式是把视频按时间降采样到3FPS,再取三个分量的平均。运动变化(Motion Variation,MV)是光流幅度超过 0.3%×min(H,W) 的像素占比,光流由SEA-RAFT估计;光照变化(Illumination Variation,IV)是灰度亮度变化超过20%的像素占比;视觉变化(Visual Variation,VV)用1减去SSIM,衡量整体外观变化,这一项参考了VideoScore的做法。三个阈值都按人眼可感知的变化水平来设,避免把不可见的微小抖动也算成“动”。

自然度:用一个视频生成模型来当“自然”的尺子

自然度(Naturalness)用KVD(核散度,Kernel Video Distance)衡量生成视频分布与自然视频分布之间的距离。这里的“自然分布”用开源视频生成模型MiniMax H3来近似,每个场景生成20条视频、共780条,条件同样是参考视角加GPT-5.5写的动态提示词。刻意不用自己管线里的Seedance 2.0,是为了避免拿自家模型当裁判。

循环接缝一致性:既要转到头,也要接得上

这一维度用两个指标。运动感知循环保真度(Motion-Aware Loop Fidelity,MALF)判断“隔一个周期后的同一相位”是否比“隔一个周期后的其他相位”更像,静止视频在这个指标上是零分。接缝SSIM(Seam SSIM)则是把上一个周期的最后一帧与下一个周期的第一帧做SSIM。两个指标都在单个接缝上计算、并且使用静态相机,以免把视角变化混进来。
Eq 6 Motion-Aware Loop Fidelity
公式6:运动感知循环保真度MALF。在一个周期内采样M=10个时间点,第一项是同一相位隔一个周期T之后的SSIM,第二项是该相位与其他相位隔一个周期之后的平均SSIM,两者相减再对M个时间点求平均。T是循环周期,I是渲染图像。这样一来,静止场景虽然SSIM很高,但因为不同相位之间几乎没差别,MALF依然接近零。
这一对指标的设计意图很清楚:LoopGaussian和3D Cinemagraphy这类近乎静止的方法,接缝SSIM可以刷到0.999以上,但它们几乎没有运动,接缝连续是“平凡”的。MALF就是用来拆穿这种刷分的。

场景质量与统一的渲染协议

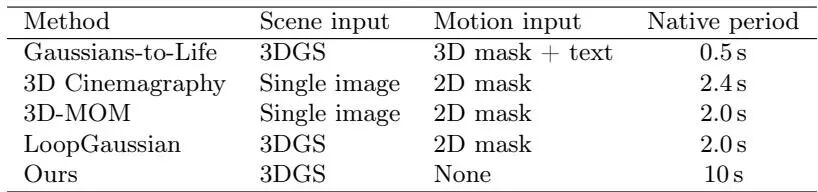
场景质量沿用VBench的美学质量(Aesthetic Quality)和整体一致性(Overall Consistency)。渲染协议统一为:20秒、30FPS、600帧、672×384分辨率,每个场景跑两条轨迹。静态相机固定在参考位姿;环绕相机围绕一个枢轴点扫过0°→20°→−20°→0°,用来考核3D一致性。两条轨迹都覆盖多个运动周期。另外,论文保留每个方法自己的原生周期再重复填充到20秒,而不是把周期归一化,原因是改周期会改变运动速度、引入与方法本身无关的伪影。

实验结果:全面超越基线,用户偏好率高达99%


实验设置

数据集共39个场景:9个来自Mip-NeRF 360的重建场景,另外30个分别来自HY-World 2.0、Marble、Lyra 2.0三个3D世界模型,每个贡献10个。场景涵盖室内、风景、建筑和风格化环境,既包括欧拉流方法擅长的流体与布料运动,也包括它们做不了的光照闪烁、星尘飘散这类动态。
对比方法四路:Gaussians-to-Life用视频扩散先验驱动3D点流,但不追求循环;3D Cinemagraphy用单图加欧拉运动先验,靠分层深度图渲染;3D-MOM同样是欧拉先验,但用4D高斯承载;LoopGaussian只沿双向混合的欧拉场移动高斯位置。三路欧拉系方法都需要运动掩膜。
公平性处理花了不少功夫。所有基线都需要静态3DGS之外的额外输入,论文统一从自己的管线里取:参考视角图像从输入3DGS渲染,文本提示用GPT-5.5写的那份,需要掩膜的方法则先由规则方法命名运动物体、再用SAM 3分割成2D掩膜、配合渲染深度反投影成3D掩膜。所有基线也过一遍同样的GPT-5.5筛选。全部实验跑在单张NVIDIA RTX 4090上。
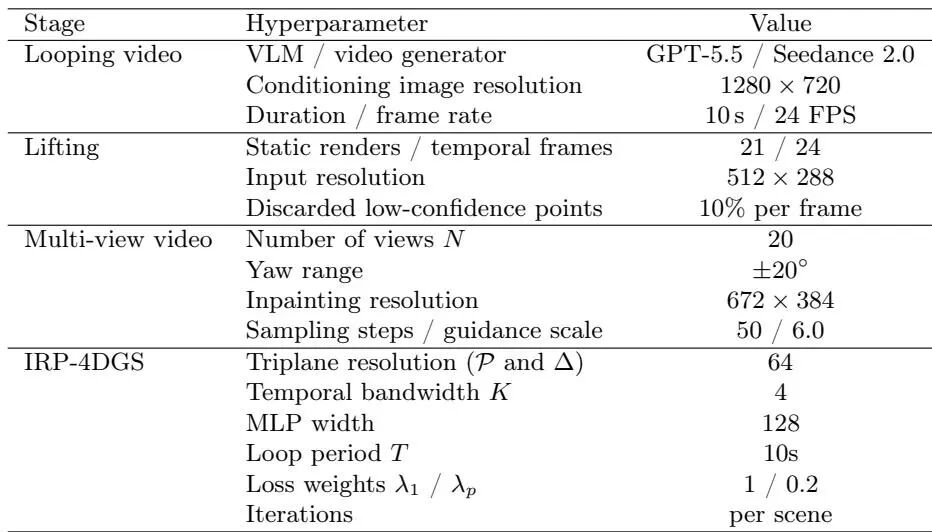
Table A.1 Hyperparameters of OuroWorld
表A.1:OuroWorld的超参数设置。
Table A.2 Inputs and native loop periods
表A.2:各方法的输入与原生循环周期。对于不循环的Gaussians-to-Life,周期取它生成运动的时长。

结果分析

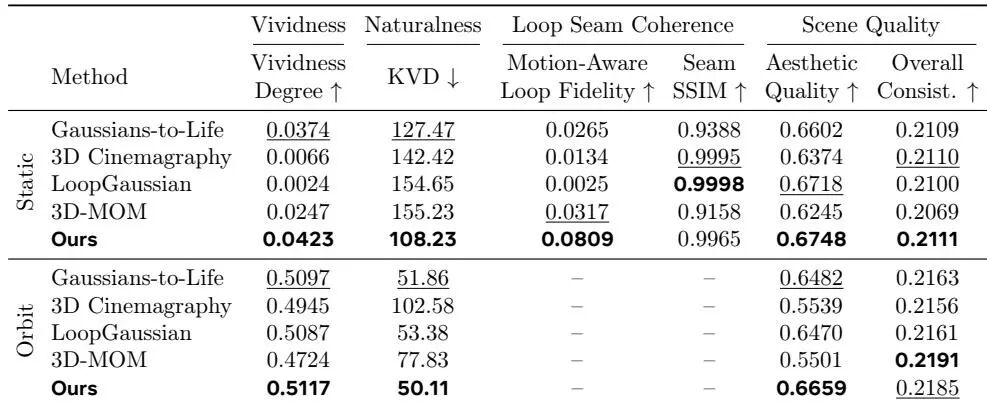
先给结论:在静态相机和环绕相机两种设置下,OuroWorld拿到了最好的生动度、自然度、MALF和美学质量。更值得琢磨的是这几个数字之间的关系。
第一,接缝SSIM这一列要小心解读。LoopGaussian的0.9998和3D Cinemagraphy的0.9995都比本文的0.9965略高,但它们的生动度分别是0.0024和0.0066,几乎等于不动,MALF更是只有0.0025和0.0134。静止画面的接缝当然完美,这是“平凡解”。本文的0.9965是在生动度0.0423、MALF 0.0809的前提下拿到的,MALF比第二名3D-MOM的0.0317高出约1.5倍——这个组合才有意义。
第二,领先幅度要客观看。生动度上,静态相机下本文0.0423对Gaussians-to-Life的0.0374,提升约13%;环绕相机下0.5117对0.5097,差距很小。真正拉开身位的是循环质量(MALF 0.0809对次优0.0317)和自然度(KVD 108.23对次优127.47,该指标越低越好)。也就是说,这篇论文的强项不是“动得更多”,而是“动得有结构、接得上、看起来自然”。
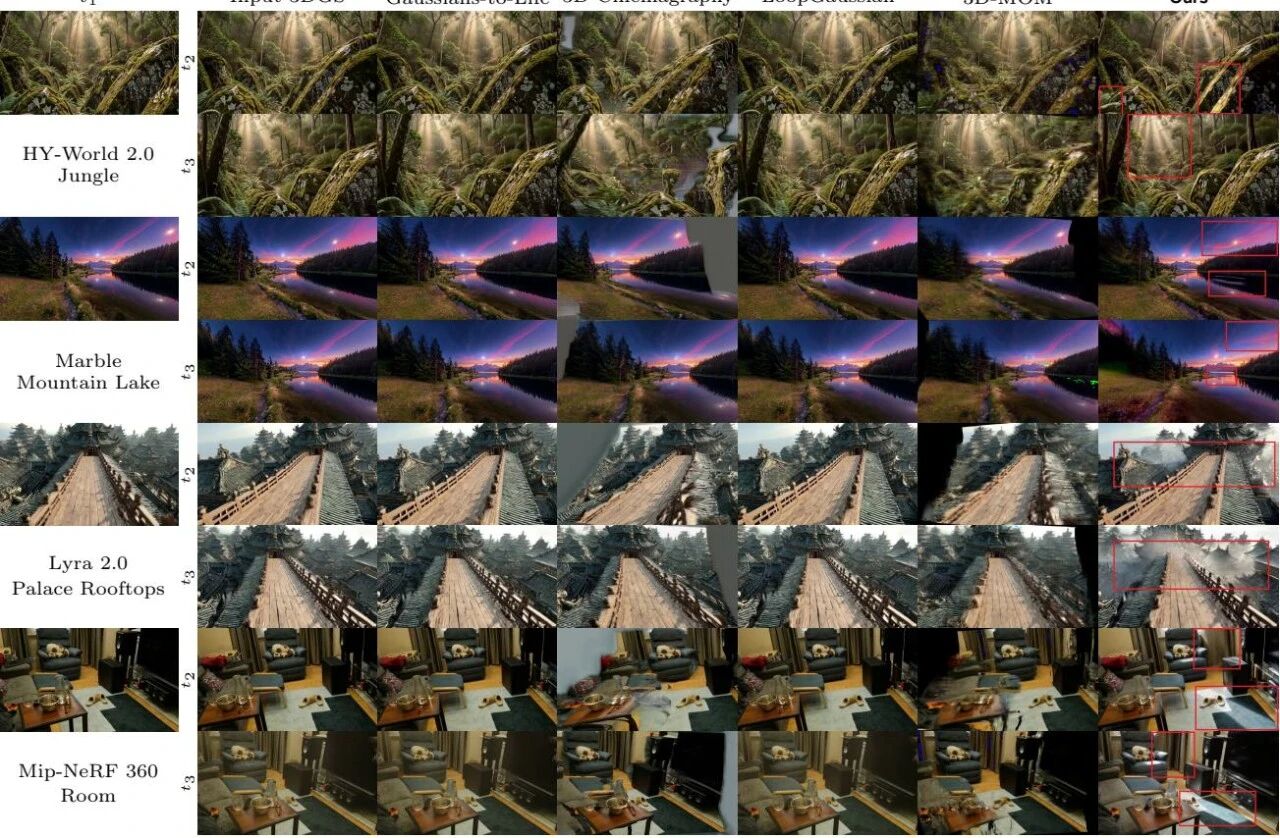
第三,环绕相机下基线集体掉链子,原因在方法本身。3D Cinemagraphy和3D-MOM依赖分层深度图或欧拉场的表示,视角一转就出现去遮挡空洞和颜色伪影;Gaussians-to-Life和LoopGaussian则一直近乎静止。本文的多视角视频生成为环绕视角提供了真实内容,这是它在这一项上占优的直接原因。
第四,消融实验的解释力比主表更强。去掉漂移场,训练时形变场要平均掉冲突视角,细节随时间退化,清晰度指标VoL(拉普拉斯方差)下降;去掉锚定,漂移把动态吸走,推理时动态变少,生动度掉到所有变体最低(0.0423→0.0392);去掉场景-视角一致性优化,修复模型的不一致被烙进场景,环绕相机下VoL掉了22%。三处改动对应三个明确的设计动机,每个组件都能被单独证伪,这种消融比单纯堆指标有说服力。
还有一个细节值得单独提:把傅里叶基的周期从T改成2T,容量不变,但形变不再是T周期。静态相机下接缝SSIM从0.9965掉到0.9783,循环边界出现可见跳变,而MALF几乎不变(0.0809→0.0788)。这说明退化集中在接缝而不是整体运动,也反向印证了“周期性由构造保证”不是修辞。

定量结果

Table 2 Quantitative result
表2:定量结果。生动度衡量运动、光照与外观变化;KVD衡量与自然视频分布的距离;MALF衡量场景在真正运动的同时是否循环;接缝SSIM衡量相邻周期接缝处的相似度;美学质量和整体一致性沿用VBench来评估场景质量。加粗与下划线分别表示最好与次好结果。本文取得最好的生动度、自然度和美学质量。近乎静止的方法(LoopGaussian、3D Cinemagraphy)能平凡地拿到很高的接缝SSIM,但MALF接近零;而本文在拿到最高MALF的同时保持了高接缝SSIM。
Table A.3 Vividness breakdown against baselines
表A.3:生动度的分项拆解对比。MV、IV、VV分别表示运动变化、光照变化和视觉变化,生动度取三者平均。加粗为最好结果。

定性结果

Figure 5 Qualitative comparison under the orbit camera
图5:环绕相机下的定性对比,每个来源各取一个场景。最左列是t₁时刻的输入3DGS;其余列是各方法在后续时刻t₂、t₃的结果。3D Cinemagraphy和3D-MOM会产生去遮挡空洞和颜色伪影,Gaussians-to-Life和LoopGaussian则几乎静止。OuroWorld生成出生动且视角一致的动态,比如变化的光照、泛起的涟漪、漂移的雾,以及随风摆动的窗帘。

用户研究

自动指标只能近似人的感知,所以论文补了一项双选强制选择(2AFC)用户研究:30名参与者在生动度、自然度、循环接缝一致性、视觉质量四个标准下,把本文结果与每一路基线做两两比较。
Figure 6 User study
图6:用户研究。在双选强制选择实验中,参与者按四个标准把OuroWorld与每路基线做比较。柱条表示偏好本文(左)与偏好基线(右)的投票比例。本文在所有基线和所有标准下的偏好率为70.8%–99.0%,其中生动度一项的优势最大。共30名参与者参加。
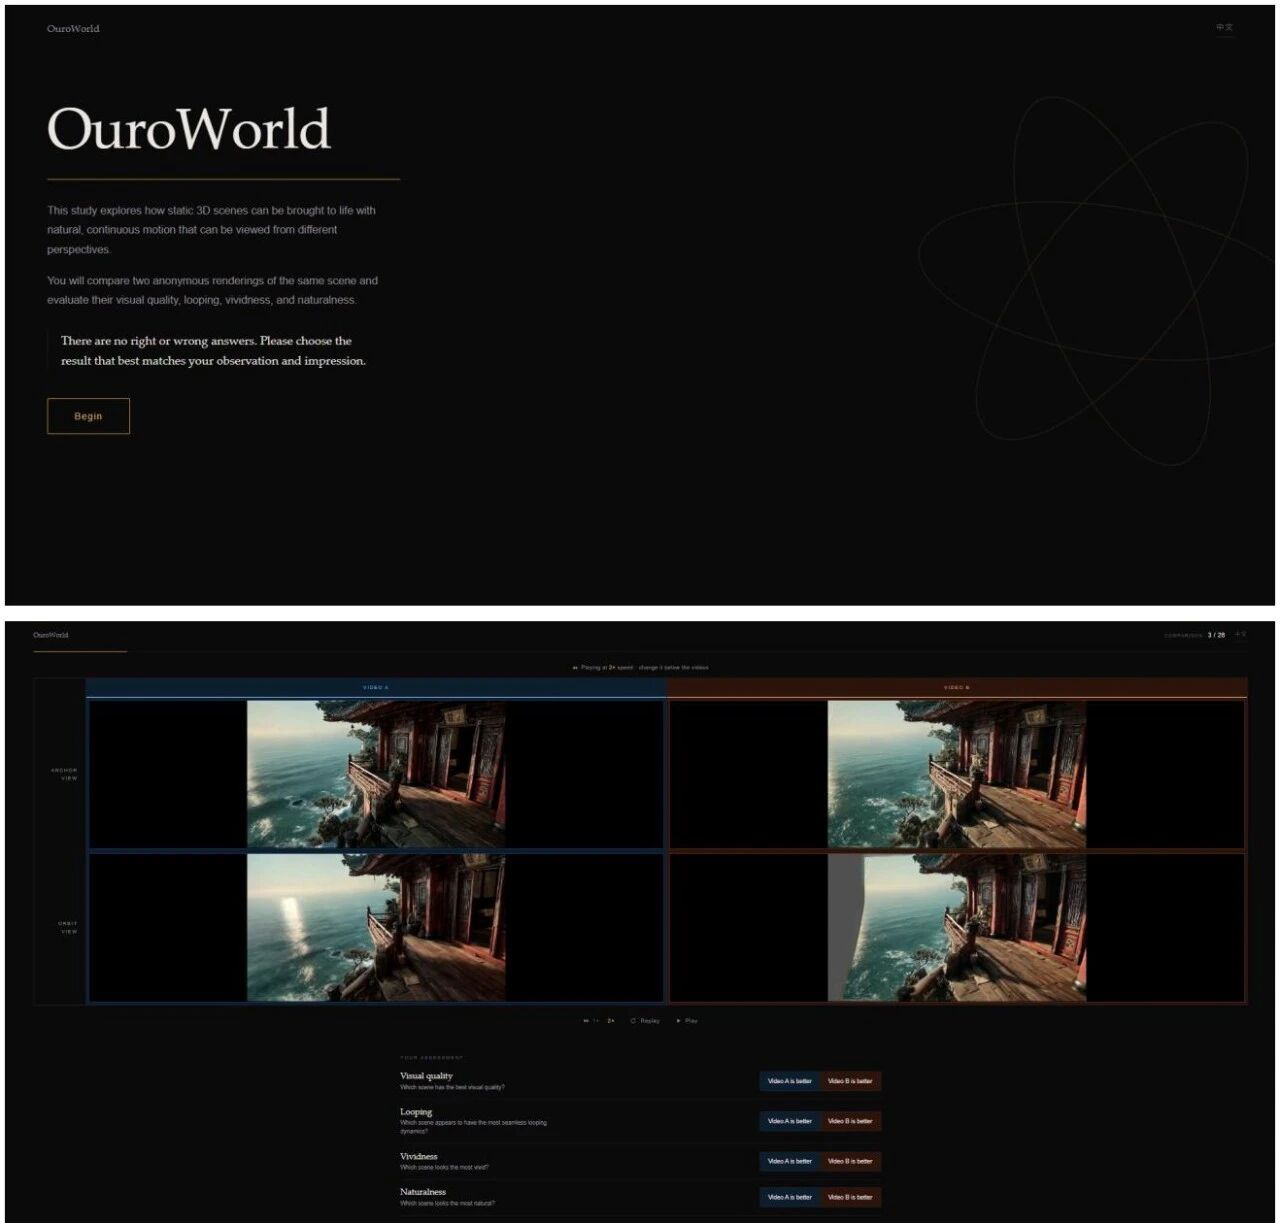
Figure A.3 User study interface
图A.3:用户研究界面。同一场景的两段视频按随机顺序左右并排展示(上方),参与者在下方对四个标准各做一次选择。
结果与主表趋势对得上:本文在全部基线和全部标准下都被更频繁地选中,偏好比例落在70.8%到99.0%之间。反过来看,用户研究也给这套自动指标提供了一次外部校验——如果指标和人的判断完全脱节,那么指标设计就有问题,这里两者是一致的。
621df26778f05KkH.gif


龙迷三问

下面是龙哥对于大家可能的一些问题的解答:
这篇论文到底在解决什么问题?无需任何掩膜,阳明交大团队提出OuroWorld:让视觉语言模型推断运动、视频模型生成参考视频,再用傅里叶周期形变场与锚定漂移场拟合4D高斯,把静态3D场景变成无缝循环的动态世界,用户偏好率最高99%。
这篇工作最值得看的点是什么?在39个场景上,OuroWorld在Vividness、Naturalness、MALF和Aesthetic Quality上均取得最佳结果,用户研究中以70.8%–99.0%的偏好率优于所有基线。在静态相机下Vividness Degree达0.0423,MALF达0.0809,Seam SSIM达0.9965;在环绕相机下Vividness Degree达0.5117,KVD降至50.11。
这篇工作的边界或风险在哪里?优点:(1)首个无掩码3D动态影像框架,无需用户提供运动掩码;(2)傅里叶级数形变场从构造上保证循环,无需后处理;(3)锚定漂移场有效处理生成多视图视频的不一致性,推理时丢弃不增加开销;(4)支持一般形变、物体运动和光照变化,超越欧拉方法的流体运动限制;(5)提出无真值评估框架,覆盖生动性、自然性、循环接缝一致性和场景质量。缺点:(1)动态受限于视频生成先验,不合理生成会传播到最终场景;(2)从单一参考视频完成所有视图在更大视角范围下导致更多遮挡和不一致;(3)评估依赖生成模型近似自然视频分布,可能引入偏差;(4)部分基线原生周期差异大,统一评估方式可能不完全公平。
如果你还有哪些想要了解的,欢迎在评论区留言或者讨论~

龙哥点评

论文创新性分数:★★★★☆

提出无掩码框架OuroWorld,利用视觉语言模型推断场景动态并引导视频生成模型合成参考视频,再通过多视图视频生成和不一致性鲁棒周期4DGS(傅里叶级数形变场保证循环,锚定漂移场吸收跨视图不一致)将任意静态3DGS场景转化为无缝循环的3D动。

实验合理度:★★★★☆

Vividness Degree(MV+IV+VV)、KVD、Motion-Aware Loop Fidelity (MALF)、Seam SSIM、Aesthetic Quality、Overall Consistency、Subject。

学术研究价值:★★★★☆

提出无掩码框架OuroWorld,利用视觉语言模型推断场景动态并引导视频生成模型合成参考视频,再通过多视图视频生成和不一致性鲁棒周期4DGS(傅里叶级数形变场保证循环,锚定漂移场吸收跨视图不一致)将任。

稳定性:★★★☆☆

现有材料未提供充分的极端条件、重复运行或扰动测试,稳定性暂按中性评价。

适应性以及泛化能力:★★★☆☆

现有材料未完整展示跨数据集、跨场景或分布外实验,泛化能力仍需进一步验证。

硬件需求及成本:★★★☆☆

所有实验在单张NVIDIA RTX 4090 GPU上运行,具体FLOPs未报告

复现难度:★★★☆☆

现有材料未确认完整代码、配置、数据处理脚本和权重是否齐备,复现难度暂按中性评价。

产品化成熟度:★★★☆☆

论文验证以研究实验为主,真实部署中的时延、成本、维护和异常场景仍需补充验证。

可能的问题:现有材料尚未充分覆盖分布外泛化、部署成本、长期稳定性和失败案例。


*本文仅代表个人理解及观点,不构成任何论文审核或者项目落地推荐意见,具体以相关组织评审结果为准。欢迎就论文内容交流探讨,理性发言哦~ 想了解更多原文细节的小伙伴,可以点击"阅读原文",查看更多原论文细节哦!       

转发文章 微博 X LinkedIn Facebook

读者留言

可直接以游客身份留言,也可注册读者账号。所有留言均需管理员审核后公开。

0 条已公开

还没有公开留言,欢迎留下你的看法。

游客可以直接留言;注册后可使用固定昵称和账号身份。 登录 免费注册
同一访问者每天最多提交 5 条。
龙哥读论文 · PaperDaily

本文基于龙哥读论文 PaperDaily 数据库整理,结合论文原文与工程视角进行解读。

LONGGE AI COMMUNITY

把每天读到的论文,变成长期积累

加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。

加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。

龙哥读论文知识星球二维码 微信扫码加入知识星球