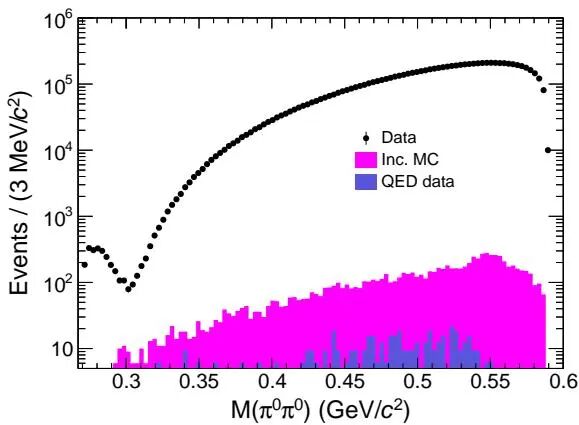
中科院高能所BESIII:π⁰π⁰阈值增强确认,显著性超10σ
ψ(3686)衰变成一对π介子加一个J/ψ时,π介子对的质量谱在靠近阈值的地方会鼓出一个小包。这个包在带电道里早就被看到过,如今BESIII在干净的中性道里又把它逮住了一次,显著性超过10σ。它究竟是新的共振结构,还是ππ散射埋下的老伏笔,正好值得掰开看看。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
ψ(3686)衰变成一对π介子加一个J/ψ时,π介子对的质量谱在靠近阈值的地方会鼓出一个小包。这个包在带电道里早就被看到过,如今BESIII在干净的中性道里又把它逮住了一次,显著性超过10σ。它究竟是新的共振结构,还是ππ散射埋下的老伏笔,正好值得掰开看看。
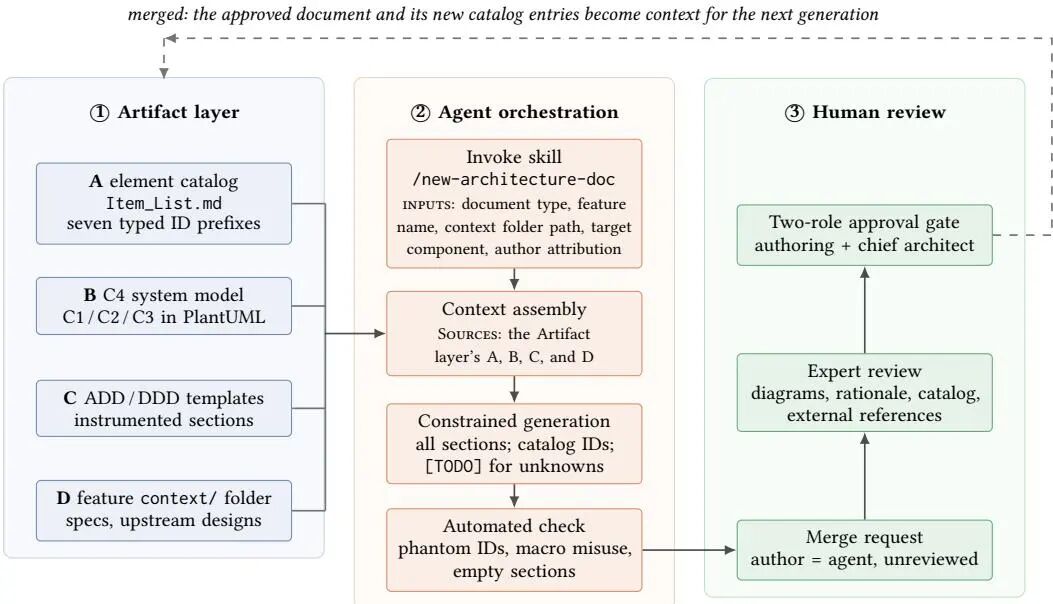
这个不对称其实很好解释。代码能编译就是能编译,编译不过就是过不去,对错有硬反馈,智能体可以在里面反复试错。
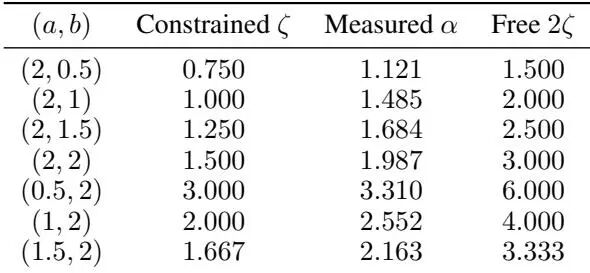
这篇论文回答的是缩放定律里最朴素也最要命的一个问题:多加一层,为什么有用?作者的答案有点反常识——在线性注意力里,深度只能按数据谱的幂律慢慢挤性能,很快就见底;注意力一旦带上 softmax 非线性,损失就按约 1/L 的逆幂律继续往下掉。作者还把这件事接到中心极限定理上,把「层间共享误差」和「层间差异」分开算账。
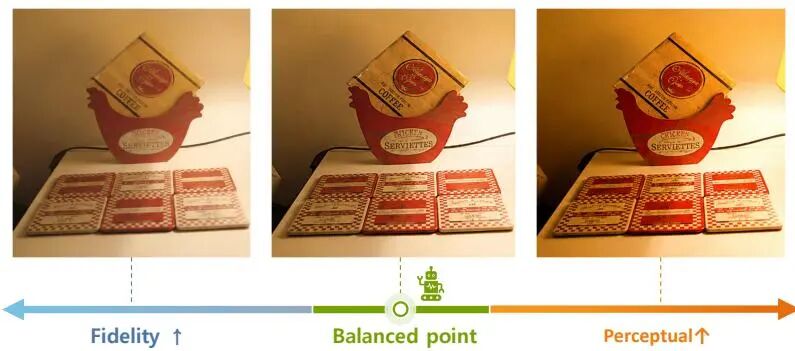
调损失权重这件事,以往基本靠炼丹手感和几轮消融碰运气。这篇论文干脆把LLM塞进训练循环:每隔一段拿固定小样本跑一遍质量指标,让它的下一段训练自己决定该更看重保真,还是更好看。改的全是现成损失项,网络结构、优化器、数据管线、推理流程一个没动,训练额外开销不到0.2%,推理零成本。三个恢复任务、七个基准,都挪到了更划算的平衡点上。🤨
代数几何里有一个非常朴素的愿望:把某一类几何对象整整齐齐地摆在一块儿,做成一个可以被参数化的空间,而且最好这个空间还是紧的——一路退化下去,极限点不许跑掉。用几何的语言讲,这就叫模空间(moduli space)。
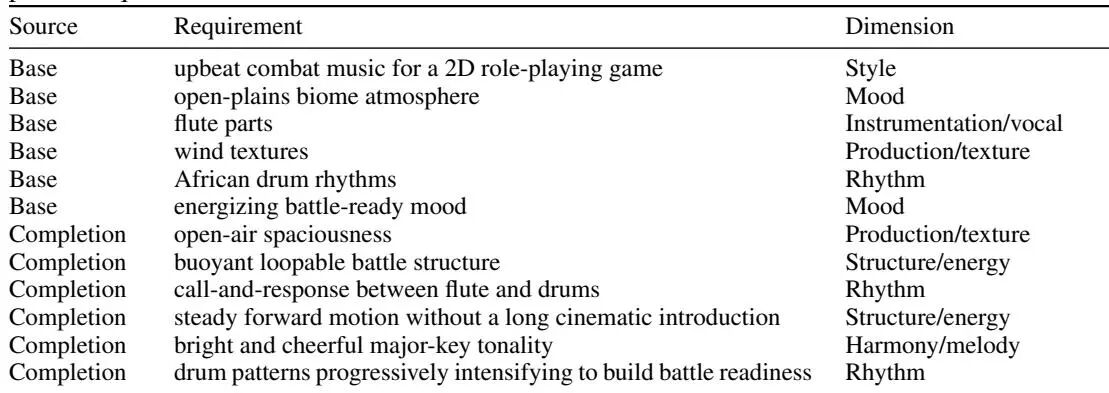
"来一段像 RPG 最终 Boss 战那样的音乐,钢琴开场,三十秒之后弦乐进来,情绪从压抑慢慢转到悲壮。"
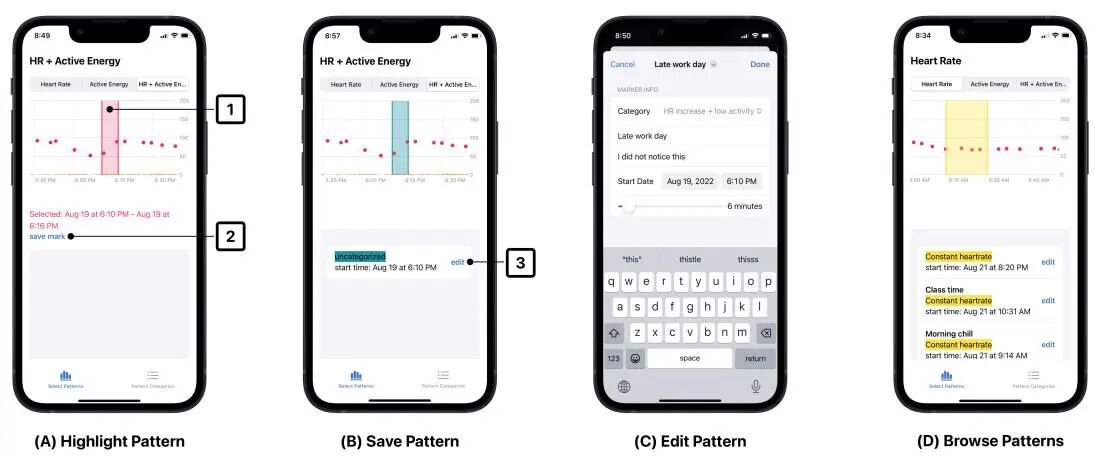
Apple 和斯坦福的这项工作不去比模型分数,而是追问一件更根本的事:当用户终于能自己定义"要让 AI 识别什么",传感系统里那些被写死的本体论边界,真的会被打破吗?8 个人、一周、两个只给界面不给算法的探针,答案比想象中拧巴得多。
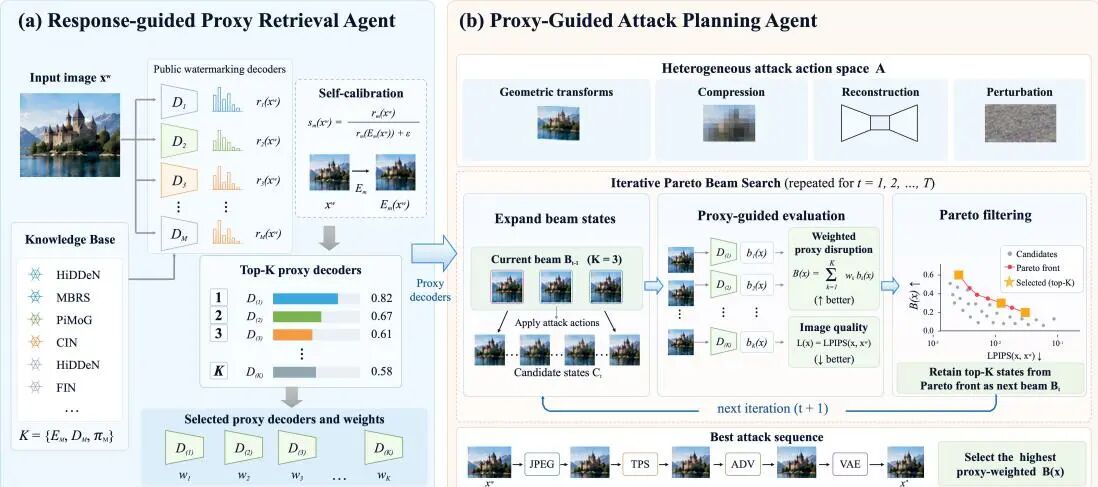
AI生成图片越来越多,水印成了内容溯源的最后一道防线。这篇论文给了一个不太舒服的结论:只要拿到一张水印图,不用知道对方用哪套算法、不碰它的解码器,也能把水印打到接近失效,11套系统平均成功率94.8%。中科大的思路值得细看——拿公开水印模型的解码器当"代理",把开环乱打变成闭环搜索。做水印的要读,做内容治理的更该读。
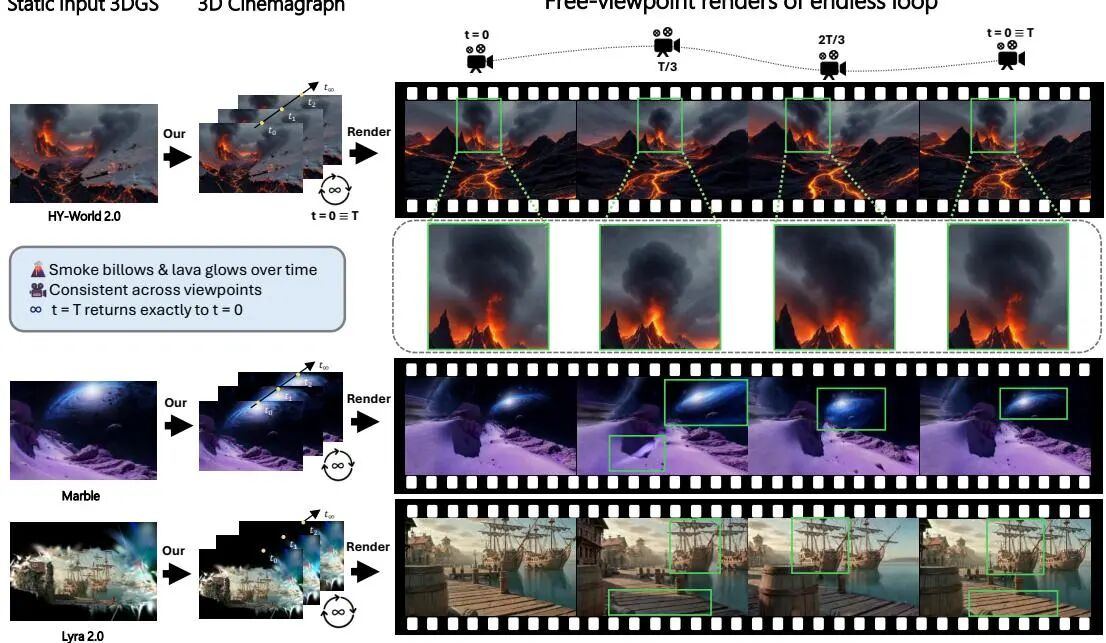
3D世界模型能把一张照片变成可走进去的场景,可这些世界是冻住的:叶子不摇,雾不飘,灯不闪。OuroWorld不用画任何掩膜,让视觉语言模型自己判断什么该动、怎么动,再用傅里叶形变场把首尾严丝合缝地接上。39个场景上全面超越四路基线,30人盲测偏好率70.8%—99%,值得一看它怎么在"互相打架"的脏监督里学出一个干净的4D场景。
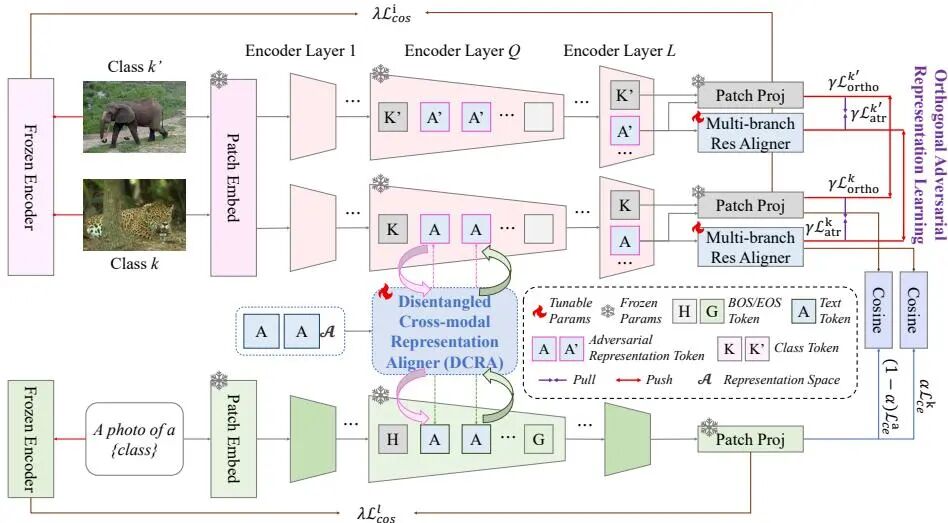
CLIP的提示学习已经被卷了三年,绝大多数工作都在往上叠模块;这篇先停下来问了一句:类特定判别信息和类无关的可迁移知识,是不是从一开始就被搅在同一个特征空间里?齐鲁工大等用解耦跨模态对齐器加正交对抗正则给出一种拆法,15个基准一致涨点,参数量还比上一版少了55.7%。涨点幅度不算炸裂,但这个诊断角度值得花时间读。
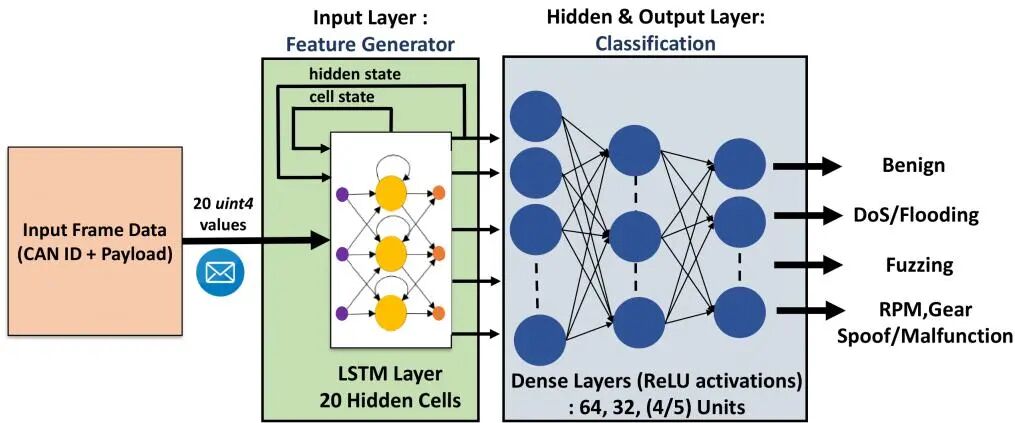
现代汽车内有多个电子控制单元(ECU),通过控制器局域网(CAN)总线通信。刹车、转向等功能都依赖这条总线,但CAN协议缺乏身份认证,任何节点都能发送消息,易受攻击。
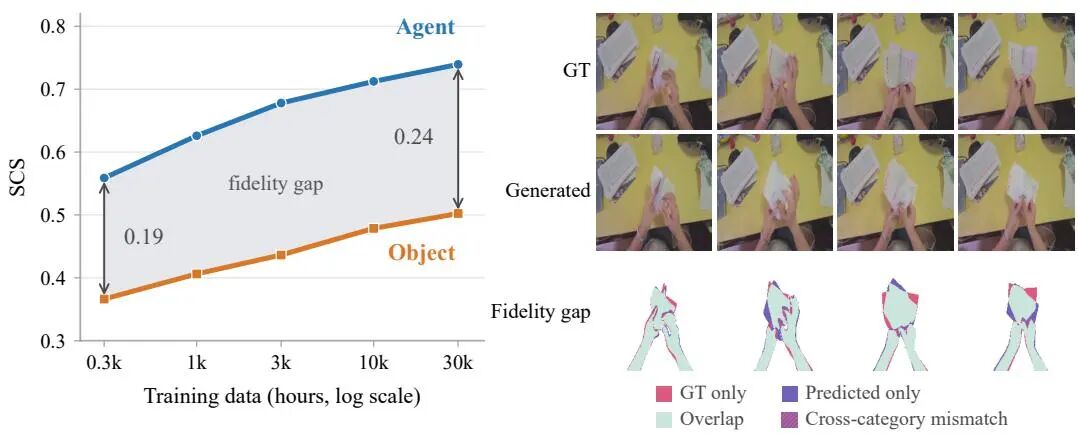
一篇给"数据越大越懂世界"这条信仰做压力测试的论文。丰田研究院联合UIUC、CMU、JHU,拿3万小时第一人称人类操作视频训练世界模型,结果有点扎心:智能体的手放在哪学得又快又准,被它折的那张纸却始终折错。骨架条件化之后,300小时就能顶到基线1.5万小时的水平;而物体交互这条曲线,怎么加数据都抬不起来。作者给出的结论比数据本身更值得读——差距出在训练方式,
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球