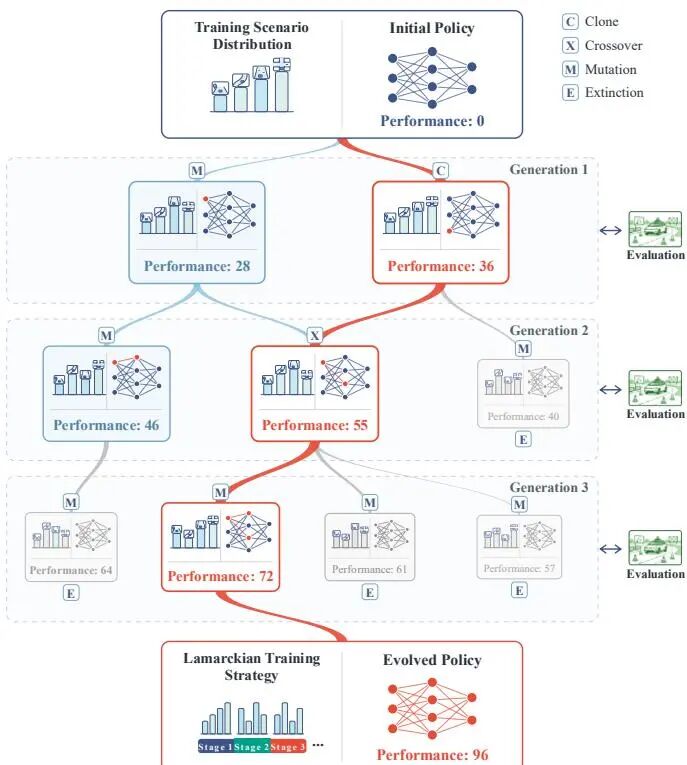
同济大学提出拉马克驾校:自动驾驶训练场景进化,性能损失最高降25.07%
自动驾驶训练里,最容易被当成“背景板”的其实是场景分布。同济大学干脆把它变成会进化的变量:候选场景分布按“训完到底开得好不好”来竞争,优胜路径再蒸馏成一套六阶段轻量课表。完整进化让性能损失比 Replay 降低 25.07%,轻量策略也有 19.13%。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
自动驾驶训练里,最容易被当成“背景板”的其实是场景分布。同济大学干脆把它变成会进化的变量:候选场景分布按“训完到底开得好不好”来竞争,优胜路径再蒸馏成一套六阶段轻量课表。完整进化让性能损失比 Replay 降低 25.07%,轻量策略也有 19.13%。
论文基本信息 方法简称: 可解释光谱分解网络(AXS-Net) 原文标题: AXS-Net: Interpretable Deep Unfolding for Hyperspectral Image Denoising via Spectral Basis Unmixing and Structured Noise Refinement 署名单位: 湘潭大学
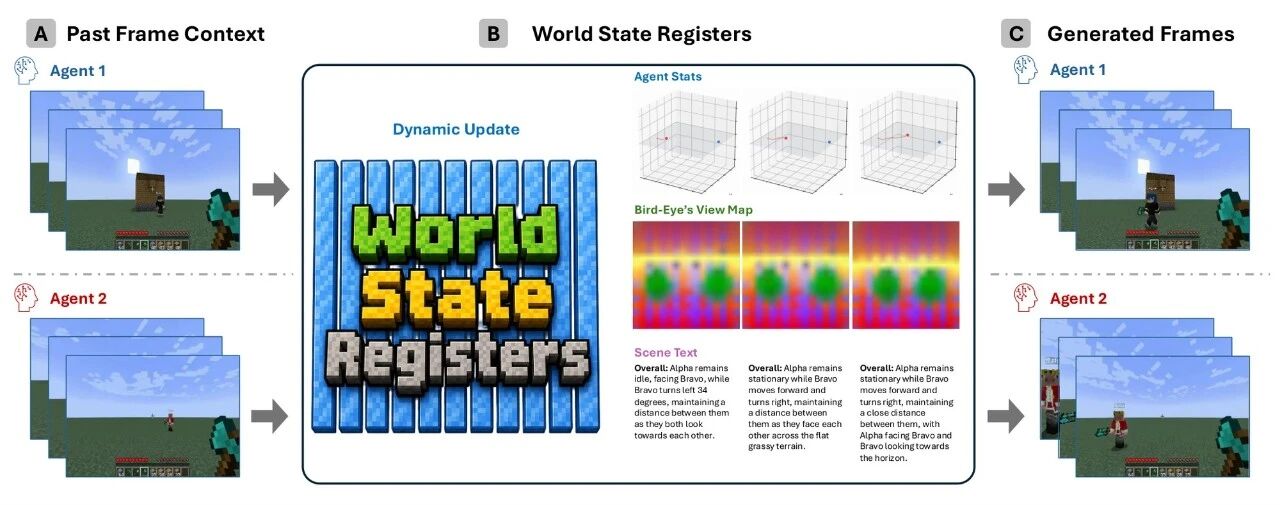
论文基本信息 原文标题: 多智能体自回归扩散模型与世界状态寄存器(Streaming Multi-Agent Autoregressive Diffusion Model with World State Registers) 首次公开: 2026年7月23日 署名单位: 加州大学洛杉矶分校、Adobe Research 原论文: https://arxiv

原文标题: RoboFolDeX: A Physical-World Benchmark for Long-Horizon Robotic Manipulation of Deformable Objects 首次公开: 2026年9月9日 署名单位: 复旦大学、美的集团(上海)人工智能研究中心、卡内基梅隆大学 原论文: https://arxiv.org/
原文标题: Video DeltaNet: A Video-Native Hybrid Attention for Livestream Video Generation 首次公开: 2026年9月17日 署名单位: 加州大学伯克利分校、Impossible公司、得克萨斯大学奥斯汀分校 原论文: https://arxiv.org/abs/2609.2074
原文标题: Programmable World Model 首次公开: 2026年9月10日 署名单位: Alaya Lab 原论文: https://arxiv.org/abs/2609.10540 项目页: https://alaya-lab.github.io/pwm 开源代码: https://github.com/AlayaLab/pwm
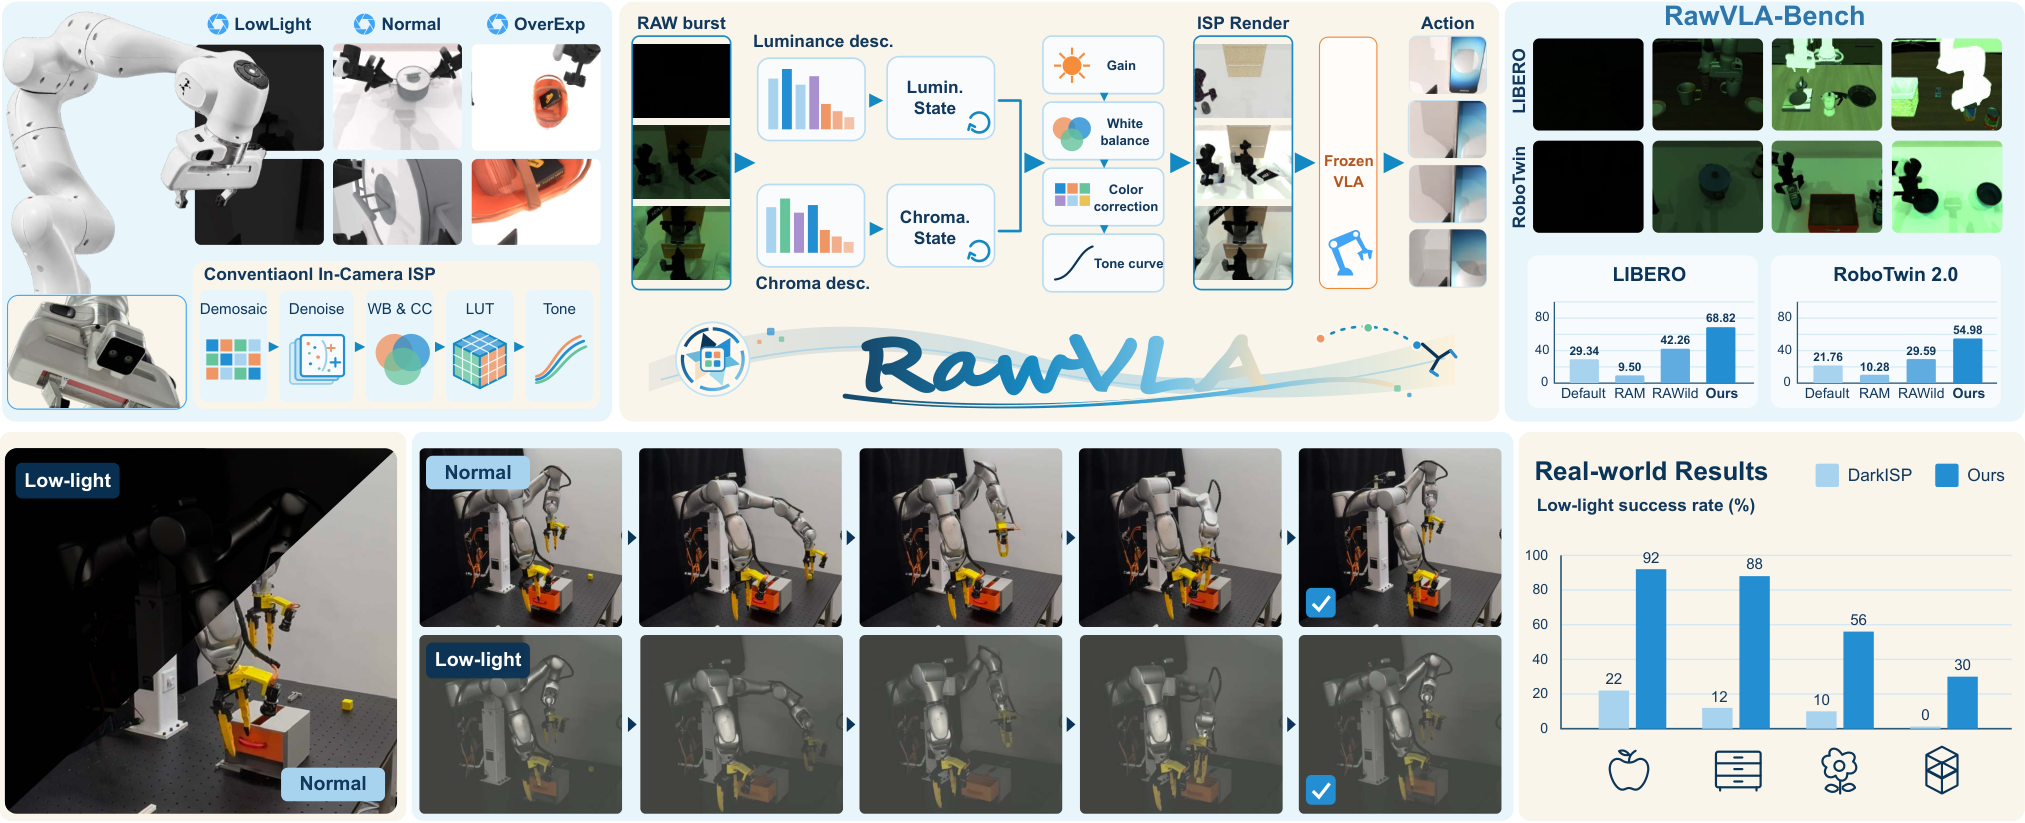
论文基本信息 原文标题: RawVLA: Embodied Neural Image Signal Processor For Robotic Manipulation 首次公开: 2026年9月29日 署名单位: 东京大学、D-Robotics、南洋理工大学、东北大学、香港科技大学(广州) 原论文: https://arxiv.org/abs/2609.3
论文基本信息 方法名称: 双阶段内生注意力利用方法(DIAL) 原文标题: Harnessing Intrinsic Subject- Aware Attention for Controllable Multi- Subject Video Generation 首次公开: 2026年9月10日 署名单位: 阿里巴巴集团、北京大学 研究领域: 多主体参考图
论文基本信息 名称说明: 连续滑车沟角测量系统(SA-Profile);滑车沟角指标(SA) 技术说明: 超分辨率技术(Super-Resolution);磁共振成像技术(MRI) 原文标题: SA-Profile: Automated Sulcus Angle Profiling from Super-Resolution MRI 首次公开: 2026年9
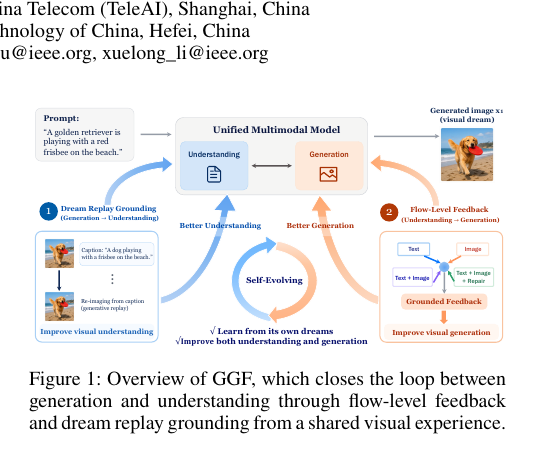
论文基本信息 原文标题: 受约束的自我改进(Self-Evolving)——Dreaming in Flow: Generative Grounding Feedback for Self-Evolving Unified Multimodal Models 首次公开: 2026年9月8日 署名单位: 上海交通大学、中国电信人工智能研究院、中国科学技术大学
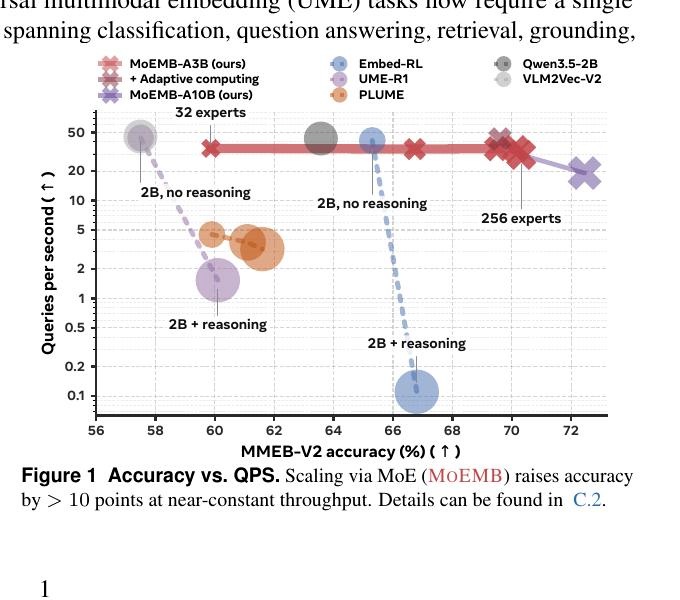
论文基本信息 原文标题: MoEMB: Scaling Universal Multimodal Embeddings with Efficient Mixture-of-Experts Models 中文概括: 用稀疏专家扩展通用多模态向量模型,并让不同输入动态使用不同算力 署名单位: Meta AI、中佛罗里达大学 首次公开: 2026年9月8日 原论文
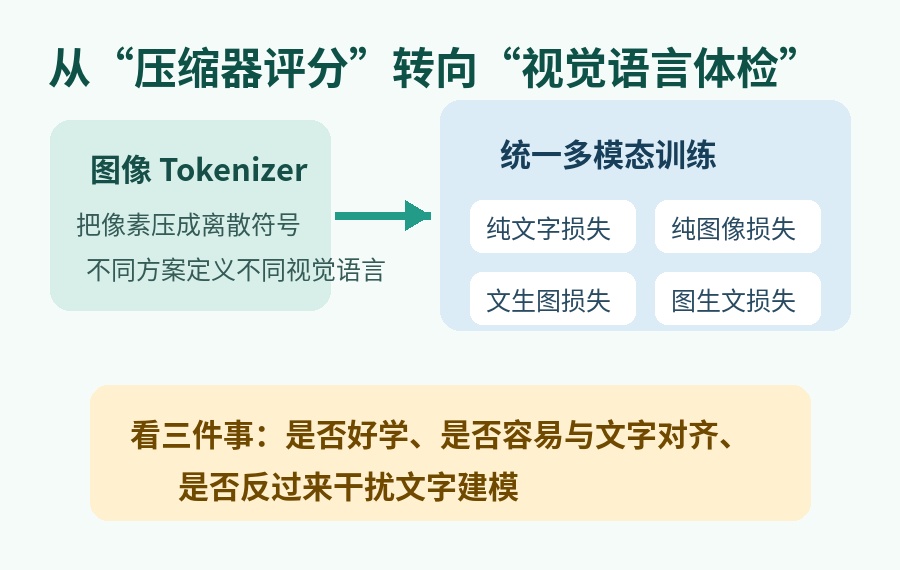
一张图压缩后看起来更像原图,不代表这些视觉符号更容易被多模态模型理解,也不代表生成效果一定更强。 华盛顿大学与亚马逊团队把图像 Tokenizer 当作一种“视觉语言”,用文字、图像、文生图和图生文四类损失重新检查它。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球